


前言
“Agent通过大模型的推理和规划,使得大模型真正实现类似人类的能力”
AI Agent也就是AI智能体,是通过把大模型作为“大脑”,通过利用大模型的推理和规划能力,然后调用外部工具来完成复杂任务的一种方式。
简单来说,Agent就是一种让大模型自己思考和分析问题,选择合适的工具,最终解决问题的一种方法,其背后原理就来自于ReAct。
ReAct是Reasoning And Acting的缩写,意思是LLM可以根据逻辑推理(Reson),构建完整系列行动(Act),从而达到期望目标。
LLM的灵感来源于人类和推理之间的协同关系,人类根据这种协同关系学习新的知识,做出决策,然后执行。
从本质上来说,智能体的作用就是模仿人类的思维和处理复杂问题的方式。

基于LLM 和 Function Call实现Agent
ReAct的作用就是协同LLM和外部的信息获取,与其它功能交互,如果说LLM模型是大脑,那么ReAct框架就是这个大脑的手脚和五官。
下面我们就用代码来实现一个简单的具有自主规划功能的Agent,需要的东西也很简单:
Python开发环境 python 版本用到3.12.1 版本没有强制要求

支持Function Call 工具的大模型(可以是自己部署的大模型或者第三方模型)。
使用第三方模型需要自己申请并获取其API-KEY,代码中还用到了tavily搜索,这个也需要自己去申请。
下图是Agent根据任务要求输出的结果,任务要求是
请帮我制定一份理财计划,你可以通过网络搜索的方式来收集一定的参考资料,并把最终的计划内容写入到理财计划.txt文件中

Agent实现的核心有三点
大模型的质量
外部工具集
提示词的质量
大模型的质量问题直接影响到Agent表现的好坏,推理能力强,知识丰富的大模型会表现更好。
而外部工具集就是提供给大模型使用的工具可以根据不同的业务场景提供不同的工具集(API)。如果使用一些第三方API可能需要自己申请,比如百度或谷歌搜索,高德和百度的地图接口等。
提示词是最重要的一个环节,我们知道大模型的能力是一方面,但怎么发挥大模型的能力是由提示词的质量决定的。
# 约束
constraints = [
    "仅使用下面列出的动作",
    "你只能主动行动,在计划行动时需要考虑到这一点",
    "你无法与物理对象交互,如果对于完成任务或目标是绝对必要的,则必须要求用户为你完成,如果用户拒绝,并且没有其它方法实现目标,则直接终止,避免浪费时间和精力"
]

# 资源
resources = [
    "提供搜索和信息搜集的互联网接入",
    "读取和写入文件的能力",
    "你是一个大语言模型,接受了大量的文本训练,包括大量的事实知识,利用这些知识来避免不必要的信息收集"
]

# 最佳实践说明
best_practices = [
    "不断地回顾和分析你的行为,确保发挥出你最大的能力",
    "不断地进行建设性的自我批评",
    "反思过去的决策和策略,完善你的方案",
    "每个动作执行部分代价,所以要聪明高效,目的是用最少的步骤完成任务"
]

prompt_template = """
    你是一个问答专家,你必须始终独立做出决策,无需寻求用户的帮助,发挥你作为LLM的优势,追求简单的策略,不要涉及法律问题

任务:
{query}


限制条件说明:
{constraints}

动作说明:这是你唯一可以使用的作用,你的任何操作都必须通过以下操作实现:
{actions}

资源说明:
{resources}

最佳实践的说明:
{best_practices}


agent_scratch:
{agent_scratch}

你应该只以json格式响应,响应格式如下:
{response_format_prompt}
确保响应结果可以由python json.loads解析

"""

response_format_prompt = """
{
    "action":{
        "name": "action name",
        "args": {
            "answer": "任务的最终结果"
        }
    },
    "thoughts": {
        "plan": "简短的描述短期和长期的计划列表",
        "criticism": "建设性的自我批评",
        "speak": "当前步骤,返回给用户的总结",
        "reasoning": "推理"
    },
    "observation": "观察当前任务的整体进度"
}
"""
在这个提示词中加入了工具列表,资源说明,任务需求等;并且约定了大模型的输出格式,以便于进行解析,大模型就可以根据这提示词对任务进行思考和推理。
并且根据推理结果,选择合适的工具来完成对应的任务,比如调用搜索工具完成信息收集,调用文件写入工具把结果写入到文件中。
下图是大模型的思考,推理和工具调用的过程,从图中可以看出大模型经过多次规划才完成的任务。

其次,就是工具集的构建,简单来说就是一些python函数,用来给大模型进行调用:
"""
    1. 写文件
    2. 读文件
    3. 追加
    4. 网络搜索

"""

def get_workdir_root():
    workdir_root = os.environ.get("WORKDIR_ROOT", './data/llm_result')
    return workdir_root

WORKDIR_ROOT = get_workdir_root()

def read_file(filename):

    if not os.path.exists(filename):
        return f"{filename} not exist, please check file exist before read"

    with open(filename, "r") as f:
        return "\n".join(f.readline())


def append_to_file(filename, content):
    filename = os.path.join(WORKDIR_ROOT, filename)

    if not os.path.exists(filename):
        return f"{filename} not exist, please check file exist before read"

    with open(filename, 'a') as f:
        f.write(content)

    return "append content to file success"

def write_to_file(filename, content):
    filename = os.path.join(WORKDIR_ROOT, filename)

    if not os.path.exists(WORKDIR_ROOT):
        os.makedirs(WORKDIR_ROOT)

    with open(filename, 'w') as f:
        f.write(content)

    return "write content to file success"

def search(query):
    tavily = TavilySearchResults(max_results=5)

    try:
        ret = tavily.invoke(input=query)

        """
            ret:
            [{
                "content": "",
                "url": ""
            }]
        """
        print("搜索结果", ret)
        content_list = [obj["content"] for obj in ret]
        return "\n".join(content_list)
    except Exception as err:
        return "search err: {}".format(err)

tools_info = [
    {
        "name": "read_file",
        "description": "read file from agent generate, should write file before read.",
        "args": [
            {
                "name": "filename",
                "type": "string",
                "description": "read file name"
            }
        ]
    },
    {
        "name": "append_to_file",
        "description": "append llm content to file, should write file before read.",
        "args": [
            {
                "name": "filename",
                "type": "string",
                "description": "file name"
            },
            {
                "name": "filename",
                "type": "string",
                "description": "append to file content"
            }
        ]
    },
{
        "name": "write_to_file",
        "description": "write llm content to file",
        "args": [
            {
                "name": "filename",
                "type": "string",
                "description": "file name"
            },
            {
                "name": "filename",
                "type": "string",
                "description": "write to file content"
            }
        ]
    },
    {
        "name": "search",
        "description": "this is a search engine, you can gain additional knowledge though this search engine when you are unsure of what large model return",
        "args": [
            {
                "name": "query",
                "type": "string",
                "description": "search query to lookup"
            }
        ]
    },
    {
        "name": "finish",
        "description": "完成用户目标",
        "args": [{
            "name": "answer",
            "type": "string",
            "description": "最后的目标结果"
        }]
    }
]

tools_map = {
    "read_file": read_file,
    "append_to_file": append_to_file,
    "write_to_file": write_to_file,
    "search": search
}

def gen_tools_desc():
    tools_desc = []
    for idx, t in enumerate(tools_info):
        args_desc = []
        for info in t['args']:
            args_desc.append({
                "name": info['name'],
                "description": info["description"],
                "type": info['type']
            })
        args_desc = json.dumps(args_desc, ensure_ascii=False)
        tool_desc = f"{idx + 1}. {t['name']}: {t['description']}, args: {args_desc}"
        tools_desc.append(tool_desc)

    tools_prompt = "\n".join(tools_desc)
    return tools_prompt
最后两个就是大模型的调用模块和业务的解析模块,大模型的调用模块相对比较简单,这里就不仔细说了,感兴趣的可以直接看代码。
解析模块说简单也简单,说复杂也复杂;因为当前的功能比较简单,因此只需要使用大模型本身的能力即可,然后完成对大模型每次思考和规划数据的解析即可。
而如果后续需要开发更加复杂的业务功能,比如说金融行业的投资分析,需要非常复杂的业务分析等环节,这时只依靠大模型本身的能力就不行了。
比如说,由于大模型在垂直领域的表现不佳,直接使用可能会带来幻觉等问题;还有就是Agent的记忆模块,在大量的复杂业务分析中,需要增加外部存储模块来记录历史记忆功能,这样才能更好地完成复杂的任务处理。
"""
todo:
环境变量的设置
工具的引入
prompt模板
模型的初始化
"""

# 初始化模型
mp = ModelProvider()

# 解析大模型的响应
def parse_thoughts(response):
    try:
        thoughts = response.get("thoughts")
        observation = response.get("observation")

        plan = thoughts.get("plan")
        reasoning = thoughts.get("reasoning")
        criticism = thoughts.get("criticism")
        prompt = f"plan: {plan}\n reasoning: {reasoning}\n criticism: {criticism}\nobservation: {observation}"
        print("thoughts: ", prompt)
        return prompt
    except Exception as err:
        print("parse thoughts err: {}".format(err))
        return "".format(err)

def agent_execute(query, max_request_time=10):
    cur_request_time = 0
    # 大模型记忆 包括短期记忆和长期记忆
    chat_history = []
    # agent 反思 规划等
    agent_scratch = ''
    while cur_request_time < max_request_time:
        cur_request_time += 1
        """
            如果返回结果达到预期,则直接返回
        """
        # 提示词模板
        """
            prompt包含的功能:
            1. 任务描述
            2. 工具描述
            3. 用户的输入user_msg
            4. assistant_msg
            5. 限制
            6. 给出更好实践的描述
        """
        prompt = gen_prompt(query, agent_scratch)

        start_time = time.time()
        print("--------------------------{}, 开始调用大模型LLM------------".format(cur_request_time), flush=True)

        # 调用大模型 直接返回json格式数据
        """
            sys_prompt:
            user_msg, assistant, history
        """

        if cur_request_time < 3:
            print("prompt: ", prompt)

        # response = call_llm()

        response = mp.chat(prompt, chat_history=chat_history)
        end_time = time.time()
        print("--------------------------{}, 调用大模型結束,耗时:{}---------------".format(cur_request_time, end_time-start_time), flush=True)

        if not response or not isinstance(response, dict):
            print("调用大模型错误, 即将重试: ", response)
            continue

        """
        大模型返回格式约定
            response:
            {
                "action":{
                    "name": "action name",
                    "args": {
                        "args name": "args values"
                    }
                },
                "thoughts": {
                    "text": "thought",
                    "plan": "plan",
                    "criticism": "criticism",
                    "speak": "当前步骤,返回给用户的总结",
                    "reasoning": ""
                }
            }
        """


        action_info = response.get("action")
        action_name = action_info.get("name")
        action_args = action_info.get("args")
        print("当前action name: ", action_name, action_args)

        if action_name == "finish":
            final_answer = action_args.get("answer")
            print("final_answer: ", final_answer)
            break

        observation = response.get("observation")

        try:
            """
                action_name 到函数的映射, map -> { action_name: func }

            """
            # todo: tools_map 的实现
            # tools_map = {}
            func = tools_map.get(action_name)
            call_func_result = func(**action_args)

        #  { action_name: func }
        except Exception as err:
            print("调用工具异常: ", err)
            call_func_result = "{}".format(err)
        agent_scratch = agent_scratch + "\n:observation:{}\n execute action result: {}".format(observation, call_func_result)

        # 由于大模型没有记忆功能,因此需要把大模型之前的输入和输出加入到history中,这也是Agent四大块中的记忆模块 由于目前的业务并不复杂,因此不需要外部记忆模块 如果业务比较复杂可能还需要外部模块进行存储
        assistant_msg = parse_thoughts(response)

        chat_history.append([user_prompt, assistant_msg])

    if cur_request_time == max_request_time:
        print("很遗憾,本次任务失败")
    else:
        print("恭喜你,任务完成")

def main():
     # 支持用户多次交互 最大规划次数设置为10次 当超过10次时 则说明任务失败 用户可以根据自己的情况进行调整
    max_request_time = 10
    while True:
        query = input("请输入你的目标:")
        if query == "exit":
            return

        agent_execute(query, max_request_time=max_request_time)


if __name__ == "__main__":
    main()
最后,这里只是为了实现Agent的实现流程,并且由于大模型的质量问题,也不能保证每次都能成功。
受限于大模型的性能问题,大模型在推理和规划方面表现还不尽人意,因此怎么才能让大模型更好实现复杂推理规划是一个值得研究的问题。
里面主要涉及两个第三方模块,一个是第三方大模型的申请,个人使用的是阿里的通义千问;第二个是Travily的搜索接口,官网地址:https://app.tavily.com用户也可以自己去申请或者使用其它搜索工具,比如百度搜索等。
最后唠两句
为什么AI大模型成为越来越多程序员转行就业、升职加薪的首选
很简单,这些岗位缺人且高薪
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
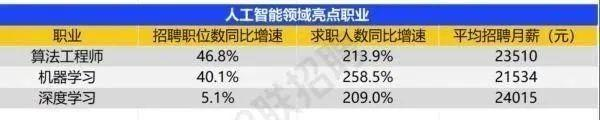
AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。
那0基础普通人如何学习大模型 ?
深耕科技一线十二载,亲历技术浪潮变迁。我见证那些率先拥抱AI的同行,如何建立起效率与薪资的代际优势。如今,我将积累的大模型面试真题、独家资料、技术报告与实战路线系统整理,分享于此,为你扫清学习困惑,共赴AI时代新程。
我整理出这套 AI 大模型突围资料包【允许白嫖】:
-
✅从入门到精通的全套视频教程
-
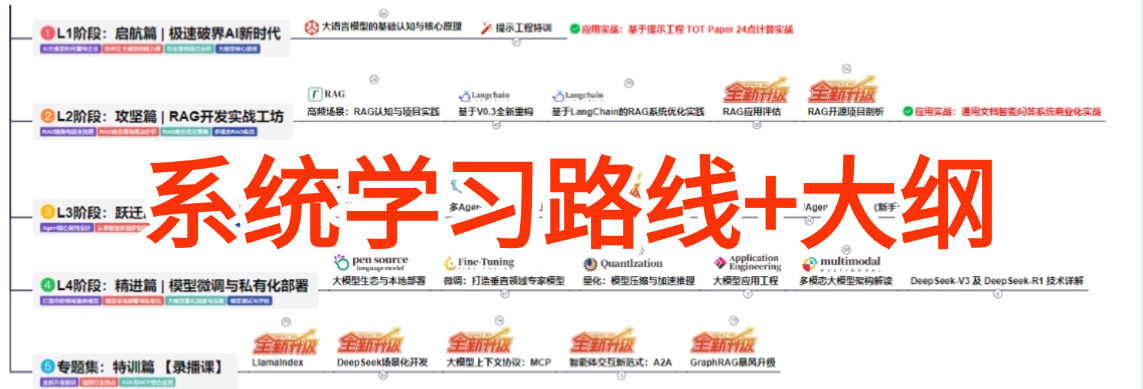
✅AI大模型学习路线图(0基础到项目实战仅需90天)
-
✅大模型书籍与技术文档PDF
-
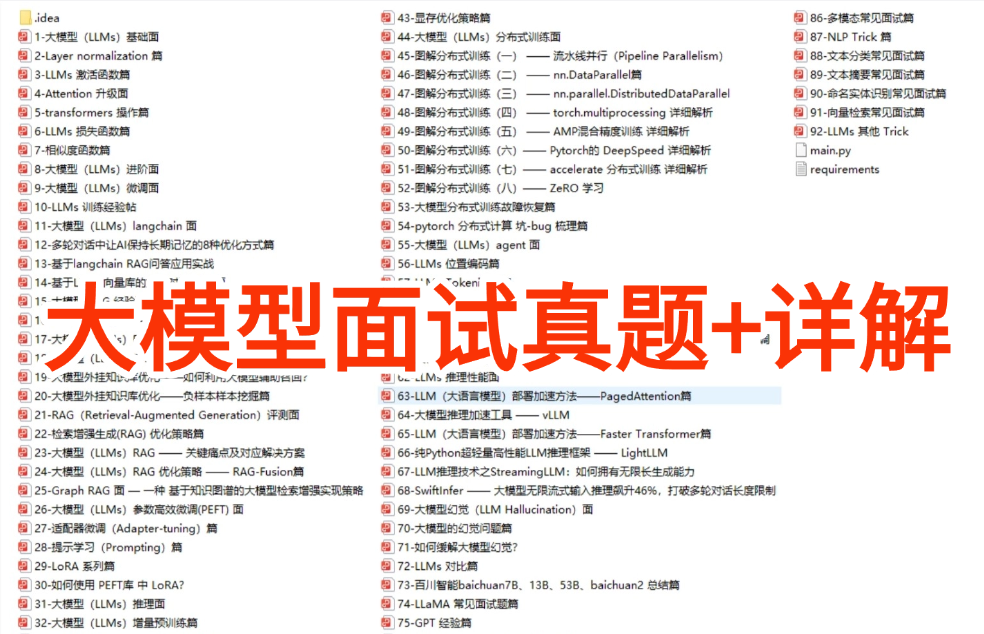
✅各大厂大模型面试题目详解
-
✅640套AI大模型报告合集
-
✅大模型入门实战训练
这份完整版的大模型 AI 学习和面试资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
①从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
② AI大模型学习路线图(0基础到项目实战仅需90天)
全过程AI大模型学习路线
③学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
④各大厂大模型面试题目详解
⑤640套AI大模型报告合集
⑥大模型入门实战训练
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
 803


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


