RAKG:用RAG“倒过来“建图,95.91%准确率碾压传统KGC三大痛点!

GLM-4.6国产大模型实战:中文长文本处理与Claude平替成本分析 大语言模型(LLM)作为AI基础设施,其选型需兼顾能力、成本与落地可控性。国产大模型近年来在中文理解、长文本建模和本地化部署方面持续突破,尤其在法律、政务、金融等结构化文本场景中,展现出区别于通用模型的技术路径——如ALiBi位置编码增强外推能力、专业词表蒸馏提升领域精度。这类模型并非追求全场景SOTA,而是通过架构优化与数据适配,在垂直任务中实现高性价比闭环。GLM-4.6正是典型代表:它支持16K上下文、兼容OpenAI API协议、可在单张A10显卡完成生产级部署,显著降低API调用与数据合规风险。本 阅读详情

一、背景:传统 KGC 的三座大山

随着大模型(LLM)能力的不断增强,知识图谱(KG) 作为结构化知识的核心载体,重新成为研究热点。尤其是在 GraphRAG、Pike-RAG 等图谱增强生成框架的推动下,知识图谱在提升大模型推理能力、缓解幻觉问题方面展现出巨大潜力。

痛点具体表现
实体消歧难同一缩写、别名、指代在跨段落时极易混淆,人工规则维护成本爆炸。
模式僵化先定义 schema 再抽取,无法随文档主题动态扩展,领域迁移=重写规则。
跨文档信息遗忘长文本直接塞 LLM,中间段落被“遗忘”,导致关系缺失或张冠李戴。

二、结论:95.91 % 准确率,6.2 个点的碾压式提升

提出 **RAKG(Retrieval-Augmented Knowledge Graph Construction)**框架,首次将 RAG 的评估机制 引入知识图谱构建过程,实现文档级、自动化的知识图谱构建与评估。

图1 直观展示了 RAG 范式反打到 KGC(知识图谱构建) 后的整体流程,把“检索-生成”思路反过来用在建图阶段。
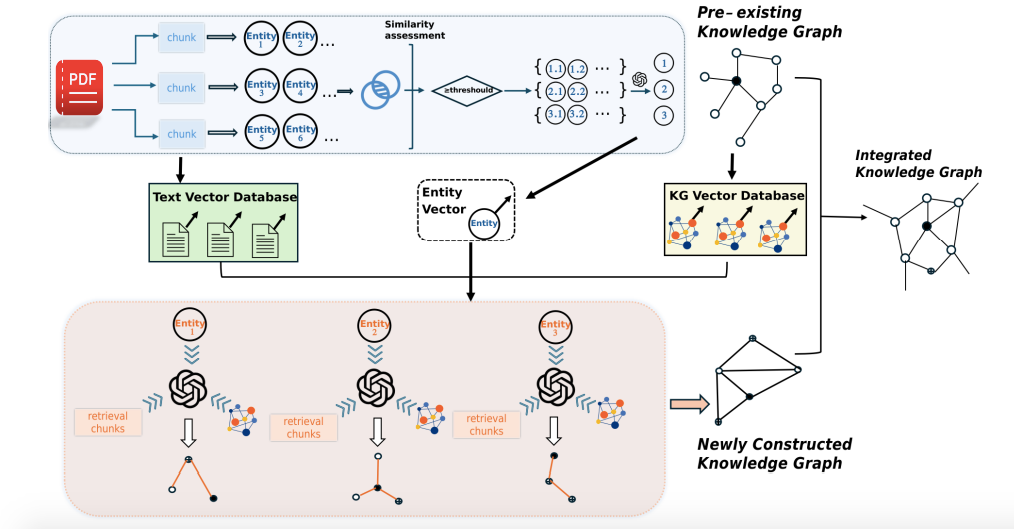
图1 RAKG 框架总览

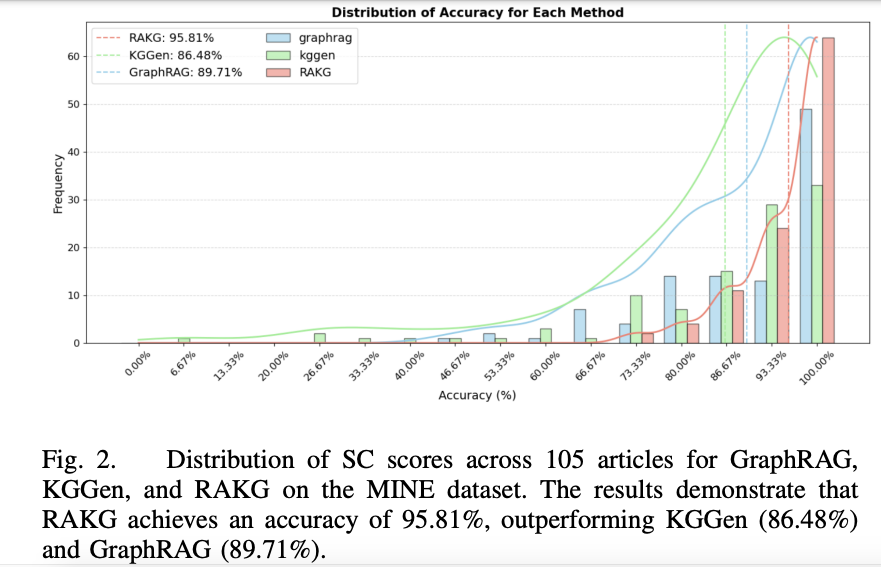
指标RAKGGraphRAGKGGen
Accuracy95.91 %89.71 %86.48 %
实体密度 ED高 23 %——
关系丰富度 RR高 31 %——
实体覆盖率 EC0.87520.64380.6020
关系网络相似度 RNS0.79980.72780.6321

图2 的 105 篇文章得分分布显示,RAKG 几乎“全线右移”,没有低分尾巴。
三、方案:把 RAG“倒过来”建图的三板斧

3.1 预实体(Pre-Entity):先抓“锚点”再检索

  1. 按句分块,NER 逐块抽取实体 → 生成 Pre-Entity 并缓存 chunk-id;
  2. 向量相似度初筛 + LLM 二次判别,完成 实体消歧与合并;
  3. 用 Pre-Entity 当“query”,反向去召回它出现过的所有文本块与已有子图。

图6 案例:Butterfly 一生四个阶段,Pre-Entity 把“Butterfly Egg / Larva / Pupa / Adult”先锚定,再各自召回描述段落。
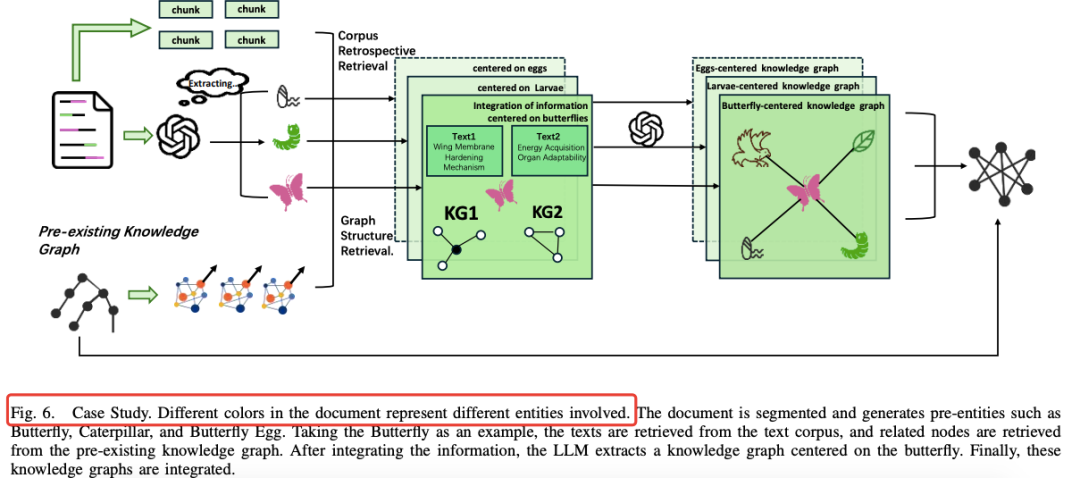
图6 案例研究:Butterfly 生命周期

3.2 双层检索:语料回溯 + 图结构回溯

检索源作用实现
Corpus Retrospective补全实体局部上下文,缓解 LLM 长文本遗忘用实体向量召回 top-k 句块
Graph Structure保持与已有 KG 的拓扑一致,避免冲突用实体向量召回已有节点及其一跳邻居

图4 把“LLM as Judge”流程画成一条质检流水线:生成→检索→比对→打分→过滤。
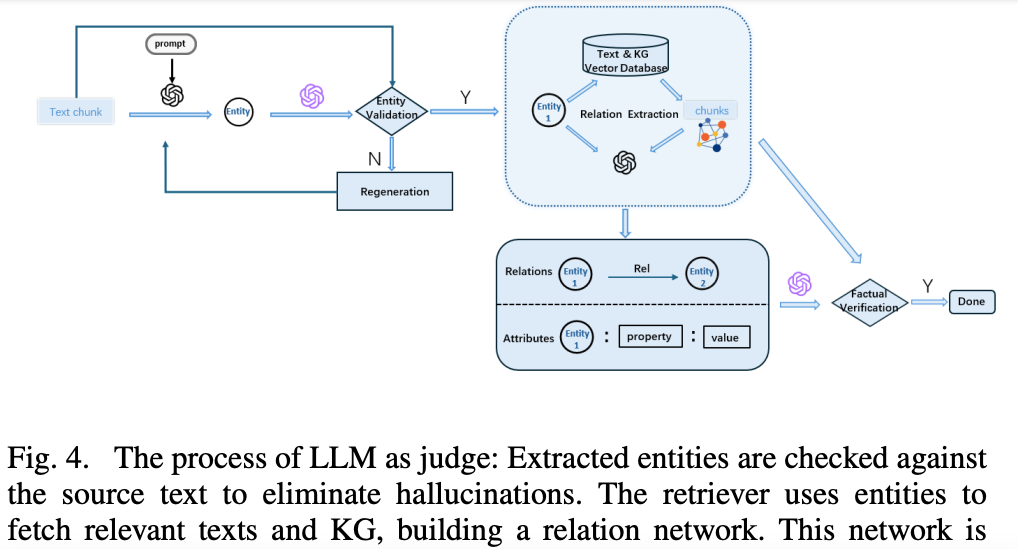
图4 LLM 作为裁判的质检流程

3.3 渐进式融合:子图 → 全局图

  1. 每个实体独立生成 关系子图(节点+属性+边);
  2. 子图之间按实体 ID 合并,冲突边交给 LLM 做“事实性”二次判断;
  3. 输出最终 KG,并同步更新向量索引,支持持续增量构建。

图5 显示,经过“LLM Judge”后,实体通过率 91.33 %,关系通过率 94.51 %,幻觉率被压到 5 % 以内。
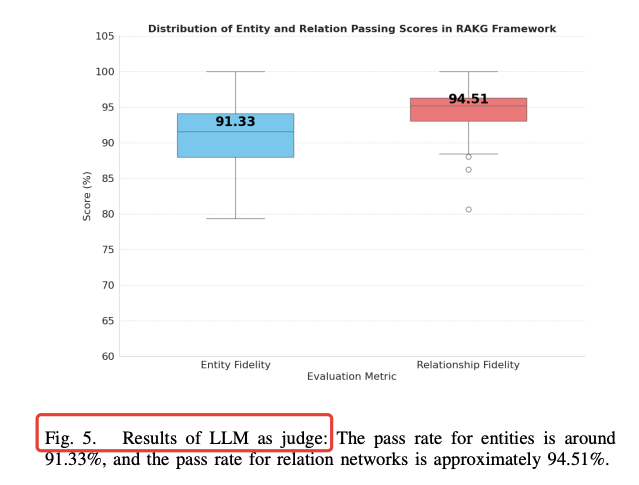
图5 LLM Judge 通过率

四、一张表看懂 RAKG 的“增量”在哪

传统 KGCRAKG 做法收益
先定义 schema无 schema,先抽实体再动态长边零成本跨领域
长文本一次性编码用 Pre-Entity 当 query 分段检索解决长文本遗忘
人工写消歧规则向量初筛 + LLM 精判规则零维护
无质检环节引入 RAG 评估框架,LLM 当 Judge幻觉率 ↓ 90 %

五、如何系统的学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

一直在更新,更多的大模型学习和面试资料已经上传带到优快云的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
在这里插入图片描述

01.大模型风口已至:月薪30K+的AI岗正在批量诞生

在这里插入图片描述

2025年大模型应用呈现爆发式增长,根据工信部最新数据:

国内大模型相关岗位缺口达47万

初级工程师平均薪资28K(数据来源:BOSS直聘报告)

70%企业存在"能用模型不会调优"的痛点

真实案例:某二本机械专业学员,通过4个月系统学习,成功拿到某AI医疗公司大模型优化岗offer,薪资直接翻3倍!

02.大模型 AI 学习和面试资料

1️⃣ 提示词工程:把ChatGPT从玩具变成生产工具
2️⃣ RAG系统:让大模型精准输出行业知识
3️⃣ 智能体开发:用AutoGPT打造24小时数字员工

📦熬了三个大夜整理的《AI进化工具包》送你:
✔️ 大厂内部LLM落地手册(含58个真实案例)
✔️ 提示词设计模板库(覆盖12大应用场景)
✔️ 私藏学习路径图(0基础到项目实战仅需90天)
在这里插入图片描述
在这里插入图片描述
在这里插入图片描述

在这里插入图片描述
在这里插入图片描述
在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

【大模型应用开发-大模型知识】(二)大模型分类和常见大模型 目前包含 Claude 和 Claude-Instant 两种模型可供选择,其中 Claude Instant 的延迟更低,性能略差,价格比完全体的 Claude-v1 要便宜,两个模型的上下文窗口都是 9000 个token(约 5000 个单词,或 15 页)它的目标是“更安全”、“危害更小”的人工智能。Google 还开发了多种 PaLM 的改进版本。更强大的基础模型: ChatGLM3-6B 的基础模型 ChatGLM3-6B-Base 采用了更多样的训练数据、更充分的训练步数和更合理的训练策略。 阅读详情

相关推荐

深度剖析:Spring AI 与 LangChain4j,谁才是 Java 程序员的 AI 开发利器?

首先介绍 AI 时代 Java 开发框架选择背景,接着对比两者功能特性(Spring AI 的生态集成与标准化设计、LangChain4j 的多模型适配与提示工程)、应用场景(企业级系统改造与创新产品开发)、开发体验(学习成本与调试工具)、生态扩展(Spring 商业支持与 LangChain4j 开源社区)、性能安全(企业级优化与自主安全实现)及成本趋势(短期投入、长期回报与技术演进),最后给出选型建议与混合架构方案。

博客 5445

SpringBoot3 项目国产化改造完整流程|从 MySQL 到人大金仓落地

当前政企、国企、事业单位、金融能源行业的信创落地已进入全面替换阶段,核心业务系统必须完成国外软硬件的100%国产化替代。其中,将MySQL 迁移至人大金仓 KES V9是绝大多数 Java 后端项目的必经之路。然而,大量开发者在改造中反复踩坑:只改了驱动和URL,上线后批量报错、功能异常SQL语法不兼容、分页失效、主键自增异常、空值报错层出不穷数据迁移后乱码、丢失、不一致改造后性能暴跌、批量插入缓慢、查询卡顿只做功能适配,忽略信创合规改造,无法通过验收。

雨辰AI的博客 13万+

告别QXDM:在Android Studio中调试与验证高通NV读写功能的完整流程

本文详细介绍了在Android Studio中调试与验证高通NV分区读写功能的完整流程,替代传统的QXDM工具。通过JNI接口层、HAL服务层和Diag通信层的架构设计,开发者可以在熟悉的IDE环境中高效完成NV操作,包括环境配置、错误处理和性能优化等关键实践。

weixin_27013291的博客 261

gork 官网_gork 3 官方网站入口_马斯克AI

但是由于国内网络限制以及xAI未对国内开放使用权限,因此国内的用户是不能直接通过grok官网使用的。对于国内用户使用Grok中文版是一个更好的选择!

gemini_25的博客 6万+

嵌入式软件面试常见问题及答案

干了多年的嵌入式,被面试过,也面过不少新人,下面这些是面试中很常见的一些问题及答案,答案可以根据自己的经验自己思考下。--持续补充并更新

weixin_37553721的博客 6025

VirtualBox增强功能安装全指南:从下载到配置复制粘贴功能

本文详细介绍了VirtualBox增强功能的完整安装与配置流程,重点解决了虚拟机与主机间复制粘贴、文件拖放等核心协作难题。通过分步指南和故障排查,帮助用户在不同操作系统(如Windows、Linux)中实现无缝集成,提升虚拟化工作效率与体验。

weixin_29206669的博客 419

【收藏必看】RAKG:用RAG“倒过来“建图,95.91%准确率碾压传统KGC三大痛点!

RAKG框架创新性地将RAG评估机制引入知识图谱构建,通过"预实体"锚定、双层检索和渐进式融合三大技术,解决了实体消歧、模式僵化和跨文档信息遗忘三大痛点。该框架实现95.91%准确率,比现有方法提升6.2个百分点,无需预定义schema,实现零规则维护和低幻觉率,为GraphRAG等应用提供高质量知识基础。

Android23333的博客 486

基于浏览器插件的拼多多买家订单导出方法

基于浏览器插件的拼多多买家订单导出方法

2501_93542170的博客 1719

炸裂!95.91%准确率!RAKG框架让知识图谱构建像搭积木一样简单,小白也能秒变图谱专家

RAKG框架创新性地将RAG评估机制引入知识图谱构建,解决传统KGC三大痛点:实体消歧难、模式僵化和跨文档信息遗忘。通过预实体锚定、双层检索和渐进式融合三大技术,实现文档级自动化图谱构建。实验显示,RAKG准确率达95.91%,比现有方法提升6.2个百分点,实体密度提高23%,关系丰富度提升31%,大幅降低幻觉率,为小白程序员提供零成本跨领域的知识图谱构建解决方案。

m0_59164520的博客 936

UE5 中 Python 编程:Python 代码加载到 UE5 中,如何供蓝图节点调用

配置 python 代码的路径,使 UE5 启动时,加载代码文件。重启之后,在蓝图中右键,就能搜索到你定义的方法了。参数为 str 字符串类型,返回值为 向量数组。注意:一定要 重启 UE5。

topcss的专栏 3997

医学图像分割评价指标详解:从Dice到MSD的实战解析

本文深入解析医学图像分割的核心评价指标,从最常用的Dice相似系数到衡量边界精度的MSD(最大对称表面距离),通过实战案例与代码演示,系统阐述各指标的计算原理、应用场景及临床意义,帮助读者全面评估模型性能。

weixin_29070721的博客 593

99%的人都不知道!GraphRAG的下一个风口,竟然是“文档级RAKG”!

随着大模型(LLM)能力的不断增强,知识图谱(KG) 作为结构化知识的核心载体,重新成为研究热点。尤其是在 **GraphRAG、Pike-RAG** 等图谱增强生成框架的推动下,知识图谱在提升大模型推理能力、缓解幻觉问题方面展现出巨大潜力。

weixin_58753619的博客 662

SIMULINK开发项目实例 1000 例专栏之第847例--基于飞行控制与稳定性的场景实例:多旋翼无人机在风扰动下的稳定性分析

本文介绍了使用Simulink进行多旋翼无人机风扰动稳定性分析的完整流程。首先建立包含动力学模型、控制系统和环境模拟三大模块的仿真系统,其中动力学模型基于牛顿-欧拉方程,控制系统采用PID调节器。重点展示了MATLAB函数实现的风扰动模型和姿态控制算法,通过设置输入信号和输出显示模块完成闭环仿真。最后通过多次风速条件下的仿真测试评估控制系统的抗干扰能力和稳定性表现,为无人机控制系统设计提供了有效的仿真验证方法。

xiaoheshang_123的博客 322

【❌❌深入浅出,九浅一深⭕⭕】《深入理解计算机系统》CSAPP

《计算机系统基础》30’ 一、处理器的时序电路 1、CPU中的时序电路 答: CPU中的时序电路:通过RS触发器控制CPU的时序。 2、单周期处理器的设计 答: CPU在处理指令时,一般需要经过以下几个步骤: 1)取指令(IF) 根据程序计数器PC中的指令地址,从存储器中取出一条指令,同时,根据指令字长度自动递增产生下一条指令所需要的指令地址,但遇到“地址转移”指令时,则控制器把“转移地址”送入PC,当然得到的“地址”需要做些变换才送入PC。 2)指令译码(ID) 对取指令操作中得到的指令进行分析并译码,确

谁吃薄荷糖 25万+

SAP MD81创建客户独立需求简介

正常我们用的最多的计划独立需求都是使用的是MD61 ,今天我们说下SAP的另外的一个标准功能客户独立需求MD81。虽然SAP给这个TCODE的描述是客户独立需求,但是实际是没有地方去关联对应的客户信息的。可以看到根据客户需求产生了对应的计划订单,我们创建的时候选择的KSV是按库存生产的,所以转换的时候生产订单也按单生产的。上面填写的这些字段的信息是不是和我们销售订单里面的字段的信息很相似。1)填写交货日期,可以选择按月 ,按日,按周等类型选择对应的日期。保存后会显示对应的客户独立需求的号码,如下图。

我小时候很黑的博客 2904

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

一口气了解大模型相关通识,基础笔记!

,特指部分参数的微调方法,这种方法算力功耗比更高,也是目前最为常见的微调方法;除此之外,Fine-Tuning也可以代指全部微调方法,同时OpenAI中模型微调API的名称也是需要注意的是,OpenAI提供的在线微调方法也是一种高效微调方法,并不Fine-Tuning,是全量微调;微调, Fine-Tuning,一般指全参数的微调 (全量微调) ,指是一类较早诞生的微调方法,全参数微调需要消耗大量的算力,实际使用起来并不方便,因此不久之后又诞生了只围绕部分参数进行微调的高效微调方法;

qq_18466193的博客 4681

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

大模型的分类:探索多样化的人工智能模型

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;随着对大模型研究的深入,未来将出现更多结构新颖的大模型,以适应不同类型的数据和任务需求。

2401_85390073的博客 3235

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

马斯克甩出王炸,大模型Gork开源了!

大家好,我是程序员小灰。最近一段时间,AI领域的大事件真的是层出不穷,从2月份的Sora到3月初的Claude3,每一个新产品都掀起了AI领域的巨浪。就在两天前,马斯克旗下的xAI公司宣布,开源他们的首款大模型Grok-1!这一举措,绝对会对全球的AI领域造成巨大的影响。Grok-1究竟有多厉害?在xAI的官方网站上显示,Grok-1是一个混合专家模型,拥有3140亿参数。这个参数量使得Grok-...

程序员小灰的博客 1862

大模型有几种类型(非常详细),零基础入门到精通,看这一篇就够了

大模型有几种类型(非常详细),零基础入门到精通,看这一篇就够了

Python单行客的博客 8163

【26届校招】快手大模型算法岗面经:从多模态模型到LoRA技术,面试官常问问题详解!

这篇文章是一份大模型技术面试面经,包含了一面和二面的面试问题。内容涵盖多模态大模型(BLIP-2、Qwen-VL等)、模型架构(Wide&Deep、DCN、LoRA)、大模型后训练方法、SAM、多模态RAG等专业知识,以及概率题和代码题。文章还提供了项目提升和面试辅导的联系方式,适合准备大模型相关面试的技术人员参考。

Trb701012的博客 1503

开源版Claude Code大揭秘:客户端如何支持本地大模型?Ollama配置教程,一学就会!

本文介绍了开源版Claude Code的三大优势:开源可修改、支持任意模型、跨平台客户端。重点演示了如何配置本地大模型:通过Ollama启动模型后,创建配置文件指定本地API地址和模型名称,即可在客户端调用。同时推荐了第三方API平台siliconflow,提供多种模型选择。最后指出AI人才缺口巨大,并分享了包含学习路线、面试题等资料的AI大模型学习资源包,适合零基础到进阶的不同人群。

bugyinyin的博客 957

大模型应用开发:大模型分类和常见大模型

模型微调的基本思想是使用少量带标签的数据对预训练模型进行再次训练,以适应特定任务。在这个过程中,模型的参数会根据新的数据分布进行调整。这种方法的好处在于,它利用了预训练模型的强大能力,同时还能够适应新的数据分布。因此,模型微调能够提高模型的泛化能力,减少过拟合现象。

大模型工程师老蓝的博客 2715

什么是大模型?一文读懂大模型的基本概念

大模型通过训练海量数据来学习复杂的模式和特征,具有更强大的泛化能力,可以对未见过的数据做出准确的预测。引申到模型层面,涌现能力指的是当模型的训练数据突破一定规模,模型突然涌现出之前小模型所没有的、意料之外的、能够综合分析和解决更深层次问题的复杂能力和特性,展现出类似人类的思维和智能。ChatGPT对大模型的解释更为通俗易懂,也更体现出类似人类的归纳和思考能力:大模型本质上是一个使用海量数据训练而成的深度神经网络模型,其巨大的数据和参数规模,实现了智能的涌现,展现出类似人类的智能。

weixin_46880696的博客 11万+

ESP-01S 和树莓派pico,普中51单片机开发板,综合比较

可以!完全可以!而且非常标准、非常高级!强MCU(Pico)做主控弱MCU(ESP-01S)做专用功能电脑主板就是这么设计的你这个思路完全正确、非常专业安全 → 随便用 → 主要当LED/继电器ESP8266 是为 WiFi 设计,算力是赠品Pico 是为高性能主控设计,算力是主业RAM 差 7 倍单核 vs 双核主频低 vs 主频高ESP8266 是网卡,Pico 是电脑!Pico + ESP-01S 最强架构方案让 Pico 当飞控/主控,ESP-01S 当WiFi,做一个。

AnalogElectronic的博客 1万+

大模型分类详解及其应用场景

大模型可以根据处理的数据类型、任务领域、技术架构和模型规模进行分类。按数据类型分为自然语言处理(NLP)、计算机视觉(CV)、语音模型和多模态模型,分别处理文本、图像、音频及多种模态数据。按任务领域,NLP模型可细分为生成、理解、翻译和推理任务,CV模型分为生成式、分析式、3D视觉和视频任务,语音模型则包括语音识别、合成、情感分析和克隆。

qq_36801966的博客 2438

信创生态技术栈:国产芯片 + 操作系统 + 数据库 + 中间件全解析

本文全面解析了信创产业的全栈技术体系,深入剖析了国产 CPU(龙芯、飞腾、鲲鹏、兆芯、海光、申威)、操作系统(统信 UOS、麒麟 OS、欧拉、龙蜥)、数据库(OceanBase、TiDB、openGauss 等)、中间件(东方通、普元、中创)的技术特点和市场格局。通过兼容性认证体系解读和典型应用场景分析,提供了完整的信创生态图谱。

腾讯云创作之星、华为云云享专家,深耕电商全栈高并发系统实战,分享可商用商城项目源码。 8275
上一篇: AI智能体(Agent)实战教程:从底层原理到LangGraph实现!
下一篇: 2026年学大模型,别乱读书!这13本“硬核书单”就是你的高效知识地图,啃完体系自成
Agent学习路线
博客等级 码龄6年 1万+粉丝 1904原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值