


前言
本文重点介绍大模型意图识别能力在智能电视核心链路中的落地过程和思考,对比了基础模型、RAG 、以及7b模型微调三种方案的优缺点。
业务背景
今年是智能电视行业在AI领域发力的元年,各厂家纷纷在自家电视OS中融入大模型能力,某国产品牌厂家更是提出了“可见即可说”的概念,希望借助AI大模型强大的自然语言处理以及逻辑推理能力,在电视端提升用户体验以及创造新的业务增长场景。
通过下面这个视频可以先对整体交互有个概念:
用户不再是简单的发出系统指令,而是可能会问出更具有个性化需求的问题,比如以下几个典型的问题:
介绍一下李白
帮我播放两个男人在天台决斗的电影
打开右下角那个电视剧
我想听一个小朋友不好好吃饭就会肚子疼的故事
深圳最近有哪些新闻?
夏洛特烦恼这部电影中夏洛这个角色是不是沈腾演的?
电影战狼3的上映时间是什么时候?
基于传统NLP算法的智能电视交互痛点
智能电视的概念其实在十几年前就已经提出了,经过许多年的迭代已经初步具备人机智能交互的能力,但是在传统NLP技术体系下,有几个问题导致体验无法进一步提升,比如复杂语境下的意图识别问题、上下文理解和多轮对话问题、泛化推理问题等。
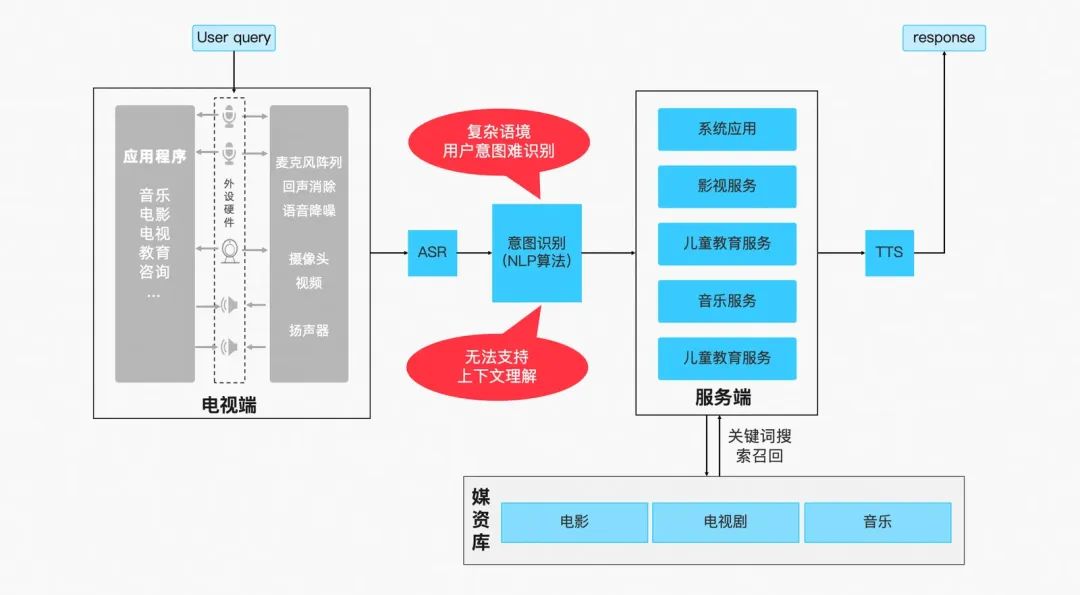
比如用户可能会问“我想看两个男人在天台决斗的电影”,此类问题在传统NLP技术下是难以做到识别用户是想看《无间道》的意图的,而大模型强大的泛化推理能力可以很好的解决。
传统NLP算法在意图识别场景的不足和局限性
语言理解能力
-
语义理解深度有限: 传统 NLP 算法多依赖于基于规则的方法,像早期的专家系统,通过人工编写大量规则来解析语义,但面对自然语言的高度灵活性,这些规则难以穷尽所有情况。以依存句法分析为例,在一些简单句中它能识别出词语间的语法关系,可一旦遇到复杂的长难句准确性大打折扣。
-
上下文感知能力不足: 像隐马尔可夫模型(HMM)这样传统用于 NLP 的算法,其在处理文本时大多聚焦于局部的状态转移概率,对上下文连贯的长序列信息整合能力欠佳。与之对比,大模型的Transformer 架构能让模型同时关注输入文本不同位置信息,在多轮交互场景下表现较好。
交互体验方面
-
多轮对话效果不佳: 传统的对话管理系统常采用有限状态机(FSM)算法构建,它依据预设的状态转移规则驱动对话流程,在面对电视多轮对话场景有一定局限性。
-
灵活性和泛化性差: 在智能电视内容搜索场景,用户搜索词偏个性化时,如从 “科幻电影” 变为 “带有科幻元素的冒险电影”,基于布尔逻辑构建的检索系统可能无法精准匹配新需求,因其检索模式固化。大模型凭借海量数据训练出的泛化能力,能适应多样表述。
知识更新和拓展方面
-
知识更新困难: 传统知识工程方法构建的知识库,如影视知识问答库,靠人工录入更新,新片上映、影视潮流变化后,知识更新滞后。而大模型可通过持续从互联网抓取最新资讯,如新闻、影评等数据,自动学习新知识,依据新信息实时优化回答,保持智能电视知识服务前沿性。
-
知识拓展能力有限: 传统 NLP 算法训练好的模型任务针对性强,如专用于电影推荐的协同过滤算法模型,若拓展到跨领域影视知识科普,需重新设计训练。大模型得益于海量数据学习的通用性,从影视娱乐知识可拓展到与之相关的文化历史、科技特效等领域知识讲解,满足智能电视用户多元化需求。
因此在整个链路中,首先重点要解决的就是意图识别问题,我们在意图识别领域使用大模型对传统NLP能力进行了全面升级,本文的重点也是介绍大模型意图识别能力在智能电视AI OS的核心链路中落地过程和思考。
意图识别场景解析
意图识别概念介绍
意图识别(Intent Classification),是一种自然语言处理技术,用于分析用户的输入并将其映射到某个预定义的意图类别。这种技术在问答机器人、智能客服、虚拟助手等领域被广泛使用。其目的是通过分析用户的文本或语音输入,识别用户的询问、请求或指示真正的目的,从而提供个性化、准确的服务。
例如,在智能客服场景中,用户输入的语句可能比较模糊、复杂,包含着咨询、抱怨、建议等多种潜在意图,大模型通过意图识别能力,剖析语句的语言模式、关键词以及语义关联等,准确判断出用户究竟是想要咨询产品功能,还是对服务质量有所不满,从而针对性地给出恰当回复,有效提升客户服务体验。
在大模型的应用体系里,意图识别处于十分关键的位置,它就像是一座桥梁,连接着用户模糊或明确的表达与大模型后续具体的任务执行,只有精准完成这一步骤,才能保证后续一系列动作的准确性和有效性,让大模型真正成为帮助用户解决问题、满足需求的有力工具。
例如下面是一个企业内部对话机器人的例子:

在意图层面有以下几个概念:
意图改写: 指在不改变用户原始意图的前提下,对用户表达意图的文本内容进行重新表述。例如,原始文本为 “明天的天气”,改写后的文本可以是 “帮我查一下明天的天气状况”。通过意图改写可以有效提高大模型输出的准确率。
意图分类: 通过给不同的意图分配特定标签,便于大模型进行快速分类和处理。比如将意图分为 “查询类”“预订类”“咨询类” 等大的类别标签,在 “查询类” 下又可以细分出 “查询天气”“查询航班” 等具体标签。当用户输入内容后,大模型依据这些预设的标签体系,能够迅速判断出所属类别,从而采取相应的处理逻辑。
意图槽位: 意图槽位在大模型意图识别中起着关键作用,它就像是一个个精准捕捉用户需求的 “小格子”。例如在用户预订机票的场景中,像出发地、目的地、出发时间、航班舱位等级等这些关键要素都可以看作是不同的意图槽位。大模型通过分析用户输入的语句,尝试将对应的信息填充到相应的槽位里,以此来更好地理解用户究竟想要做什么。
意图置信度: 是指模型在预测用户意图时的自信程度。通常用一个概率值来表示,概率越高,表示模型对预测的意图越有信心。例如,模型预测用户意图是 “产品咨询”,置信度为 0.9,这就表明模型比较确定用户的意图是产品咨询;如果置信度为 0.4,说明模型对这个预测不是很有把握。
意图识别在智能电视中的落地挑战
由于该场景处于电视C端业务的核心交互链路上,因此对意图识别模块也提出了更高的要求。该场景的落地挑战主要来自于以下几个方面:
1.延迟要求:由于全链路较长,用户对延迟容忍度低,因此对意图识别模型的延迟要求也非常苛刻,通常需要在500ms-800ms左右必须返回全包,以供后续链路继续处理业务。
2.准确性要求:C端用户对整体体验效果敏感,不准确的意图会导致全链路功能失效,无法达到用户预期。因此对意图识别模型的准确性要求非常高,需要保证简单指令100%准确率,复杂指令98%+准确率。
3.实时数据处理能力:由于电视场景的特性,业务上需要涉及到最新的媒资信息或互联网上较新的梗,例如“老默吃鱼”,单纯靠基模能力无法有效理解。因此需要将一些较新的知识内容注入给模型。
几种落地方案选型
方案一:基模 + Prompt
方案特点:
开发成本低,适用于需要快速上线,对延时要求不高,分类相对简单的场景。
模型选择:
该方案主要靠基模的推理能力,需要根据分类难度和延时要求选择不同模型。建议至少使用32b以上的模型,如qwen-plus、qwen-max。
方案说明:
Prompt的实现也有较多写法,这里是一些常用的实现技巧:
(1)CoT 思维链
CoT的核心在于引导模型逐步构建一个逻辑链,这个链由一系列相关的推理步骤组成,每个步骤都是基于前一步的结果。这种方法有助于模型更好地理解问题的上下文和复杂性,并且增强了模型输出的解释性和可信度。
# 思考步骤
为了完成上述目标,请按照下面的过程,一步一步思考后完成:
1.首先需要先理解候选的意图信息共有如下{}个类别,每个意图的含义或常见描述如下:
{}
(2)Few-Shot 少样本学习
大模型具备强大的少样本学习能力,通过在prompt中引入few shot少样本可有效提高大模型在意图识别分类任务中的能力。例如:
2. 然后,观察以下意图识别分类案例,学习意图识别分类任务的能力:
{}
(3)特定准则重点说明
3. 意图识别前,请重点学习并记住以下识别准则:
{}
(4)输出示例
4. 请以JSON格式进行输出,输出示例:
{}
方案缺点:
-
对垂类领域分类的识别有一定局限性
-
由于对模型推理能力有一定要求,选用大尺寸模型会带来一定延迟开销
基于以上原因,我们放弃了基模 + 提示词的方案,该场景更适合业务相对简单,延迟要求不敏感的业务场景。

方案二:基模 + Prompt + RAG
RAG介绍:
检索增强生成(Retrieval-Augmented Generation,RAG)指的是在LLM回答问题之前从外部知识库中检索相关信息,RAG有效地将LLM的参数化知识与非参数化的外部知识库结合起来,使其成为实现大型语言模型的最重要方法之一
-
早期的神经网络模型,在处理需要依赖外部知识或特定信息的任务时遇到了瓶颈。
-
LLM的问题: 幻觉、依赖信息过时、缺乏专业领域知识。
-
RAG的提出,是为了解决如何将广泛的、分布式的外部信息库与生成模型相结合,从而提高模型在问答、摘要等任务中的性能和准确度。

方案特点:
鉴于方案一中垂类领域知识的问题,考虑加入RAG能力解决。通过在知识库中上传大量的意图分类知识,使得该方案可以理解较为垂类或更个性化要求的分类判定逻辑。
模型选择:
该方案引入了RAG能力,对模型推理要求不是很高,建议选用性能相对性价比较高的模型,如qwen-turbo、qwen-plus。
方案说明:
以下是一些建议的步骤:
(1)意图语料结构设计
首先我们需要定义不同意图的分类以及其槽位的设计,这些设计会和实际的业务场景以及后续承载具体实现的Agent密切相关,例如:

(2)数据生成
- query语句生成:
这里可以考虑给一些生产上用户可能问的query示例,用LLM生成一批同义句,此处不再赘述
- 意图结果生成:
根据前面设计的意图语料结构,使用大尺寸模型生成相关意图分类和槽位,并可加入在线搜索相关能力,代码示例和Prompt如下:
prompt = """
# 角色
你是一位意图样本生成专家,擅长根据给定的模板生成意图及对应的槽位信息。你能够准确地解析用户输入,并将其转化为结构化的意图和槽位数据。

## 技能
### 技能1:解析用户指令
- **任务**:根据用户提供的自然语言指令,识别出用户的意图。

### 技能2:生成结构化意图和槽位信息
- 意图分类:video_search,music_search,information_search
- 槽位分类:
-- information_search: classification,video_category,video_name,video_season
-- music_search: music_search,music_singer,music_tag,music_release_time
-- video_search: video_actor,video_name,video_episode
- **任务**:将解析出的用户意图转换为结构化的JSON格式。
  - 确保每个意图都有相应的槽位信息,不要自行编造槽位。
  - 槽位信息应包括所有必要的细节,如演员、剧名、集数、歌手、音乐标签、发布时间等。

### 技能3:在线搜索
- 如果遇到关于电影情节的描述,可以调用搜索引擎获取到电影名、演员等信息称补充到actor,name等槽位中

### 输出示例
  - 以JSON格式输出,例如:
    -"这周杭州的天气如何明天北京有雨吗":{'infor_search':{'extra_info':['这周杭州的天气如何明天北京有雨吗']}}
    -"我一直在追赵丽颖的楚乔传我看到第二十集了它已经更新了吗我可以看下一集吗":{'video_search':{'video_actor':['赵丽颖'],'video_name':['楚乔传'],'video_episode':['第21集'],'extra_info':['我一直在追赵丽颖的楚乔传我看到第二十集了它已经更新了吗我可以看下一集吗']}}

## 限制
- 只处理与意图生成相关的任务。
- 生成的意图和槽位信息必须准确且完整。
- 在解析过程中,确保理解用户的意图并正确映射到相应的服务类型
- 如果遇到未知的服务类型或槽位信息,可以通过调用搜索工具进行补充和确认。
- 直接输出Json,不要输出其他思考过程
生成后的用于知识库的数据集格式如下:
[{
"instruction":"播放一首七仔的歌曲我想听他的经典老歌最好是70年代的音乐风格",
"output":"{'music_search':{'singer':['张学友'],'music_tag':['经典老歌'],'release_time':['70年代']}}"
}]
(3)知识上传和向量化
这里有非常多成熟的方案可以选择,可以考虑阿里云百炼平台的RAG方案,此处不再赘述。
方案缺点:
-
需要做数据预处理,有一定开发成本;
-
知识库内容较多或质量不佳时,可能引起模型幻觉和分类冲突;
-
相比方案1,会增加向量召回部分的延迟,且模型要求依然在14b以上,有一定延迟问题;
因此,该方案也不太适用于电视C端交互链路上,但是方案二关于数据增强的思路还是值得借鉴的,基于这个思路,我们可以尝试用小尺寸模型SFT的方案
方案三:使用小尺寸模型进行SFT
方案特点:
通过小尺寸模型解决延迟问题,通过微调解决数据增强问题
模型选择:
一般而言,模型底座越大,下游任务效果越好,但是部署成本和推理代价相应增大。针对意图识别的场景,建议从4B左右的大模型底座开始进行SFT和调参,当效果较大同时通过调参无法进一步提升时,建议换成7B的更大底座。超过10B的底座理论上能得到更好的结果,但是需要权衡实际的效果和成本问题,因此本场景使用7B的底座性价比较高。
微调方案:
选用LoRA方式进行微调

LoRA 原理(来源 LoRA 论文:LORA: LOW-RANK ADAPTATION OF LARGE LANGUAGE MODELS)
LoRa算法在固定主预训练参数的情况下,用支路去学习特定任务知识,来完成特定任务。它的假设为模型适应时的权重改变总是“低秩”的。训练方法为在每层transfomer block旁边引入一个并行低秩的支路,支路的输入是transfomer block的输入,然后将输出和transfomer block的输出相加。训练完后将原始权重加上LoRA训练的权重( ),最终使得模型结构不变。
方案说明:
SFT的大致流程如下:

(1)意图语料结构设计
参考方案二中的意图预料设计,此处不再赘述
(2)样本生成
样本生成有很多方式,比如前面提到的LLM生成或是引入一些数据预处理工具。笔者这里使用的是PAI-iTag工具。首先,将用于iTag标注的数据注册到PAI数据集,该数据集为manifest格式文件,内容示例如下:
{"data":{"instruction": "我想听音乐"}}
{"data":{"instruction": "太吵了,把声音开小一点"}}
{"data":{"instruction": "我不想听了,把歌关了吧"}}
{"data":{"instruction": "我想去杭州玩,帮我查下天气预报"}}
标注完成后可以将标注结果导出至OSS,在本示例中,输出文件内容如下:
{"data":{"instruction":"我想听音乐
","_itag_index":""},"label-1787402095227383808":{"results":[{"questionId":"2","data":"play_music()","markTitle":"output","type":
"survey/value"}]},"abandonFlag":0,"abandonRemark":null}
{"data":{"instruction":"太吵了,把声音开小一点
","_itag_index":""},"label-1787402095227383808":{"results":[{"questionId":"2","data":"volume_down()","markTitle":"output","typ
e":"survey/value"}]},"abandonFlag":0,"abandonRemark":null}
{"data":{"instruction":"我不想听了,把歌关了吧
","_itag_index":""},"label-1787402095227383808":{"results":[{"questionId":"2","data":"music_exit()","markTitle":"output","type":"
survey/value"}]},"abandonFlag":0,"abandonRemark":null}
{"data":{"instruction":"我想去杭州玩,帮我查下天气预报
","_itag_index":""},"label-1787402095227383808":{"results":[{"questionId":"2","data":"weather_search(杭
州)","markTitle":"output","type":"survey/value"}]},"abandonFlag":0,"abandonRemark":null}
标注完成的数据格式说明参考标注数据格式概述。为了在PAI-ModelGallery
种使用标注数据进行模型训练,需要将上述文件转化为PAI-ModelGallery
接受的训练数据格式,可以参考如下Python脚本:
# 输入文件路径和输出文件路径
input_file_path = 'test_json.manifest'
output_file_path = 'train.json'

converted_data = []
with open(input_file_path, 'r', encoding='utf-8') as file:
    for line in file:
        data = json.loads(line)
        instruction = data['data']['instruction']
        for key in data.keys():
            if key.startswith('label-'):
                output = data[key]['results'][0]['data']
                converted_data.append({'instruction': instruction, 'output': output})
                break

with open(output_file_path, 'w', encoding='utf-8') as outfile:
    json.dump(converted_data, outfile, ensure_ascii=False, indent=4)
(3)模型训练参数设置
- 全参数微调 OR 轻量化微调(LoRA和QLoRA)
全参数微调消耗计算资源最多,而且容易使大模型产生灾难性遗忘,LoRA和QLoRA有效地避免了这个问题。另一方面,QLoRA由于参数精度低,容易对下游任务的效果产生不利影响。综合考虑,使用LoRA算法进行微调。
- 全局批次大小
全局批次大小=卡数*per_device_train_batch_size*gradient_accumulation_steps
这里在GPU显存允许的情况下尽可能调大batch size,可以使得模型更快收敛到最优解,同时具有较高的泛化能力。
- 序列长度
序列长度对显存消耗和训练效果有较大的影响,过小的序列长度虽然节省了显存,但是导致某些比较长的训练数据集被切断,造成不利影响;过大的序列长度又会造成显存的浪费。从意图识别的场景来看,根据实际数据的长度,选择64/128/256的长度比较合适。
- 学习率
如果训练数据质量比较差,训练效果一般会受影响,所以在数据标注的时候需要进行充分的质量校验。同时,由于LoRA训练一般参数调整空间不大,学习率默认可以进行偏大设置,例如1e-4左右,当训练loss下降过慢或者不收敛时,建议适当调大学习率,例如3e-4或者5e-4。不建议使用1e-3这个量级的学习率,容易得不到优化的结果。
- 模型选择
一般而言,模型底座越大,下游任务效果越好,但是部署成本和推理代价相应增大。针对意图识别的场景,建议从4B左右的大模型底座开始进行SFT和调参,当效果较大同时通过调参无法进一步提升时,建议换成7B的更大底座。超过10B的底座理论上能得到更好的结果,但是需要权衡实际的效果和成本问题,因此,因此本场景使用7B的底座性价比较高。
(4) 启动训练任务

值得注意的是,如果需要在训练过程中改变默认的system_prompt,让大模型扮演某种特定的角色,可以在Qwen1.5系列模型的训练中配置自定义的
system_prompt,例如“你是一个意图识别专家,可以根据用户的问题识别出意图,并返回对应的意图和参数”。在这种情况下,给定一个训练样本:
[
    {
        "instruction":"我想听音乐",
        "output":"play_music()"
    }
]
实际用于训练的数据格式如下:
<|im_start|>system\n你是一个意图识别专家,可以根据用户的问题识别出意图,并返回对应的意图和参数
<|im_end|>\n<|im_start|>user\n我想听音乐<|im_end|>\n<|im_start|>assistant\nplay_music()<|im_end|>\n
当设置apply_chat_template为true并且添加system_prompt,算法会自行对训练数据进行扩展,无需关注执行细节。
(5) 模型离线评测
当模型训练结束后,可以使用如下Python脚本进行模型效果的评测。假设评测数据如下:
[
    {
        "instruction":"想知道的十年是谁唱的?",
        "output":"music_query_player(十年)"
    },
    {
        "instruction":"今天北京的天气怎么样?",
        "output":"weather_search(杭州)"
    }
]
评测脚本如下所示:
#encoding=utf-8
from transformers import AutoModelForCausalLM, AutoTokenizer
import json
from tqdm import tqdm

device = "cuda" # the device to load the model onto

# 修改模型路径
model_name = '/mnt/workspace/model/qwen14b-lora-3e4-256-train/'
print(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype="auto",
    device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained(model_name)

count = 0
ecount = 0


# 修改训练数据路径
test_data = json.load(open('/mnt/workspace/data/testdata.json'))
system_prompt = '你是一个意图识别专家,可以根据用户的问题识别出意图,并返回对应的函数调用和参数。'

for i in tqdm(test_data[:]):
    prompt = '<|im_start|>system\n' + system_prompt + '<|im_end|>\n<|im_start|>user\n' + i['instruction'] + '<|im_end|>\n<|im_start|>assistant\n'
    gold = i['output']
    gold = gold.split(';')[0] if ';' in gold else gold

    model_inputs = tokenizer([prompt], return_tensors="pt").to(device)
    generated_ids = model.generate(
        model_inputs.input_ids,
        max_new_tokens=64,
        pad_token_id=tokenizer.eos_token_id,
        eos_token_id=tokenizer.eos_token_id,
        do_sample=False
    )
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    pred = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
    if gold.split('(')[0] == pred.split('(')[0]:
        count += 1
        gold_list = set(gold.strip()[:-1].split('(')[1].split(','))
        pred_list = set(pred.strip()[:-1].split('(')[1].split(','))
        if gold_list == pred_list:
            ecount += 1
    else:
        pass

print("意图识别准确率:", count/len(test_data))
print("参数识别准确率:", ecount/len(test_data))
(6)模型部署
部署的推理服务支持使用ChatLLM WebUI进行实时交互,也可以使用API进行模型推理,具体使用方法参考5分钟使用EAS一键部署LLM大语言模型应用:
https://help.aliyun.com/zh/pai/use-cases/deploy-llm-in-eas
以下给出一个示例request客户端调用:
import argparse
import json
from typing import Iterable, List

import requests

def post_http_request(prompt: str,
                      system_prompt: str,
                      history: list,
                      host: str,
                      authorization: str,
                      max_new_tokens: int = 2048,
                      temperature: float = 0.95,
                      top_k: int = 1,
                      top_p: float = 0.8,
                      langchain: bool = False,
                      use_stream_chat: bool = False) -> requests.Response:
    headers = {
        "User-Agent": "Test Client",
        "Authorization": f"{authorization}"
    }
    pload = {
        "prompt": prompt,
        "system_prompt": system_prompt,
        "top_k": top_k,
        "top_p": top_p,
        "temperature": temperature,
        "max_new_tokens": max_new_tokens,
        "use_stream_chat": use_stream_chat,
        "history": history
    }
    response = requests.post(host, headers=headers,
                             json=pload, stream=use_stream_chat)
    return response

def get_response(response: requests.Response) -> List[str]:
    data = json.loads(response.content)
    output = data["response"]
    history = data["history"]
    return output, history

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--top-k", type=int, default=4)
    parser.add_argument("--top-p", type=float, default=0.8)
    parser.add_argument("--max-new-tokens", type=int, default=2048)
    parser.add_argument("--temperature", type=float, default=0.95)
    parser.add_argument("--prompt", type=str, default="How can I get there?")
    parser.add_argument("--langchain", action="store_true")

    args = parser.parse_args()

    prompt = args.prompt
    top_k = args.top_k
    top_p = args.top_p
    use_stream_chat = False
    temperature = args.temperature
    langchain = args.langchain
    max_new_tokens = args.max_new_tokens

    host = "EAS服务公网地址"
    authorization = "EAS服务公网Token"

    print(f"Prompt: {prompt!r}\n", flush=True)
    # 在客户端请求中可设置语言模型的system prompt。
    system_prompt = "你是一个意图识别专家,可以根据用户的问题识别出意图,并返回对应的意图和参数"

    # 客户端请求中可设置对话的历史信息,客户端维护当前用户的对话记录,用于实现多轮对话。通常情况下可以使用上一轮对话返回的histroy信息,history格式为List[Tuple(str, str)]。
    history = []
    response = post_http_request(
        prompt, system_prompt, history,
        host, authorization,
        max_new_tokens, temperature, top_k, top_p,
        langchain=langchain, use_stream_chat=use_stream_chat)
    output, history = get_response(response)
    print(f" --- output: {output} \n --- history: {history}", flush=True)

# 服务端返回JSON格式的响应结果,包含推理结果与对话历史。
def get_response(response: requests.Response) -> List[str]:
    data = json.loads(response.content)
    output = data["response"]
    history = data["history"]
    return output, history
在智能电视意图识别场景中,为了保证用户的交互体验,通常要求更高的延时,因此建议使用PAI提供的BladeLLM推理引擎进行LLM服务的部署。
(7)Prompt
因为主要靠微调提升效果,Promp的写法相对简单,不再预置业务规则和思维链:
{"role": "system", "content": "你是个意图识别专家,你要通过用户的输入,识别用户的意图以及槽位信息,注意:不要添加没有的意图和槽位。"}
几种方案的对比:

新的问题:准确率、时效性、成本
在实际的生成链路上,我们发现要保证准确率、时效性、以及成本之间,还有一些工作要做,主要包含以下几个灵魂拷问:
1.如何保证生产准确率持续符合要求?
互联网上的信息更新迭代很快,尤其是在娱乐性质较重的媒资类产品上,几乎每天都会产生新的电视/电影/音乐等信息;一些互联网上的梗也持续出现,比如“老默吃鱼”,“蒋欣在这里”等等,用户个性化的问法也是层出不穷,如何能持续保证生产的准确率符合98%以上的预期是一个难题。
2.如何在生产环境上对结果纠错?
电视场景的交互是以语音为主,不太涉及触屏等精细化交互操作。如果客户对某个答案不满意,并不会像PC或手机上的智能机器人那样有一个“点踩”的反馈渠道。出现大量事实性错误时,只能通过用户投诉得到反馈,这会极大有损用户体验。所以如何拿到生产的意图结论对错成为一个待解决的问题。
3.海量C端用户的指令无法穷举,大量的训练集如何产生?
我们通过微调解决垂直业务数据问题,前期我们准备的训练数据只能解决一小部分问题,实际生产上微调模型是需要不停的迭代的,那么微调的数据要从要哪里来也是一个很重要的问题。
4.训练集不停变大,反复SFT耗时耗力,有没有自动化的方案?
当我们拿到了训练集后,需要人工在平台上进行模型训练和部署,如果这个操作频率精细化到每天都要处理,那么无疑对人力成本的消耗是巨大的。所以有没有一个全自动化的方案能帮我们解决这些问题?
进阶方案:自动质检和自动微调工程链路
通过设计完整的离线质检工程链路,持续自动训练和部署最新模型,解决生产准确率、训练集和微调模型成本的问题。

该方案通过多步骤处理流程,实现了自动对线上意图质检及自动重新训练的流程。总体上分为在线流程和离线流程两部分,以下是详细的流程描述:
在线流程:
1.用户的query先经过一道意图缓存库,该库直接以query为key,将曾经正确返回的意图结果存储在es中。当缓存被命中时直接将结果返回,不再走后续链路,以此提高响应速度和保证准确性。该缓存库主要是为一些简单意图如系统指令、媒资名搜索做快速结果返回
2.如果未命中缓存,则走到后续的模型推理链路。当前使用的是微调后的qwen-7b模型
离线流程:
1.当大模型输出意图推理结果后,会异步将query+reponse传入给一个意图优化应用,作为整体质检的入口
2.调用一个大尺寸模型,例如qwen-max对结果进行质检。质检规则是输出response相对于result的得分情况,满分为1分,只有0.9分以上的答案才认为是正确的
3.如果意图准确,则重新将此次的意图结果写进缓存中,方便下次调用读取
4.如果意图得分低于0.9,认为该意图生成质量不佳,此时会尝试使用大尺寸模型如qwen-max进行意图的重新生成。需要注意的是,此质检agent会引入LLM实时搜索能力,保证对一些较新的query信息做好理解
5.当意图生成agent的答案重新通过质检后,会更新到训练集中,以供下一次SFT使用
落地效果
在某国产头部电视厂家落地过程中,最终经过多轮技术选型,我们决策使用PAI平台进行qwen-7b模型的训练和推理部署,该方案准确率和延迟上都有较大优势,平均延迟500ms,生产实时准确率达到98%+。
结尾
随着电视技术的迅猛发展和用户交互模式的日益多样化,意图识别技术在增强用户体验中发挥着不可或缺的作用。本文聚焦于电视环境中大模型意图识别的核心技术、所面临的挑战以及当前的解决方案。
AI大模型技术还在不断高速迭代更新,作为阿里云大模型技术服务团队将陪伴客户共同成长,一起见证更加智能且人性化的电视互动体验的诞生。通过持续优化和升级现有的大模型结构,并融入多维度的数据源——例如语音情感分析与视觉内容感知等先进技术,未来的电视设备将不仅能够准确理解用户的指令,还能够预判其需求,提供超越预期的个性化服务。
这种进步将重新定义观众与电视之间的互动方式,开启智能家居娱乐的新纪元。
最后的最后
感谢你们的阅读和喜欢,作为一位在一线互联网行业奋斗多年的老兵,我深知在这个瞬息万变的技术领域中,持续学习和进步的重要性。
为了帮助更多热爱技术、渴望成长的朋友,我特别整理了一份涵盖大模型领域的宝贵资料集。
这些资料不仅是我多年积累的心血结晶,也是我在行业一线实战经验的总结。
这些学习资料不仅深入浅出,而且非常实用,让大家系统而高效地掌握AI大模型的各个知识点。如果你愿意花时间沉下心来学习,相信它们一定能为你提供实质性的帮助。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
大模型知识脑图
为了成为更好的 AI大模型 开发者,这里为大家提供了总的路线图。它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。

经典书籍阅读
阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。

实战案例
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

面试资料
我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下

640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 438


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


