项目实施-14完结篇(配置自动调度)

部署HPC集群的实施方案 部署HPC集群的实施方案 济南友泉软件有限公司 一、系统配置 1.1 网络拓扑 服务器 内网IP 计算专网IP 域名 备注 登陆节点 172.17.22.16 loginserver-chaosuan 管理节点 172.17.22.13 ..... 阅读详情

概述

本篇是用户综合分析系统专栏的最后一篇。到本篇为止,我们此次的项目实施宣告终结。

我们已经完成了大数据 流处理与批处理 的设计编码,已经实现了基本的数据处理任务,但是,因为批处理一般都是定期执行的,而且多数是在非服务器高峰期的半夜执行的,因此,我们需要用到 Azkaban的任务调度,帮我们完成批处理的自动执行。

设计计划

  • 附:完整的计划zip包:

https://pan.baidu.com/s/1dR9NxB9TXE4vx879c6mMlg 获取码:jbyk

  • 整体思路

批处理 的过程是:
①先执行Flink的Table api 完成离线数据计算
②再通过Sqoop将①中执行输出的数据写到MySQL

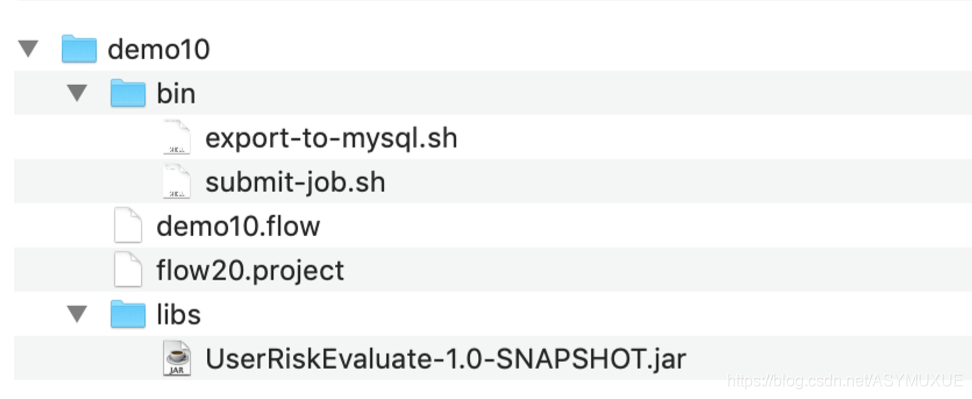
  • 整体调度计划结构
    在这里插入图片描述

说明: 此次的项目批处理设计中,批处理的读取文件地址和输出文件地址是作为参数传递的

  • libs下的代码实现
package com.baizhi.sql

import java.text.SimpleDateFormat

import org.apache.flink.api.scala.ExecutionEnvironment
import org.apache.flink.table.api.scala.BatchTableEnvironment
import org.apache.flink.table.api.scala._
import org.apache.flink.api.scala._
import java.math.{BigDecimal => JBigDecimal}

import org.apache.flink.api.common.typeinfo.TypeInformation
import org.apache.flink.api.java.io.jdbc.JDBCAppendTableSinkBuilder
import org.apache.flink.api.scala.typeutils.Types
object UserRiskErrorRateCount {
  def main(args: Array[String]): Unit = {

    val fbEnv = ExecutionEnvironment.getExecutionEnvironment
    val fbTableEnv = BatchTableEnvironment.create(fbEnv)

    //获取传递的参数
    var input=args(0)
    var output=args(1)

    val sdf= new SimpleDateFormat("yyyy-MM-dd HH:mm:ss")
    val dataSet:DataSet[(String,String,String,String,String,Boolean,Boolean,Boolean,Boolean,Boolean,Boolean,Boolean)] = fbEnv.readTextFile(input,
                            "utf-8")
                                          .map(_.split("\\s+"))
                                          .map(ts => (ts(0),ts(1),sdf.format(ts(3).toLong),ts(4),ts(5),ts(6).toBoolean,
                                           ts(7).toBoolean,ts(8).toBoolean,ts(9).toBoolean,ts(10).toBoolean,ts(11).toBoolean,ts(12).toBoolean))

    val table = fbTableEnv.fromDataSet(dataSet,'appName,'userIdentified,'evaluateTime,'cityName,'geoPoint,'area,'device,'inputfeature, 'similarity, 'speed,'timeslot,'total)
    //注册视图
    fbTableEnv.createTemporaryView("t_report",table)

    table.select("appName, userIdentified,evaluateTime,cityName,geoPoint,area,device,inputfeature,similarity, speed,timeslot,total")
      .toDataSet[(String,String,String,String,String,Boolean,Boolean,Boolean,Boolean,Boolean,Boolean,Boolean)]
      .print()


    var tableSink = new JDBCAppendTableSinkBuilder()
      .setDBUrl("jdbc:mysql://localhost:3306/test")
      .setDrivername("com.mysql.jdbc.Driver")
      .setUsername("root")
      .setPassword("root")
      .setBatchSize(1000)
      .setQuery("INSERT INTO error_rate(app_name,area_rate,device_rate,inputfeature_rate,similarity_rate,speed_rate,timeslot_rate,total_rate,total,start,end) values(?,?,?,?,?,?,?,?,?,?,?)")
      .setParameterTypes(Types.STRING, Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.INT,Types.STRING, Types.STRING)
      .build();

    fbTableEnv.registerTableSink("Result",
      Array("app_name","area_rate","device_rate","inputfeature_rate","similarity_rate","speed_rate","timeslot_rate","total_rate","total","start","end"),
      Array[TypeInformation[_]](Types.STRING, Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.JAVA_BIG_DEC,Types.INT, Types.STRING, Types.STRING),
      tableSink)

    //获取时间参数
    var start=args(2)
    var end=args(3)
    //计算因子触发率
    val sql=
      s"""
        select appName,
        round(sum(case area when true then 1.0 else 0 end)/count(area),2)  as  area_rate,
        round(sum(case device when true then 1.0 else 0 end)/count(device),2)  as  device_rate,
        round(sum(case inputfeature when true then 1.0 else 0 end)/count(inputfeature),2)  as  inputfeature_rate,
        round(sum(case similarity when true then 1.0 else 0 end)/count(similarity),2)  as similarity_rate,
        round(sum(case speed when true then 1.0 else 0 end)/count(speed),2)  as  speed_rate,
        round(sum(case timeslot when true then 1.0 else 0 end)/count(timeslot),2)  as  timeslot_rate,
        round(sum(case total when true then 1.0 else 0 end)/count(total),2)  as  total_rate,
        count(*) as total
        from (select * from t_report where evaluateTime between '${start}' and '${end}')
        group by appName
      """

    fbTableEnv.sqlQuery(sql)
      .addColumns(s"'${start}' as start")
      .addColumns(s"'${end}' as end")
      .toDataSet[(String,JBigDecimal,JBigDecimal,JBigDecimal,JBigDecimal,JBigDecimal,JBigDecimal,JBigDecimal,Long,String,String)]
      .map(t => t._1+","+t._2+","+t._3+","+t._4+","+t._5+","+t._6+","+t._7+","+t._8+","+t._9+","+t._10+","+t._11)
      .writeAsText(output,WriteMode.OVERWRITE)

          fbEnv.execute("UserRiskErrorRateCount")

  }
}

  • flow20.project

2.0版本的 任务调度

 azkaban-flow-version: 2.0
  • demo10.flow
---
config:
  user.to.proxy: root
  failure.emails: zyl.m@qq.com
  success.emails: zyl.m@qq
  notify.emails: zyl.m@qq

nodes:
  - name: UserRiskErrorRateCount
    type: command
    config:
      command: sh ./demo10/bin/submit-job.sh ${input} ${output}

  - name: ExportToMysQL
    type: command
    dependsOn:
      - UserRiskErrorRateCount
    config:
      command: sh ./demo10/bin/export-to-mysql.sh ${out} 

${}----->表示传参,第二个任务的参数out,由第一个任务的执行计划传递

  • 第一个任务 Submit-job.sh
#!/usr/bin/env bash 
base_path=$(pwd)
jar_path=$base_path/demo10/libs/UserRiskEvaluate-1.0-SNAPSHOT.jar
start_time=$(date -d -1month '+%Y-%m-%d')
end_time=$(date '+%Y-%m-%d')

input=$1
output=$2

/usr/flink-1.10.0/bin/flink run --class com.baizhi.sql.UserRiskErrorRateCount --parallelism 4 --jobmanager centos:8081 $jar_path $input $output $start_time  $end_time 

echo '{"out":"'$output'"}' > $JOB_OUTPUT_PROP_FILE

说明: ${date -d -1month ‘+%Y-%m-%d’} 表示获取当前时间减去一个月的时间,作为传递到批处理计算的第三个参数,后面的end_time作为第四个参数

  • 第二个任务 export-to-mysql.sh
#!/usr/bin/env bash 
sqoop export --connect jdbc:mysql://CentOS:3306/test --username root --password root --table error_rate --update-key app_name --update-mode allowinsert --export-dir $1 --input-fields-terminated-by ','
  • 将以上文件打成Zip包,上传到Azkaban的客户端,提交执行即可。

测试

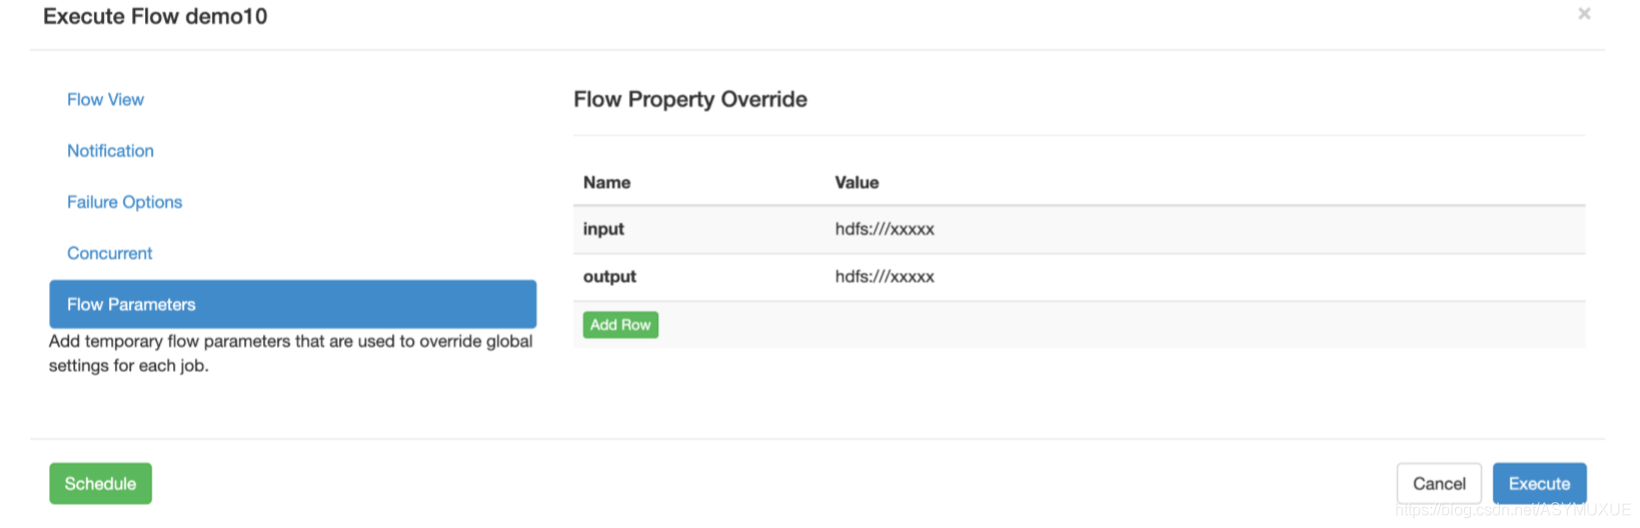
在这里插入图片描述

在以上界面中填写参数即可 注:参数名一定要与脚本中的名字一致

附

本次项目的完整源码:
https://pan.baidu.com/s/1YLcfiaiYIe0Gnj9IY2wYgQ 获取码:ag8t


2020-04-10 项目结束,有缘再见。-----------------------项目交付就跑路的项目经理。
关于分布式任务调度平台xxl-job的本地配置实例 最近闲来无事研究了下xxl-job,是个开源分布式任务调度平台。一、基本概念XXL-JOB是一个轻量级分布式任务调度框架,其核心设计目标是开发迅速、学习简单、轻量级、易扩展。现已开放源代码并接入多家公司线上产品线,开箱即用。二、特性1、简单:支持通过Web页面对任务进行CRUD操作,操作简单,一分钟上手;2、动态:支持动态修改任务状态、暂停/恢复任务,以及终止运行中任务,即时生效;3、调度中心HA... 阅读详情

相关推荐

Android14 SurfaceFlinger启动流程与线程调度机制解析

本文深入解析Android14中SurfaceFlinger的启动流程与线程调度机制,详细介绍了从初始化、Binder线程优先级管理到VSYNC信号分发体系的构建过程。通过实际案例和性能数据,揭示了图形合成服务的关键优化策略,帮助开发者深入理解Android显示系统的核心工作原理。

weixin_29237635的博客 155

如何进行seatunnle的脚本定期调度呢?

对于Seatunnel的脚本定期调度,你可以使用类似Linux的cron作业调度器、Apache Airflow、Apache DolphinScheduler或其他调度工具来实现。请注意,以上步骤假设你已经正确安装了Seatunnel,并且你的环境配置正确无误。这个脚本应该接受任何必要的参数,并启动你的Seatunnel任务。此外,根据你的安全设置,你可能需要在cron作业中使用绝对路径,并确保所有必要的环境变量都已正确设置。你的cron作业现在已经设置好了,并将在指定的时间自动运行。

smile6868的博客 1330

azkaban调度SQL代码

1. azkaban上新建一个project 登录azkaban后,右上角有个Create Project的按钮,点解后录入项目信息。 2.上传项目文件 前人经验,这里应该上传一个.zip的压缩文件,并且你这个.zip的压缩文件里面不要有文件目录,直接是文件。 这个压缩文件里有2个文件,一个是run.sh的脚本,一个是.job的文件。 脚本文件中存储一些认证的信息,以及文件目录等信息 kl...

fwj_ntu的博客 1926

Waterdrop帮你快速玩转Spark数据处理

Waterdrop 是一个非常易用,高性能,能够应对海量数据的实时数据处理产品,构建于Apache Spark之上。

Gary 的影响力 3027

【Android Performance】CPU EAS能量感知调度:从 Kernel 4.14 到 6.6 的配置演进指南

本文系统梳理 Android 系统中 CPU EAS(Energy Aware Scheduling,能量感知调度)的演进脉络,覆盖 Kernel 4.14 的 schedtune、Kernel 5.4 的 uclamp、Kernel 5.15/6.6 的 walt 三代配置机制。详细对比各版本的配置文件路径、关键参数含义、生效节点及 ADB 调试方法,帮助读者理解 Android 调度器如何在不同内核版本中实现"能耗与性能的动态平衡"。文中结合真实项目配置案例,附参数说明表和调试命令速查,适合做系统性能优

weixin_44081096的博客 454

医疗AI Agent实战:从零搭建一个能看病的智能助手(附完整代码)

本文详细介绍了如何从零搭建一个医疗AI Agent智能助手,涵盖核心架构设计、症状推理引擎开发、安全与合规实现以及系统集成等关键环节。通过完整的代码示例和实战案例,帮助开发者快速构建具备医疗咨询能力的智能Agent,提升医疗服务的效率和质量。

ss78901的博客 468

WaterDrop 基本使用

文章内容节选自官方文档,如有侵权请告知作者。官网地址https://github.com/InterestingLab/waterdrop

rao826699158的博客 9763

基于紫光同创FPGA的adf网表文件使用和黑匣子设置

这个时候就可以选择将你的网表文件给到他使用,就是相当于把你的功能模块封装成了一个黑匣子一样,只有外部端口,没有内部代码;,在TOP层的子模块声明里面需要加上/*synthesis syn_black_box */进行黑匣子设置,此时子层 adf 文件作为黑盒是不会综合的,在 device map 时会将顶层综合结果与子层 adf 文件合并传递至布局布线阶段;这些都设置完毕后呢,就可以对工程进行编译和综合了,综合完毕后会生成一个.adf的网表文件,我们要使用的就是这个文件;我这里是把两个子模块的添加了哈;

H2061722的博客 966

Clickhouse导数工具waterdrop用法

官方文档链接地址:https://interestinglab.github.io/waterdrop-docs/#/zh-cn/case_study/2 Hive to ClickHouse 假定我们的数据已经存储在Hive中,我们需要读取Hive表中的数据并筛选出我们关心的字段,或者对字段进行转换,最后将对应的字段写入ClickHouse的表中。 Hive Schema 我们在Hive中存储的数据表结构如下,存储的是很常见的Nginx日志 hive的建表语句如下: CREATE TABLE `nginx

qq_42016966的博客 3857

STM32Cubemx+CanFestival:从零到一的CANopen移植实战

本文详细介绍了如何使用STM32CubeMX和CanFestival实现CANopen协议栈的移植,从开发环境搭建到核心配置步骤,再到调试与问题排查。通过实战经验分享,帮助开发者快速掌握STM32与CANopen的结合应用,提升嵌入式系统开发效率。

weixin_42558093的博客 421

Android 的端智能学习路径

基础层:先补齐 Android 进阶(JNI / 性能优化)和 AI 基础概念,无需深入算法开发;核心层:掌握 TFLite 的模型加载、推理、量化,能完成基础端侧推理;落地层:聚焦实战场景(图像 / OCR / 语音),解决工程化问题(模型管理、异常处理);优化层:通过模型量化、硬件加速、工程优化,提升推理性能和用户体验。

hqiangtai的博客 345

Qt5之qmake配置:自动复制依赖库

 新建项目后复制下面到pro文件最下方即可使用。 方便地自动复制依赖库(需要翻译文件的修改一下调用命令那里即可) PROJECT_DIRECTORY = $$PWD COMMON_DIRECTORY = $$PWD CONFIG(debug, debug|release) { contains(QMAKE_COMPILER, gcc) { if($$ARCHITE...

mccoy39082的博客 3484

智慧社区:安防系统解决方案

智慧社区:安防系统解决方案

s13166803785的博客 433

5G NR标准 第14章 调度

NR 本质上是一个调度系统,这意味着调度器决定何时以及向哪些设备分配时间、频率和空间资源,以及使用什么传输参数,包括数据速率。 调度可以是动态的或半静态的。 动态调度是基本的操作模式,其中调度程序针对每个时间间隔(例如,时隙)确定要发送和接收的设备。 由于经常做出调度决策,因此可以跟踪业务需求和无线电信道质量的快速变化,从而有效地利用可用资源。 半静态调度意味着传输参数是预先提供给设备的,而不是动态提供的。 在下文中,将讨论动态下行链路和上行链路调度,包括带宽自适应,然后是关于非动态调度的讨论

sundaygeek的专栏 6588

Python爬虫教程:抓取地方政府网站的公开文件与政策信息

Web爬虫是指一种自动化脚本,用于模拟人类浏览器访问网页、提取网页内容的数据抓取工具。发送请求到目标网页;获取网页内容;解析网页内容,提取所需数据;将数据保存或进一步处理。爬虫可以抓取各种形式的数据,如文本、图片、文件等。本教程将重点展示如何抓取地方政府网站上公开的政策文件、公告等信息。许多政府网站都会采取一定的反爬虫措施,防止大量数据被爬取。IP封锁:如果短时间内大量请求来自同一IP,可能会被封锁。验证码:一些网站会使用验证码来验证访问者是否为机器人。动态加载。

2201_76125261的博客 1981

C#实现鼠标点击任意绝对位置(附完整源码)

C#实现鼠标点击任意绝对位置(附完整源码)

希望我的博客,能帮上你解决学习中工作中所遇到的问题 481

电网到底是怎么调度14亿人用电的?

调度全国的电力资源满足 14 亿人口的需求,如此大规模的用电是怎么做到的?我们今天来深入地探讨了解其中的细节。

2401_86189088的博客 1996

[系统安全] 四十七.恶意软件分析 (3)动态分析经典沙箱Cape的安装和基础用法详解

系统安全将更好地帮助初学者了解病毒逆向分析和系统安全。前文详细介绍恶意代码静态分析经典工具Capa的基础用法,以及批量提取静态特征和ATT&CK技战术,主要是从提取的静态特征Json文件中提取关键特征。这篇文章将详细讲解动态分析沙箱Cape,其是一个开源的自动恶意软件分析系统,通过自动运行和分析恶意软件,全面分析和提取恶意软件的关键特征。本文先介绍Cape沙箱的安装和基础用法,后续随着深入再分享。基础性文章,希望对您有帮助!

杨秀璋的专栏 6739

go1.14基于信号的抢占式调度实现原理

转载地址:http://xiaorui.cc/archives/6535 前言: 疫情期间里老老实实在家蹲着,这期间主要研究下go 1.14新增的部分。go 1.14中比较大的更新有信号的抢占调度、defer内联优化,定时器优化等。前几天刚写完了golang 1.14 timer定时器的优化,有兴趣的朋友可以看看,http://xiaorui.cc/?p=6483 golang在之前的版本中已经实现了抢占调度,不管是陷入到大量计算还是系统调用,大多可被sysmon扫描到并进行抢占。但有些场景是无法

笔记 2323

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

14.调度未来任务

crontab 文件中的用户作业时间格式怎么解释?crontab 文件中用户作业的时间格式由 5 个字段组成,依次为:第一个字段:分钟(0-59)第二个字段:小时(0-23)第三个字段:日期(1-31)第四个字段:月份(1-12)第五个字段:周(0-6,0 和 6 代表周日)这 5 个字段共同定义了作业执行的时间,字段之间用空格分隔,后面紧跟要执行的命令。2.要计划周期性系统作业,应该将自定义的 crontab 文件放入哪个位置?

2201_75287549的博客 1946

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

京东自动化脚本配置指南:三步完成福利任务调度

当你每天面对京东平台上的各种签到任务、活动参与时,是否感到时间被碎片化?繁琐的重复操作不仅消耗精力,还容易错过重要奖励。现在,通过简单的脚本配置,你就能让这些福利任务自动运行。 ## 场景一:上班族的自动化管理需求 你可能遇到这样的情况:早上匆忙上班,忘记完成京东签到;午休时想参与活动,却被工作打断;晚上回家太累,直接跳过所有任务。一天下来,京豆、积分等奖励与你擦肩而过。 我们可以这样解决:

gitblog_00079的博客 1029

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

python分布式任务调度_分布式任务调度平台的自动化部署

一、概述1、自动化部署能简化开发过程的代码管理,让开发人员把更多的时间专注于业务实现,简化繁琐的上线流程和操作步骤,做到项目的快速打包和部署,减少人为操作中的失误。2、分布式任务调度平台,XXL-JOB:美团点评员工许雪里开发,其核心设计目标是开发迅速、学习简单、轻量级、易扩展。现已开放源代码并接入多家公司线上产品线,开箱即用。源码地址:https://github.com/xuxueli/xxl...

weixin_39942474的博客 642

开源情报收集:OpenClaw调度SecGPT-14B自动化监控暗网

本文介绍了如何在星图GPU平台上自动化部署SecGPT-14B镜像,实现开源情报的高效收集与分析。该方案通过OpenClaw调度SecGPT-14B模型,可7×24小时自动化监控暗网论坛,快速识别勒索软件、C2服务器等威胁情报,显著提升安全研究效率。

weixin_35920379的博客 341

自动任务调度系统

  这个自动任务调度系统的来由是这样的:前段时间,在一个 Java 技术群中,看到一个网友发了一个消息,说:自己在面试中,遇到编写一个具体的自动任务调度系统。并把面试中的那个任务调度系统的需求发到了群中。当时,感觉没有头绪,就没怎么想了。后来感觉吧,还挺有意思的,于是就分析了一下,大致完成了需求中的要求。可能内容比较长,我把提纲先列了出来:   (1)面试中,具体的项目要求 那位朋友,在面...

weixin_34112030的博客 4126

Android14 SurfaceFlinger启动流程与线程调度优化

本文深入解析了Android 14中SurfaceFlinger的启动流程,重点剖析了其线程调度优化策略。通过分析main函数初始化、核心线程(如EventThread)的优先级设置(如SCHED_FIFO)、以及引入uclamp.min等机制,揭示了系统如何通过精细化的线程管理来保障图形合成服务的低延迟与高响应性,从而提升整体视觉流畅度。

lilh34434的博客 608

Qwen3-14B与Kubernetes集群调度协同优化

本文探讨如何通过Kubernetes实现Qwen3-14B大模型的高效调度,涵盖资源精准分配、亲和性策略、冷启动优化及基于GPU指标的弹性伸缩,结合真实场景问题与解决方案,提升AI服务稳定性与资源利用率。

weixin_36178216的博客 481
上一篇: 项目实施-13(集成Flink计算引擎)
下一篇: 大数据开发工程师面试题 (20.04.14)
纯净天空7
博客等级 码龄8年 119粉丝 48原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值