


目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
选题指导:
最新最全计算机专业毕设选题精选推荐汇总
大家好,这里是海浪学长毕设专题,本次分享的课题是
🎯基于深度学习的野外毒蘑菇与可食用蘑菇快速识别算法研究
选题背景
毒蘑菇识别是一个关系到公众健康与生命安全的重要研究领域。我国毒蘑菇种类繁多,分布广泛,据统计,中国境内已知的毒蘑菇种类超过种,每年因误食毒蕈导致的中毒事件时有发生。全国食物中毒事件中,毒蕈中毒占比显著,特别是在夏季和秋季的多雨季节,野外毒蕈大量生长,成为中毒事件的高发期。这些中毒事件不仅对人民群众的身体健康造成严重威胁,也给医疗资源带来了巨大压力。传统的毒蕈识别方法主要依赖于专业人士的经验判断和形态学特征观察。然而,这种方法存在明显的局限性:首先,专业的菌物学知识普及程度低,普通群众难以掌握;其次,毒蕈与可食用菌在形态特征上高度相似,仅依靠肉眼观察容易出现误判;再者,传统识别方法受环境因素和个体差异影响较大,识别结果的准确性难以保证。这些局限性导致普通群众在野外遇到不明蘑菇时,往往无法做出准确判断,从而增加了误食毒蕈的风险。
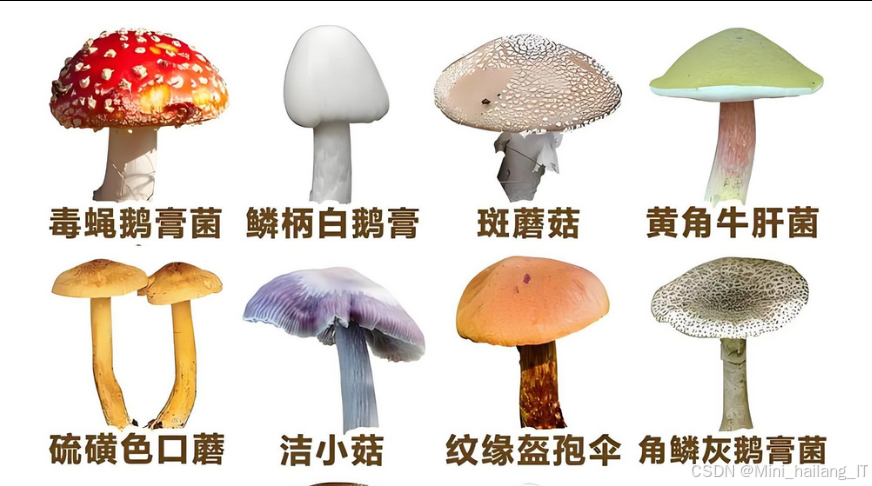
随着计算机视觉和深度学习技术的快速发展,基于深度学习的图像识别技术在诸多领域取得了突破性进展。特别是卷积神经网络的出现,为解决复杂的图像识别问题提供了新的思路和方法。深度残差网络作为一种优秀的深度学习模型,在图像分类任务中展现出了卓越的性能,能够有效提取图像的深层特征,提高识别准确率。同时,迁移学习技术的应用,使得模型能够利用在大规模数据集上预训练的知识,快速适应新的识别任务,解决小样本学习问题。深度学习技术在植物识别、医学图像分析、食品安全检测等领域的成功应用,为毒蕈图像识别研究提供了有力的技术支持。然而,目前针对毒蕈图像识别的研究相对较少,且存在以下问题:一是缺乏大规模、高质量的毒蕈图像数据集;二是现有识别方法的准确率和鲁棒性有待提高;三是识别系统的实用性和便捷性不足,难以在实际场景中推广应用。
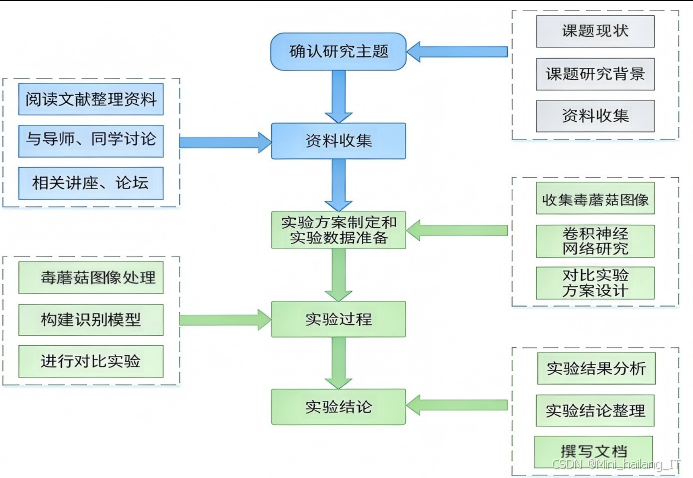
在这种背景下,构建一个基于深度残差网络与迁移学习的毒蕈图像识别系统。通过建立包含多种常见毒蕈的图像数据集,利用深度学习技术自动提取毒蕈图像特征,实现对毒蕈种类的准确识别,并开发相应的移动端应用,为普通群众提供便捷的毒蕈识别工具。该研究不仅具有重要的学术价值,能够丰富深度学习在生物分类领域的应用研究,也具有显著的社会意义,有助于减少误食毒蕈事件的发生,保护公众健康安全。
数据集
数据集的建立是毒蕈图像识别研究的基础和关键。本研究依据中国科学院网络化科学传播平台中列举的常见毒蕈种类,构建了一个包含种毒蕈的图像数据集。整个数据集的建立过程包括图像采集、数据筛选、数据预处理和数据增强等多个环节,确保了数据集的质量和多样性。
数据获取
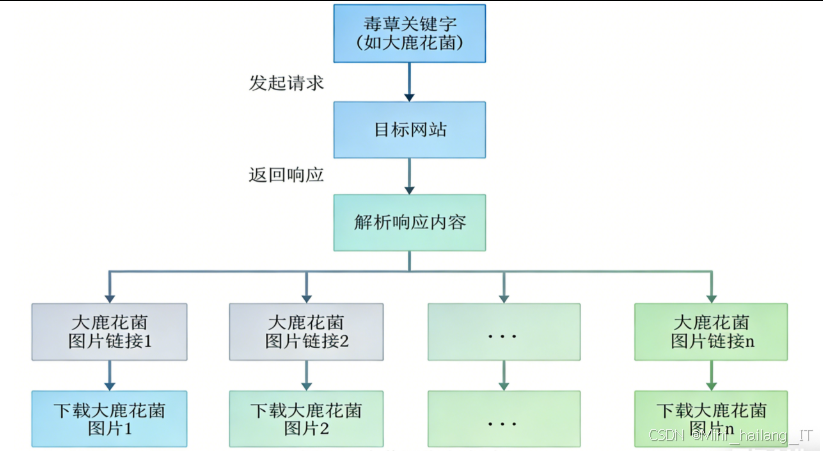
本研究采用爬虫工具从搜索中采集毒蕈图像。采集过程中,研究人员根据毒蕈的中文名称和拉丁学名设计搜索关键词,以确保能够获取到与目标毒蕈相关的图像。对于每种毒蕈,研究人员同时使用中文名称、拉丁学名以及英文名称进行搜索,以提高图像的覆盖范围和准确性。 具体的采集步骤如下:首先,研究人员确定需要采集的种常见毒蕈种类,包括白毒鹅膏菌、毒蝇鹅膏菌、大青褶伞、毒红菇、黄盖鹅膏菌、绿盖鹅膏菌、赭红拟口蘑、毛头鬼伞、细褐鳞蘑菇、头状秃马勃、鹿花菌、豹斑毒伞、毒粉褶菌、球基蘑菇、大鹿花菌、臭黄菇、毒杯伞、白鳞粗柄鹅膏等。然后,为每种毒蕈设计对应的搜索关键词,例如白毒鹅膏菌的搜索关键词包括"白毒鹅膏菌"、“Amanita verna”、"destroying angel"等。接着,使用ImageAssistant工具进行搜索和批量下载,对每种毒蕈采集约-1500张图像。最后,对下载的图像进行人工筛选,去除不相关、低质量或重复的图像。
本研究的毒蕈图像数据集包含种毒蕈的图像,每种毒蕈的图像数量不等。经过筛选和清洗后,最终的数据集规模达到张图像。其中,白毒鹅膏菌654张、毒蝇鹅膏菌698张、大青褶伞612张、毒红菇654张、黄盖鹅膏菌654张、绿盖鹅膏菌654张、赭红拟口蘑654张、毛头鬼伞654张、细褐鳞蘑菇654张、头状秃马勃654张、鹿花菌654张、豹斑毒伞654张、毒粉褶菌654张、球基蘑菇654张、大鹿花菌654张、臭黄菇654张、毒杯伞654张、白鳞粗柄鹅膏654张。所有图像均为JPEG格式,分辨率各不相同。在数据预处理阶段,研究人员将所有图像统一调整为224×224像素的尺寸,以适应深度学习模型的输入要求。调整后的图像保存为RGB三通道格式,像素值范围为0-255。
类别定义
本数据集包含种常见的毒蕈类别,每种毒蕈都有明确的分类定义和特征描述。以下是各类别的详细信息:
白毒鹅膏菌:又称白毒伞、毁灭天使,子实体中等大小,菌盖白色,表面光滑,菌褶白色,菌柄白色,有菌环和菌托。
-
毒蝇鹅膏菌:又称毒蝇伞,子实体较大,菌盖橙红色或红色,表面有白色鳞片,菌褶白色,菌柄白色,有大而明显的菌环。
-
大青褶伞:又称摩根小伞,子实体大,菌盖初为球形,后展开呈扁平状,表面白色至浅褐色,菌褶初期白色,后变为青灰色。
-
毒红菇:子实体中等大小,菌盖红色至粉红色,表面光滑,菌褶白色至浅黄白色,菌柄白色。
-
黄盖鹅膏菌:子实体较大,菌盖黄色至橙黄色,表面光滑,菌褶白色,菌柄白色,有菌环和菌托。
-
绿盖鹅膏菌:又称毒鹅膏、死帽菇,子实体中等大小,菌盖初期近球形,后扁平,表面淡黄绿色至橄榄绿色,菌褶白色,菌柄白色,有菌环和菌托。
-
赭红拟口蘑:子实体中等大小,菌盖橙红色至砖红色,表面有绒毛,菌褶黄色,菌柄橙黄色。
-
毛头鬼伞:又称鸡腿菇,子实体中等大小,菌盖初期圆柱形,后钟形,表面有浅褐色鳞片,菌褶初期白色,后变为黑色。
-
细褐鳞蘑菇:子实体中等大小,菌盖初期半球形,后扁平,表面褐色,有细鳞片,菌褶初期粉红色,后变为暗褐色。
-
头状秃马勃:子实体较大,近球形至梨形,表面白色至浅褐色,成熟后变为褐色,内部充满粉末状孢子。
-
鹿花菌:子实体中等大小,菌盖不规则,表面红褐色至深褐色,呈脑状或马鞍状,菌柄白色至浅褐色。
-
豹斑毒伞:又称豹斑鹅膏,子实体中等大小,菌盖灰褐色至褐色,表面有白色鳞片,菌褶白色,菌柄白色,有菌环和菌托。
-
毒粉褶菌:子实体中等至大型,菌盖初期半球形,后扁平,表面白色至浅灰色,菌褶粉红色,菌柄白色。
-
球基蘑菇:子实体中等大小,菌盖初期半球形,后扁平,表面白色至浅褐色,有细鳞片,菌褶初期粉红色,后变为暗褐色。
-
大鹿花菌:子实体大型,菌盖不规则,表面黄褐色至深褐色,呈脑状或马鞍状,菌柄粗壮,白色至浅褐色。
-
臭黄菇:子实体中等大小,菌盖初期半球形,后扁平,表面黄色至黄褐色,表面光滑,菌褶白色,菌柄白色至浅黄白色。
-
毒杯伞:子实体小型至中等,菌盖初期半球形,后扁平,表面白色至浅灰色,菌褶白色,菌柄白色。
-
白鳞粗柄鹅膏:子实体中等大小,菌盖白色,表面有白色鳞片,菌褶白色,菌柄粗壮,白色,有菌环和菌托。
为了评估模型的性能和避免过拟合,研究人员采用了折交叉验证的方法对数据集进行分割。具体来说,将整个数据集按照:3的比例划分为训练集和验证集。其中,训练集包含8187张图像,验证集包含3508张图像。在5折交叉验证过程中,数据集被分成5个大小相等的子集,每次使用其中4个子集作为训练数据,剩下的1个子集作为验证数据,重复5次,确保每个子集都有机会作为验证数据。这种分割策略能够更全面地评估模型的泛化能力,提高实验结果的可靠性。
数据预处理
数据预处理是确保数据集质量的重要步骤。本研究采用了以下预处理方法:
-
图像筛选:对采集到的原始图像进行人工筛选,去除不相关的图像、低质量图像以及重复图像。筛选过程中,研究人员参考了专业的菌物学资料,确保筛选后的图像能够准确代表目标毒蕈的特征。
-
统一格式与尺寸:将筛选后的图像统一转换为JPEG格式,并调整为224×224像素的尺寸。这种标准化处理有助于减少模型训练的计算量,提高训练效率,同时确保所有图像具有相同的输入维度。
-
保证分类正确性:在预处理过程中,研究人员再次核对每个图像的分类标签,确保每个图像都被正确归类。对于难以确定类别的图像,研究人员咨询了专业的菌物学专家,以确保分类的准确性。
数据增强
为了扩充数据集规模,增加数据的多样性,减少过拟合风险,本研究采用了以下数据增强技术:
-
水平翻转:将原始图像水平翻转,生成新的训练样本。这种变换能够增加模型对不同视角图像的识别能力。
-
随机裁剪:从原始图像中随机裁剪出224×224像素的区域。这种方法能够模拟不同距离和角度拍摄的图像,提高模型的鲁棒性。
-
添加高斯噪声:在原始图像上添加适量的高斯噪声,模拟真实环境中可能遇到的图像噪声。这种处理有助于提高模型对噪声图像的识别能力。
-
亮度调节:随机调整图像的亮度,生成在不同光照条件下的图像样本。这种增强方法能够提高模型对不同光照环境的适应能力。
-
旋转变换:将原始图像随机旋转一定角度,生成不同角度的图像样本。这种变换有助于提高模型对图像旋转的鲁棒性。
通过上述数据增强技术,本研究显著扩充了训练数据集的规模,提高了数据的多样性,为后续的模型训练提供了更加丰富和全面的训练样本。这些预处理和增强步骤的实施,确保了数据集的质量和有效性,为构建高性能的毒蕈图像识别模型奠定了坚实的基础。
功能模块介绍
本研究设计并实现的毒蕈图像识别系统主要由四个核心功能模块组成:毒蕈图像采集模块、图像处理模块、毒蕈图像识别模块和结果展示模块。这些模块相互协作,共同完成毒蕈图像的采集、处理、识别和结果展示的完整流程。
毒蕈图像采集模块
毒蕈图像采集模块是整个系统的输入部分,负责获取用户需要识别的毒蕈图像。模块支持两种图像获取方式:相机拍摄和本地相册选择,以满足用户在不同场景下的使用需求。相机拍摄功能允许用户直接通过智能手机的相机实时拍摄毒蕈图像。当用户选择相机拍摄模式时,系统会自动调用Android设备的相机API,启动相机应用。用户可以通过触摸屏进行对焦和拍照操作,系统会自动保存拍摄的图像并返回应用界面。为了确保拍摄的图像质量,系统还提供了基本的相机参数设置,如闪光灯控制、焦距调节等。本地相册选择功能允许用户从手机本地存储中选择已有的毒蕈图像进行识别。当用户选择本地相册模式时,系统会打开设备的相册应用,显示所有可访问的图像文件。用户可以浏览相册中的图像,选择需要识别的毒蕈图像。选择完成后,系统会将选定的图像加载到应用界面中,供用户进行后续操作。
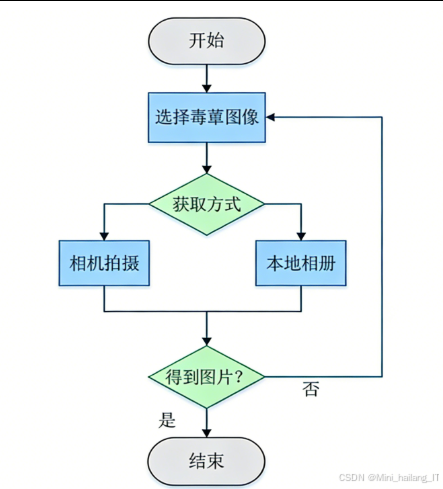
毒蕈图像采集模块的工作流程如下:首先,用户在应用主界面点击图像区域,系统弹出选择菜单,提供"相机拍摄"和"本地相册"两个选项;然后,用户根据实际情况选择合适的图像获取方式;接着,系统调用相应的API完成图像的获取;最后,获取的图像被显示在应用界面中,等待用户进行下一步操作。模块的设计充分考虑了用户的使用习惯和便捷性。通过提供两种图像获取方式,用户可以根据实际场景灵活选择,无论是在野外实时拍摄还是查看已保存的图像,都能够方便地完成图像采集。同时,界面设计简洁明了,操作流程直观,降低了用户的学习成本,提高了系统的易用性。
图像处理模块
图像处理模块负责对采集到的原始毒蕈图像进行预处理,以便后续的识别任务。模块主要包含两个功能:图像尺寸调整和图像上传。
图像尺寸调整功能的主要目的是解决原始图像分辨率过大导致的上传和识别速度缓慢问题。当用户选择或拍摄的图像分辨率超过系统处理能力时,过大的图像文件会增加网络传输时间和服务器处理负担,影响用户体验。因此,系统提供了图像裁剪功能,允许用户手动调整图像的大小和区域,保留最能反映毒蕈特征的部分。具体来说,用户可以通过拖动裁剪框来选择图像的有效区域,系统会自动将选定区域裁剪为×像素的标准尺寸,以适应模型的输入要求。
图像上传功能负责将处理后的毒蕈图像发送到Web服务端进行识别。该功能采用HTTP协议中的POST方法,使用OkHttp网络请求框架实现。OkHttp是一个高效的HTTP客户端,支持连接池、请求缓存和GZIP压缩等特性,能够显著提高网络请求的效率和稳定性。当用户点击"开始识别"按钮时,系统首先检查是否已选择需要识别的毒蕈图像,如果未选择,则弹出提示框提醒用户;如果已选择,则将图像数据封装到请求体中,发送到预定义的服务器地址。
图像处理模块的工作流程如下:首先,系统接收来自图像采集模块的原始图像;然后,对图像进行初步检查,判断是否需要进行尺寸调整;接着,用户通过裁剪工具调整图像尺寸和区域;最后,系统将处理后的图像上传到Web服务端。整个过程中,系统会实时显示处理进度和状态,确保用户了解当前操作的进展。模块的设计注重实用性和效率。通过图像裁剪功能,用户可以突出毒蕈的关键特征,提高识别准确率;通过高效的网络传输机制,系统能够快速将图像数据传输到服务器,减少用户等待时间。同时,模块还包含错误处理机制,能够有效应对网络中断、服务器无响应等异常情况,提高系统的稳定性和可靠性。
毒蕈图像识别模块
毒蕈图像识别模块是整个系统的核心,负责对上传的毒蕈图像进行分类识别。模块部署在Web服务端,主要包含模型部署、图像识别和结果查询三个功能。
模型部署是将训练好的毒蕈识别模型移植到Web服务环境中的过程。具体步骤如下:首先,在TensorFlow中使用freeze_graph命令将训练完成的模型导出为output_graphpb文件,该文件包含了模型的完整结构和参数;然后,使用Flask框架搭建Web服务端,将导出的模型文件部署在服务器上;最后,编写模型加载和调用的Python脚本,确保服务端能够正确加载模型并处理识别请求。服务端的主机地址设置为,端口设置为5000,以提供稳定的网络服务。
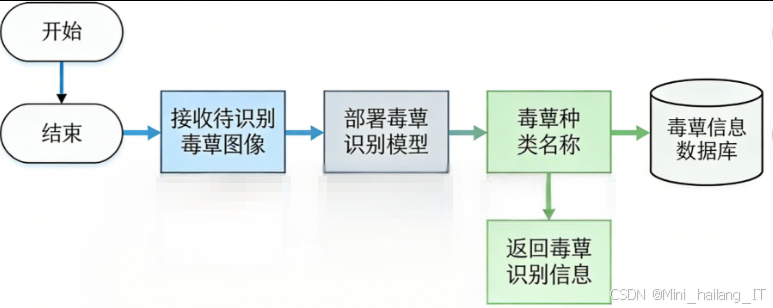
图像识别功能是模型的核心应用,负责对输入的毒蕈图像进行分类预测。当服务端接收到客户端发送的图像数据后,首先对图像进行标准化处理,包括调整尺寸、归一化像素值等;然后,将处理后的图像输入到加载好的ResNet-152模型中进行特征提取和分类;最后,模型输出各个类别的预测概率,系统选择概率最高的类别作为识别结果,并计算相应的置信度。
结果查询功能负责根据识别结果获取毒蕈的详细信息。系统在MySQL数据库中建立了一张常见毒蕈信息表toadstools,表中包含id、toadstool_name和toadstool_info三个字段,分别存储毒蕈的唯一标识符、种类名称和详细信息。当模型完成图像识别后,系统将识别得到的毒蕈名称作为查询条件,在数据库中检索对应的详细信息。这些信息包括毒蕈的形态特征、分布范围、毒性强度、中毒症状及急救措施等,为用户提供全面的参考。
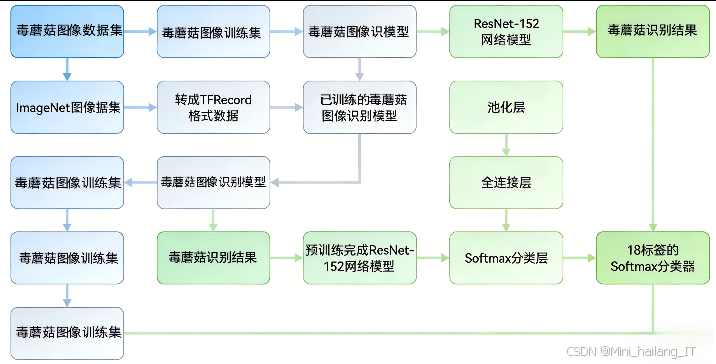
毒蕈图像识别模块的工作流程如下:首先,服务端接收客户端上传的毒蕈图像;然后,加载预训练的ResNet-152模型对图像进行识别;接着,根据识别结果在数据库中查询毒蕈信息;最后,将识别结果和毒蕈信息组合成JSON格式的数据,返回给客户端应用程序。整个识别过程的平均时间约为2秒,能够满足用户的实时性需求。模块的设计充分利用了深度学习和迁移学习的优势。通过部署预训练的ResNet-152模型,系统能够高效提取毒蕈图像的深层特征,实现准确分类;通过数据库查询机制,系统能够为用户提供丰富的毒蕈信息,增强识别结果的实用性。同时,服务端采用轻量级的Flask框架,具有良好的可扩展性和维护性,能够支持多用户并发访问。
结果展示模块
结果展示模块负责接收并显示服务端返回的毒蕈识别结果和相关信息,是用户获取识别结果的终端界面。模块主要包含信息接收和信息展示两个功能。
信息接收功能负责与服务端进行通信,接收识别结果数据。该功能使用OkHttp框架的异步回调机制,设置成功响应和失败响应两个回调函数。当网络请求成功时,系统从响应体中解析JSON格式的数据,提取毒蕈名称、识别准确率和详细信息;当网络请求失败时,系统弹出提示信息,告知用户识别失败的原因。
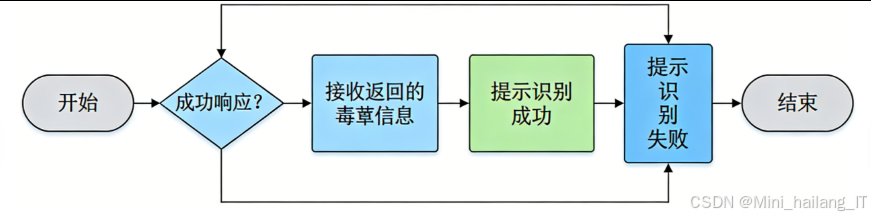
信息展示功能负责将接收的识别结果以友好的方式呈现给用户。界面设计采用清晰的层次结构,主要展示以下信息:首先,显示识别到的毒蕈种类名称,使用醒目的字体和颜色,确保用户能够快速获取核心信息;其次,展示识别结果的准确率,用百分比形式表示,让用户了解识别结果的可靠性;最后,显示毒蕈的详细信息,包括形态特征描述、毒性说明、分布情况等,为用户提供全面的参考。对于毒性较强的毒蕈,系统还会显示警告信息,提醒用户注意安全。
结果展示模块的工作流程如下:首先,系统发送图像上传请求并等待服务端响应;然后,根据响应状态执行相应的回调函数;接着,解析返回的JSON数据,提取相关信息;最后,将信息格式化后显示在应用界面中。如果识别失败,系统会提示用户检查网络连接或重新上传图像。模块的设计注重用户体验和信息的有效传达。通过简洁明了的界面布局和清晰的信息层次,用户能够快速获取关键信息;通过醒目的警告提示,系统能够有效提醒用户注意毒蕈的危险性;通过详细的毒蕈信息展示,系统能够为用户提供有价值的知识。同时,模块还包含错误处理和用户反馈机制,提高了系统的易用性和可靠性。
算法理论
卷积神经网络基础
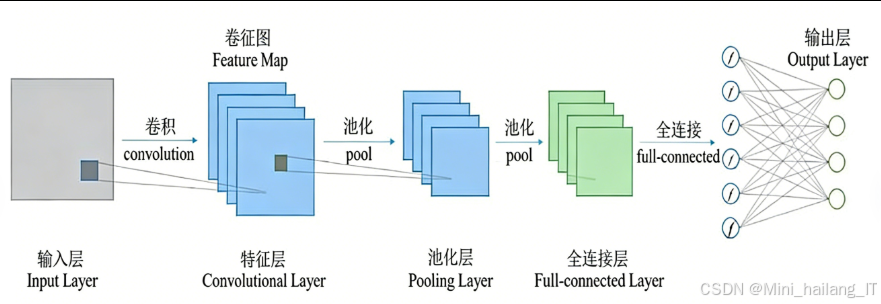
卷积神经网络是一种专门用于处理具有网格结构数据的深度学习模型,在图像识别领域展现出了卓越的性能。CNN的核心特点是局部连接和参数共享,这使得网络能够有效提取图像的局部特征,同时大大减少了模型的参数量。卷积层是CNN的基本组成部分,通过卷积操作提取图像的特征。卷积操作使用卷积核在输入图像上滑动,计算卷积核与对应图像区域的点积,生成特征图。卷积核的大小通常为×或5×5,能够捕获图像的局部特征。通过堆叠多个卷积层,网络能够逐渐提取更加抽象和复杂的特征。池化层用于降低特征图的维度,减少计算量,同时增强特征的鲁棒性。常用的池化操作包括最大池化和平均池化。最大池化取局部区域的最大值,能够保留最显著的特征;平均池化取局部区域的平均值,能够保留区域的整体信息。池化层通常放在卷积层之后,形成卷积-池化的基本结构单元。全连接层用于将特征图展平成一维向量,并通过神经元之间的连接进行分类决策。全连接层的神经元与前一层的所有神经元相连,能够整合来自不同区域的特征信息。在分类任务中,全连接层的输出通常连接到SoftMax分类器,生成各个类别的概率分布。
深度残差网络原理
深度残差网络是一种解决深层神经网络训练难题的创新架构。随着网络深度的增加,传统的CNN模型会出现梯度消失或梯度爆炸问题,导致模型性能下降。ResNet通过引入残差学习机制,有效解决了这一问题。残差学习的核心思想是学习残差映射而不是直接学习目标映射。假设某层的输入为x,期望的输出为H,传统网络直接学习H,而ResNet学习残差F=H-x,因此实际输出为F+x。这种残差连接的结构使得网络能够更容易地学习恒等映射,当最优映射接近恒等映射时,残差映射F接近零,网络更容易训练。
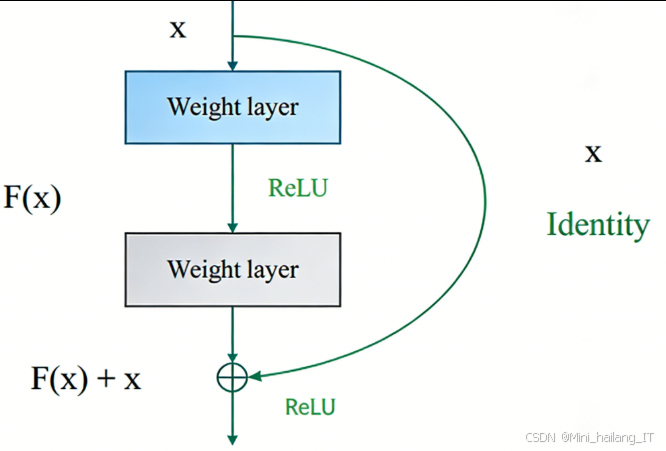
ResNet的基本构建单元是残差块。每个残差块包含两个×卷积层和一个跳跃连接。输入首先经过Batch Normalization层和ReLU激活函数,然后通过第一个卷积层,再经过Batch Normalization和ReLU,通过第二个卷积层,最后将输入与输出相加,得到残差块的最终输出。这种结构使得梯度能够通过跳跃连接直接传播到浅层,有效缓解了梯度消失问题。ResNet有多种变体,包括ResNet-18、ResNet-34、ResNet-50、ResNet-101和ResNet-152等,数字表示网络的总层数。随着层数的增加,网络的表示能力增强,但计算复杂度也相应提高。在本研究中,选择ResNet-152作为基础模型,因其具有更深的网络结构和更强的特征提取能力,适合处理复杂的毒蕈图像识别任务。
迁移学习技术
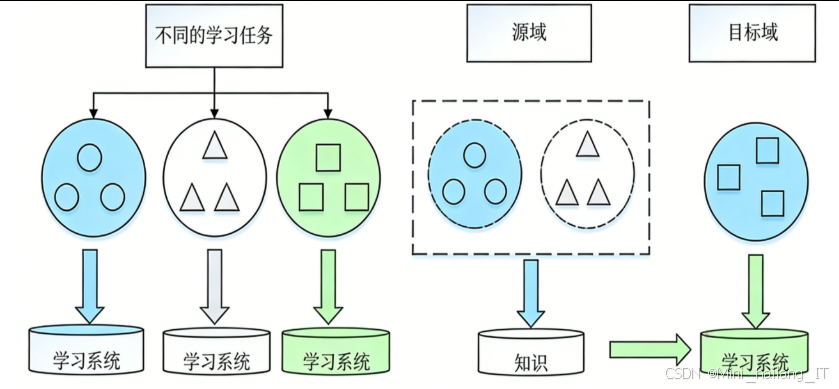
迁移学习是一种利用已有的知识和经验解决新问题的机器学习方法。在深度学习领域,迁移学习通常表现为将预训练模型应用到新的任务中,通过微调等方式使其适应新的数据分布。迁移学习的基本思想是利用预训练模型在大规模数据集上学习到的通用特征,加速新任务的学习过程。预训练模型已经学习到了图像的底层特征,如边缘、纹理等,这些特征在不同的图像识别任务中具有通用性。通过迁移这些特征,可以大大减少新任务所需的训练数据量和训练时间。基于模型的迁移学习是最常用的迁移学习方法之一,主要包括以下几种策略:
冻结预训练模型的部分层:保留预训练模型的特征提取层不变,只训练新的分类层。这种策略适用于新任务与预训练任务较为相似的情况。
微调预训练模型的部分层:冻结预训练模型的早期层,微调后期层。这种策略能够平衡通用特征和特定任务特征。
- 重新训练预训练模型的全层:对预训练模型的所有层进行微调,使其完全适应新任务。这种策略适用于新任务与预训练任务差异较大的情况。
核心代码介绍
##模型训练代码
以下是毒蕈图像识别模型的核心训练代码,该代码实现了基于ResNet-和迁移学习的模型构建、训练和评估过程。
import tensorflow as tf
from tensorflowkeras.applications import ResNet152
from tensorflow.keras.preprocessing.image import ImageDataGenerator
from tensorflow.keras.models import Model
from tensorflow.keras.layers import Dense, GlobalAveragePooling2D
from tensorflow.keras.optimizers import Adam
import numpy as np

# 设置随机种子,确保实验结果可复现
tfrandomset_seed
np.random.seed

# 数据路径设置
train_dir = 'path/to/train_data'
validation_dir = 'path/to/validation_data'

# 图像参数设置
img_width, img_height = ,
batch_size = 32
num_classes = 18
epochs = 50

# 创建数据生成器,实现数据增强
train_datagen = ImageDataGenerator

validation_datagen = ImageDataGenerator

# 生成训练和验证数据集
train_generator = train_datagenflow_from_directory,
    batch_size=batch_size,
    class_mode='categorical')

validation_generator = validation_datagenflow_from_directory,
    batch_size=batch_size,
    class_mode='categorical')

# 加载预训练的ResNet-模型,不包含顶层
base_model = ResNet)

# 添加自定义的顶层
x = base_modeloutput
x = GlobalAveragePoolingD  # 全局平均池化层
x = Dense  # 全连接层
predictions = Dense  # 输出层

# 构建完整模型
model = Model

# 冻结预训练模型的所有层,然后根据迁移策略选择是否解冻
for layer in base_modellayers:
    layertrainable = True  # 策略三:重新训练预训练网络全层

# 配置优化器,使用Adam算法
optimizer = Adam

# 编译模型
modelcompile

# 训练模型
history = modelfit

# 评估模型
loss, accuracy = modelevaluate
print
print

# 保存模型
modelsave

# 导出模型为pb格式,用于部署
from tensorflowkeras.models import load_model
model = load_model

# 冻结模型
from tensorflowpythonframework.convert_to_constants import convert_variables_to_constants_v2

full_model = tf.function)
full_model = full_model.get_concrete_function)

# 获取冻结图
frozen_func = convert_variables_to_constants_v
frozen_funcgraph.as_graph_def

# 保存冻结图
tfiowrite_graph
- 实现了完整的模型训练流程,包括数据加载与增强、模型构建、编译和训练等步骤。首先,使用ImageDataGenerator创建数据生成器,实现数据增强,包括旋转、平移、缩放和翻转等操作。然后,加载预训练的ResNet-152模型,移除顶层分类器,添加自定义的全局平均池化层、全连接层和输出层。在迁移学习策略方面,代码采用了策略三:重新训练预训练网络的所有层,使模型能够更好地适应毒蕈图像的特征。模型使用Adam优化器和交叉熵损失函数进行编译,然后在训练数据集上进行训练,并在验证数据集上评估性能。最后,保存训练好的模型,并将其导出为.pb格式,以便部署到Web服务端。
##Web服务端代码
以下是Web服务端的核心代码,负责接收客户端上传的图像,调用毒蕈识别模型进行识别,并返回识别结果。
from flask import Flask, request, jsonify
import tensorflow as tf
import numpy as np
from PIL import Image
import io
import mysqlconnector

app = Flask

# 加载毒蕈识别模型
def load_model:
    model_path = 'output_graphpb'
    graph = tfGraph
    with graph.as_default:
        od_graph_def = tf.compat.v1.GraphDef
        with tf.compat.v2.io.gfile.GFile as fid:
            serialized_graph = fid.read
            od_graph_def.ParseFromString
            tf.import_graph_def
    return graph

# 初始化模型
graph = load_model

# 建立数据库连接
db = mysqlconnectorconnect
cursor = db.cursor

# 毒蕈类别标签
class_labels = [
    '白毒鹅膏菌', '毒蝇鹅膏菌', '大青褶伞', '毒红菇', '黄盖鹅膏菌',
    '绿盖鹅膏菌', '赭红拟口蘑', '毛头鬼伞', '细褐鳞蘑菇', '头状秃马勃',
    '鹿花菌', '豹斑毒伞', '毒粉褶菌', '球基蘑菇', '大鹿花菌',
    '臭黄菇', '毒杯伞', '白鳞粗柄鹅膏'
  ]

# 图像预处理
def preprocess_image:
    image = Imageopen)
    image = imageresize)
    image = np.array / 255.0
    image = np.expand_dims
    return image

# 识别毒蕈图像
def predict_toadstool:
    image = preprocess_image
    with graphas_default:
        with tfcompat.v1.Session as sess:
            input_tensor = graph.get_tensor_by_name
            output_tensor = graph.get_tensor_by_name
            predictions = sess.run
    return predictions

# 查询毒蕈信息
def query_toadstool_info:
    query = "SELECT toadstool_info FROM toadstools WHERE toadstool_name = %s"
    cursorexecute)
    result = cursorfetchone
    if result:
        return result[0]
    else:
        return "暂无此毒蕈的详细信息"

  @app.route
def predict:
    try:
        # 接收上传的图像
        if 'image' not in request.files:
            return jsonify, 400

        file = request.files['image']
        image_bytes = file.read

        # 预测毒蕈类别
        predictions = predict_toadstool
        top1_idx = np.argmax
        top1_label = class_labels[top1_idx]
        top1_prob = float * 100

        # 获取前5个预测结果
        top5_indices = np.argsort[-5:][::-1]
        top5_results = []
        for idx in top5_indices:
            top5_results.append * 100
            })

        # 查询毒蕈详细信息
        toadstool_info = query_toadstool_info

        # 构建响应
        response = {
            'top1_prediction': {
                'label': top1_label,
                'probability': round
            },
            'top5_predictions': top5_results,
            'toadstool_info': toadstool_info
        }

        return jsonify, 200

    except Exception as e:
        return jsonify}), 500

if __name__ == '__main__':
    app.run
- 使用Flask框架搭建了一个Web服务,提供毒蕈图像识别的API接口。首先,加载预先导出的.pb格式模型,并建立与MySQL数据库的连接。然后,定义了图像预处理、模型预测和数据库查询等核心函数。当客户端发送POST请求到/predict端点时,服务端接收上传的图像文件,调用predict_toadstool函数进行识别,获取前1和前5的预测结果。接着,根据识别得到的毒蕈名称,从数据库中查询对应的详细信息。最后,将识别结果和毒蕈信息组合成JSON格式的数据,返回给客户端。整个服务运行在192.168.1.106:5000地址上,能够处理多用户并发请求,具有良好的性能和稳定性。
##Android客户端代码
以下是Android客户端应用的核心代码,负责图像采集、上传和结果展示。
package comexampletoadstoolidentification;

import androidx.annotation.NonNull;
import androidx.appcompat.app.AppCompatActivity;
import androidx.core.app.ActivityCompat;
import androidx.core.content.ContextCompat;

import android.Manifest;
import android.content.Intent;
import android.content.pm.PackageManager;
import android.graphics.Bitmap;
import android.graphics.BitmapFactory;
import android.net.Uri;
import android.os.Bundle;
import android.provider.MediaStore;
import android.view.View;
import android.widget.Button;
import android.widget.ImageView;
import android.widget.TextView;
import android.widget.Toast;

import com.squareup.okhttp.Call;
import com.squareup.okhttp.Callback;
import com.squareup.okhttp.MediaType;
import com.squareup.okhttp.MultipartBuilder;
import com.squareup.okhttp.OkHttpClient;
import com.squareup.okhttp.Request;
import com.squareup.okhttp.RequestBody;
import com.squareup.okhttp.Response;

import org.json.JSONArray;
import org.json.JSONException;
import org.json.JSONObject;

import java.io.ByteArrayOutputStream;
import java.io.File;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;

public class MainActivity extends AppCompatActivity {

    private static final int REQUEST_CAMERA = 1;
    private static final int REQUEST_GALLERY = 2;
    private static final int REQUEST_PERMISSION = 100;

    private ImageView imageView;
    private Button identifyButton;
    private TextView resultText;
    private Bitmap selectedImage;

    private static final String SERVER_URL = "http://192.168.1.106:5000/predict";

    @Override
    protected void onCreate {
        super.onCreate;
        setContentView;

        imageView = findViewById;
        identifyButton = findViewById;
        resultText = findViewById;

        // 请求相机和存储权限
        if
                != PackageManager.PERMISSION_GRANTED ||
            ContextCompat.checkSelfPermission
                != PackageManager.PERMISSION_GRANTED) {
            ActivityCompat.requestPermissions;
        }

        // 设置图像点击事件
        imageView.setOnClickListener {
            @Override
            public void onClick {
                showImagePickerDialog;
            }
        });

        // 设置识别按钮点击事件
        identifyButton.setOnClickListener {
            @Override
            public void onClick {
                if  {
                    uploadImageForPrediction;
                } else {
                    Toast.makeText.show;
                }
            }
        });
    }

    // 显示图像选择对话框
    private void showImagePickerDialog {
        CharSequence[] options = {"拍照", "从相册选择", "取消"};
        android.app.AlertDialog.Builder builder = new android.app.AlertDialog.Builder;
        builder.setTitle;
        builder.setItems -> {
            if ) {
                Intent takePicture = new Intent;
                startActivityForResult;
            } else if ) {
                Intent pickPhoto = new Intent;
                startActivityForResult;
            } else if ) {
                dialog.dismiss;
            }
        });
        builder.show;
    }

    @Override
    protected void onActivityResult {
        super.onActivityResult;
        if  {
            if  {
                Bundle extras = data.getExtras;
                selectedImage =  extras.get;
                imageView.setImageBitmap;
            } else if  {
                Uri selectedImageUri = data.getData;
                try {
                    selectedImage = MediaStore.Images.Media.getBitmap, selectedImageUri);
                    // 调整图像大小
                    selectedImage = Bitmap.createScaledBitmap;
                    imageView.setImageBitmap;
                } catch  {
                    e.printStackTrace;
                    Toast.makeText.show;
                }
            }
        }
    }

    // 上传图像进行预测
    private void uploadImageForPrediction {
        // 显示加载中状态
        resultText.setText;

        // 保存图像到临时文件
        File file = new File, "temp_image.jpg");
        try {
            FileOutputStream fos = new FileOutputStream;
            bitmap.compress;
            fos.flush;
            fos.close;
        } catch  {
            e.printStackTrace;
            Toast.makeText.show;
            return;
        }

        // 创建OkHttpClient
        OkHttpClient client = new OkHttpClient;

        // 构建多部分请求体
        RequestBody requestBody = new MultipartBuilder
                .type
                .addFormDataPart, file))
                .build;

        // 创建请求
        Request request = new Request.Builder
                .url
                .post
                .build;

        // 执行请求
        client.newCall.enqueue {
            @Override
            public void onFailure {
                runOnUiThread -> {
                    resultText.setText;
                    Toast.makeText.show;
                });
            }

            @Override
            public void onResponse throws IOException {
                if ) {
                    String responseData = response.body.string;
                    try {
                        // 解析JSON响应
                        JSONObject jsonResponse = new JSONObject;
                        JSONObject top1Prediction = jsonResponse.getJSONObject;
                        String label = top1Prediction.getString;
                        double probability = top1Prediction.getDouble;
                        String toadstoolInfo = jsonResponse.getString;

                        // 更新UI
                        runOnUiThread -> {
                            StringBuilder result = new StringBuilder;
                            result.append.append.append;
                            result.append.append).append;
                            result.append.append;
                            resultText.setText);
                            Toast.makeText.show;
                        });
                    } catch  {
                        e.printStackTrace;
                        runOnUiThread -> {
                            resultText.setText;
                            Toast.makeText.show;
                        });
                    }
                } else {
                    runOnUiThread -> {
                        resultText.setText;
                        Toast.makeText.show;
                    });
                }
            }
        });
    }

    @Override
    public void onRequestPermissionsResult {
        super.onRequestPermissionsResult;
        if  {
            if  {
                // 权限已授予
            } else {
                Toast.makeText.show;
            }
        }
    }
}
- 实现了Android客户端的核心功能,包括图像采集、上传和结果展示。首先,在onCreate方法中初始化UI组件,并请求相机和存储权限。当用户点击图像视图时,显示选择菜单,允许用户通过相机拍摄或从相册选择图像。当用户点击识别按钮时,调用uploadImageForPrediction方法将图像上传到Web服务端。该方法使用OkHttp库创建多部分表单请求,将图像数据发送到预定义的服务器URL。在请求的回调函数中,处理服务器的响应:如果请求成功,解析返回的JSON数据,提取毒蕈名称、识别准确率和详细信息,并更新UI;如果请求失败,显示错误信息。整个客户端应用采用异步请求方式,确保UI在网络请求过程中保持响应,提供良好的用户体验。
重难点和创新点
##研究难点
本研究在实施过程中面临几个主要难点,这些难点的解决对于项目的成功至关重要。
** 毒蕈图像数据集的构建**
构建高质量的毒蕈图像数据集是本研究的首要难点。由于毒蕈种类繁多,且形态特征复杂,获取准确标注的图像数据面临诸多挑战。首先,网络上的毒蕈图像质量参差不齐,存在大量模糊、光照不足或背景复杂的图像,需要进行人工筛选和清洗。其次,不同毒蕈种类之间可能存在形态相似性,导致分类困难,需要专业知识进行准确标注。最后,部分毒蕈种类的图像资源稀缺,难以获取足够数量的样本,影响模型的训练效果。
为解决这一难点,研究团队采用了多关键词搜索策略,同时使用中文名称、拉丁学名和英文名称进行图像搜索,扩大了数据来源。对于获取的原始图像,进行了严格的人工筛选,参考专业的菌物学资料,确保每张图像的分类准确性。针对样本数量不足的问题,采用数据增强技术,通过水平翻转、随机裁剪、亮度调节等方式扩充数据集,提高了数据的多样性和模型的泛化能力。
** 深度神经网络的训练与优化**
训练深层神经网络面临着梯度消失、过拟合等问题。ResNet-152作为一个具有152层的深层网络,其训练过程更为复杂。如何选择合适的优化算法、学习率策略和正则化方法,以确保模型能够有效收敛并避免过拟合,是本研究的第二个难点。
研究团队通过对比实验,系统研究了不同优化算法对模型性能的影响。同时,采用了指数衰减的学习率策略,初始学习率设为0.001,随着训练轮次的增加逐渐降低,使模型能够在训练初期快速收敛,在后期精细调整参数。为了减轻过拟合,除了数据增强外,还在全连接层使用了Dropout技术,随机丢弃部分神经元,提高了模型的泛化能力。
3. 迁移学习策略的选择
选择合适的迁移学习策略是提高模型性能的关键。预训练模型在ImageNet数据集上学习到的特征与毒蕈图像的特征存在一定差异,如何有效迁移这些特征,使其更好地适应毒蕈识别任务,是本研究的第三个难点。
研究团队设计了三组对比实验,分别测试了三种迁移学习策略:只训练全连接层、微调部分层、重新训练全层。实验结果显示,重新训练全层的策略在毒蕈图像识别任务中表现最佳,Top-1准确率达到92.17%,Top-5准确率达到97.35%。这一结果表明,毒蕈图像与ImageNet数据集中的图像在内容和特征分布上存在较大差异,需要模型重新学习特定的特征表示。因此,选择了重新训练预训练网络全层的迁移学习策略。
4. 移动端应用的开发与优化
将深度学习模型部署到移动设备上,需要解决模型压缩、计算资源限制和实时性等问题。如何在保证识别准确率的前提下,优化应用性能,提高用户体验,是本研究的第四个难点。
为了解决这一难点,研究团队采用了客户端-服务器架构,将计算密集型的模型推理任务部署在Web服务端,移动端主要负责图像采集和结果展示。这种架构既避免了移动设备计算能力不足的问题,又保证了识别的实时性。在图像上传过程中,使用了高效的网络请求框架OkHttp,实现了异步上传和响应处理,确保UI的流畅性。同时,对上传的图像进行了预处理,如调整尺寸、压缩质量等,减少了数据传输量,提高了响应速度。
##创新点
本研究在毒蕈图像识别领域取得了以下几个方面的创新成果:
** 构建了中国常见毒蕈图像数据集**
目前,公开的毒蕈图像数据集相对较少,且大多来自国外,难以满足中国境内常见毒蕈识别的需求。本研究基于中国科学院网络化科学传播平台的毒蕈分类标准,构建了包含种常见毒蕈的图像数据集,共11695张图像。该数据集涵盖了中国境内分布广泛、毒性较强的主要毒蕈种类,为毒蕈图像识别研究提供了重要的基础数据资源。与现有的UCI蘑菇数据库相比,本数据集规模更大,且包含真实的图像数据,更符合实际应用场景的需求。
2. 提出了基于深度残差网络与迁移学习的毒蕈识别方法
传统的毒蕈识别方法主要依赖人工特征提取,识别准确率受限于特征设计的质量。本研究提出了一种基于ResNet-152和迁移学习的毒蕈图像识别方法,能够自动提取图像的深层特征,避免了繁琐的人工特征工程。通过将预训练的ResNet-152模型迁移到毒蕈识别任务中,结合数据增强技术,显著提高了识别准确率。
3. 设计并实现了Android平台的毒蕈图像识别系统
为了将研究成果应用于实际场景,本研究设计并实现了一个基于Android平台的毒蕈图像识别系统。该系统采用客户端-服务器架构,客户端负责图像采集和结果展示,服务端负责图像识别和信息查询。系统提供了相机拍摄和本地相册选择两种图像获取方式,支持实时识别和结果展示,并提供毒蕈的详细信息,包括形态特征、毒性说明等。通过系统测试,验证了该系统在识别准确率、响应速度和用户体验方面都达到了设计要求,具有较强的实用性和推广价值。
4. 系统地比较了不同优化算法、迁移学习策略和网络模型的效果
本研究通过设计13组对比实验,系统地研究了不同优化算法、不同迁移学习策略以及不同深度的网络模型对毒蕈图像识别效果的影响。研究结果表明,Adam算法的优化效果最佳,重新训练预训练网络全层的迁移学习策略效果最好,且随着网络深度的增加,识别准确率逐渐提高,ResNet-152表现最优。这些研究结果为毒蕈图像识别领域的模型选择和参数优化提供了有价值的参考。
总结
本研究基于深度残差网络与迁移学习技术,成功构建了一个高效准确的毒蕈图像识别系统。通过系统的研究和实验,取得了以下主要成果:
-
建立了一个包含种常见毒蕈的图像数据集。该数据集通过网络爬虫采集和人工筛选相结合的方式构建,共包含11695张高质量的毒蕈图像。为了提高模型的泛化能力,还采用了数据增强技术,包括水平翻转、随机裁剪、亮度调节等,进一步扩充了训练数据的多样性。
-
提出了一种基于ResNet-152和迁移学习的毒蕈图像识别方法。该方法充分利用了ResNet-152在特征提取方面的优势,结合迁移学习技术,显著提高了模型的识别性能。通过对比实验,确定了最佳的优化算法和迁移学习策略,使模型在测试集上的Top-1准确率达到92.17%,Top-5准确率达到97.35%。
-
设计并实现了一个基于Android平台的毒蕈图像识别系统。该系统分为客户端和服务端两部分,客户端负责图像采集和结果展示,服务端负责图像识别和信息查询。系统支持相机拍摄和本地相册选择两种图像获取方式,能够快速准确地识别毒蕈种类,并提供详细的毒蕈信息。系统测试结果表明,从图像上传到返回识别结果的时间约为2秒,满足了实时性要求。
本研究的成果具有重要的理论意义和实用价值。在理论方面,系统研究了深度残差网络和迁移学习在毒蕈图像识别中的应用,为生物图像分类提供了新的思路和方法。在实践方面,开发的Android应用为普通群众提供了便捷的毒蕈识别工具,有助于减少误食毒蕈事件的发生,保护公众健康安全。
当然,本研究还存在一些不足之处和改进空间。首先,数据集的规模和种类还可以进一步扩大,以覆盖更多的毒蕈种类和生长环境。其次,模型的准确率和实时性还有提升空可以通过模型压缩、量化等技术进一步优化。此外,Android应用的功能还可以更加丰富,如增加用户反馈、社区分享等功能,提高应用的互动性和用户黏性。
未来的研究方向主要包括:一是扩充毒蕈图像数据集,增加更多种类的毒蕈和不同生长环境下的样本;二是优化模型结构,提高识别准确率和降低计算复杂度;三是完善Android应用功能,增加用户反馈和数据共享机制;四是探索将模型部署到移动端的可能性,实现离线识别,提高系统的实用性。
参考文献
[] He K, Zhang X, Ren S, et al. Deep residual learning for image recognition[C]. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2016: 770-778.
[2] Kingma D P, Ba J. Adam: A method for stochastic optimization[C]. International Conference on Learning Representations, 2015.
[3] Pan S J, Yang Q. A survey on transfer learning[J]. IEEE Transactions on Knowledge and Data Engineering, 2010, 22: 1345-1359.
[4] Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition[J]. arXiv preprint arXiv:1409.1556, 2014.
[5] Szegedy C, Liu W, Jia Y Q, et al. Going deeper with convolutions[C]. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2015: 1-9.
[6] Russakovsky O, Deng J, Su H, et al. ImageNet large scale visual recognition challenge[J]. International Journal of Computer Vision, 2015, 115: 211-252.
[7] Hu J, Shen L, Sun G. Squeeze-and-excitation networks[C]. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2018: 7132-7141.
[8] Zhang H, Cisse M, Dauphin Y N, et al. mixup: Beyond empirical risk minimization[J]. arXiv preprint arXiv:1710.09412, 2017.

 338


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


