【毕业设计】基于计算机视觉的社交距离检测算法优化研究

毕业设计选题指南:100个创新项目与避坑策略 深度学习与大数据分析已成为计算机领域的热门技术方向,其核心原理是通过算法模型处理复杂数据,实现智能决策。在工程实践中,YOLOv5、LSTM等技术框架能有效解决目标检测、文本分类等实际问题。毕业设计作为技术能力的重要展示,选题需平衡技术复杂度、工作量和创新性。本文提供100个涵盖计算机视觉、自然语言处理等方向的实战项目案例,包括社交距离检测、昆虫识别等典型应用场景,并分享数据集构建、模型优化等工程经验,帮助学生避开常见开发陷阱。 阅读详情

目录

前言

项目背景

数据集

设计思路

更多帮助


前言

    📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。

        🚀对毕设有任何疑问都可以问学长哦!

       大家好,这里是海浪学长计算机毕设专题,本次分享的课题是

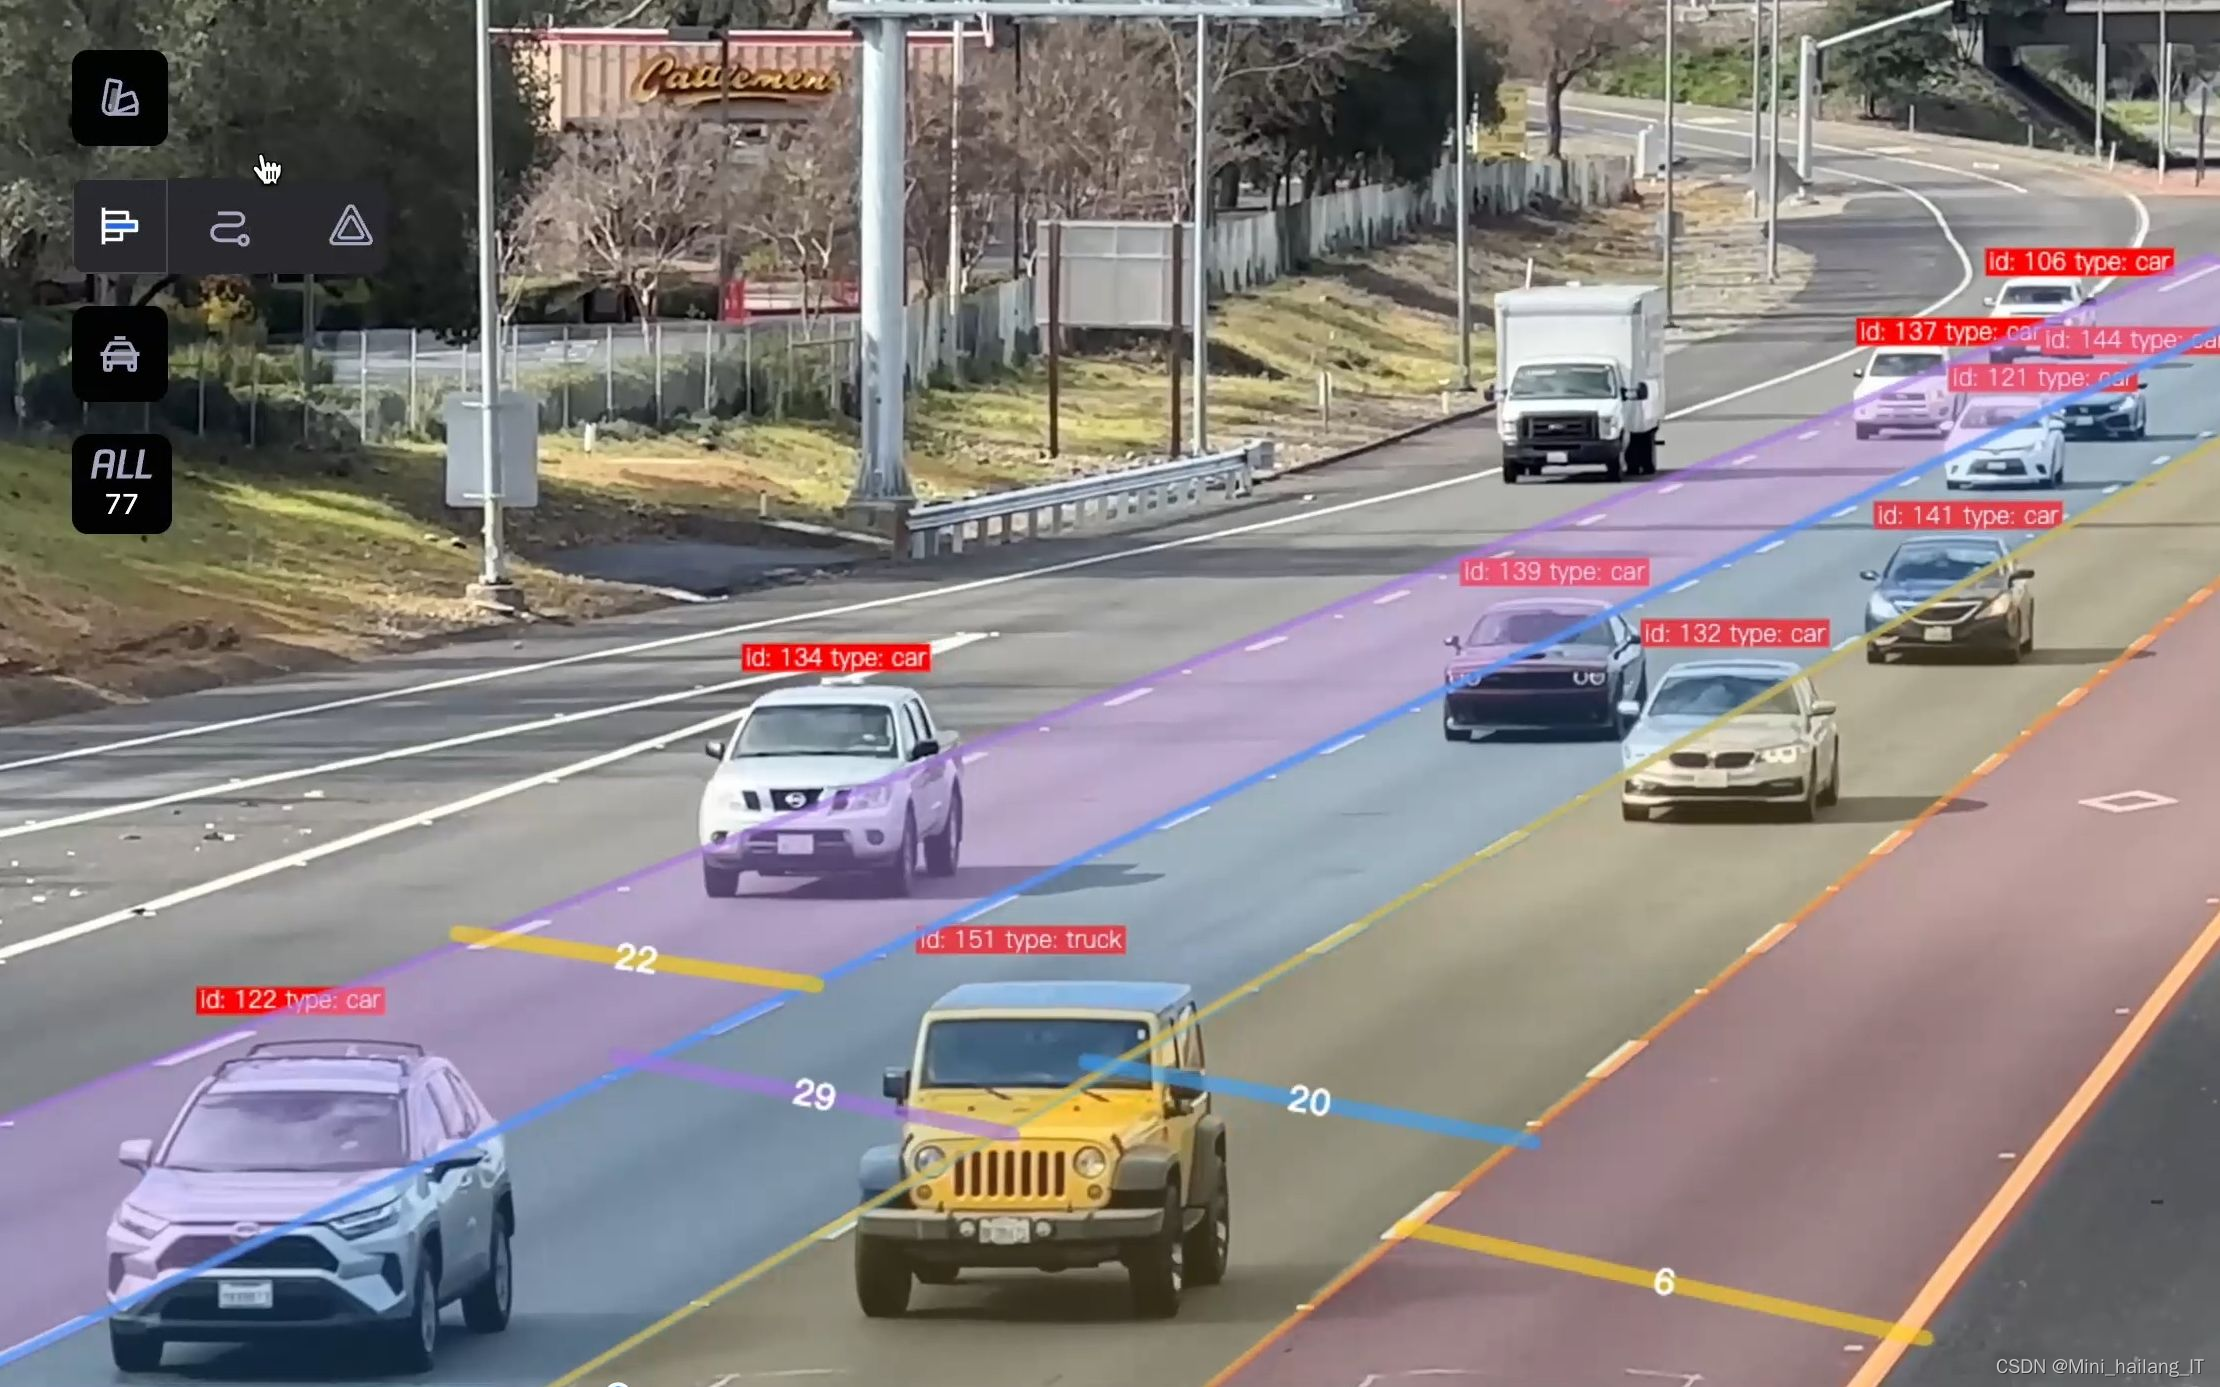
       🎯基于计算机视觉的社交距离检测算法优化研究

项目背景

       随着全球公共卫生事件的频发,保持社交距离已成为防止病毒传播的重要措施。传统的人力监测方式效率低下,且难以实时反馈。计算机视觉技术的发展为社交距离检测提供了新的解决方案,通过摄像头实时监测人群行为,可以有效识别和警告不符合社交距离要求的情况。然而,目前的社交距离检测算法在准确性、实时性以及适应性等方面仍存在不足,因此对这些算法进行优化显得尤为重要。提高社交距离检测的精度和效率,为公共场所的疫情防控工作提供技术支持。

数据集

       数据收集阶段需要选择合适的场景,如公共交通站、商场或学校等,以确保捕捉到不同社交距离下的真实场景。使用摄像设备拍摄时,应尽量涵盖不同的光照、角度和人群密度,以确保数据的多样性。使用标注工具对收集到的图像进行标注,框选出每个行人并记录相关的社交距离信息。这一过程对模型的训练效果至关重要,标注精度直接影响到后续模型的性能。

基于计算机视觉的社交距离检测算法优化研究

       标注完成后,需对数据进行清洗,去除模糊或标注错误的图像,以提升数据集的整体质量。数据增强是接下来的一步,通过对原始图像进行旋转、翻转、缩放等操作,生成更多样化的数据样本,从而提高模型的鲁棒性和泛化能力。最后,数据集需要划分为训练集、验证集和测试集,通常采用70%用于训练,15%用于验证,15%用于测试的比例。

设计思路

       卷积神经网络核心在于卷积核的计算,特点在于能够处理网格结构的数据。在图像处理任务中,卷积神经网络可以分为输入层、卷积层、池化层、激活层、全连接层和输出层六个部分。输入层作为卷积神经网络的起始,主要接收原始或预处理过的数据。以图像处理为例,输入的图像通常是原始的三维彩色图像。在输入层,这些图像会被转换为固定大小的格式,以适应神经网络的处理需求,这样网络能更好地从图像中提取特征并进行后续处理和分析。

       卷积层的主要功能是对输入层形成的像素矩阵进行目标信息提取,通过卷积运算获取输出特征图。卷积层由多个卷积核构成,工作原理是对输入的特征图转化而来的像素矩阵,卷积核按照固定的步长以自上往下、自左向右的顺序进行点乘操作,通过逐步进行卷积计算,获得整个卷积过程的输出结果,以此提取出相应特征信息。

       池化层通常设置在卷积层之后,主要作用是对特征矩阵实施降维处理,将维度减小后的特征输入到下一个网络层,此操作可以去除冗余信息,保留局部有用信息,减少计算量和参数,避免过拟合现象并提升运算速度。标准池化是最常见的,分为平均池化和最大池化。平均池化计算输入特征矩阵的局部区域的平均值,保留更多的背景信息;最大池化选择特征矩阵局部区域的最大值作为输出,有效降低计算量,保留更多的纹理信息。

       激活层介于卷积层和池化层之间,通过激活函数增强模型的特征提取能力,激活函数是神经网络非线性关系的重要组成部分,解决了整个神经网络输入和输出线性叠加的问题。全连接层位于输出层之前,所有节点与前层节点全部互联,作用是整合前层的信息,并将这些特征映射到样本标记空间。

       YOLOv5s的核心架构由输入端、特征提取网络、特征融合增强网络和预测端四大组件构成。在输入端,引入了Mosaic数据增强技术,实现了自适应锚框计算,并对图像进行了自适应缩放,提升了模型的泛化能力。Mosaic数据增强技术从多张图片中随机选择四张,进行随机分布与叠加,最终生成一张合成图片,极大丰富了数据集的多样性,同时生成了许多小目标,通过训练提升了模型的小目标识别能力;自适应锚框和自适应缩放图像根据图片的长度和宽度差异,将原始图片缩放到标准尺寸,输入模型进行训练。特征提取网络主要由Focus框架、BottleneckCSP和空间金字塔池化组成,增强了CNN的学习能力。特征融合增强网络提升了对不同缩放尺度对象的特征融合能力。预测端通过边界框损失函数对目标框进行筛选,实现目标检测,训练过程中额外使用Mosaic数据增强方法减轻过拟合现象,提升检测性能。

       在图像处理中,利用注意力机制可以对特定区域进行高分辨率处理。将注意力集中在图片中的特定部分,不处理全部图像,有针对性地对图像进行处理,从中获取更多的关键信息,从而提升整个模型的性能。引入CBAM注意力机制可以提升模型的检测性能。通道注意力增强不同通道的特征表示,空间注意力机制提取空间中不同位置的关键信息。

       损失函数也是影响模型检测精度的重要因素,合适的损失函数能够使模型在进行目标检测任务时获得更精准的指标。损失函数旨在量化单个训练样本的预测值与真实值之间的偏差。在YOLOv5s中,这一误差通过分类损失函数、边界框回归损失函数和置信度损失函数的加权组合来全面衡量。边界框回归是目标检测任务中的重要环节,为了准确框出检测目标,必须对边界框的位置数据进行精确预测。SIoU损失函数同CIoU损失函数一样是基于IoU损失函数扩展出来的计算方式。相较于IoU,SIoU更加关注所需回归边界框之间的向量角度,从而重新定义惩罚指标,以提供更准确的评估。YOLOv5s中用来定义边界框回归损失的函数大多基于IoU衍生而来。

       数据准备是模型训练的基础,包括数据收集、标注和预处理。首先,需要收集包含不同社交距离场景的图像数据集,并为这些图像进行标注,通常采用矩形框标注出目标对象(如人)。在标注完成后,对图像进行预处理,如调整图像大小、归一化等,以便于后续的模型训练。数据增强通过对原始数据进行变换生成新的样本,以提高模型的鲁棒性和泛化能力。可以采用多种增强策略,如随机旋转、翻转、裁剪、亮度调整等。在YOLOv5s中,引入了Mosaic数据增强技术,通过随机选择几张图像进行拼接,以增加数据集的多样性。

import cv2
import os

def preprocess_images(image_folder, target_size=(640, 640)):
    for img_name in os.listdir(image_folder):
        img = cv2.imread(os.path.join(image_folder, img_name))
        img_resized = cv2.resize(img, target_size)
        cv2.imwrite(os.path.join(image_folder, 'preprocessed', img_name), img_resized)

preprocess_images('data/images')

       特征提取网络负责从输入图像中提取关键特征。YOLOv5s的特征提取网络包括Focus框架、BottleneckCSP和空间金字塔池化等组件。这些组件有助于增强模型对图像特征的学习能力,从而提高目标检测的准确性。特征融合增强网络旨在将不同尺度的特征进行融合,以提升对不同大小目标的检测能力。通过融合不同层次的特征,模型可以更好地适应复杂场景中的目标检测任务。

class FeatureExtractor(nn.Module):
    def __init__(self):
        super(FeatureExtractor, self).__init__()
        self.focus = Focus()
        self.bottleneck_csp = BottleneckCSP()
        self.spp = SpatialPyramidPooling()

    def forward(self, x):
        x = self.focus(x)
        x = self.bottleneck_csp(x)
        x = self.spp(x)
        return x

       在预测端,使用边界框损失函数对目标框进行筛选,实现目标检测。通过计算分类损失、边界框回归损失和置信度损失的加权和,全面评估模型的表现。引入注意力机制可以进一步提升模型的性能,使其能够专注于关键区域。优化损失函数是提高模型检测精度的关键。YOLOv5s原本采用CIoU损失函数,而引入SIoU损失函数可以更好地优化边界框的定位准确性。SIoU损失函数相比于传统的IoU损失,更加关注所需回归边界框之间的向量角度。

def compute_loss(predictions, targets):
    classification_loss = classification_loss_fn(predictions, targets)
    bbox_regression_loss = bbox_regression_loss_fn(predictions, targets)
    confidence_loss = confidence_loss_fn(predictions, targets)
    total_loss = classification_loss + bbox_regression_loss + confidence_loss
    return total_loss

       完成数据准备、特征提取和损失函数优化后,进行模型训练。通过多轮训练和验证,评估模型的性能,并根据评估结果进行调整和优化。训练过程中使用验证集监控模型的过拟合情况,并采取适当的措施进行处理。

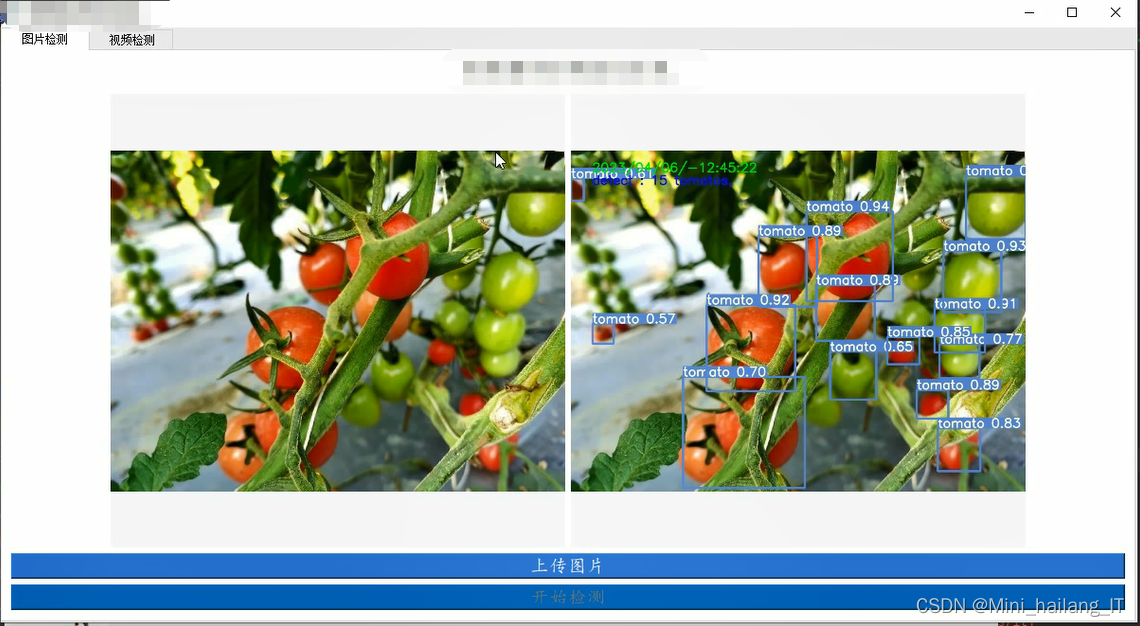
海浪学长项目示例:
更多帮助

毕业设计选题与实现全攻略:从深度学习到大数据分析 毕业设计是计算机专业学生展示技术能力的重要环节,涉及深度学习、大数据分析等核心技术。深度学习通过神经网络模型实现图像识别、自然语言处理等任务,而大数据分析则关注数据采集、处理与可视化。这些技术在智慧医疗、智能交通等领域有广泛应用。本文以YOLOv5目标检测和B站数据分析为例,详解技术选型、实现路线与创新方法,帮助读者掌握800-1500行核心代码的工程实践,解决模型训练不收敛、系统性能瓶颈等常见问题。 阅读详情

相关推荐

基于YOLOv5的动物行为分析系统开发实战

目标检测是计算机视觉的核心技术之一,通过深度学习算法自动识别图像中的物体并定位其位置。YOLOv5作为当前最先进的目标检测框架,以其出色的推理速度和模型轻量化特性,成为工业界部署的首选方案。该系统采用模块化设计,整合数据采集、模型训练与可视化分析全流程,特别适合需要实时处理视频流的场景。在动物行为研究领域,基于YOLOv5的解决方案可实现85%以上的识别准确率,大幅提升观测效率。通过PyTorch生态和ONNX/TensorRT加速,该系统可灵活部署从云端服务器到边缘计算设备。

weixin_33691817的博客 366

【毕业设计】基于YOLOv5s+DeepSORT的多目标跟踪与社交距离检测算法研究

基于改进的YOLOv5s与DeepSORT算法,设计并实现了一个高效的社交距离检测系统,能够实时检测行人目标并准确评估其社交距离是否符合安全标准。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心收集了各种有趣且具有挑战性的选题,旨在帮助学生们在毕业设计中展现他们的技术实力和创新能力。不论是对于对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能的领域的同学,本合集都能为您提供丰富的选题资源和灵感。

Hai_Lang_IT的博客 1220

深度学习之Encoder-Only原理与实战

【代码】深度学习之Encoder-Only原理与实战。

yumiwangzi30的博客 265

选题指南:人工智能专业毕业设计选题题目汇总 2025

人工智能专业毕业设计选题合集涵盖了深度学习、机器学习、算法、人工智能、大数据、信息安全、推荐系统、目标检测等多个热门领域。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心收集了各种有趣且具有挑战性的选题,旨在帮助学生们在毕业设计中展现他们的技术实力和创新能力。不论是对于对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能的领域的同学,本合集都能为您提供丰富的选题资源和灵感。

Hai_Lang_IT的博客 1539

深度学习之Seq2Seq原理与实战

【代码】深度学习之Seq2Seq原理与实战。

yumiwangzi30的博客 132

深度学习之TF-IDF原理与实战

【代码】深度学习之TF_IDF原理与实战。

yumiwangzi30的博客 187

毕业设计——基于Pytorch卷积神经网络的人脸面部表情识别系统研究

本项目是基于卷积神经网络模型开展表情识别的研究,为了尽可能的提高最终表情识别的准确性,需要大量的样本图片训练,优化,所以采用了 FER2013 数据集用来训练、测试,此数据集由 35886 张人脸表情图片组成,其中,测试图 28708 张,公共验证图和私有验证图各 3589 张,所有图片中共有7种表情。

abackcab的博客 2346

深度学习之LoRA(低秩适配)原理与实战

【代码】深度学习之LoRA(低秩适配)原理与实战。

yumiwangzi30的博客 258

200个人工智能相关毕业设计选题

本文围绕人工智能核心方向,系统梳理了涵盖深度学习、计算机视觉、自然语言处理、智能预测、智能系统开发、机器学习优化及安全伦理等七大领域的200个研究课题。内容聚焦模型优化、算法创新、多模态应用与实际场景落地,涵盖图像识别、语音处理、文本生成、风险预测、智能安防与隐私保护等前沿议题,体现人工智能技术在理论深化与工程实践中的深度融合与广泛应用。

yh1340327157yh的博客 392

三菱FX5U PLC与CCLINK模块通信配置全流程(附接线图与参数详解)

本文详细解析了三菱FX5U PLC与CCLINK模块的通信配置全流程,包括硬件接线规范、参数设置及软件编程方法。通过实战指南帮助工程师快速掌握FX5U与CCLINK模块的高效通信技术,提升工业自动化控制系统的稳定性和可靠性。

weixin_27014595的博客 430

Unity物理驱动3D汽车实现:从刚体控制到参数调优

在游戏开发中,刚体物理是实现真实物体运动与交互的核心技术。通过Unity的物理引擎,开发者可以模拟重力、碰撞、摩擦力等物理行为,为游戏世界注入真实感。其技术价值在于能够以符合物理规律的方式驱动游戏对象,避免穿墙、无视惯性等问题,从而提升游戏体验的真实性和沉浸感。这一原理广泛应用于角色控制、车辆模拟、物体破坏等场景。本文以3D小汽车为例,详细解析了如何通过Rigidbody组件施加力与扭矩,并利用C#脚本实现玩家输入逻辑,完成一辆可操控、能碰撞的物理驱动汽车。文中重点探讨了AddForce与角速度控制两种方案

weixin_34380948的博客 501

计算机硕士研究生毕设选题方向推荐 - 题目推荐

导师不理!放羊!那只好自己找题目了,中国特色,并不罕见。两个主要来源一个是狂看各专业期刊和会议的论文,看看别人在干些什么,从中找个自己能做的方向写论文,另一个是如果你有机会到各大IT公司实习的话,在实践中寻找课题,不过这要看你去哪家公司,具体干哪些活,其中的不确定因素可能更大一些。🧿httpshttpshttpshttps。...

HUXINY的博客 1万+

【硬件设计】_基于STM32单片机的智能台灯系统

智能台灯系统是一款多功能的智能照明设备,能够自动调节亮度、监测人体活动、感知环境光照,并具备定时和报警功能,极大提升了用户体验与功能的灵活性,主要包括以下功能:系统提供自动和手动两种模式以调节台灯亮度。在自动模式下,台灯会根据周围光强智能调整;而在手动模式下,用户可通过按键自行设置亮度。利用红外光电开关检测台灯与用户之间的距离,若距离过近,系统将发出报警提示。通过时钟模块设置定时提醒,并在OLED显示屏上显示当前时间,当达到设定的定时时间时,蜂鸣器将发出报警音。

2401_85381181的博客 1731

AI表情定制系统:随机森林与风格迁移技术实践

计算机视觉中的表情识别技术通过分析面部特征点实现情绪理解,其核心在于特征提取与分类算法的高效结合。随机森林算法凭借在小样本数据下的稳定表现和优秀的实时推理能力,成为轻量级表情识别系统的理想选择。结合风格迁移技术,可将识别结果转化为多样化的艺术风格,这种AI驱动的UGC(用户生成内容)生成方式正在重塑数字社交体验。在实际工程中,需平衡模型精度与计算效率,例如通过特征重要性分析优化随机森林参数,或对GAN网络进行轻量化改造。这类技术已广泛应用于即时通讯、虚拟社交等场景,本文展示的表情定制系统即实现了从特征提取到

weixin_34267123的博客 360

KEGG数据库与KAAS工具:基因功能注释的实用指南

本文提供了使用KEGG数据库与KAAS工具进行基因功能注释的完整实用指南。详细阐述了如何从准备基因或蛋白序列开始,通过KAAS服务器获取KEGG Orthology(KO)编号,并解读注释结果。文章进一步介绍了如何利用KOBAS工具进行通路富集分析,将定性观察转化为定量洞察,并分享了提高注释准确率、处理大数据集及使用API等避坑技巧与高阶方法,为基因组学、转录组学研究者奠定坚实的数据分析基础。

weixin_29292535的博客 390

零差云控 ZeroErr eRob 电机 CAN、CANopen、EtherCAT、ROS2 机器人开发详细教程

TwinCAT 3(Windows 控制与自动化技术)是 Beckhoff 提供的开发平台,可将任何兼容 PC 转变为实时控制系统,用于管理各种类型的工业自动化系统,如 PLC(可编程逻辑控制器)、运动控制、机器人等。

机器人控制与仿真应用 1万+

深度学习0:数学知识:正态分布1

步骤内容结果1引入e−x2e^{-x^2}e−x2钟形曲线2算它的面积I∫−∞∞e−x2dxI∫−∞∞​e−x2dx3平方变成二重积分I2I^2I24换极坐标简化计算5算出I2πI^2 = \piI2πIπIπ​6代入σ\sigmaσ和μ\muμ做变量替换得到σ2πσ2π​7除以它归一化得到正态分布公式2π2π​不是随便写的,它来自高斯积分∫−∞∞e−x2。

tellmewhoisi的博客 196

Python爬虫实战:利用Playwright与异步技术高效抓取链家十万级二手房数据

在开始编写代码之前,我们首先需要为项目选择合适的技术栈。1. 传统方案:Requests + BeautifulSoup优点: 简单、轻量、学习成本低。直接发送HTTP请求获取HTML,然后解析。缺点: 对于大量由JavaScript动态渲染的内容无能为力。现代网站(包括链家)大量使用JS来加载数据和实现交互,简单的HTTP请求无法获取到完整的页面内容。此外,容易被基于IP或请求头特征的反爬机制拦截。2. 进阶方案:Selenium优点。

2201_76125261的博客 891

图解循环神经网络(RNN)

RNN(循环神经网络)就是“带记忆的网络”:让网络拥有一块“记忆”,在处理当前数据时,能同时参考之前看过的内容;它不一次性看完全部输入,而是像人读书一样,一个字一个字地读,每读一个字就更新一次脑子里的记忆,然后用这份记忆去理解当前这个字。但便签一直在被改写,新信息不断挤占旧信息,传到第 40 步时,“巴黎”的痕迹已经淡得几乎没了。读到“贵”的时候,网络并没有重新去查“好看”这个词——但“好看”的影响已经融在了便签里(那个 1.5)。这三个困难的共同点:答案不在当前这一个字里,而在“前面那串东西”里。

技术管理两手抓,两手都要硬. 358

文本分析-使用jieba库进行中文分词和去除停用词(附案例实战)

本文将手把手教会你使用jieba库进行中文分词和去除停用词,这是学会文本分析的必经之路!

m0_64336780的博客 4万+

数字电视中的 Closed Caption (CC) 字幕标准协议

本文将详细介绍 DVB中的 CC 字幕标准协议,包括数据结构格式、字段定义、字段占用比特数以及字段用途。此外,本文还将举例说明如何从 TS 传输流中解析 CC 字幕信息,并组织打包到电视节目中进行显示。

以实战经验介绍行业知识 670

【原创深度学习项目】基于深度学习的建筑工地防护装备检测系统|安全帽与反光衣检测系统(RT-DETR-L 模型)

本文设计并实现了一套基于RT-DETR-L的建筑工地防护装备检测系统,采用Django+Vue前后端架构,实现对安全帽、反光背心等7类装备及“无PPE”“未戴安全帽”等缺失状态的精准识别。系统支持图片、视频、摄像头实时检测,具备参数可调、数据可视化与统计分析功能,有效解决小目标漏检、误检及管理难问题,助力智慧工地安全管理落地。文末可获取源码。

qq_1445749146的博客 215

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

神经网络入门指南:从 CNN、RNN 到 Attention

神经网络的学习,本质是“预测—比较—纠错”的循环;CNN 通过局部连接与权重共享理解图像;RNN 通过隐藏状态传递上下文;LSTM 和 GRU 用门控机制管理记忆;Encoder–Decoder 把理解与生成拆成两个阶段;Attention 则让模型在每一步都能主动寻找最相关的信息。到这里,我们已经走完了从普通神经网络到 Attention 的完整路线。下一篇将正式进入 Transformer,看看它如何摆脱 RNN 的顺序计算,又如何让每个 Token 直接找到与自己相关的信息。

爱敲代码的小黄 353

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

基于深度学习的垃圾分类系统的设计与实现

本系统是一个基于 Flask Web 框架与 PyTorch 深度学习模型的垃圾分类智能识别平台。系统面向垃圾图像分类场景,能够对上传图片中的玻璃、纸张、纸板、塑料、金属、其他垃圾等六类垃圾进行自动识别与置信度评估,并提供识别历史、数据统计、模型在线训练与记录导出等完整功能。系统使用 TrashNet 公开垃圾分类数据集进行模型训练,管理员可手动发起模型训练,训练完成后自动加载新权重。启动服务不会自动训练。

aiyuanma_vip的博客 385
上一篇: 一站式毕业设计选题推荐:人工智能技术应用课题
下一篇: 人工智能毕业设计题目选题精选:目标检测 算法
Mini_hailang_IT
博客等级 码龄9年 5936粉丝 640原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值