毕业设计:基于机器学习的异常URL检测系统 信息安全

使用机器学习识别恶意URL 通过收集恶意URL和正常URL的数据集,并提取相关特征,我们可以构建一个机器学习模型进行训练和预测。然而,需要注意的是,恶意URL的识别是一个不断演化的过程,需要定期更新数据集和模型,以应对新的威胁和攻击技术的出现。下面,我们将介绍一个基于机器学习的恶意URL识别方法,并提供相应的源代码。值得注意的是,恶意URL的识别是一个动态的过程。因此,我们需要定期更新训练数据集,并使用新的数据重新训练机器学习模型,以保持识别的准确性和效果。一种常用的特征提取方法是将URL分解为不同的组成部分,并从中提取有用的信息。 阅读详情

目录

前言

项目背景

数据集

设计思路

算法理论技术

基于近邻的协同过滤算法

基于模型的协同过滤算法

实验环境

模型训练

更多帮助


前言

    📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。

        🚀对毕设有任何疑问都可以问学长哦!

       大家好,这里是海浪学长计算机毕设专题,本次分享的课题是

       🎯基于机器学习的异常URL检测系统

项目背景

       随着互联网的快速发展,恶意软件和网络欺诈行为也日益猖獗,给用户的信息安全和网络环境带来了巨大威胁。异常URL是恶意软件和网络欺诈活动的常见手段之一。异常URL检测系统通过分析URL的特征和行为,利用机器学习算法来识别和预测恶意URL,帮助用户避免点击和访问潜在的风险网址,从而提高网络安全性和用户的信息保护能力。

设计思路

算法理论技术

基于近邻的协同过滤算法

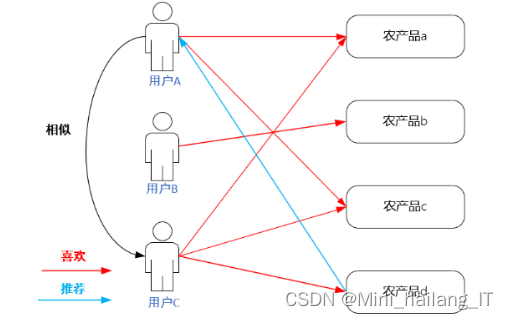
       协同过滤算法是推荐系统中最重要的思想之一。基于近邻的协同过滤算法是目前最广泛应用的方法之一,它通过寻找与目标用户或物品兴趣相似的其他用户或物品,来进行推荐。其中,基于用户的协同过滤算法通过找到与目标用户兴趣相似的其他用户,利用他们的评价或行为数据预测目标用户对未评价或未购买的物品的兴趣程度,并进行推荐。基于用户的协同过滤算法需要依赖用户的历史行为数据。通过比对不同用户的消费记录,找到具有相似消费行为的用户,可以推断它们具有较高的相似性。然后,根据这种相似性,将一个用户未购买但相似用户购买过的物品推荐给该用户。
毕业设计:基于机器学习的异常URL检测系统 信息安全

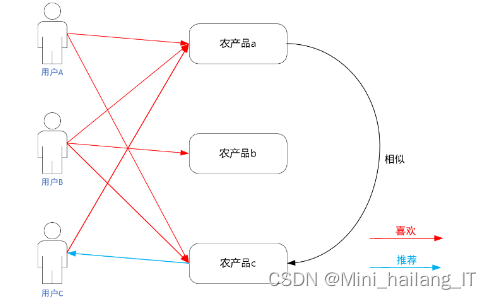
       基于物品的协同过滤算法在思想上与基于用户的协同过滤算法相似,但其重点在于计算物品之间的相似度。这种算法可以解决物品冷启动问题,特别适用于推广销量较低或曝光较少的农产品。由于农产品通常具有相对稳定的属性和特征,物品的相似性更容易捕捉。基于物品的协同过滤算法能够提供多样化的推荐结果,让用户接触到更广泛的农产品品种并提供更多选择。
毕业设计:基于机器学习的异常URL检测系统 信息安全

基于模型的协同过滤算法

       基于模型的协同过滤算法通过构建和学习推荐模型来进行推荐。与基于近邻的协同过滤算法不同,基于模型的方法不直接依赖于用户或物品之间的相似性,而是通过对用户行为和物品特征进行建模,利用机器学习、深度学习等技术来预测用户对物品的喜好。这种方法可以从大量的用户和物品数据中学习用户的喜好信息,并将这些信息作为生成个性化推荐的依据。

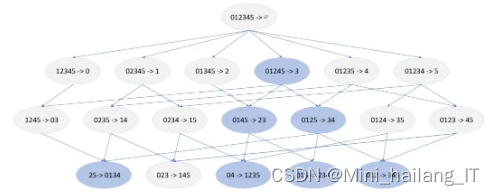
       基于模型的协同过滤算法可以利用不同的技术,如联规则算法和聚类算法,来分析用户的评分记录和建立用户和物品之间的关系模型。此外,它也可以应用于社交网络中的推荐,通过利用用户的关系数据,如好友关系,来生成用户的推荐内容,从而帮助用户扩大社交圈。
毕业设计:基于机器学习的异常URL检测系统 信息安全

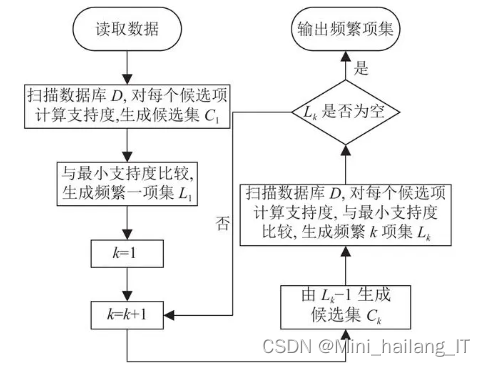
       改进后的算法是一种混合推荐算法,通过融合Apriori算法和Item-CF算法的特点,解决协同过滤算法中的数据稀疏性问题。该算法首先利用Apriori算法挖掘频繁项集,补充用户行为信息,然后使用Item-CF算法计算物品相似度,填充用户-物品评分矩阵,以提升推荐效果。通过这种融合的方式,APICF算法能够更好地适应用户的实际需求,并缓解由于数据稀疏性导致的推荐预测问题。
毕业设计:基于机器学习的异常URL检测系统 信息安全

数据集

       由于网络上缺乏现有的适用于异常URL检测系统的数据集,本研究决定通过网络爬取的方式收集数据并制作一个全新的数据集。通过开发网络爬虫,我们从不同来源的网页和在线资源中收集了大量的URL样本。这些样本包括正常的合法URL和恶意的异常URL,并涵盖了各种恶意行为和网络攻击的类型。通过网络爬取的方式,我们能够获得真实、多样的异常URL数据,提供可靠的数据基础。

       为了增加数据的多样性和覆盖度,本研究对自制的异常URL数据集进行了数据扩充。通过应用数据增强技术和生成模型,我们对原始数据进行了扩充和增强。通过数据合成、特征变换和噪声添加等技术对原始样本进行了增强,生成更多样、更具代表性的异常URL样本。

实验环境

       实验环境使用Windows操作系统,并利用Python作为主要的编程语言进行算法和模型的实现。使用PyTorch作为深度学习框架,构建和训练神经网络模型。借助Pandas等库,完成数据的加载、处理和转换。这样的实验环境提供了一个方便和高效的平台,用于开发和测试算法系统。

模型训练

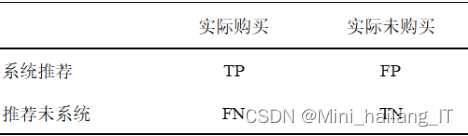
       在本次实验中,为了评估推荐算法的效果,主要使用准确率、召回率和F1值这三个指标。这些指标是在TopN推荐任务中常用的评估指标。准确率衡量了推荐列表中与用户实际喜好相符的比例,召回率评估了算法能够找到多少用户喜欢的物品,而F1值综合考虑了准确率和召回率的平衡性。通过对这三个指标的分析,可以更全面地了解算法的性能和推荐效果。
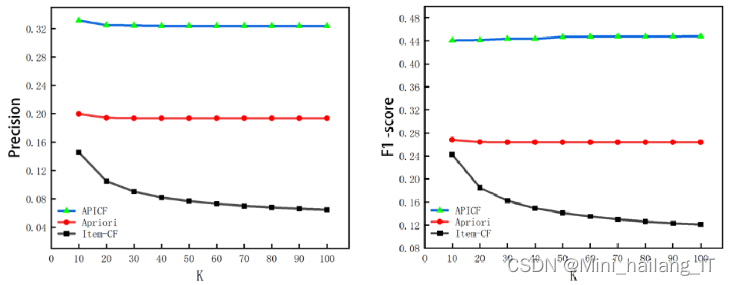
       实验通过改变最近邻个数(K)来比较Item-CF算法、Apriori算法和混合推荐算法(APICF)在推荐效果上的差异。初始时,最近邻个数K为10,并每次递增10,直到测试到K值为100为止,得到了10个评测指标数据。通过对比这三种算法的推荐效果,可以得出结论。这样的实验设计可以提供关于不同K值下算法性能的详细比较,帮助评估算法在不同情况下的推荐准确率、召回率和F1值等指标。
 相关代码示例:

# 定义函数:计算推荐算法的准确率、召回率和F1值
def evaluate_algorithm(predictions, targets):
    # 计算准确率
    precision = len(predictions.intersection(targets)) / len(predictions)
    
    # 计算召回率
    recall = len(predictions.intersection(targets)) / len(targets)
    
    # 计算F1值
    f1_score = 2 * precision * recall / (precision + recall)
    
    return precision, recall, f1_score

# 初始化参数
K = 10  # 初始最近邻个数
increment = 10  # 每次递增的最近邻个数
max_K = 100  # 最大最近邻个数

while K <= max_K:

    precision_itemcf, recall_itemcf, f1_itemcf = evaluate_algorithm(itemcf_predictions, targets)
    precision_apriori, recall_apriori, f1_apriori = evaluate_algorithm(apriori_predictions, targets)
    precision_apicf, recall_apicf, f1_apicf = evaluate_algorithm(apicf_predictions, targets)
    
    # 输出评测指标结果
    print("K =", K)
    print("Item-CF: Precision =", precision_itemcf, "Recall =", recall_itemcf, "F1 =", f1_itemcf)
    print("Apriori: Precision =", precision_apriori, "Recall =", recall_apriori, "F1 =", f1_apriori)
    print("APICF: Precision =", precision_apicf, "Recall =", recall_apicf, "F1 =", f1_apicf)
    print()
    
    # 更新最近邻个数K
    K += increment

海浪学长项目示例:

更多帮助

论文研究-基于机器学习的异常URL检测方法研究 .pdf 基于机器学习的异常URL检测方法研究,邱启哲,吴步丹,随着各行各业对于互联网依赖的不断加深,每年因恶意网站造成的损失也不断增大。本文从文本挖掘的角度分析URL特征,提出一种基于机 立即下载

相关推荐

Docker部署 SRS rtmp/flv流媒体服务器

SRS(Simple Realtime Server)是一款开源的流媒体服务器,具有高性能、高可靠性、高灵活性的特点,能够支持直播、点播、转码等多种流媒体应用场景。SRS 不仅提供了流媒体服务器,还提供了适用于多种平台的客户端 SDK 和在线转码等辅助服务,是一款十分强大的流媒体解决方案。

m0_56659620的博客 4869

WEB网站安全检测系统设计与实现

要对客户端发起的请求进行完全的监控光靠检测客户端的行为是不够的,因为这样我们只知道客户端发起什么样的请求但无法知道服务器端是如何对客户端进行响应的。Web IPS的处理流程如图2所示,具体流程如下:当客户端发送Http请求时,原始的数据报文经Http报文解析模块解析,报文解析模块会通知策略引擎模块对客户端的信息进行检测,策略引擎会依据策略脚本中编写的策略,通知Http响应模块对客户端的行为做出响应,并依据策略脚本中的策略,通知日志记录模块记录相应的日志。按照前面的分析,这一层是由服务器提供的接口封装实现。

毕业作品网站 2729

高效 DEM 拼接

通过以上步骤的系统实施,能够实现高效、准确的大型地理信息系统 DEM 数据拼接,满足复杂和大规模项目的应用需求。

llhllq2015的博客 1033

通过机器学习识别恶意url

利用机器学习【逻辑回归,svm】判断url是否为恶意 环境:Python3

菜文鸡 2万+

RabbitMq安装

本文详细介绍了在CentOS7系统上离线部署RabbitMQ4.3.2的完整流程。主要内容包括:1)准备RabbitMQ安装包、Erlang依赖和socat网络工具;2)安装系统编译依赖并编译安装Erlang;3)部署RabbitMQ服务,配置环境变量和socat依赖;4)启用Web管理插件并创建管理员账号;5)配置防火墙放行端口;6)设置Systemd开机自启服务;7)提供常用运维命令。文档特别强调离线部署注意事项,包括socat依赖、版本兼容性、账号安全及主机名配置等问题,为生产环境部署提供完整解决方案

sinat_25821779的博客 323

微信内置浏览器抓包全攻略:从ADB配置到Chrome调试(附常见问题解决)

本文提供了一套完整的微信内置浏览器抓包与调试解决方案。从ADB工具的深度配置与稳定性连接开始,详细讲解了如何开启X5内核调试开关,并利用Chrome DevTools建立远程连接。文章重点剖析了Network面板进行网络请求抓取、性能分析和问题定位的实战技巧,并附带了设备连接失败、无网络请求等常见问题的排查指南,帮助开发者高效解决微信H5页面调试难题。

gitlab7runner的博客 543

【网络空间安全数据挖掘技术】基于机器学习的钓鱼网址检测

参考论文:Pratiwi M E, Lorosae T A, Wibowo F W. Phishing site detection analysis using artificial neural network[C]//Journal of Physics: Conference Series. IOP Publishing, 2018, 1140(1): 012048.Label列是自己添加的,benign为0,phishing为1。添加了与html相关的属性速度非常慢,但是准确率有提升。

LLlanNN_的博客 2451

AI在个性化营养方案制定中的应用:从代谢组学到膳食规划

本文章的主要目的是全面探讨AI在个性化营养方案制定过程中的应用,从代谢组学的数据收集与分析,到基于这些数据制定合理的膳食规划。范围涵盖了AI技术在该领域的核心概念、算法原理、数学模型、实际项目应用,以及相关的工具和资源推荐等方面。旨在为科研人员、营养师、软件开发人员等提供一个系统的知识体系,帮助他们更好地理解和应用AI技术来实现个性化营养方案的制定。核心概念与联系:介绍AI、代谢组学和膳食规划的核心概念,以及它们之间的相互联系,并通过文本示意图和Mermaid流程图进行展示。

架构师的AI之路,分享AI应用开发架构的学习与实践。 1031

机器学习实现恶意URL检测实战一

恶意URL检测的方法很多,这里介绍通过机器学习分析URL文本分词词频来检测恶意URL。训练的数据集为开源数据集,通过机器学习训练检测模型,然后做了部分工程化的应用,将模型持久化,在应用的时候加载进来直接应用,不用重新进行训练。通过接口调用实现恶意URL检测预测判断。 恶意URL检测,对应与机器学习是个分类问题,这里分别用逻辑回归和SVM支持向量机分类模型进行模型实现。 具体实现过程包括数据载入–>数据处理(分词、向量化处理)–>模型训练–>模型保存–>模型应用 项目组织结构如下:

学而思(xiejava的blog) 1万+

STM32G474的HRTIM实战:用CubeMX配置互补PWM驱动全桥电路(附移相算法代码)

本文详细介绍了如何使用STM32G474的HRTIM高分辨率定时器,通过CubeMX配置互补PWM驱动全桥电路,并附移相算法代码。内容涵盖HRTIM硬件架构解析、CubeMX配置全流程、移相控制算法实现及调试技巧,为数字电源和电机控制领域提供实用解决方案。

weixin_27017211的博客 482

PyTorch生成式人工智能——VQ-VAE详解与实现

VQ-VAE (Vector Quantised-Variational AutoEncoder) 的核心思想就是将 VAE 的连续潜变量离散化。它通过学习一个码本 (Codebook) 来实现这一点,码本是一个包含有限个嵌入向量的字典。模型不是直接输出一个连续的潜在向量,而是从码本中找出与编码器输出最接近的嵌入向量来代替它。本节首先详细讲解 VQ-VAE 的技术原理,然后使用 PyTorch 从零开始实现 VQ-VAE 模型。

盼小辉丶的博客 3306

毕业设计:基于信息安全的钓鱼网址URL检测模型研究

基于特征提取的钓鱼网址URL检测模型,通过分析URL结构和内容特征,自动识别潜在的钓鱼网址。从大量URL数据中提取关键特征,应用统计方法选择最具代表性的特征,降低特征维度,确保模型的高效性。采用多种机器学习算法进行训练,包括逻辑回归、支持向量机和深度学习模型(如CNN、LSTM)。通过交叉验证评估模型性能,确保在训练过程中有效控制过拟合。对于计算机专业、人工智能专业、大数据专业、信息安全专业、软件工程专业、的毕业生而言,不论是对于对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能都能提供灵感

毕设帮助,疑难解答,欢迎打扰! 1033

LabVIEW进行MQTT通信及数据解析

该文章介绍了LabVIEW的MQTT通信的开源VI控制,以及如果进行数据的解析,特别是一些需要注意的点

heda3的博客 4106

信息安全毕业设计:2026 年专业毕设选题汇总(含域名检测 / 网络入侵检测/漏洞扫描方向,建议收藏)✅

信息安全专业的毕业设计方向包括网络安全、数据加密、认证与授权、区块链安全、恶意软件检测、社会工程学防护与物联网安全等,涵盖防御机制、加密实现、身份管理、智能合约安全、恶意代码分析与用户安全教育,为提升系统与数据的整体安全性提供多样研究选题。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心收集了各种有趣且具有挑战性的选题,旨在帮助学生们在毕业设计中展现他们的技术实力和创新能力

毕设帮助,疑难解答,欢迎打扰! 1109

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

信息安全专业毕业设计最新最全选题+创新点精华汇总--持续更新中④

毕设开题阶段,同学们都比较迷茫该如何选题,有的是被要求自己选题,但不知道自己该做什么题目比较合适,有的是老师分配题目,但题目难度比较大,指导老师提供的信息和帮助又比较少,不知道从何下手。与此同时,又要准备毕业后的事情,比如考研,考公,实习等,一边忙碌备考或者实习,一边还得为毕设伤透脑筋。除非是算法类或者科研性项目,项目代码要有一定的工作量和完整度,否则后期论文的撰写会很难写,因为论文是要基于项目写的,如果项目的工作量太少,又缺乏研究性的东西,则会导致很难写出成篇幅的东西。选题不能太难,也不能太简单。

laoman456的博客 820

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

毕业设计 机器学习服务器异常日志分类(源码+论文)

🔥这两年开始毕业设计和毕业答辩的要求和难度不断提升,传统的毕设题目缺少创新和亮点,往往达不到毕业答辩的要求,这两年不断有学弟学妹告诉学长自己做的项目系统达不到老师的要求。为了大家能够顺利以及最少的精力通过毕设,学长分享优质毕业设计项目,今天要分享的是🚩毕业设计 基于深度学习的新闻文本分类算法系统(源码+论文)🥇学长这里给一个题目综合评分(每项满分5分)难度系数:3分工作量:3分创新点:4分🧿 项目分享:见文末!项目包含内容1万4千字 完整详细设计论文🧿 项目分享:见文末!

m0_12378的博客 396

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

毕业设计项目 机器学习服务器异常日志分类(源码+论文)

🔥这两年开始毕业设计和毕业答辩的要求和难度不断提升,传统的毕设题目缺少创新和亮点,往往达不到毕业答辩的要求,这两年不断有学弟学妹告诉学长自己做的项目系统达不到老师的要求。为了大家能够顺利以及最少的精力通过毕设,学长分享优质毕业设计项目,今天要分享的是🚩毕业设计 基于深度学习的新闻文本分类算法系统(源码+论文)🥇学长这里给一个题目综合评分(每项满分5分)难度系数:3分工作量:3分创新点:4分🧿 项目分享:见文末!项目包含内容1万4千字 完整详细设计论文🧿 项目分享:见文末!

loop_yang123的博客 430

毕设开源 机器学习服务器异常日志分类(源码+论文)

本文介绍了一个基于深度学习的新闻文本分类算法系统项目,旨在帮助毕业生解决毕设创新性不足的问题。项目通过机器学习技术对服务器日志进行异常检测,采用结构化编码和实体嵌入算法处理日志数据,并训练SVM、LR、PCA和决策树四种模型进行特征识别。实验结果显示,该方法在恶意登录检测上准确率达98.1%,并开发了可视化工具模块。项目包含完整源码、1.4万字论文及演示视频,综合评分为难度3分、工作量3分、创新性4分,为网络安全领域的异常检测提供了有效解决方案。

HUXINY的博客 951

毕设 机器学习服务器异常日志分类(源码+论文)

🔥这两年开始毕业设计和毕业答辩的要求和难度不断提升,传统的毕设题目缺少创新和亮点,往往达不到毕业答辩的要求,这两年不断有学弟学妹告诉学长自己做的项目系统达不到老师的要求。为了大家能够顺利以及最少的精力通过毕设,学长分享优质毕业设计项目,今天要分享的是🚩毕业设计 基于深度学习的新闻文本分类算法系统(源码+论文)🥇学长这里给一个题目综合评分(每项满分5分)难度系数:3分工作量:3分创新点:4分🧿 项目分享:见文末!项目包含内容1万4千字 完整详细设计论文🧿 项目分享:见文末!

mabile123444的博客 492
上一篇: 毕业设计:基于深度学习的的人物跌倒检测系统
下一篇: 毕业设计:基于深度学习的肺结节识别系统 目标检测 人工智能
Mini_hailang_IT
博客等级 码龄9年 5936粉丝 640原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值