毕业设计:基于大数据的餐饮消费可视化系统 python

数据分析项目一:餐厅数据分析 基本的pandas、numpy、matplotlib库要导入,然后设置中文字体,这里使用read_excel()函数导入excel表,如果excel文件中有多张工作表后面的sheet_name表明要标注是哪一张。 阅读详情

目录

前言

项目背景

设计思路

更多帮助


前言

    📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。

        🚀对毕设有任何疑问都可以问学长哦!

       大家好,这里是海浪学长大数据毕设专题,本次分享的课题是

       🎯基于大数据的餐饮消费可视化系统

项目背景

       随着餐饮行业的快速发展,餐饮消费数据呈现出爆炸性增长。这些数据中蕴含着丰富的信息,对于了解消费者喜好、市场趋势、菜品优化等方面具有重要意义。因此,建立一个基于大数据的餐饮消费可视化系统,旨在通过数据挖掘和分析,为餐饮企业提供决策支持。本课题将有助于提升餐饮企业的竞争力,并为其他行业的可视化数据分析提供借鉴。

设计思路

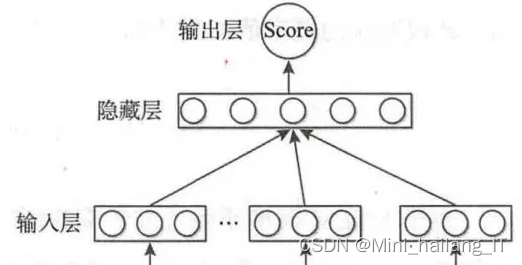
       在评论情感分析中应用机器学习算法的方法,包括支持向量机、多项式朴素贝叶斯和伯努利贝叶斯三种算法。首先进行人工标注,然后进行分词和去停用词处理,接着采用TF-IDF向量化,最后通过十次十折交叉验证训练模型,并使用召回率和准确率计算F值作为分类效果评判标准。最终选择效果最好的模型用于判别情感极性。

       随机选取一定数量的评论,并由人工对它们的情感极性进行标注,其中积极情感标注为1,消极情感标注为-1。为了保证分类器的效果,标注的积极和消极情感数量需要保持一致。由于餐饮订购网站评论文本具有较强的领域性,我们使用PYNLPIR分词工具进行分词,并加入用户字典以提高分词的准确性。此外,通过停用词库去掉停用词,可以降低特征维度,提高模型的分类效果。
data = pd.read_csv('reviews.csv')  
  
data['tokens'] = data['review'].apply(lambda x: nlpir.cut(x, to_hownet=True, to_syn=True))  
  
data['tokens'] = data['tokens'].apply(lambda x: [word for word in x if word not in stop_words])  
  
labels = []  
for i in range(len(data)):  
    if i % 2 == 0:  
        labels.append(1) # 积极情感标注为1  
    else:  
        labels.append(-1) # 消极情感标注为-1  
data['label'] = labels  
  
X_train, X_test, y_train, y_test = train_test_split(data['tokens'], data['label'], test_size=0.2)  
    
vectorizer = TfidfVectorizer()  
X_train = vectorizer.fit_transform(X_train)  
X_test = vectorizer.transform(X_test)  
  
classifier = LogisticRegression()  
classifier.fit(X_train, y_train)  
  
y_pred = classifier.predict(X_test)  
accuracy = accuracy_score(y_test, y_pred)  
print("Accuracy:", accuracy)

        将文本数据转化为数值向量,即文本向量化。这里我们采用scikit-learn库提供的TF-IDF接口构建向量空间模型。TF-IDF是一种常用的文本向量化方法,它通过计算词语在文档中的出现频率和逆文档频率来衡量词语的重要性。 TF-IDF的核心思想是,一个词在特定文档中的重要性与其在该文档中的出现频率成正比,与其在所有文档集合中的普遍性成反比。TF-IDF向量化方法将文本数据转化为数值向量,使得计算机可以更容易地进行数学运算和数据分析。
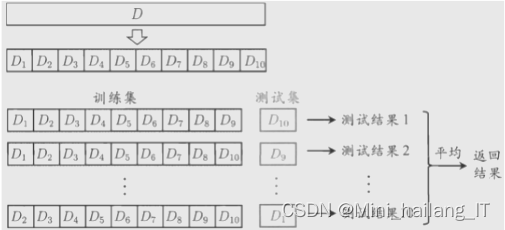
       采用十次十折交叉验证方法分别训练三种模型。十折交叉验证是一种常用的评估机器学习模型性能的验证方法。它将数据集分成十份,轮流将其中9份作为训练数据,1份作为测试数据,进行试验。每次试验都会得出相应的正确率(或差错率)。10次的结果的正确率(或差错率)的平均值作为对算法精度的估计。这种方法的优势在于能够减少评估过程中的偏差,因为每次试验使用的训练和测试数据都是不同的。此外,十折交叉验证还可以用于估计模型的泛化能力,因为它通过在不同的数据子集上测试模型来模拟了模型的泛化性能。
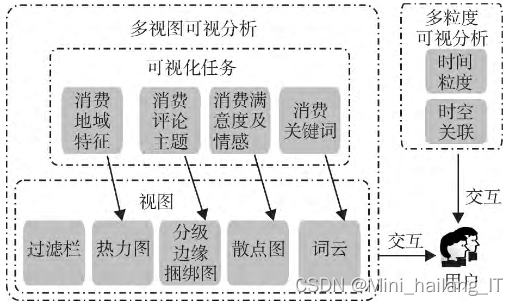
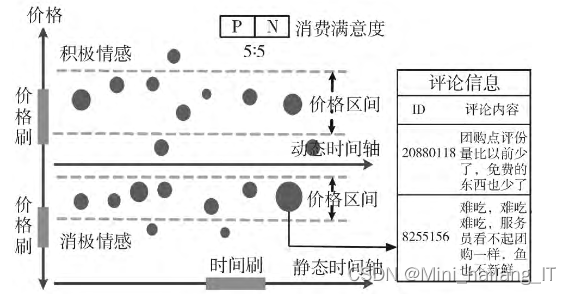
       情感分析图通过散点图的方式展示不同商铺在不同时间、不同价格的情感变化。用户可筛选时间和商铺类型,查看具体情感和数量。消费满意度由积极和消极情感比例计算得出。异常情感可快速定位,便于判断消费者选择和价格区间及情感与价格的关系。该图用于舆情监控,帮助用户更好地理解消费者情感变化。
       对团购网站评论数据进行了主题提取和关键词提取,以识别消费行为特征。在可视分析阶段,采用分级边缘捆绑图和标签云展示主题词和关键词,并设计了基于时空维度的多粒度过滤方法,对同一属性在不同粒度下反映出的特有规律或特征进行分析,为消费者行为分析提供依据。
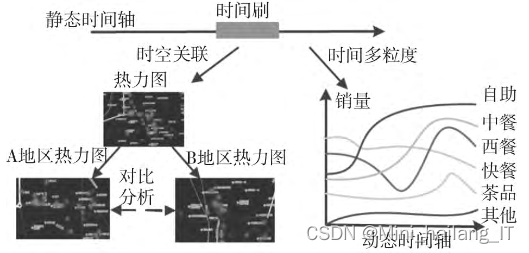
       多粒度时空关联分析旨在探究时间和地域对城市餐饮消费行为的影响。在时空关联分析中,用户可以选择不同的时间粒度,并使用热力图在地图上显示选定时间粒度下的商铺销量分布。通过对比不同时间粒度下不同地区的销量,可以深入了解消费行为的时空特征。多粒度时空关联分析具有灵活的时间选择和直观的数据可视化优势,能够深入探究消费行为的时空特征。然而,它可能无法有效检测特定情况,存在主观性,且在处理大规模数据时性能受限,需要在使用中注意其局限性。

df['date'] = pd.to_datetime(df['date'])  
df.set_index('date', inplace=True)  
  
# 创建一个按日期分组的DataFrame,以便我们可以对每天的数据进行操作  
df_daily = df.groupby(pd.Grouper(freq='D')).sum()  
  
# 创建一个按月分组的DataFrame  
df_monthly = df.groupby(pd.Grouper(freq='M')).sum()  
  
# 使用matplotlib进行数据可视化  
plt.figure(figsize=(10,6))  
  
# 画出每日数据  
plt.subplot(211)  
plt.plot(df_daily.index, df_daily['your_column'])  
plt.title('Daily Data')  
plt.xlabel('Date')  
plt.ylabel('Value')  
  
# 画出每月数据  
plt.subplot(212)  
plt.plot(df_monthly.index, df_monthly['your_column'])  
plt.title('Monthly Data')  
plt.xlabel('Date')  
plt.ylabel('Value')  
  
plt.tight_layout()  # 自动调整子图间距,使其看起来更整齐。  
plt.show()  # 显示图形。

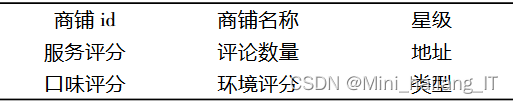
       由于现有的餐饮消费数据集无法满足本课题的需求,我决定自制一个全新的数据集。首先,从各大餐饮平台和商家收集消费数据,确保数据的全面性和实时性。其次,对收集到的数据进行清洗和预处理,包括去重、异常值处理、数据格式统一等操作。然后,将数据按照特定的结构存储在数据库中,以便后续的数据分析和可视化。最后,通过实际应用和测试,不断优化数据集的质量和效果,确保其能够为餐饮企业的决策提供有力支持。
import requests  
from bs4 import BeautifulSoup  
  
url = 'http://www.example.com/restaurants'  
  
response = requests.get(url)  

soup = BeautifulSoup(response.text, 'html.parser')  

restaurants = soup.find_all('div', class_='restaurant')  
 
for restaurant in restaurants:  
    name = restaurant.find('h1').text  
    address = restaurant.find('p', class_='address').text  
    phone = restaurant.find('p', class_='phone').text  
    website = restaurant.find('a', href=True)['href'] if restaurant.find('a', href=True) else None  
    print(name, address, phone, website)

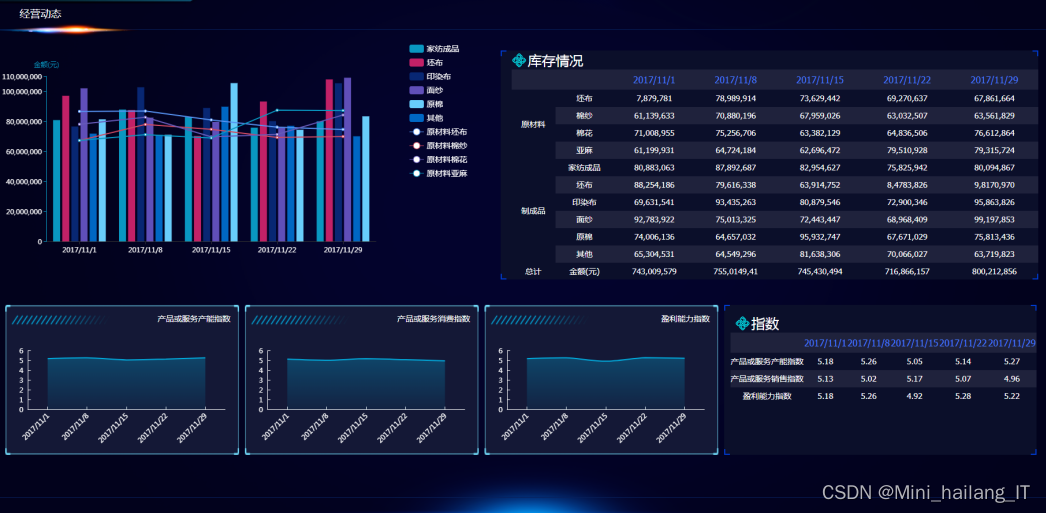
海浪学长项目示例:
更多帮助

餐饮外卖平台数据集(大数据) 这个数据集是顾客对各个商家餐饮服务的评价由标签和评价两个数据项组成。 label=1(正向评价) label=0(负向评价) 用jieba(自然语言处理)库对用户评价进行分类,对商家的餐饮质量进行分析,把商家更加直观的呈现给顾客,让顾客选择更方便简洁。 立即下载

相关推荐

ARIMA时间序列分析:预测餐厅销量 数据集

销售数据:第一列为日期(2015/1/1-2015/2/6),第二列为销售量。

餐厅订单数据分析【Python】

餐厅订单表格数据资源如下百度网盘👇。

Infinity_and_beyond的博客 3923

餐馆点评数据集 CSV 440W+数据

4 万家餐馆,54 万用户,440 万条评论/评分数据

前端(echarts+百度地图api)后端(python+flask)完成绵阳餐饮消费数据可视化系统

一、可视化要求 针对团购网站餐饮类消费数据的可视分析系统设计与开发 大多数消费者在选择团购网站消费后会做出相应评价,从而产生海量的交易数据。这些数据包含了消费者对饮食比较全面的主观性评价和量化评分,因此通过对此类餐饮数据的分析能够有效洞悉城市餐饮消费行为。而由于该类数据体量大、数据类型多等特点,使得传统的数据分析技术已经难以有效进行分析处理。如何将可视分析技术应用于团购网站餐饮类数据分析,探索城市消费行为是一个新颖的研究课题。提供某团购网站绵阳市3444家餐饮类店铺数据的基本信息及351941条评论信息,其

oNew_Lifeo的博客 3940

上海餐饮数据集,csv格式格式,用于基于聚类算法的城市餐饮数据

上海餐饮数据集,csv格式格式,用于基于聚类算法的城市餐饮数据分析与店铺选址案例。其中包括类别、行政区、点评数、口味、环境、服务、人均消费、城市、Lng和Lat等信息。

餐饮商铺数据集(16列,44512条记录)XLSX

包含字段:店铺id、店铺名称、经度、纬度、人均消费、评分、评论数量、距离描述、米其林推荐指数、归属商圈、菜系类型、city、county、营业时间、地址、店铺电话

基于大数据的上海餐饮数据可视化分析系统 大数据毕业设计 计算机毕业设计 机器学习毕业设计 毕业设计定制开发 大屏可视化 全新UI定制设计

上海餐饮数据可视化分析系统摘要:该系统基于Hadoop+Spark大数据框架,采用Python+Django/Vue技术栈,对上海餐饮业进行多维度分析。实现四大核心功能:1)餐饮分布分析(热力图/类型占比);2)消费水平分析(区域消费对比/价格档次);3)服务质量评估(口味/环境/服务评分);4)商圈竞争格局(K-Means聚类分析)。系统集成了Spark SQL数据处理、Pandas/NumPy统计分析,通过Echarts实现可视化呈现,为餐饮从业者、投资者及消费者提供数据支持。

计算机毕业设计小明哥的博客 626

solidworks vba二次开发配合问题

solidworks vba二次开发配合问题二次开发装配的步骤 二次开发装配的步骤 solidworks可以使用宏录制配合过程从而得到配合的vba代码,步骤如下: 1.选择两个配合的面(点、线等) 2. 建立配合 例如将两个圆柱面同心(图中高亮): 配合后 我们看一下宏录制的代码: Sub main() //激活solidworks接口 Set swApp = Application.SldWorks Set Part = swApp.ActiveDoc //选择两个圆柱面,注意此处是根据坐标选择,不

Alejandro123的博客 3405

大数据毕业设计选题推荐-基于大数据的餐饮服务许可证数据可视化分析系统-Spark-Hadoop-Bigdata

文章摘要: 本文介绍了“基于大数据的餐饮服务许可证数据可视化分析系统”,该系统利用Hadoop+Spark处理海量数据,结合Python/Java和Django/Spring Boot框架开发,前端采用Vue+Echarts实现交互式可视化。系统通过分析许可证数据,从区域分布、经营业态、生命周期等维度揭示餐饮行业趋势,助力政府监管和企业决策。展示了数据大屏、时空分析、企业画像等功能界面,并附有Spark数据处理代码示例,支持餐饮行业数字化转型与精准管理。项目提供定制化开发服务。

IT研究室的博客 1042

基于单目视觉的四旋翼定点降落——如何通过mavros控制pixhawk(二)

    一直拖了这么久没有更新,怪我太懒啦~~~ 今天要特别感谢舒仔仔同学,我的好队友帮我写了这篇博文。这篇文章主要讲了如何通过mavros来控制pixhawk。硬件逻辑是这样子,我们先搞一个odroid(土豪上TX2),再用usb线将odroid与pixhawk连接。所以,odroid发送控制指令来控制pixhawk飞行。pixhawk与外界的通信协议是mavlink。ROS下面有个包叫mavr...

zhengyuxin0507的博客 1万+

PLUS模型土地利用变化模拟使用简介

因子包括自然因子如社会因子,通过计算整理得到新图层,并以tif文件输出到驱动因子的文件夹里,驱动因子文件夹里存放的是tif文件格式。线性回归使用提供的所有的LULC资源数据,可以选择往后预测的年数,选择好数据之后,可以得出预测的每一年的每一用地类型面积数据。在此过程之后,可以继续使用此CARS输入的数据继续模拟,也可返回二(3)中CARS模块,重新输入不同的年份预测。在此过程之后,可以继续使用此CARS输入的数据继续模拟,也可返回二(3)中CARS模块,重新输入不同的年份预测。

qq_42831270的博客 5808

【数据分析】基于大数据的上海餐饮数据可视化分析系统 | 大数据毕设实战项目 选题推荐 可视化大屏 Hadoop SPark java Python

基于大数据的上海餐饮数据可视化分析系统是一个综合运用Hadoop和Spark技术的毕业设计项目,针对上海地区餐饮行业数据进行深度挖掘和可视化展示。系统采用Hadoop分布式存储和Spark快速处理技术,支持Python+Django和Java+SpringBoot两种后端方案,前端使用Vue+ElementUI构建交互界面,通过Echarts实现动态数据可视化。核心功能包括餐饮分布分析、消费分析、质量分析和竞争分析四大模块,帮助用户直观了解上海餐饮市场特征,为决策提供数据支持。项目代码展示了使用PySpar

计算机毕业设计江挽的博客 1010

C# 实现文件和字符串的AES加密解密

C# 实现文件和字符串的AES128加密解密

m0_72044573的博客 5935

【Python大数据+AI毕设实战】上海餐饮数据可视化分析系统、计算机毕业设计、包括数据爬取、Spark、数据分析、数据可视化、Hadoop、实战教学

【Python大数据+AI毕设实战】上海餐饮数据可视化分析系统、计算机毕业设计、包括数据爬取、Spark、数据分析、数据可视化、Hadoop、实战教学

biyesheji88的博客 866

Ubuntu系统全盘备份——TimeShift的安装与使用

所以如果有那天你不小心作了个大死,并且幸运到还能打开GNOME桌面和Timeshift(只要不是执行sudo rm -f /*这样的自杀程序)的时候,点击你要恢复的那个备份文件再点击Restore,经过短暂的重启后你的系统就成功恢复了。打开软件后,会有一些初始化设置,只需要一直点击 Next。根据自己电脑的内存大小决定是自动备份还是手动备份。当然,对于虚拟机用户来说,没有比在客户机直接拷贝虚拟磁盘文件更棒的方式了。点击左上角的 Create,就会执行备份操作。最下面的意思就是说不会自动备份需要手动操作。

琉璃轻纱的博客 4703

RAG测评实战代码

本文主要介绍了RAG测评实战代码,希望对使用RAG的同学们有所帮助。 文章目录 1. 前言 2. 实战代码 2.1 实战代码一 2.2 实战代码二

herosunly的博客 1万+

python重庆餐饮美食数据可视化大屏全屏系统设计与实现(django框架)

python重庆餐饮美食数据可视化大屏全屏系统设计与实现(django框架),通过文本分析技术对评论进行情感分析等。通过建立一个基于django框架的重庆餐饮美食数据可视化大屏全屏系统,可以更加直观地展示市场上餐饮美食的情况,并为从业人员提供更加准确的市场分析和预测,帮助他们更好地制定营销策略和提高经营效率。本系统的研究思路是通过收集重庆市所有餐饮店铺的相关数据,使用数据分析技术将这些数据进行整理和分析,并将分析结果可视化展示在一个大屏幕上,以帮助从业人员更好地了解市场情况。

杭州.黄老师 3748

从 SAP ABAP 到 S/4HANA,SAML 2.0 单点登录到底是怎么跑起来的

在很多 SAP 项目里,SSO 不是一个锦上添花的功能,而是系统能不能顺利上线的基本门槛。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1050

【数据分析】基于大数据的餐饮外卖平台数据分析系统 | 大数据毕设实战项目 大数据选题推荐 数据可视化大屏 Hadoop SPark java Python

本文介绍了一个基于大数据的餐饮外卖平台数据分析系统。该系统采用Hadoop+Spark技术框架,结合Django和Vue,构建了完整的数据分析解决方案。系统通过分布式存储管理外卖订单、用户行为等多维度数据,利用Spark SQL等进行数据处理,提供11个功能模块,包括消费行为分析、菜品销售分析等,并借助Echarts实现数据可视化展示。系统代码示例展示了如何使用Spark进行消费行为分析,包括时间分布、用户年龄分组、订单频率等维度的数据处理和统计分析。该平台为餐饮外卖行业提供了科学的运营决策支持,展示了大数

2501_92994129的博客 1444

YOLO26涨点改进 | 全网独家创新,注意力改进篇| SCI一区Top | 引入AFCA自适应细粒度通道注意力,联合建模全局与局部通道依赖关系,适合目标检测、图像去雾、关键点检测、图像分类、图像分割

🔥本文提出了一种基于AFCA(自适应细粒度通道注意力)模块改进的YOLO26目标检测网络。AFCA通过联合建模全局与局部通道依赖关系,实现了更精细的通道注意力分配,能够增强目标相关特征并抑制背景噪声。该模块采用自适应融合策略动态平衡通道权重,在保持轻量级结构的同时,显著提升了小目标和复杂背景下的检测性能。文章详细介绍了AFCA的结构原理、实现优势,并提供了完整的代码实现和YAML配置文件,指导读者如何将该模块集成到YOLO26框架中。实验结果表明,AFCA在检测精度和鲁棒性方面优于传统注意力机制。

Ai缝合怪、助力小伙伴高效发论文 304

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

基于大数据的餐饮管理系统可视化分析系统(毕业设计源码+lw文档)

当前餐饮企业运营存在数据利用不足与决策滞后的问题:门店日常产生的海量数据(客流、销量、库存、成本)分散存储于各系统,难以整合分析;管理层缺乏直观的可视化工具,难以快速洞察经营瓶颈(如高峰时段人力不足、滞销菜品占比高);连锁品牌难以横向对比各门店绩效差异,区域化运营策略缺乏数据支撑;同时,消费趋势预测依赖经验判断,易造成食材浪费或供应短缺,制约餐饮企业的精细化运营与规模化发展。 基于大数据的餐饮管理系统可视化分析系统,依托大数据处理技术与可视化工具,构建 “数据整合 - 多维分析 - 智能决策” 生态:实时采

博主自己就是程序员、避免中介对接,从事软件开发多年,累计开发或辅导多名同学, 有丰富的项目开发和文档编写经验、同学们有任何项目问题都可以联系我~ 982

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

基于大数据的餐饮外卖平台数据分析系统【python、Hadoop、spark、MySQL、python项目、大数据毕设选题、论文书写】【源码+论文+答辩】

基于大数据的餐饮外卖平台数据分析系统【python、Hadoop、spark、MySQL、python项目、大数据毕设选题、论文书写】【源码+论文+答辩】

计算机毕业设计小途的博客 1166

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

计算机毕设如何做出大数据效果?《餐饮服务许可证可视化分析系统》告诉你答案

计算机毕设如何做出大数据效果?《餐饮服务许可证可视化分析系统》告诉你答案计算机毕设如何做出大数据效果?《餐饮服务许可证可视化分析系统》告诉你答案

计算机毕业设计小明哥的博客 1047

python上海餐饮美食数据可视化大屏全屏系统设计与实现(django框架)

python上海餐饮美食数据可视化大屏全屏系统设计与实现(django框架),他们都建立了自己的数据分析中心,通过大数据分析对消费者的口味、点餐方式等进行研究,以便不断优化菜单和服务。同时,基于Django框架,实现了系统的后台管理和前端功能,包括用户管理、数据管理、权限管理、数据可视化展示、数据查询、数据导出等。通过采用现有的技术手段和平台,可以实现对上海餐饮市场数据的深度分析和可视化呈现,有助于经营者和消费者进行更细致、准确的决策。

杭州.黄老师 4532

基于python外卖订餐数据分析系统 餐饮数据 可视化大屏 实时监控大屏 Flask框架 大数据毕业设计(源码)✅

基于python外卖订餐数据分析系统 餐饮数据 可视化大屏 实时监控大屏 Flask框架 大数据毕业设计(源码)✅

q_3375686806的博客 1711

Python毕业设计选题推荐:基于大数据的美食数据分析与可视化系统实战

本文介绍了一个基于Python技术栈的大众点评美食数据分析与可视化系统。系统采用Scrapy框架爬取店铺信息,利用Spark进行数据清洗和聚合分析,构建了区域特征、消费者偏好、质量评价和商业价值四大分析模块,应用K-means聚类、决策树等算法挖掘餐饮市场规律。可视化层面使用Pyecharts生成交互式图表,如热力图、雷达图等,直观展示餐厅分布、消费偏好等分析结果。开发环境整合了Hadoop、Spark等大数据技术及Django、Vue等前后端框架。系统为消费者提供就餐参考,为创业者辅助市场决策,同时展现了

BYSJLG的博客 1568
上一篇: 毕业设计:基于大数据的药品销售数据可视化系统 python
下一篇: 毕业设计:基于大数据的电商销售数据可视化系统 python
Mini_hailang_IT
博客等级 码龄9年 5936粉丝 640原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值