


目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
选题指导:
大家好,这里是海浪学长毕设专题,本次分享的课题是
🎯基于深度学习的工程地质勘察现场目标检测系统
设计思路
一、课题背景与意义
现状多数省份的勘察信息化管理系统的平台,仅是从“纸质记录”向“手机APP记录”的方式转变,仍需要大量的人为操作。虽然已经实现通过视频采集摄像头完成对现场作业人员及设备的实时监控,但缺少对信息的识别和提取。其本质是对流程的信息化,没有充分利用现阶段迅速发展的“机器视觉”等领域的发展成果。为了自动识别地质勘察现场的人员、设备及动作,实现工程地质勘察钻探现场的远程自动监控很有必要。
二、算法理论原理
工程地质勘察现场目标检测系统运行流程:首先利用数据增强算法对自制数据集进行处理,并利用增强后的自制数据集对YOLOv5s模型进行训练,使其达到可以良好反映钻探现场各预定检测目标的水平。通过输入钻探现场摄像头实时采集的视频或图片,生成检测结果。通过对检测结果的分析提取钻机工作状态,对处于异常状态的钻机生成提醒并及时反馈。

YOLOv5模型主要由输入、Backbone、Neck、输出4部分组成。

相关代码:
image_hsv = image.convert('HSV')
    h, s, v = image_hsv.split()
    hue_factor = hue * np.random.uniform(-1, 1)
    h = np.array(h, dtype=np.uint8)
    h = (h + hue_factor * 255) % 255
    h = Image.fromarray(h)
    image_hsv = Image.merge('HSV', (h, s, v))
    image = image_hsv.convert('RGB')

    return np.array(image)

def adjust_channels(image, r_factor=1.0, g_factor=1.0, b_factor=1.0):
    # RGB三通道调整
    image[:, :, 0] = np.clip(image[:, :, 0] * r_factor, 0, 255)
    image[:, :, 1] = np.clip(image[:, :, 1] * g_factor, 0, 255)
    image[:, :, 2] = np.clip(image[:, :, 2] * b_factor, 0, 255)

    return image

# 加载图像
image_path = 'path_to_image.jpg'  # 图像路径
image = cv2.imread(image_path)

# 色彩抖动处理
image_jittered = color_jitter(image, brightness=0.2, contrast=0.2, saturation=0.2, hue=0.1)

# RGB三通道调整处理
image_adjusted = adjust_channels(image_jittered, r_factor=1.2, g_factor=0.8, b_factor=1.0)

# 显示处理后的图像
cv2.imshow('Original Image', image)
cv2.imshow('Augmented Image', image_adjusted)
cv2.waitKey(0)
cv2.destroyAllWindows()
三、检测的实现
3.1 数据集
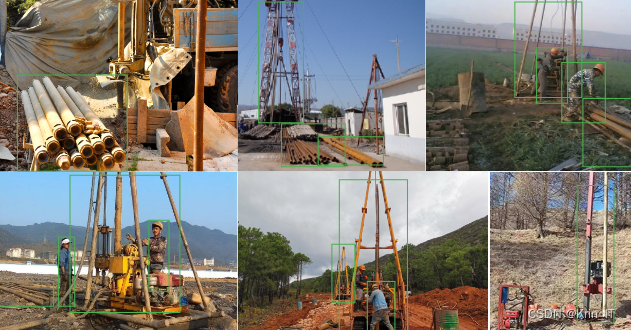
自制数据集图片共计1200张,图片涵盖了处于早中晚等不同光照背景下,位于山区、城市等不同勘探环境的工程地质勘察钻探作业现场。图片内容包括正在执行钻探、原位测试、下放套管等不同工作状态下的现场情景。

输入端功能包含马赛克数据增强(Mosaic)、自适应锚框计算等。Mosaic数据增强指通过对随机选取图片进行拼接呈新的图片,获得行的锚定框,极大丰富了检测物体的背景。
3.2 实验环境搭建
模型训练环境为NVIDIA GeForce RTX3080Ti,开发语言为Python,Pytorch框架。模型采用YOLOv5系列中体积最小,部署最灵活的YOLOv5s网络模型,设置参数如下:Batch大小为32;动量系数设置为0.937,权重衰减为0.005,学习率为0.01,学习率更新采用Warm-up方法,批尺寸为16。训练迭代次数为1200。
3.3 实验及结果分析
输出端主要包括GIOU_Loss损失函数计算方法,提高了相交尺度衡量,代替了以往模型中常见的IOU_Loss损失函数计算方法。在经过了300次左右的训练后,YOLOv5s模型的损失函数(GIoU)已经较初始有了较大的改善,在经历了800轮左右的训练后,损失函数已经趋于稳定。

在各种钻探施工条件及不同光照背景下,基于YOLOv5s的检测模型可以对施工现场的钻机、工人、钻杆、标贯锤等多种对象进行识别,平均精度mAP值为91.5%。即使在现场工人对钻机正在进行操作,产生明显遮挡的情况下,也能对被遮挡的对象产生良好反应。
相关代码如下:
import torch
import torchvision
from torchvision.models.detection import faster_rcnn
from torchvision.transforms import transforms
from torch.utils.data import DataLoader
from PIL import Image

# 定义数据集路径和其他参数
dataset_path = 'path_to_dataset'  # 数据集路径
num_classes = 2  # 目标和背景的类别数

# 数据预处理和增强
transform = transforms.Compose([
    transforms.ToTensor(),
])

# 加载数据集
dataset = torchvision.datasets.VOCDetection(dataset_path, year='2007', image_set='train', download=True, transform=transform)

# 创建数据加载器
batch_size = 32
dataloader = DataLoader(dataset, batch_size=batch_size, shuffle=True)

# 加载预训练的模型
model = faster_rcnn.mobilenet_v2(pretrained=True)
model = model.cuda()  # 将模型移动到GPU(如果可用)

# 定义优化器和损失函数
optimizer = torch.optim.SGD(model.parameters(), lr=0.001, momentum=0.9)
criterion = torch.nn.CrossEntropyLoss()

# 训练模型
num_epochs = 10

for epoch in range(num_epochs):
    for images, targets in dataloader:
        images = images.cuda()
        targets = [target.cuda() for target in targets]

        # 前向传播
        outputs = model(images)
        loss = criterion(outputs, targets)

        # 反向传播和优化
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    print(f"Epoch [{epoch+1}/{num_epochs}], Loss: {loss.item()}")

# 保存训练好的模型
torch.save(model.state_dict(), 'path_to_save_model.pth')
实现效果图样例

创作不易,欢迎点赞、关注、收藏。
毕设帮助,疑难解答,欢迎打扰!


 919


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


