这才是真・开源模型!公开「后训练」一切,性能超越Llama 3.1 Instruct

Tülu 3:重新定义开源大模型的后训练范式 Tülu 3 代表了当前开源大模型后训练的最高水平,它不仅是一个单一的模型,而是一个完整的模型家族。AI2发布的这个系列包含了两个主要版本:Tülu 3 8B和Tülu 3 70B,同时还预告了即将推出的405B版本。这种多规格的部署策略,让开发者可以根据实际需求和计算资源选择合适的模型版本。Tülu 3 的发布标志着开源模型后训练领域的一个重要里程碑。当Meta发布Llama 3.1报告时,AI2团队以其后训练模型为优化目标,不仅成功超越了Meta官方的指令版本性能,更开创性地将整个训练方案完全开源。 阅读详情

图片

在最近关于「Scaling Law 是否撞墙」的讨论中,后训练(post-training)被寄予厚望。

众所周知,近期发布的 OpenAI o1 在数学、 代码、长程规划等问题上取得了显著提升,而背后的成功离不开后训练阶段强化学习训练和推理阶段思考计算量的增大。基于此,有人认为,新的扩展律 —— 后训练扩展律(Post-Training Scaling Laws) 已经出现,并可能引发社区对于算力分配、后训练能力的重新思考。

不过,对于后训练到底要怎么做,哪些细节对模型性能影响较大,目前还没有太多系统的资料可以参考,因为这都是各家的商业机密。

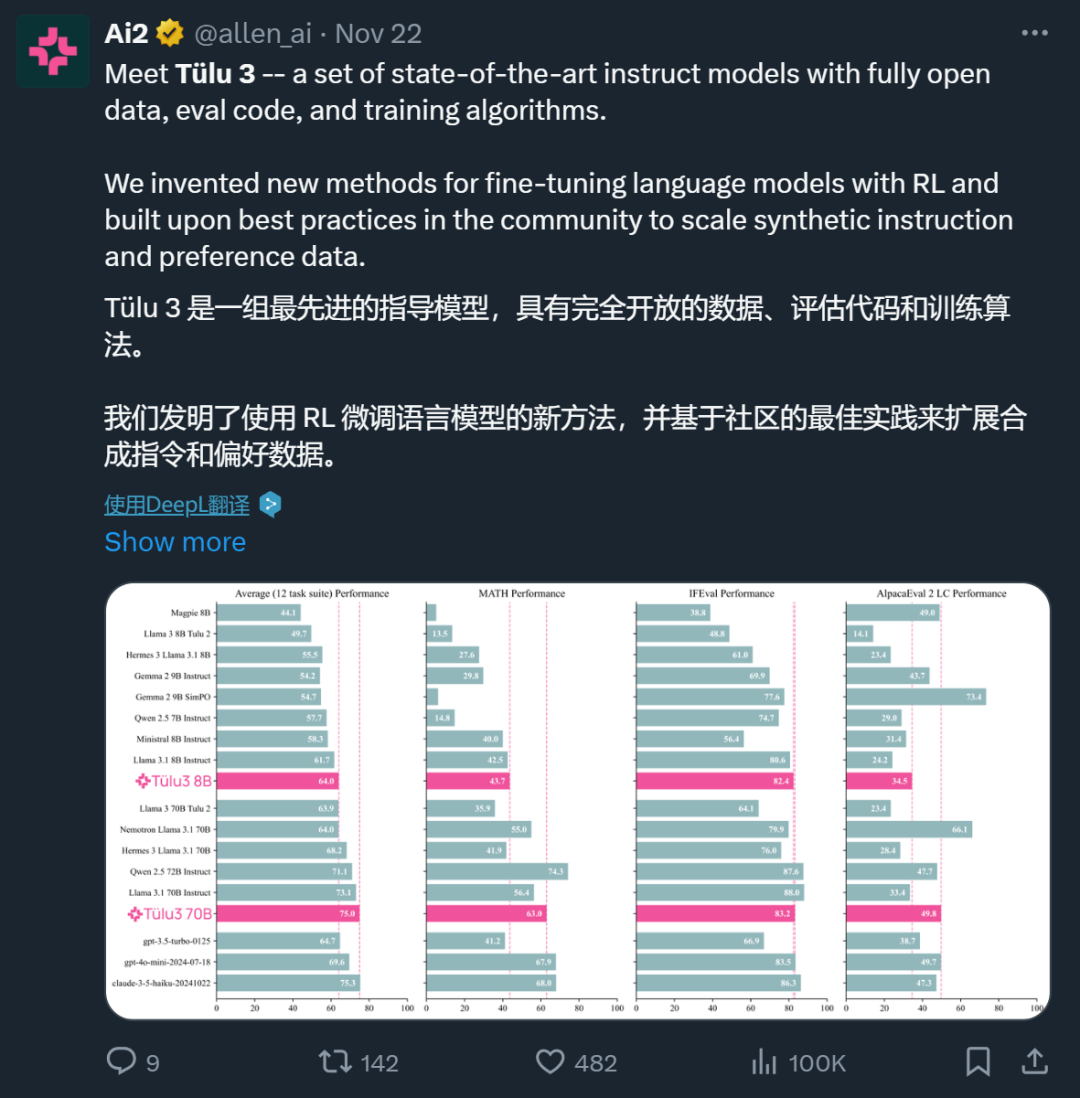
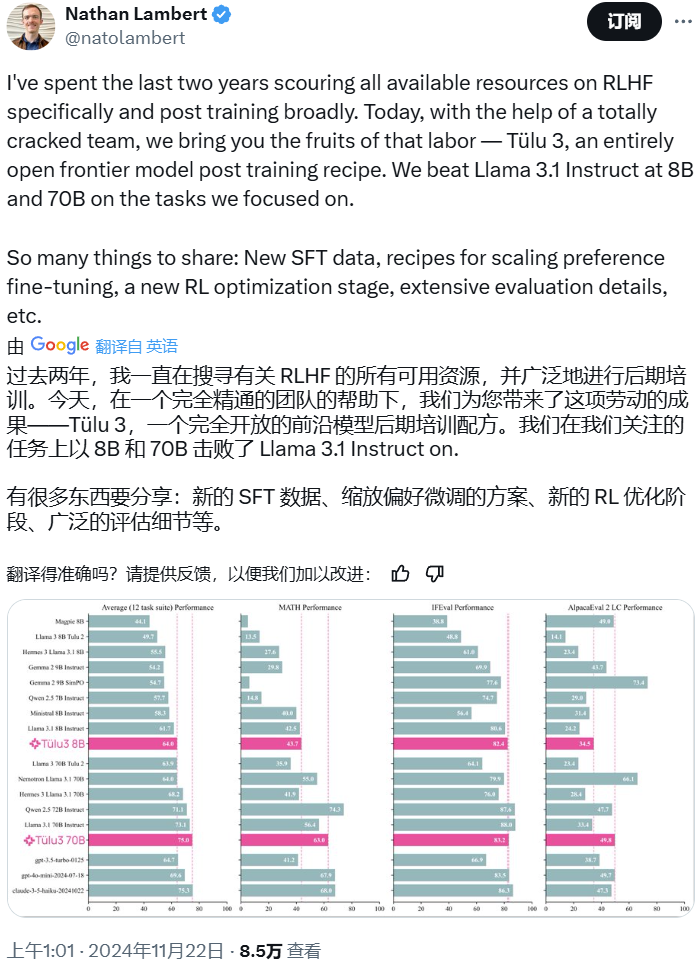
刚刚,曾经重新定义「开源」并发布了史上首个 100% 开源大模型的艾伦人工智能研究所(Ai2)站出来打破了沉默。他们不仅开源了两个性能超过 Llama 3.1 Instruct 相应版本的新模型 ——Tülu 3 8B 和 70B(未来还会有 405B 版本),还在技术报告中公布了详细的后训练方法。
图片

Ai2 研究科学家 Nathan Lambert(论文一作)的推文

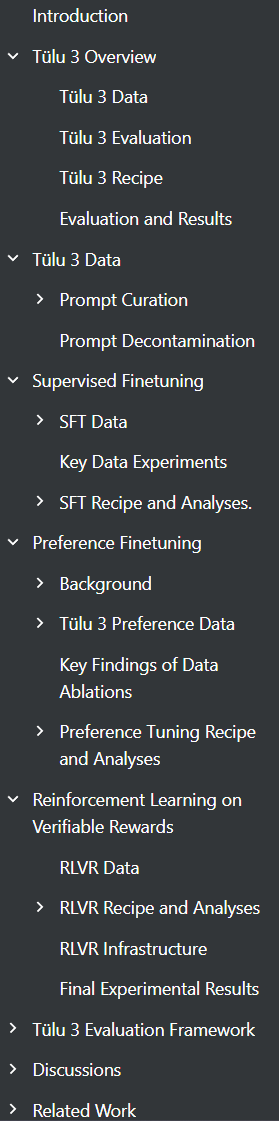
这份 70 多页的技术报告可以说诚意满满,非常值得详细阅读:   
图片

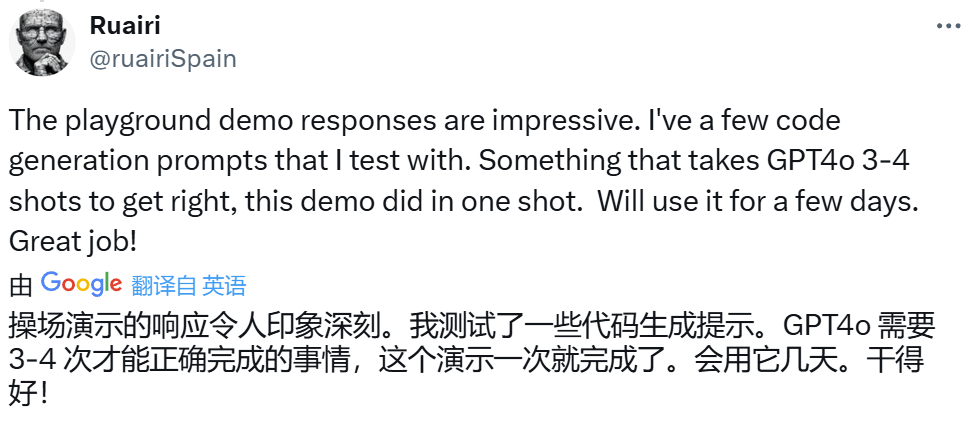
Tülu 3 发布后,社区反响热烈,甚至有用户表示测试后发现其表现比 GPT-4o 还好。
图片

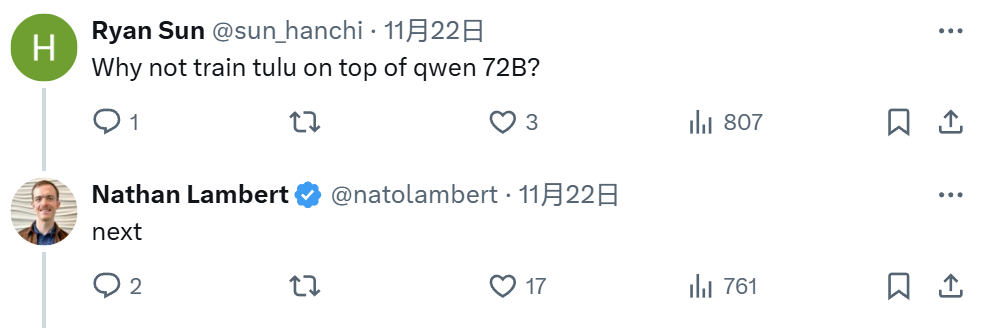
另外,Nathan Lambert 还暗示未来可能基于 Qwen 来训练 Tülu 模型。
图片

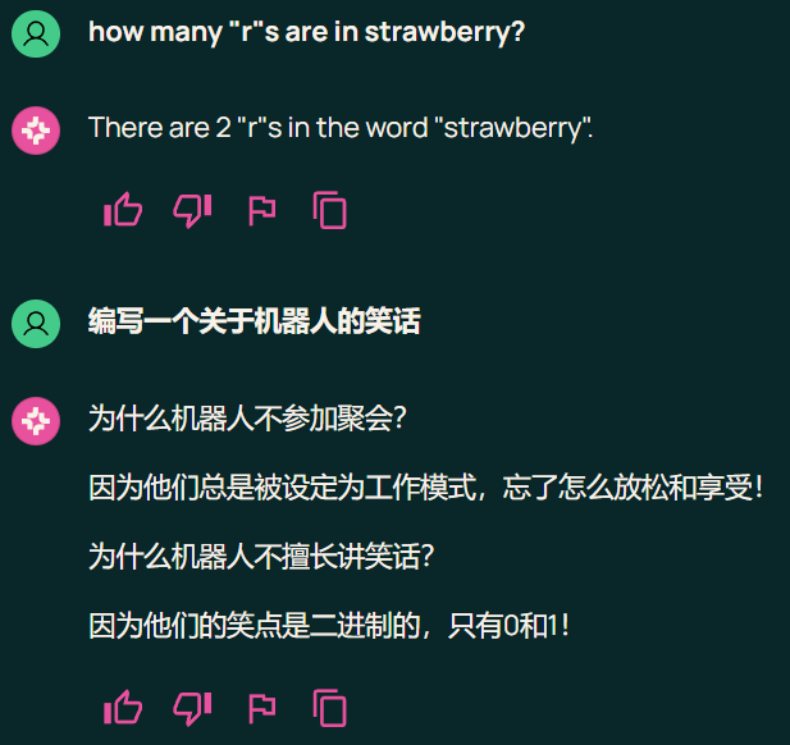
机器之心也简单测试了下 Tülu。首先,数 Strawberry 中 r 数量的问题毫无意外地出错了,至于其编写的笑话嘛,好像也不好笑。
图片

本地部署 AI 模型的工具 Ollama 也第一时间宣布已经支持该模型。

图片

机器之心也简单通过 Ollama 和 Obsidian 的插件简单体验了一下 8B 的本地版本,看起来效果还不错,速度也很快。
图片

不过,比模型性能更值得关注的或许还是 Tülu 3 的后训练方案。在这套方案的启发下,众多研究者有望在大模型的后训练阶段进行更多尝试,延续大模型的 Scaling Law。

首个发布后训练详情的开源模型

在提升模型性能方面,后训练的作用越来越大,具体包括微调和 RLHF 等。此前,OpenAI、 Anthropic、Meta 和谷歌等大公司已经大幅提升了其后训练方法的复杂度,具体包括采用多轮训练范式、使用人类数据 + 合成数据、使用多个训练算法和训练目标。也正因为此,这些模型的通用性能和专业能力都非常强。但遗憾的是,他们都没有透明地公开他们的训练数据和训练配方。

到目前为止,开源后训练一直落后于封闭模型。在 LMSYS 的 ChatBotArena 排行榜上,前 50 名(截至 2024 年 11 月 20 日)中没有任何一个模型发布了其后训练数据。即使是主要的开放权重模型也不会发布任何数据或用于实现这种后训练的配方细节。

于是,Ai2 似乎看不下去了,决定开源一切!

Tülu 3 模型之外,Ai2 还发布了所有的数据、数据混合方法、配方、代码、基础设施和评估框架!
图片

  • 模型:https://huggingface.co/allenai

  • 技术报告:https://allenai.org/papers/tulu-3-report.pdf

  • 数据集:https://huggingface.co/collections/allenai/tulu-3-datasets-673b8df14442393f7213f372

  • GitHub:https://github.com/allenai/open-instruct

  • Demo:https://playground.allenai.org/

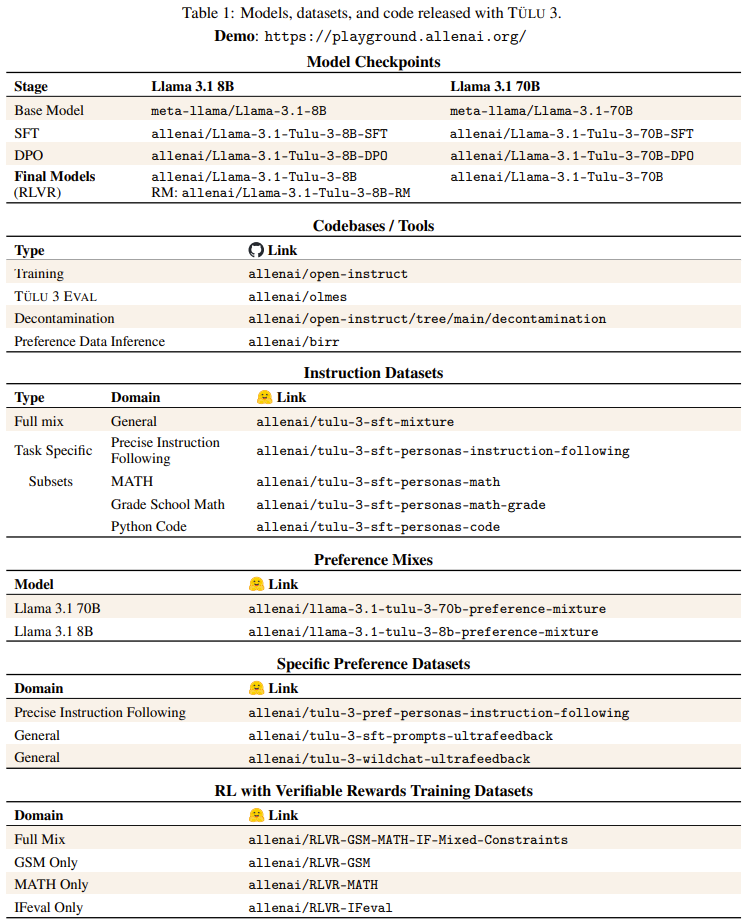
下表展示了 Ai2 开源的模型、数据集和代码:
图片

Ai2 表示,Tülu 3 突破了后训练研究的界限,缩小了开放和封闭微调配方之间的性能差距。

为此,他们创建了新的数据集和新的训练流程。他们还提出了直接使用强化学习在可验证问题上训练的新方法,以及使用模型自己的生成结果创建高性能偏好数据的新方法。

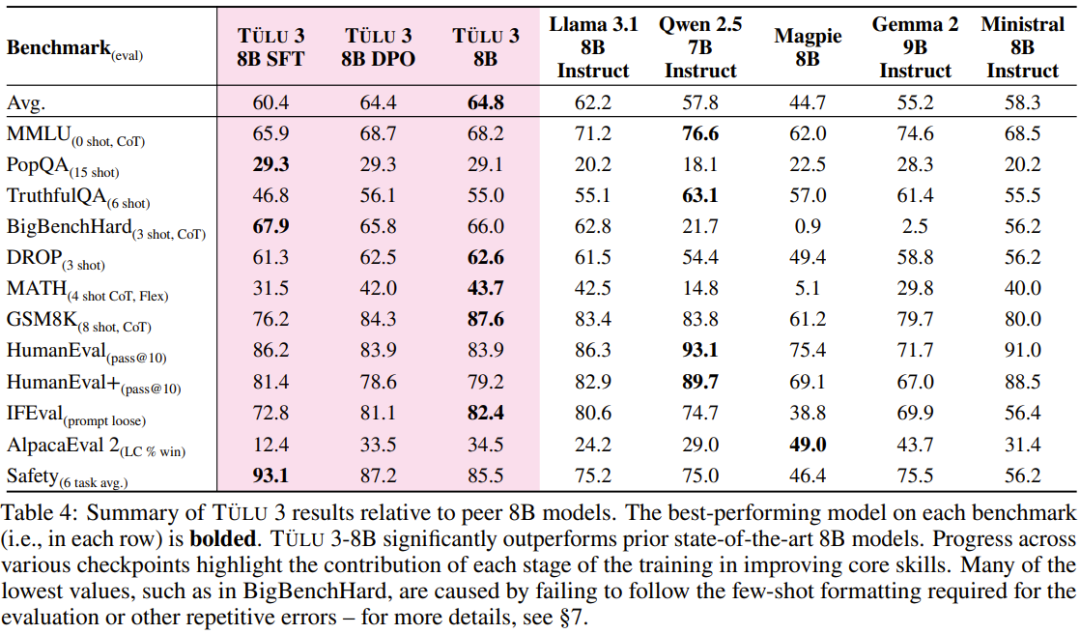
加上更多优化细节,得到的 Tülu 3 系列模型明显优于同等规模的其它模型。
图片

8B 模型在各基准上的表现

图片

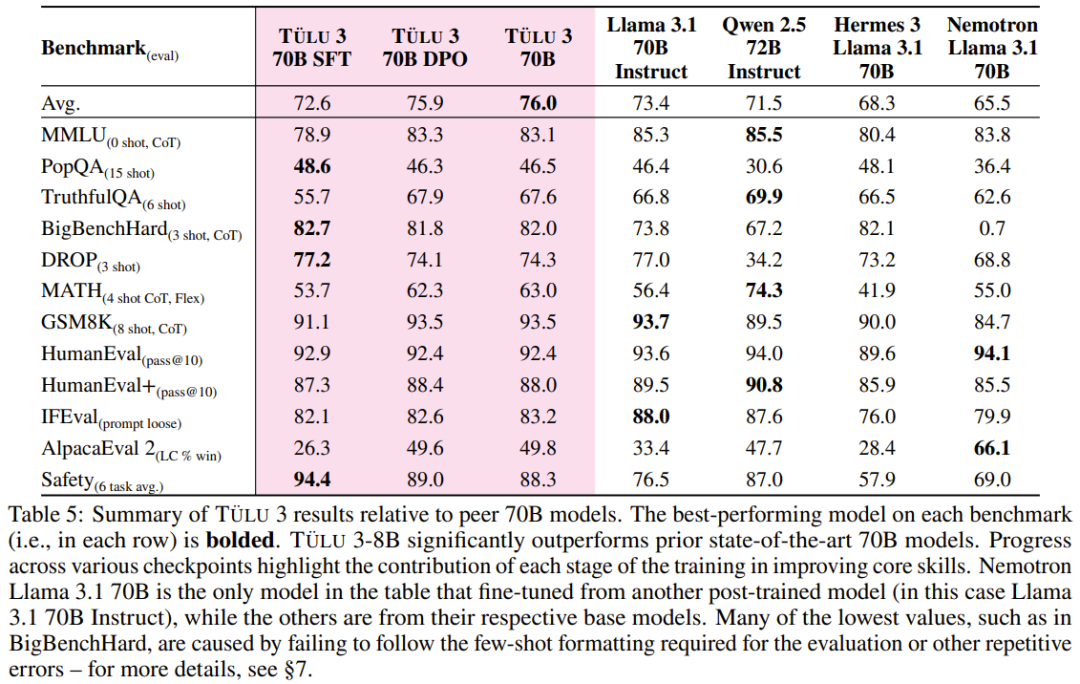
70B 模型在各基准上的表现

Tülu 3 是如何炼成的?  

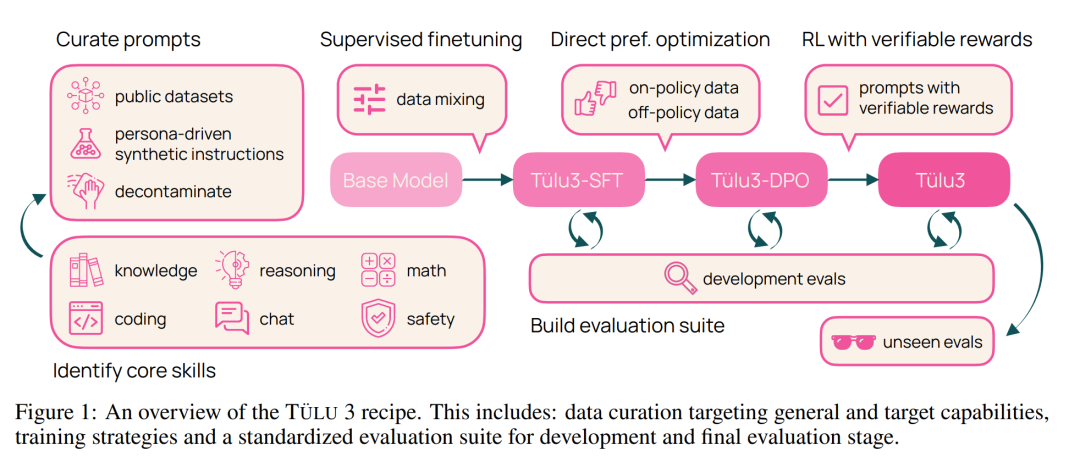
Ai2 在预训练语言模型的基础上,通过四个阶段的后训练方法生成 Tülu 3 模型(见图 1)。这套训练流程结合了强化学习中的新算法改进、尖端基础设施和严格的实验,以便在各个训练阶段整理数据并优化数据组合、方法和参数。
图片

这些阶段如下:

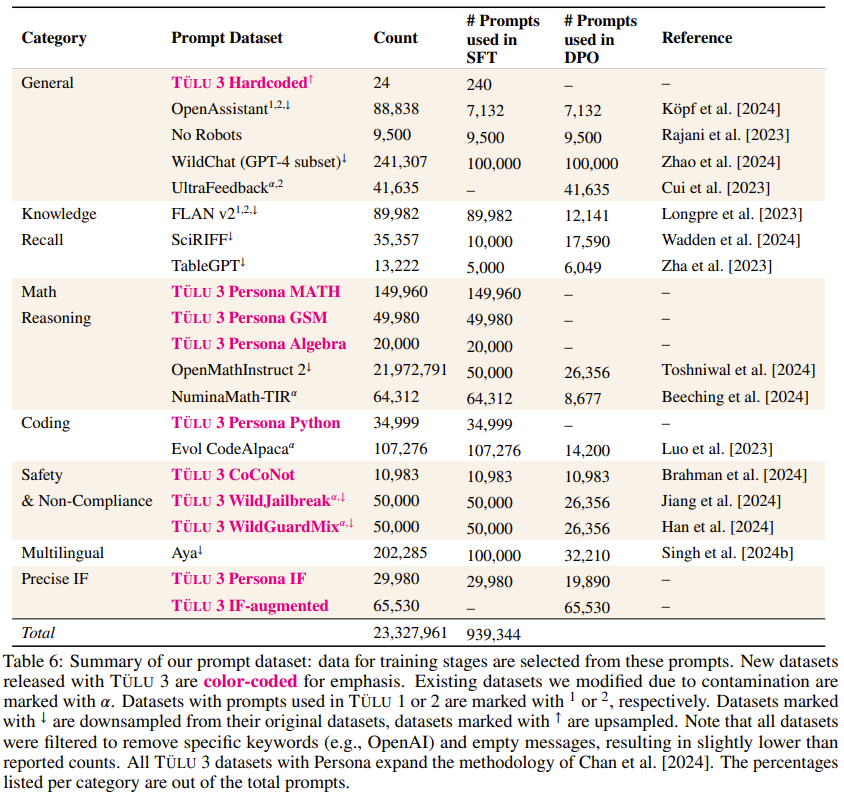
  • 阶段一:数据整理。Ai2 整理了各种提示(prompt)信息,并将其分配到多个优化阶段。他们创建了新的合成提示,或在可用的情况下,从现有数据集中获取提示,以针对特定能力。他们确保了提示不受评估套件 Tülu 3 EVAL 的污染。
图片

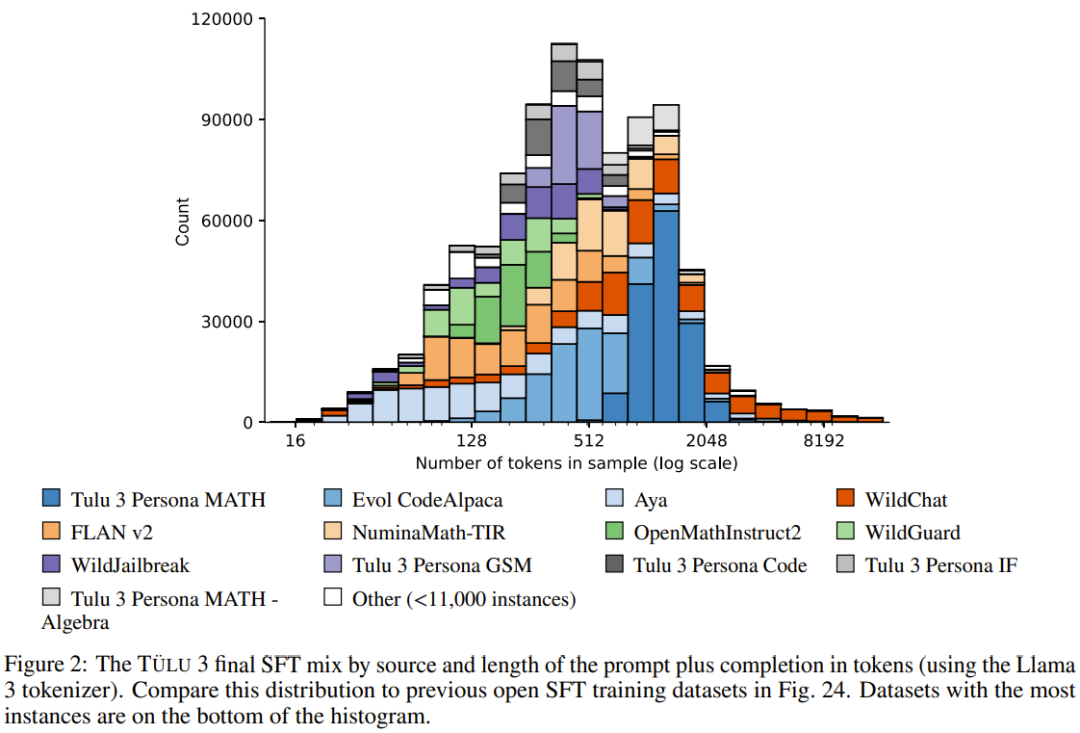
  • 阶段二:监督微调。Ai2 利用精心挑选的提示和回答结果进行监督微调(SFT)。在评估框架指导下,他们通过全面的实验,确定最终的 SFT 数据和训练超参数,以增强目标核心技能,同时不对其他技能的性能产生重大影响。
图片

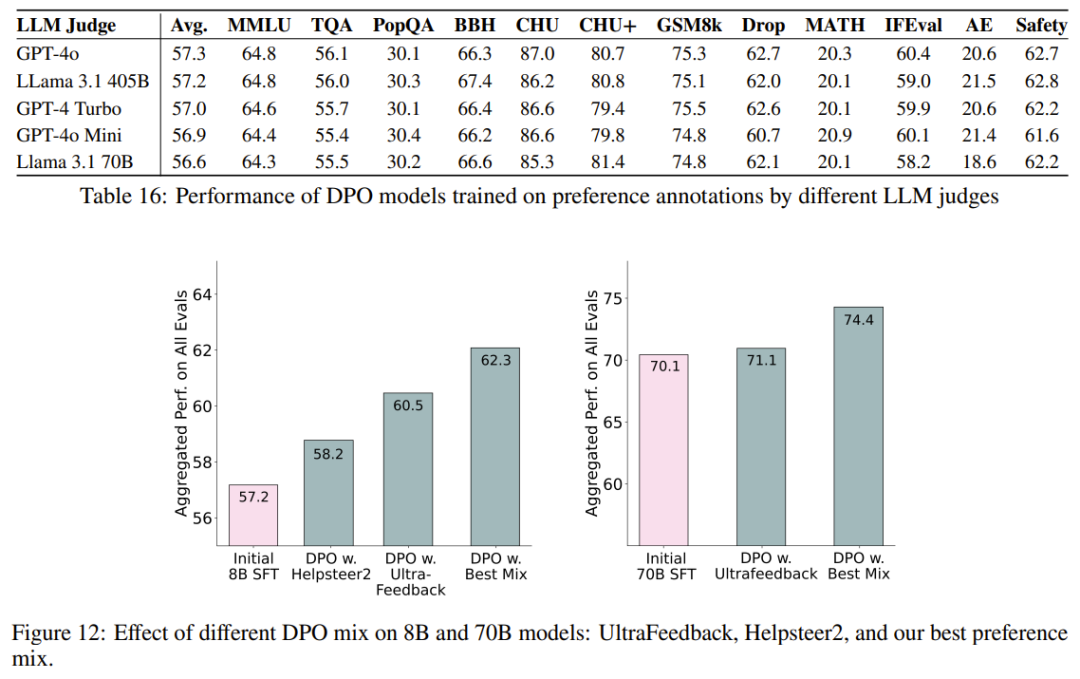
  • 阶段三:偏好微调。Ai2 将偏好微调 —— 特别是 DPO(直接偏好优化)—— 应用于根据选定的提示和 off-policy 数据构建的新 on-policy 合成偏好数据。与 SFT 阶段一样,他们通过全面的实验来确定最佳偏好数据组合,从而发现哪些数据格式、方法或超参数可带来改进。
图片

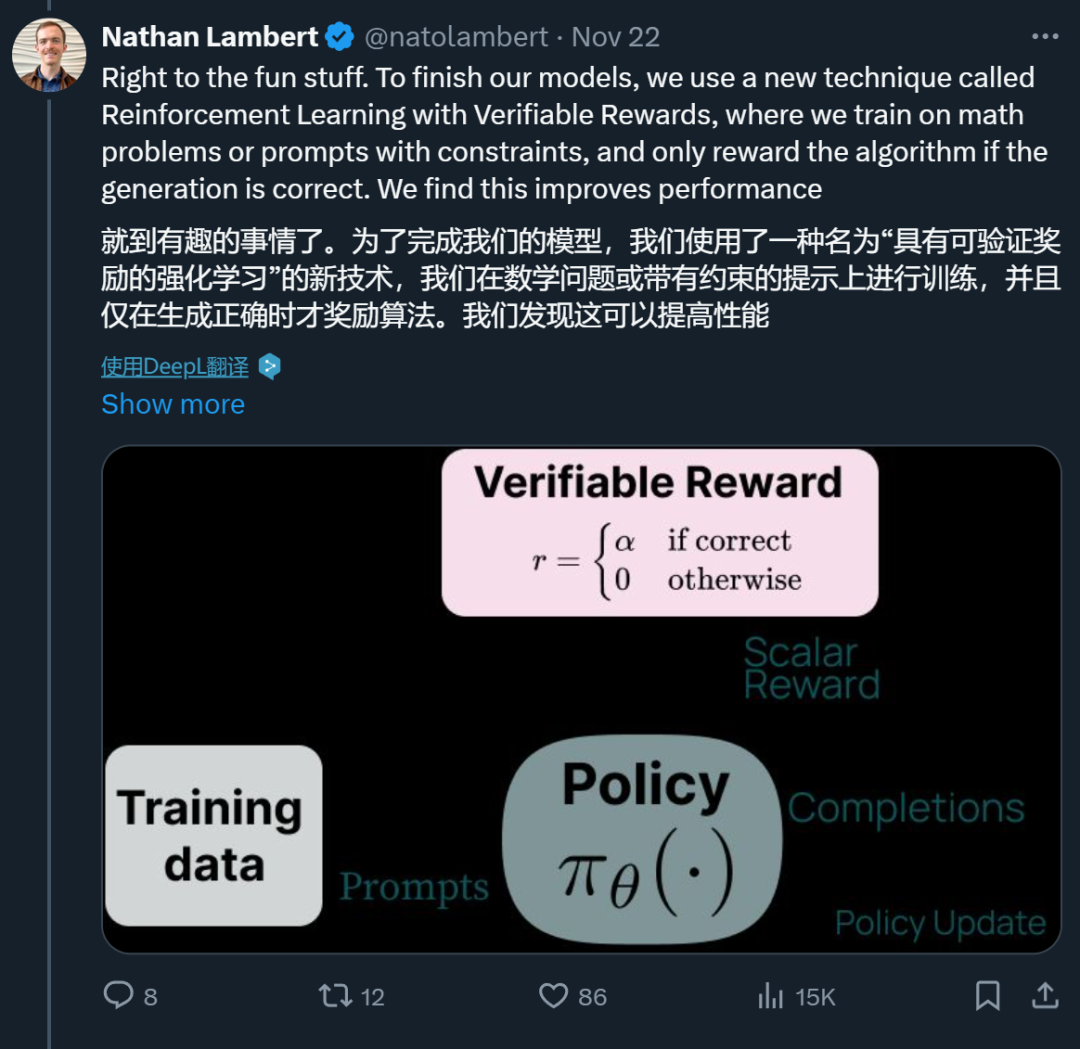
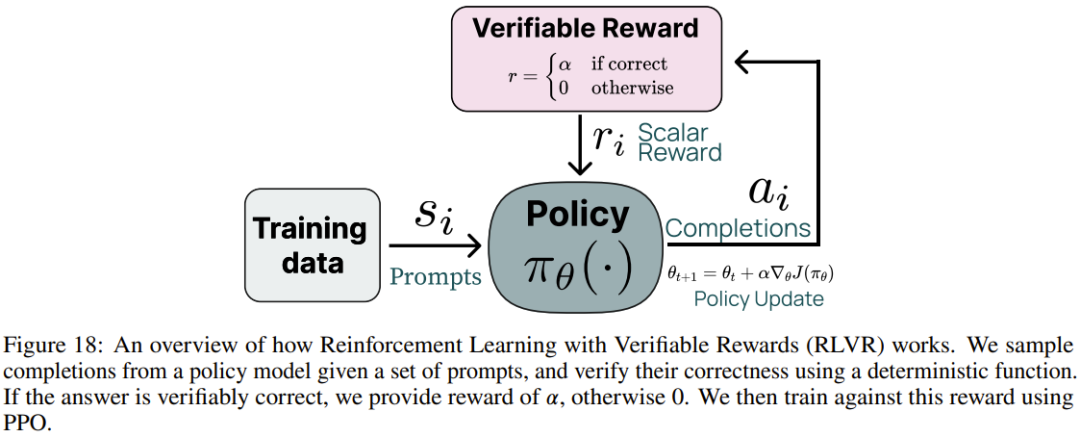
  • 阶段四:具有可验证奖励的强化学习。Ai2 引入了一个新的基于强化学习的后训练阶段,该阶段通过可验证奖励(而不是传统 RLHF PPO 训练中常见的奖励模型)来训练模型。他们选择了结果可验证的任务,例如数学问题,并且只有当模型的生成被验证为正确时才提供奖励。然后,他们基于这些奖励进行强化学习训练。
图片

Tülu 3 pipeline 的主要贡献在于数据、方法、基础设施的改进和严格的评估。其中的关键要素包括: 

  • 数据质量、出处和规模:Ai2 通过仔细调查可用的开源数据集、分析其出处、净化来获取提示,并针对核心技能策划合成提示。为确保有效性,他们进行了全面的实验,研究它们对评估套件的影响。他们发现有针对性的提示对提高核心技能很有影响,而真实世界的查询(如 WildChat)对提高通用聊天能力很重要。利用 Tülu 3 EVAL 净化工具,他们可以确保提示不会污染评估套件。

  • 创建多技能 SFT 数据集。通过利用不同数据混合结果进行几轮有监督微调,Ai2 优化了「通用」和「特定技能」类别中提示的分布。例如,为了提高数学推理能力,Ai2 首先通过创建数学专业模型在评估套件中建立一个上限,然后混合数据,使通用模型更接近这个上限。

  • 编排一个 On-Policy 偏好数据集。Ai2 开发了一个 on-policy 数据编排 pipeline,以扩展偏好数据集生成。具体来说,他们根据给定的提示从 Tülu 3-SFT 和其他模型中生成完成结果,并通过成对比较获得偏好标签。他们的方法扩展并改进了 Cui et al. [2023] 提出的 off-policy 偏好数据生成方法。通过对偏好数据进行精心的多技能选择,他们获得了 354192 个用于偏好调整的实例,展示了一系列任务的显着改进。

  • 偏好调整算法设计。Ai2 对几种偏好调整算法进行了实验,观察到使用长度归一化( length-normalized)直接偏好优化的性能有所提高。他们在实验中优先考虑了简单性和效率,并在整个开发过程和最终模型训练中使用了长度归一化直接偏好优化算法,而不是对基于 PPO 的方法进行成本更高的研究。

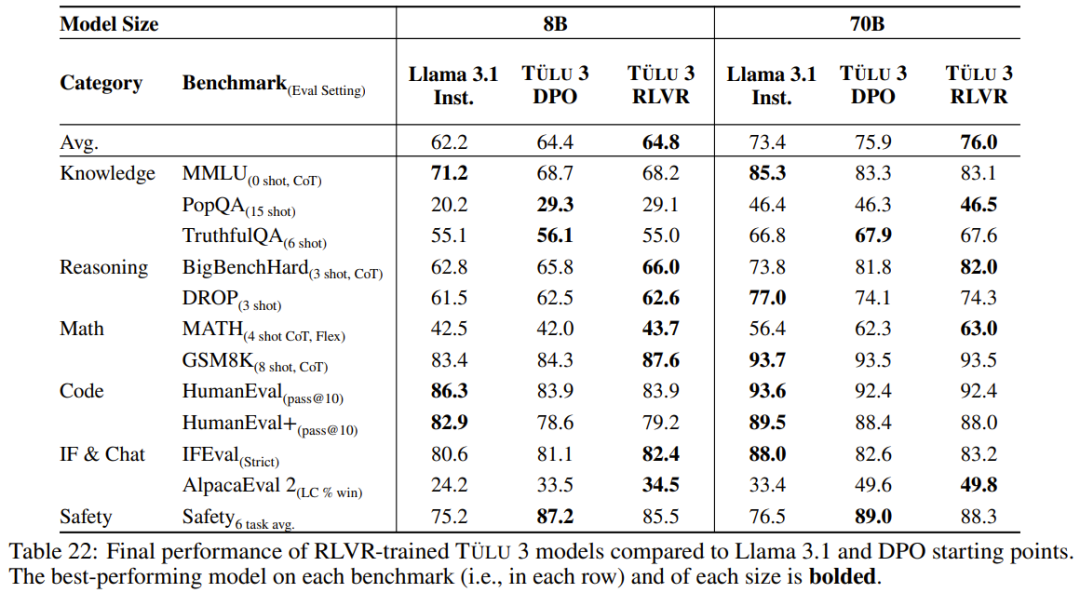
  • 具有可验证奖励的特定技能强化学习。Ai2 采用了一种新方法,利用标准强化学习范式,针对可以对照真实结果(如数学)进行评估的技能进行强化学习。他们将这种算法称为「可验证奖励强化学习」(RLVR)。结果表明,RLVR 可以提高模型在 GSM8K、MATH 和 IFEval 上的性能。
图片

  • 用于强化学习的训练基础设施。Ai2 实现了一种异步式强化学习设置:通过 vLLM 高效地运行 LLM 推理,而学习器还会同时执行梯度更新。并且 Ai2 还表示他们的强化学习代码库的扩展性能非常好,可用于训练 70B RLVR 策略模型。
图片

Tülu 3 的表现如何?

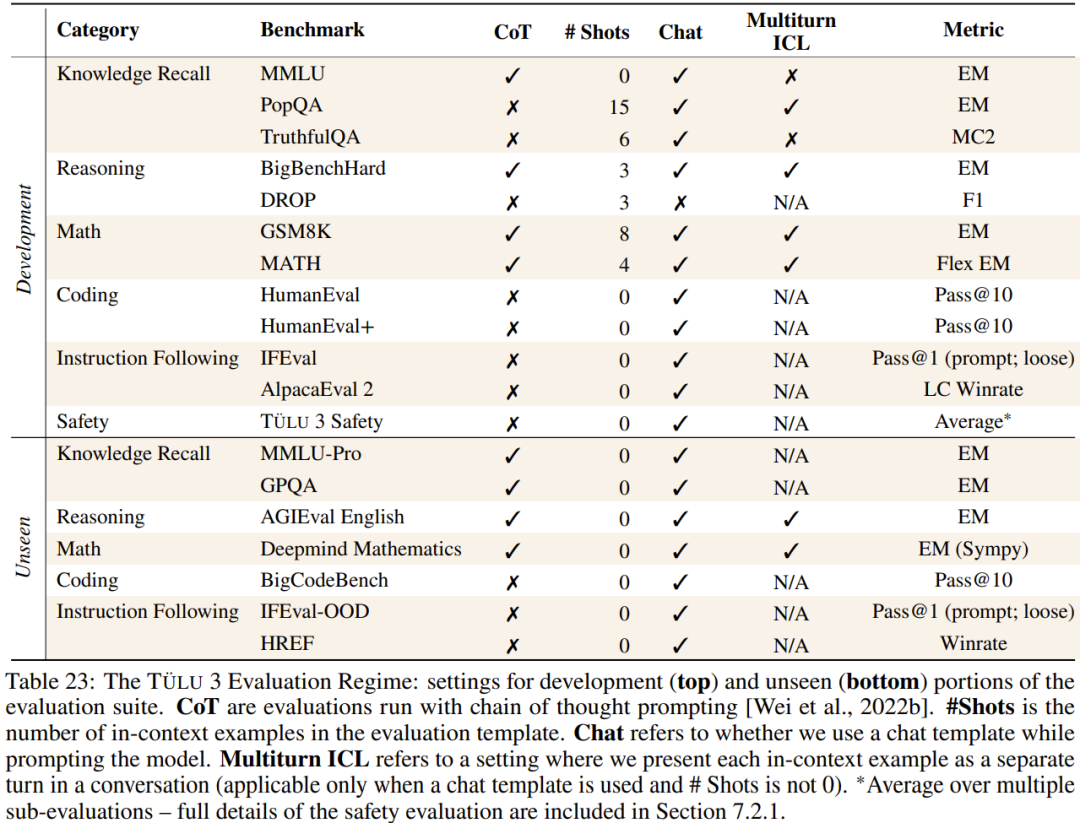
为了评估 Tülu 3 以及其它模型,Ai2 设计了一套评估框架,其中包含一个用于可重复评估的开放评估工具包、一套用于评估指令微调模型的核心技能的套件(具有分立的开发和留存评估),以及一组推荐设置(基于 Ai2 对各种模型的实验)——Ai2 称之为 Tülu 3 Evaluation Regime。

除了评估最终模型,该框架还是一个开放的评估工具套件,旨在通过精心挑选的评估套件和净化工具来引导开发进度。
图片

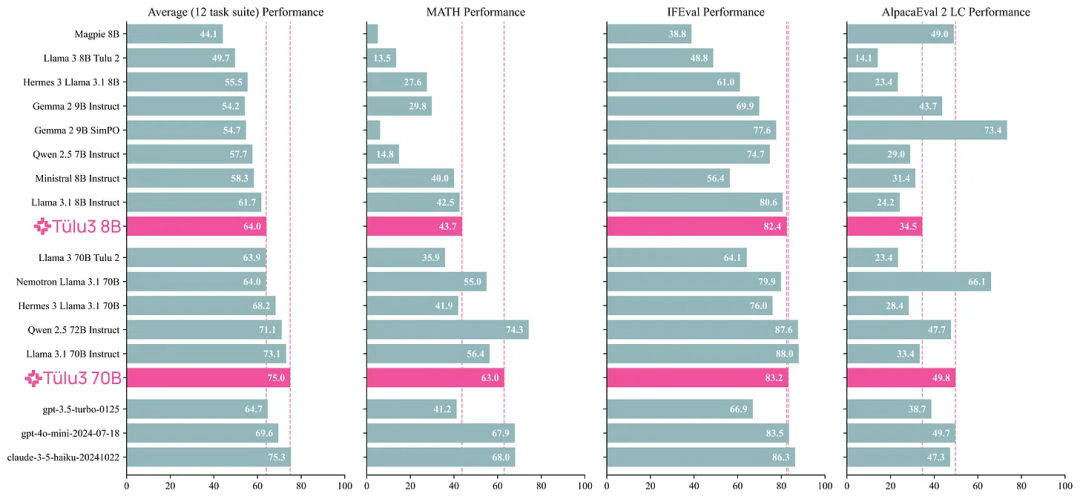
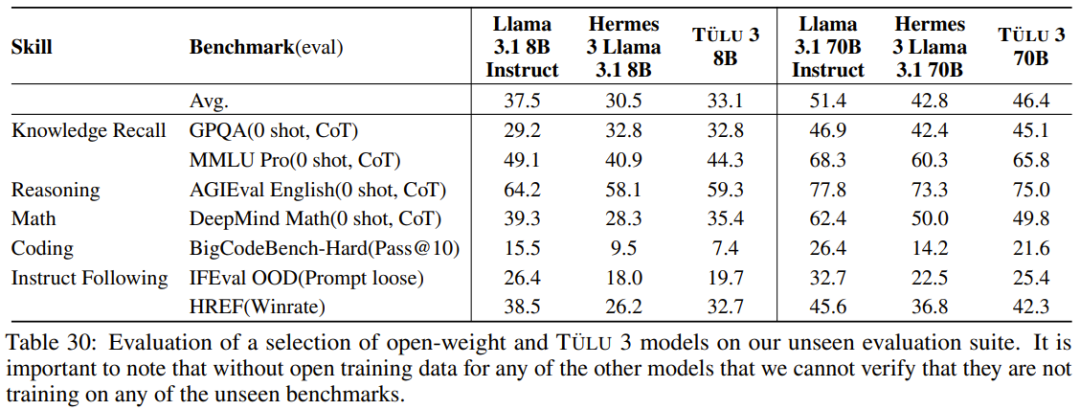
下面展示了一些主要的评估结果。可以看到,同等规模性,在这些基准上,Tülu 3 的表现非常出色,其中 70B 版本的平均性能甚至可与 Claude 3.5 Haiku 比肩。
图片

此外,Ai2 还提出了两个新的评估基准:IFEval-OOD 和 HREF。

IFEval-OOD 的目标是测试 LLM 遵从精确指令的能力,以及它们是否能够遵从超出 IFEval 中包含的 25 个约束的指令约束。IFEval-OOD 包含 6 大类 52 个约束。

HREF 的全称是 Human Reference-guided Evaluation of instruction Following,即人类偏好指导的指令遵从评估,其目标是自动评估语言模型遵从指令的能力。HREF 专注于语言模型通常训练的 11 个指令遵从任务,即头脑风暴、开放式 QA、封闭式 QA、提取、生成、重写、总结、分类、数值推理、多文档合成和事实核查。

下表给出了 Tülu 3 与对比模型在这两个新基准以及其它已有基准上的表现,具体涉及的领域包括知识调用、推理、数学、编程和指令遵从。需要注意,这些都是 Unseen 基准,即这些任务是模型训练过程中未见过的。
图片

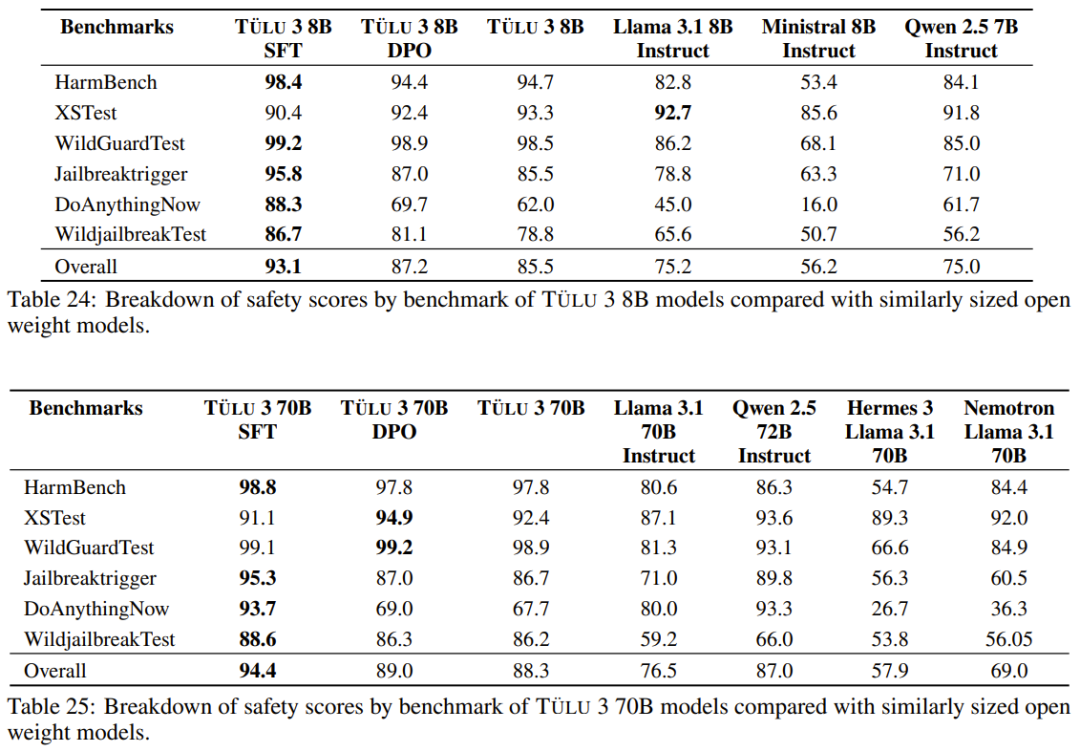
安全性方面,以下两表展示了 Tülu 3 与对比模型在两个基准上的安全分数。整体而言,同等规模下,Tülu 3 相较于其它开源模型更有优势。
图片

最后必须说明,长达 73 页的 Tülu 3 技术报告中还包含大量本文并未提及的细节,感兴趣的读者千万不要错过。

参考链接:

https://allenai.org/blog/tulu-3?includeDrafts

https://x.com/natolambert/status/1859643351441535345

https://www.interconnects.ai/p/tulu-3

GPT-5.5不存在:OpenAI最新模型GPT-4o全解析与避坑指南 大语言模型(LLM)是当前人工智能应用的核心技术,其版本演进遵循严格的工程发布规范。OpenAI官方模型命名体系以GPT-3.5、GPT-4、GPT-4 Turbo、GPT-4o为真实迭代路径,其中GPT-4o作为2024年发布的优化版,具备低延迟、多模态原生支持与免费可用等关键技术价值,已广泛应用于智能客服、代码生成、企业知识库等生产场景。所谓‘GPT-5.5’并非真实模型,而是中文社区因配置占位符误读、评测基准混淆及版本数字崇拜所衍生的技术幻象;其常见于Ollama别名、VS Code插件默认值或API 阅读详情

相关推荐

VS2022离线安装包 - 下载安装教程

VS2022离线安装包 - 下载安装教程

鲤籽鲲的博客 3万+

TÜLU 3:首个发布后训练配方的开源模型,性能超越Llama3.1

TÜLU 3 建立在 Llama 3.1 基础模型之上,其结果超过了 Llama 3.1、Qwen 2.5、Mistral 的 instruct 版本,甚至超过了 GPT-4o-mini 和 Claude 3.5-Haiku 等闭源模型。最近,来自艾伦人工智能研究所和华盛顿大学的研究团队推出了 TÜLU 3,一个完全开放的 SOTA 后训练模型系列,以及它的数据、代码和训练方法,作为现代后训练技术的综合指南。正是在这个阶段,模型从一个"无所不知"却缺乏判断力的网络,转变为具有特定功能导向的实用工具。

u012744245的博客 857

解决ArcGIS-OpenStreetMap Toolbox-Load OSM File错误

在安装成功OpenStreetMap Toolbox后,首次运行Load OSM File工具,出现以下错误

Zjf的博客 8820

Tulu 3:开放后训练的新里程碑 - 从技术突破到标准化实践

Tulu 3的推出不仅是开放后训练技术的一次重要进步,更是对整个AI领域的推动。通过提供全面的指导和工具,Tulu 3为研究人员和开发者提供了强有力的支持,帮助他们在模型性能上取得显著提升。这一新标准的确立,将对未来的语言模型训练和优化产生深远的影响。

XianxinMao的博客 1160

记录:N10激光雷达串口编程,将数据存进 SQLite,并进行 ROS2 - cartographer 单雷达建图

N10 系列采用 TOF(time of flight)测距原理,通过测量调制激光的发射、返回时间差来测量物体与传感器的相对距离。激光发射器发出调制脉冲激光,内部定时器开始 从t1时刻计算时间,当激光照射到目标物体后,部分能量返回,当雷达接收到返回的激光信号时,在t2时刻停止内部定时器计时,光速C,激光雷达到达物体的距离D为:经过N10系列激光雷达内嵌的信号处理单元的实时解算得到探测物体的距离值,结合高精度自适应角度测量模块输出的角度信息,可以得到量程内周围 360 度环境 的二维平面信息。

m0_74013893的博客 1096

手把手搭建摄像头驱动(一):I2C设备树插件与OV5640实战

本文手把手指导如何搭建OV5640摄像头驱动,重点讲解I2C设备树插件的编写与实战应用。通过硬件连接验证、I2C驱动框架搭建、设备树插件编译及动态加载调试,系统介绍Linux驱动开发全流程,并提供常见问题解决方案,帮助开发者快速掌握摄像头驱动开发技术。

git9versioner的博客 755

超强!10大开源大模型!

近期,Meta 重磅发布发布两款开源Llama 3 8B与Llama 3 70B模型,供外部开发者免费使用。

qkh1234567的博客 9111

MT4量化交易入门:手把手教你用MQL4编写第一个外汇EA(含完整代码)

本文详细介绍了如何使用MQL4在MT4平台上编写第一个外汇EA,涵盖从开发环境配置到均线交叉策略实现的完整流程。通过手把手教学和完整代码示例,帮助量化交易新手快速掌握外汇自动化交易的核心技术,实现高效的MT4量化交易系统。

mmm90的博客 527

太强了!10​大开源大模型!

大型语言模型(LLMs)无疑是人工智能革命中的核心驱动力,它们建立在Transformer架构的稳固基石之上,并根据缩放定律不断演进。正是通过预先训练海量的文本数据,LLMs展现出了卓越的对话和任务处理能力,成为了现代人工智能领域的璀璨星辰。尽管如此,如今备受欢迎的巨型模型如ChatGPT和Bard,都建立在专有且闭源的基石之上,这无疑为它们的使用设立了重重障碍,导致技术信息的透明度变得模糊不清。

ytt0523_com的博客 5673

ifix5.8连接ab plc的点-通过rslinx

以ifix连接ab plc的点为例 1.先在rslinx上把plc的点导出为opc server 2.使用opc power tool 作为opc client 去连接 3.保存到项目的PDB文件夹下面,并且以节点名命名。 也可以不以节点名命名,系统自动会生成一个以节点名命名的这种文件,就显得很乱。 同时,项目的PDB目录下面必须还得拷过来一个de...

中国智造2025 4114

VSCode 中搭建 Python 开发环境

**验证安装**:打开终端(CMD/PowerShell/终端),输入 `python --version`(Windows)或 `python3 --version`(macOS/Linux),显示版本号即成功。- **下载地址**:[Python 官网](https://www.python.org/downloads/)(选择对应系统的最新稳定版,推荐 3.8+)- **调试**:通过 `launch.json` 配置,设置断点后按 `F5` 启动,使用 `F10/F11` 控制流程。

寒寒豆豆软件公司的博客 2536

51c大模型~合集110

为了解决这一问题,在稠密化过程中,我们对容易引起退化和梯度集中的具有极端延展率的高斯面片进行了筛选,并对其增殖过程进行了限制,从而在不牺牲性能的情况下有效稳定了训练过程,保障了优化过程的顺利进行。大规模场景的重建往往还意味着显著的训练开销,要重建 1.97 平方千米的区域会产生接近两千万的高斯点,这意味着 4.6G 的存储以及 31.5G 的显存开销,以及超过三小时的训练时长。站在 AI 研究者的角度,得到了《苦涩的教训》,意味着在总结教训的过程中明确了什么是「更好」的。第二类则瞄准了相对复杂的问题。

whaosoft~aiotの开发板商城 2604

2025华为od面试手撕代码【求字符串表达式结果】

2025华为od面试手撕代码【求字符串表达式结果】

MISAYAONE的博客 1353

太强了!10大开源大模型!

近期,Meta 隆重推出了两款开源模型:Llama 3 8B与Llama 3 70B,这两款模型可供外部开发者免费使用。Meta 表示,Llama 3 8B和Llama 3 70B在目前同体量模型中,展现出卓越的性能,堪称业界的佼佼者。从Meta 分享的基准测试结果来看,Llama 3 400B+ 的实力不容小觑,其性能已逼近Claude超大杯以及新版GPT-4 Turbo,虽然还存在一定的差距,但足以证明它在顶尖大模型领域已占有一席之地。

优快云_430422的博客 5503

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

盘点十大开源大模型

大模型时代,开源与闭源模型不断涌现,构成了大模型领域的双重引擎。开源大模型为AI领域注入了新的活力,基于开源大模型的应用如雨后春笋般出现,同时也为研究者和开发者提供了更广阔的创新空间。在此,,让我们共同探寻这些令人振奋的进展。

u014073556的博客 9253

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

大模型论文 | tule开源TÜLU 3,并全面开源最先进llm的post-training框架

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

star_nwe的博客 1654

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

2025年最强开源大模型盘点:超越95%专有模型的7大LLM推荐!

在本文中,我们将基于多个基准测试的综合评分,探索当前最强的7款LLM。这些模型在代码生成、推理、问答以及复杂文本任务上,超越了95%的专有解决方案!

Xianxiancq的博客 7010

TÜLU 3: Pushing Frontiers inOpen Language Model Post-Training

为确保有效性,他们进行了全面的实验,研究它们对评估套件的影响。为了评估 Tülu 3 以及其它模型,Ai2 设计了一套评估框架,其中包含一个用于可重复评估的开放评估工具包、一套用于评估指令微调模型的核心技能的套件(具有分立的开发和留存评估),以及一组推荐设置(基于 Ai2 对各种模型的实验)——Ai2 称之为 Tülu 3 Evaluation Regime。在评估框架指导下,他们通过全面的实验,确定最终的 SFT 数据和训练超参数,以增强目标核心技能,同时不对其他技能的性能产生重大影响。

yaohaishen的专栏 1173

TÜLU 3: Pushing Frontiers in Open Language Model Post-Training翻译

后训练(包括指令微调、从人工反馈中进行强化学习和其他类型的微调等一系列技术)已成为构建前沿语言模型的关键步骤,但这些技术的开发通常没有伴随开放资源和配方。完全开源的对应产品(例如 TÜLU 2 和 Zephyr-𝛽)通常依赖于更易于实现且更便宜的管道,并且在许多指标上已经过时。为了缩小开源和闭源后训练之间的差距,我们推出了TÜLU 3,这是一系列开源的SOTA后训练模型,以及所有数据、训练配方、代码、基础设施和评估框架。

nopSled 460

如何用python统计未截断的tokenization的长度分布:基于tulu3数据集和gemma-2-2b的tokenizer

统计tokenize之后长度超过 1024 的样本数量

阿正的梦工坊 580
上一篇: o1圈杀疯了,阿里又开源Marco-o1
下一篇: 斯坦福大学教授李飞飞团队:关于 2024 年人工智能发展报告总结
AIBigModel
博客等级 码龄2年 5359粉丝 706原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值