scrapy爬虫框架简单实例

Scrapy框架爬虫案例 @toc 1 什么是Scrapy Scrapy是适用于Python的一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试。 2 Scrapy架构 Scrapy Engine(引擎) 负责Spider、ItemPipeline、Downloader、Scheduler中间的通讯,信号、数据传递等。 Scheduler(调度器) 它负责接受引擎发送过来的Request请求,并按照一定的方式进行整理排列,入队,当 阅读详情

声明:初学scrapy,总结学习内容。

目录

一、安装scrapy

二、创建工程

三、编写代码 

3.1 item文件编写

3.1 spider文件编写

3.2 pipeline文件编写

3.3 setting文件修改

四、测试


一、安装scrapy

pip install scrapy 

二、创建工程

scrapy startproject mySpider                 #创建scrapy工程
cd mySpider                                  #进入工程目录
scrapy genspider itcast "www.itcast.cn"      #创建爬虫(spider名不能与project名相同)

三、编写代码 

3.1 item文件编写

items用于存储字段的定义。即爬取的内容存与item类中。

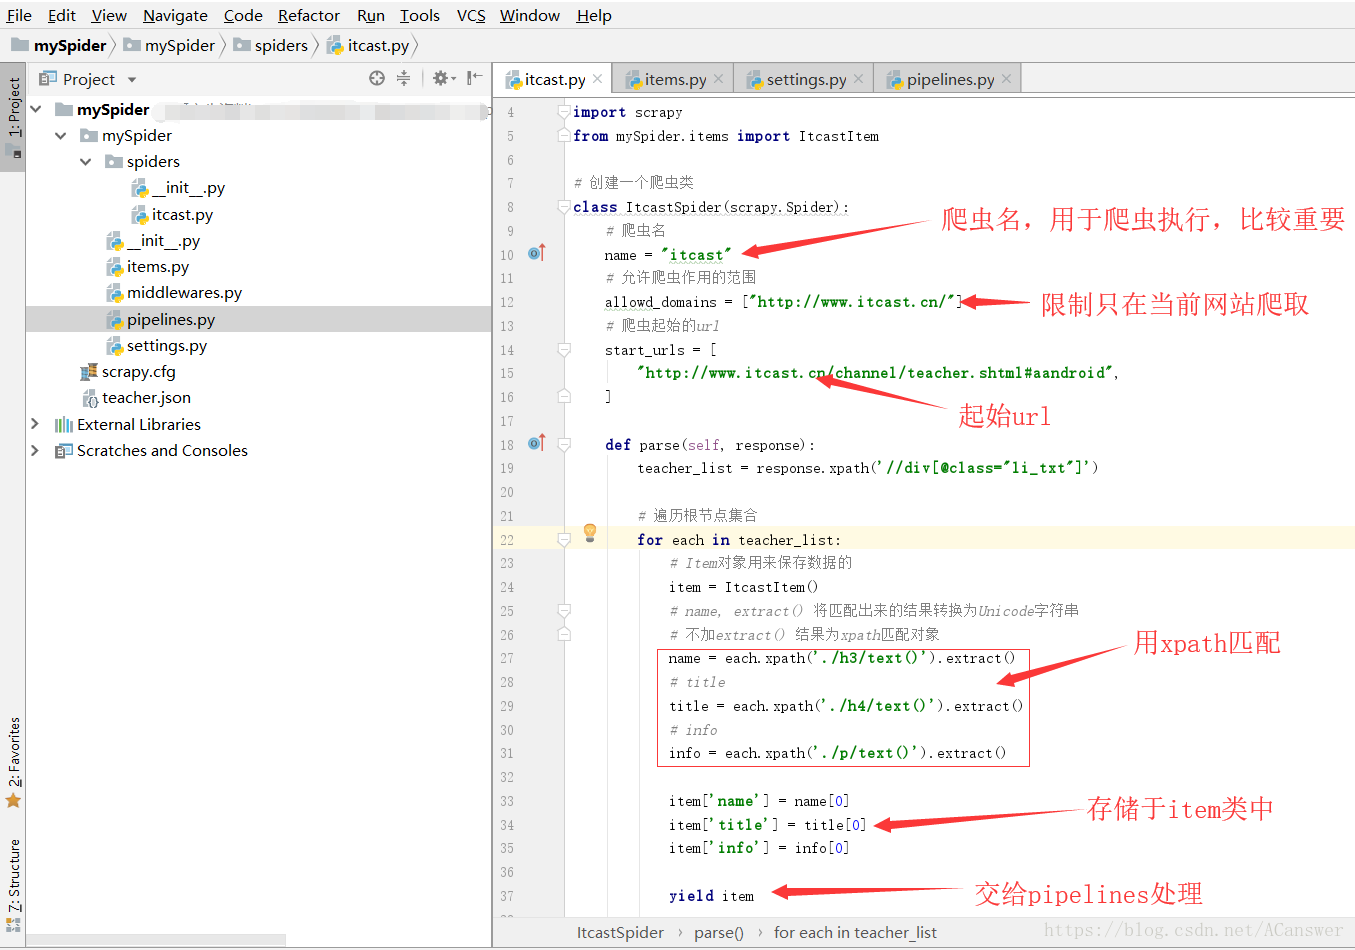
3.1 spider文件编写
3.2 pipeline文件编写

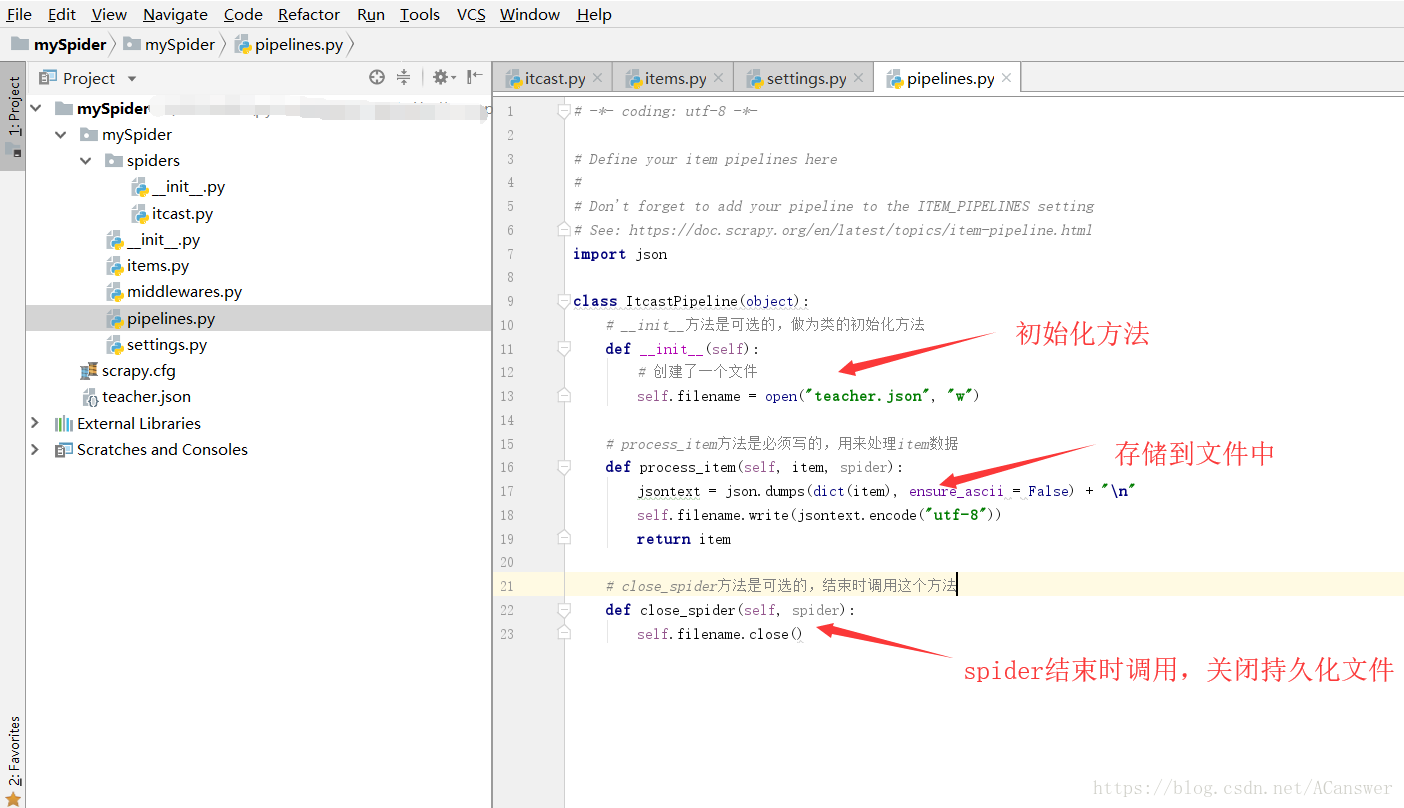
pipeline文件用于存储到文件中。
3.3 setting文件修改

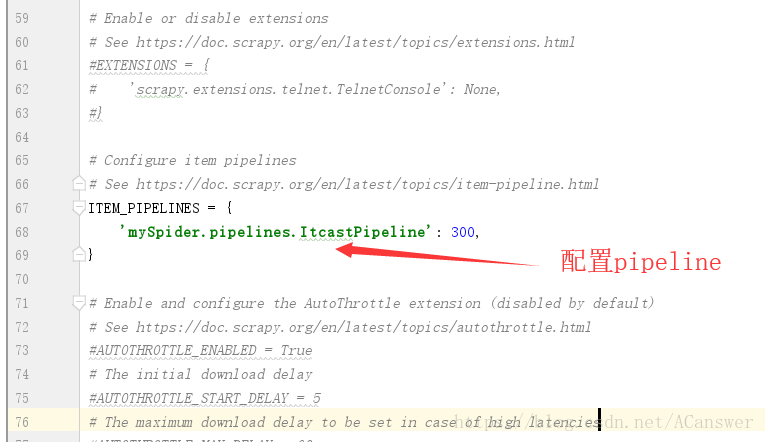
其他配置暂且不用修改,只修改pipeline配置。
四、测试

scrapy crawl itcast                        #运行爬虫

 

python爬虫基础小案例, scrapy框架,思路和经验你全都有。 目录 一、scrapy介绍 二、爬取步骤 三、代码 1、创建爬虫项目 scrapy startproject 项目名字 注意: 项目名字不能出现中文,也不能以数字开头。 2、创建爬虫文件 3.进入itmes.py 4.进入spiders 5.进入pipelines.py 四、运行scrapy 文件 一、scrapy介绍 简单介绍一下scrapy吧。 Scra... 阅读详情

相关推荐

网络爬虫:Scrapy爬虫框架

介绍了Scrapy爬虫框架的原理和基本使用方式

Jingmin Wei's Blog 2996

Scrapy项目实例及详解(1)

基础知识请跳转: Scrapy基础详解 Scrapy持久化存储 = = 本次实例为菜鸟教程中scrapy入门练习实例 抓取传智教育师资简介(http://www.itcast.cn/channel/teacher.shtml#aandroid) 网页没有做反爬措施,就不进行网页分享啦 = = 首先创建项目及spider 创建项目 scrapy startproject itcastPro 创建spider scrapy genspider itcast www.xxx.com 先写items文件 imp

weixin_44457673的博客 1130

【愚公系列】《Python网络爬虫从入门到精通》049-了解Scrapy爬虫框架

大家好,欢迎来到《Python网络爬虫从入门到精通》系列教程的第48篇文章。经过前面几十篇的学习,我们已经掌握了使用 requests、BeautifulSoup、Selenium 等工具进行数据抓取的基本方法。然而,随着项目的复杂度提升,这些工具在面对大型、高并发、高可维护性的爬虫任务时,往往力不从心。这时候,专业的爬虫框架——Scrapy,就该登场了。Scrapy 是一个由 Python 编写的、功能强大的异步爬虫框架,它具备高性能、模块化、易扩展等诸多优点,被广泛应用于各种数据采集任务中。

愚公智库 10万+

scrapy爬虫框架小案例

scrapy爬虫框架小案例

陈二狗的博客 1966

MIKE21桥墩模拟实战:抠网格与构筑物法对比与选型指南

本文详细对比了MIKE21软件中抠网格法与构筑物法在桥墩模拟中的应用,包括操作步骤、适用场景及优缺点分析。通过实际案例数据展示两种方法的精度与效率差异,并提供选型决策树和常见问题解决方案,帮助工程师根据项目需求选择最优模拟方法。

weixin_42656416的博客 322

深入解析SAP MM模块OBYC自动科目分配机制:从T030表到实战配置

本文深入解析SAP MM模块中OBYC自动科目分配机制,阐明其作为连接物流与财务核心桥梁的作用。文章以T030表为核心,详细拆解其字段结构与检索逻辑,并通过采购收货、生产发料等实战场景,手把手演示配置步骤与关键要点,帮助读者掌握从原理到实践的完整知识体系,实现业财无缝对接。

nft7creator的博客 358

Scrapy爬虫框架,入门案例(非常详细)

Scrapy,Python开发的一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试. 其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的, 后台也应用在获取API所返回的数据(例如 Amazon Associates Web Services ) 或者通用的网络爬虫. Scrapy吸引人的地...

ck784101777的博客 21万+

Linux双网卡设置IP属于同一网段的ping方法以及现象记录分析

文章目录前言ping以及MAC地址总结 前言 写在前面:经常遇到客户将板卡上的两个网络设备的IP地址设置为同一网段的情况,比如eth0:192.168.0.232,eth1:192.168.0.30. 我的解释是,不能设置为同一网段,或者使用其中一个时候下线另外一个网卡。但是我不知道这个说法到底是根据什么,查了很多资料也没找到明确的说法,但是下面这个实验能够说明一些现象的原因。 ping以及MAC地址 首先查看网卡的信息 ifconfig 因为两个网卡都在同一个网段,所以如果这个时候直接和我们的主机(I

“逛丢一只鞋”的博客 1万+

基于Scrapy框架实现网络爬虫-Python

网络爬虫原理 互联网上大量的信息以网页形式提供给用户,用户通过浏览器从服务器获得网页数据并经过浏览器解析后,进行网页阅读、内容复制、链接单击等操作。用户与网页服务器的通信是通过HTTP或者HTTPS实现的,网络浏览器是用户向服务器发送请求数据、接收服务器回应数据、解析并呈现服务器回应数据的客户端软件。 用户不通过浏览器而是通过程序自动获取网页内容,有两种办法:一是当服务器提供API方法时,可以调用API获取网页数据;二是当服务器没有提供API方法时,需要使用爬虫程序从服务器获取网页数据并从中过滤提取所需数据

weixin_43845524的博客 6340

从‘裸纤’到成品:手把手拆解光纤阵列(FA)的装配、点胶与端面研磨全流程

本文详细拆解了光纤阵列(FA)从裸纤到成品的全流程,包括装配、点胶与端面研磨等关键工艺。通过实战经验和数据对比,揭示了5G基站、数据中心等场景中FA的精密制造要点与常见故障解决方案,为光通信器件生产提供专业指导。

weixin_42652674的博客 746

从C-EPS到DP-EPS:手把手图解不同EPS类型怎么选,对你的车操控感影响有多大?

方向盘转动时那股细腻的阻尼感,高速过弯时令人安心的沉稳,或是狭窄车位里一根手指就能拨动的轻盈——这些看似微妙的差异,其实都源自转向系统电机那几厘米的安装位置变化。当我们谈论驾驶乐趣时,发动机参数和悬架调校总是占据C位,但真正连接驾驶者与车辆的神经末梢,恰恰是那套默默工作的电动助力转向系统(EPS)。不同EPS类型带来的操控特性差异,可能比马力数字更能定义一辆车的性格。

weixin_30920513的博客 531

Scrapy:Python中强大的网络爬虫框架

Scrapy是一个开源的网络爬虫框架,由Python编写而成。它提供了一套强大的工具和API,用于处理网页的下载、解析、数据提取和存储。Scrapy的设计目标是高效、可扩展和易于使用,使开发者能够快速构建复杂的网络爬虫应用程序。Scrapy是一款功能强大的Python网络爬虫框架,为开发者提供了一种高效、灵活和可扩展的方式来构建网络爬虫应用程序。它具有强大的爬取能力、灵活的数据提取、自动化的流程控制、分布式和去重机制,以及扩展性和插件支持等特性。

爱编程的鱼的博客 2788

基于STM32的智能台灯PWM调光与人体感应融合设计

本文详细介绍了基于STM32单片机的智能台灯设计方案,重点讲解了PWM调光技术与人体感应模块的融合实现。通过STM32的高级定时器产生精准PWM信号控制LED亮度,结合红外传感器实现人来灯亮、人走灯灭的智能体验,同时集成光敏传感实现环境自适应调光,打造高效节能的智能照明解决方案。

threejs5artist的博客 824

初识网络爬虫框架Scrapy

我们仍然是先用cd命令,从前面的项目路径,进入到scrapy项目里的Spider文件夹里,再通过运行scrapy genspider spidername domainname命令来创建一个新的Spider爬虫文件。2、在Spider部分:在爬虫文件里,我们向start_urls数组放入要爬取的url连接,框架就会经过引擎、调度器、下载器等一系列操作,再会返回一个response结果回到Spider的解析函数里,我们只需要对返回结果进行数据解析,解析完成的数据通过实体类传向管道。

weixin_44067776的博客 2231

【3D Slicer】的小白入门使用指南一

3D Slicer 是一个免费的开源软件平台,用于医学、生物医学和其他 3D 图像的可视化、处理、分割、配准和分析。Slicer 的功能包括:读/写。

图挖掘领域,新晋砖家 ☞ 未来可期,欢迎和静静一起学习交流吖 5555

hwasan实例分析踩内存之一:camx进程stack tag-mismatch的三种解决方案

hwasan实例分析踩内存之一:camx进程stack tag-mismatch的三种解决方案。

1291

Scrapy网络爬虫框架学习

Scrapy是一个用Python编写的开源爬虫框架,目标是帮助开发者高效地从网站上提取数据。它和单纯用 requests + BeautifulSoup 不一样,Scrapy提供了一整套完整的“爬虫解决方案”,非常适合做中大型爬虫项目。

YoungLime的博客 2808

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

Scrapy框架(高效的网络爬虫)

介绍scrapy框架的使用,并给出案例

FFNCL的博客 3202

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

网络爬虫框架Scrapy

Scrapy是一个用Python编写的网络爬虫框架,它提供了许多工具和功能,使得开发者可以轻松地构建强大的网络爬虫。

2302_80048824的博客 2466

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

python网络爬虫知识---Scrapy框架

什么是Scrapy?Scrapy是用来干嘛的?怎么使用Scrapy?这篇让我们一起来认识。

x702604121的博客 2456

Python网络爬虫:Scrapy框架的全面解析

Scrapy是一个功能强大且灵活的开源网络爬虫框架,它提供了一种高效的方式来爬取网站并提取所需的数据。本文将深入探讨Scrapy框架的核心概念、使用方法以及高级技巧,帮助你更好地理解和应用Scrapy进行网络爬虫的开发。

4.0啊的博客 2848

网络爬虫开发常用框架Scrapy

开发者可以定义一个 Item 类型,用于存储从网页中抓取到的数据,并规定数据的字段和类型,使得数据抓取和处理更加规范和清晰。利用选择器定位需要的数据,将提取到的数据存储到定义的 Item 中,再通过 Pipeline 处理数据的持久化和其他操作。通过 Scrapy,开发者可以定义需要抓取的数据、提取数据的方式,并能够自定义爬取规则,从而快速、精确地获取所需数据。开发者可以编写自定义的 Spider 类,定义爬取的起始请求、数据提取的规则等,从而实现对特定网站的信息抓取和处理。

m0_70911440的博客 2144

Python开发从入门到精通:网络爬虫高级应用与Scrapy框架

本文介绍了Python网络爬虫的高级应用与Scrapy框架的核心内容。首先概述了网络爬虫的基本概念和工作流程,然后重点讲解了Scrapy框架的安装、项目创建和爬虫编写方法。针对动态网页爬取,介绍了Selenium的使用及其与Scrapy的结合。在反爬虫策略方面,详细说明了代理IP、User-Agent旋转和Cookies池等技术的实现。最后,通过Scrapy-Redis实现了分布式爬虫,并以豆瓣电影Top250为案例进行了实战演示。文章涵盖了网络爬虫开发的核心技术要点,包括框架使用、反反爬措施和分布式处理等

编程世界如山海,探索不止。 2万+

使用Scrapy框架构建高效网络爬虫的完整指南

Scrapy是一个用Python编写的开源网络爬虫框架,用于快速、高效地从网站提取结构化数据。内置支持CSS和XPath选择器,强大的数据提取能力基于Twisted的异步网络处理,高效并发自动处理请求和响应,简化开发流程模块化设计,易于扩展定制内置支持JSON、CSV、XML等多种数据导出格式完善的中间件系统,可灵活处理请求和响应自带项目模板,快速启动开发Scrapy是一个功能强大且灵活的爬虫框架,通过本文的介绍,您应该已经掌握了使用Scrapy构建网络爬虫的完整流程。

MenzilBiz的博客 2036

基于Scrapy框架的网络爬虫开发流程

前节介绍了什么网络爬虫,什么是Scrapy框架并如何安装 本节介绍基于Scrapy框架的网络爬虫开发流程 1. 新建Scrapy爬虫项目 安装好Scrapy框架后,就可以基于Scrapy框架开发爬虫项目了。基于框架开发项目,不需要从零开始编写代码,只需要掌握如何使用框架,如何添加与自己应用相关的代码即可。 进入打算新建爬虫项目的路径中,使用命令: scrapy startproject proj...

qq_41802192的博客 857
上一篇: linux下Redis数据库配置
下一篇: MATLAB设计模糊控制器并用simulink仿真
ACanswer
博客等级 码龄12年 280粉丝 42原创
评论 8
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值