lucene字典Finite State Transducers(FST)

FST(Finite-State Transducer) 原理 参考依据:Weighted Finite-State Transducer Algorithms An Overview 这是一篇由纽约计算机和数学教授,同时也是全球人工智能超级大咖Mehryar Mohri在美国最大电信公司AT & T 工作期间撰写的论文《加权有限状态转换器算法概述》,原文专业术语和数学概念太多,非数学和计算机科学专业的很难读懂,但是身为一个IT民工也不需要我们能完全读... 阅读详情

下面大部分内容转自http://www.cnblogs.com/LBSer/p/4119841.html

使用lucene进行查询不可避免都会使用到其提供的字典功能,即根据给定的term找到该term所对应的倒排文档id列表等信息。实际上lucene索引文件后缀名为tim和tip的文件实现的就是lucene的字典功能。

      怎么实现一个字典呢?我们马上想到排序数组,即term字典是一个已经按字母顺序排序好的数组,数组每一项存放着term和对应的倒排文档id列表。每次载入索引的时候只要将term数组载入内存,通过二分查找即可。这种方法查询时间复杂度为Log(N),N指的是term数目,占用的空间大小是O(N*str(term))。排序数组的缺点是消耗内存,即需要完整存储每一个term,当term数目多达上千万时,占用的内存将不可接受。

常用字典数据结构

很多数据结构均能完成字典功能,总结如下。

数据结构优缺点
排序列表Array/List使用二分法查找,不平衡
HashMap/TreeMap性能高,内存消耗大,几乎是原始数据的三倍
Skip List跳跃表,可快速查找词语,在lucene、redis、Hbase等均有实现。相对于TreeMap等结构,特别适合高并发场景(Skip List介绍)
Trie适合英文词典,如果系统中存在大量字符串且这些字符串基本没有公共前缀,则相应的trie树将非常消耗内存(数据结构之trie树)
Double Array Trie适合做中文词典,内存占用小,很多分词工具均采用此种算法(深入双数组Trie)
Ternary Search Tree三叉树,每一个node有3个节点,兼具省空间和查询快的优点(Ternary Search Tree)
Finite State Transducers (FST)一种有限状态转移机,Lucene 4有开源实现,并大量使用

 FST原理简析

     lucene从4开始大量使用的数据结构是FST(Finite State Transducer)。FST有两个优点:1)空间占用小。通过对词典中单词前缀和后缀的重复利用,压缩了存储空间;2)查询速度快。O(len(str))的查询时间复杂度。

     下面简单描述下FST的构造过程(工具演示:http://examples.mikemccandless.com/fst.py?terms=&cmd=Build+it%21)。我们对“cat”、 “deep”、 “do”、 “dog” 、“dogs”这5个单词进行插入构建FST(注:必须已排序)。

1)插入“cat”

     插入cat,每个字母形成一条边,其中t边指向终点。


2)插入“deep”

    与前一个单词“cat”进行最大前缀匹配,发现没有匹配则直接插入,P边指向终点。

3)插入“do”

    与前一个单词“deep”进行最大前缀匹配,发现是d,则在d边后增加新边o,o边指向终点。

4)插入“dog”

    与前一个单词“do”进行最大前缀匹配,发现是do,则在o边后增加新边g,g边指向终点。

5)插入“dogs”

     与前一个单词“dog”进行最大前缀匹配,发现是dog,则在g后增加新边s,s边指向终点。

     最终我们得到了如上一个有向无环图。利用该结构可以很方便的进行查询,如给定一个term “dog”,我们可以通过上述结构很方便的查询存不存在,甚至我们在构建过程中可以将单词与某一数字、单词进行关联,从而实现key-value的映射。

也就是它这种压缩,就是让每个节点都不会放重复值,节省了大量的空间

假设我们现在要将mop, moth, pop, star, stop and top(term index里的term前缀)映射到序号:0,1,2,3,4,5(term dictionary的block位置)。最简单的做法就是定义个Map<string, integer="">,大家找到自己的位置对应入座就好了,但从内存占用少的角度想想,有没有更优的办法呢?答案就是:FST
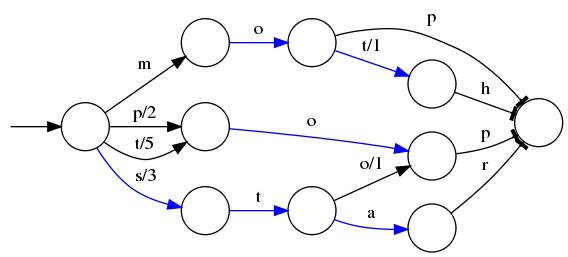
Alt text

⭕️表示一种状态

-->表示状态的变化过程,上面的字母/数字表示状态变化和权重

将单词分成单个字母通过⭕️和-->表示出来,0权重不显示。如果⭕️后面出现分支,就标记权重,最后整条路径上的权重加起来就是这个单词对应的序号。

FST以字节的方式存储所有的term Index,这种压缩方式可以有效的缩减存储空间(优点),使得term index足以放进内存,但这种方式也会导致查找时需要更多的CPU资源(缺点,查找性能一般)。



ElasticSearch搜索引擎入门到精通 ES 是基于 Lucene 的全文检索引擎,它会对数据进行分词后保存索引,擅长管理大量的数据,相对于 MySQL 来说不擅长经常更新数据及关联查询。这篇文章就是为了进一步了解一下它,到底是如何做到这么高效的查询的。在学习其他数据库的时候我们知道是一个数据库系统极其重要的部分,它直接决定着查询的效率。ES之所以快,是因为其底层的Lucene采用倒排索引的方式,并且还有很多的优化点, 阅读详情

相关推荐

Lucene中的FST算法描述

描述了Lucene中如何使用FST算法构建term的内存索引,使用了很多图,直观的展现了FST图的构建流程,能够对想了解lucene内部实现机制原理的同学有帮助。

FST(Finite State Transducers, 有限状态转换器)简介及示例

一、简介 Finite State Transducers 简称 FST, 中文名:有穷状态转换器。FST目前在语音识别和自然语言搜索、处理等方向被广泛应用。 例如,在自然语言处理中,经常会遇到一些针对某些内容法则做出修改的操作,比如:如果c的后面紧接x的话,则把c变为b,FST则是基于这些规则上的数学操作,来把若干个规则整合成一个单程的大型规则,以有效提高基于规则的系统(rule-based s...

vivian_ll的博客 1万+

详解modbus TCP通讯,并利用其实现欧姆龙PLC和西门子PLC的通讯

大家好,之前需要更新的MQTT通讯【2】因为硬件不足还不能发布出来,但最近在项目中涉及到西门子和欧姆龙之间的modbus TCP通讯,想到modbus TCP通讯是个非常常见并广泛使用的通讯协议,今天就结合最近做的测试给大家好好讲解一下,先提示一下,这边只给大家讲解如何实现,至于报文是什么,如何用socket来编写功能块或dll这边不会讲解,这块我会根据私信的小伙伴数量来考虑要不要出一篇如何用ST语言来编写modbus TCP功能块的博客。

dy186187的博客 1万+

lucene随笔-FST(Finite State Transducer)有限状态传感器

lucene版本:6.5.1 有限状态传感器,FST(Finite State Transducer)在lucene中扮演着非常重要的一个角色,在4.0后的版本lucene大量使用了这种数据结构,主要是用于在庞大的字典中快速的定位term的位置。 那么为什么使用FST呢? 考虑到这样一个场景,在lucene中倒排索引是核心,而其带来的问题就是term的字典是非常大,如何在保证term查询效率的...

u011926899的专栏 2486

2.1 量子精密测量:SERF原子陀螺仪中的核自旋-电子自旋强耦合机制

本文深入解析了SERF原子陀螺仪中核自旋-电子自旋强耦合机制的核心原理与应用。通过量子精密测量技术,SERF陀螺仪实现了超高精度的惯性导航,其独特的磁场自补偿和拉莫尔进动特性使其在弱磁场环境下表现出色。文章还探讨了关键技术突破和前沿进展,展示了量子精密测量在惯性导航领域的巨大潜力。

kotlin6android的博客 210

人形机器人骨骼材料选型实战:从铝合金到碳纤维的5种方案对比

本文深入探讨人形机器人骨骼材料的选型策略,对比铝合金、镁合金、钛合金、碳纤维复合材料及3D打印材料等5种方案的性能优劣。通过建立强度-重量比、疲劳寿命等核心评价维度,结合具体应用场景,提供科学的材料决策方法论,助力开发者优化机器人结构设计,实现性能与成本的平衡。

weixin_29199873的博客 437

FST(Finite State Transducer)

有限状态转换器(Finite State Transducer,简称FST)是一种计算模型,它是有限状态自动机(Finite State Automaton,简称FSA)的扩展。FSA是一种理论计算模型,用于表示和处理正则语言,它包含一组状态和在这些状态之间的转换,通常用于模式匹配、文本搜索等任务。与FSA不同的是,FST不仅接受输入字符串,还能产生输出字符串,因此它可以用于建模输入和输出之间的关系,如字符串的转换和映射。

xy2006860的专栏 2840

RH850系列芯片深度剖析 1.5-链接(ld)文件解析

基础编译过程分为四个阶段:预处理(Preprocessing)、编译(Compilation)、汇编(Assembly)、链接(Linking)。执行这四个阶段的程序(预处理器、编译器、汇编器、和链接器)一起构成了编译系统。CONSTANTS接下来的内存空间定义部分会使用这些常量来定义内存空间的范围,理论上来说不定义常量也没有影响,直接用魔鬼数字代替,定义常量的主要目的就是方便理解以及方便修改;从示例中可以看出,常量的值可以为16进制或者10十进制,而且10进制支持数量级单位(k级,M级);

本博客专注于嵌入式软件领域技术分享。 1427

lucene字典Finite State Transducers(FST)和Postings List

下面内容转自http://www.cnblogs.com/LBSer/p/4119841.html 以及https://blog.youkuaiyun.com/AAA821/article/details/82014792 使用lucene进行查询不可避免都会使用到其提供的字典功能,即根据给定的term找到该term所对应的倒排文档id列表等信息。实际上lucene索引文件后缀名为tim和tip的文件实现...

im_cheer的博客 515

STM32实战开发(71):STM32人脸识别开发教程:基于摄像头模块的人脸识别系统

在嵌入式系统中,STM32凭借其强大的计算性能、丰富的外设接口以及低功耗特性,成为了实现人脸识别系统的理想平台。STM32虽然没有强大的计算能力,但可以通过合理利用外部硬件加速模块,如DSP、GPU、FPGA等,结合轻量级的人脸识别算法,实现高效的人脸识别系统。尽管STM32的计算资源相对有限,但通过合理的优化和使用高效的算法,我们依然能够实现高效的人脸识别功能。在本项目中,我们使用。在STM32开发中,虽然处理能力有限,但通过优化算法和合理利用硬件加速,我们仍然可以实现一个轻量级的、实时的人脸识别系统。

2201_76125393的博客 1662

2.0 电子凸轮 西门子1500电子凸轮使用研究1

本文研究了S7-1500T电子凸轮同步控制技术,通过仿真实验得出以下结论:1)通过比例系数可调整凸轮曲线形状;2)解除同步需调用从轴其他运动指令;3)详细阐述了凸轮同步的5个实施步骤。重点分析了三种同步类型(主值距离同步、动态参数同步和直接同步)的特点及应用场景,并探讨了缩放系数、偏移量等参数对凸轮曲线的影响。同时介绍了凸轮应用模式及常见异常处理方法,为工程应用提供了重要参考。

qq_34047402的博客 809

lucene字典实现原理——FST

转自:http://www.cnblogs.com/LBSer/p/4119841.html 1 lucene字典 使用lucene进行查询不可避免都会使用到其提供的字典功能,即根据给定的term找到该term所对应的倒排文档id列表等信息。实际上lucene索引文件后缀名为tim和tip的文件实现的就是lucene的字典功能。 怎么实现一个字典呢?...

djph26741的博客 340

Debezium报错处理系列之二十一:Unable to connect: Communications link failure.The driver has not received any

Debezium报错系列之二十一:Unable to connect: Communications link failure.The driver has not received any。

zhengzaifeidelushang的博客 547

字典数据结构-FST(Finite State Transducers)

http://www.cnblogs.com/LBSer/p/4119841.html 1 lucene字典 &nbsp; &nbsp; &nbsp; 使用lucene进行查询不可避免都会使用到其提供的字典功能,即根据给定的term找到该term所对应的倒排文档id列表等信息。实际上lucene索引文件后缀名为tim和tip的文件实现的就是lucene的字典功能。 &nbsp; &nbsp...

Javap 指令集 8263

22、忆阻器、忆阻系统及其神经形态应用综述

本文综述了忆阻器与忆阻系统的理论基础及其在神经形态系统中的广泛应用。从忆阻器的基本定义出发,介绍了其在非线性电路、存储技术、通信和神经形态计算等领域的应用潜力。重点探讨了基于忆阻器的神经元模型(如Hodgkin-Huxley、FitzHugh-Nagumo和Hindmarsh-Rose模型)、突触实现方式及多种忆阻神经网络架构,包括细胞神经网络、脉冲神经网络和递归神经网络等。此外,深入分析了忆阻器在水库计算中的理论研究与硬件实现进展,展示了其在时间序列处理、模式识别和信号预测等方面的优异性能。尽管忆阻技术前

kiwi8的博客 207

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

5.Lucene 基本原理(六)字典实现原理 FST(Finite State Transducer)

在Lucene基本原理(四)和(五)中,介绍了Lucene索引的构成,Lucene 基本原理(三)索引的构成是基于Lucene2.9.0版本概述索引的组成。倒排索引的核心是“单词字典”和“倒排列表”。从Lucene4.0之后,构成索引的字典的底层数据结构转换为FST(Finite State Transducer)中文,有穷状态转换器。接下来将简单介绍Lucene字典的底层数据结构。 1 lu...

腊八粥 1100

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

Finite State Transducers 详解

一、 简介       Finite State Transducers 简称 FST, 中文名:有穷状态转换器。在自然语言处理等领域有很大应用,其功能类似于字典的功能(STL 中的map,C# 中的Dictionary),但其查找是O(1)的,仅仅等于所查找的key长度。目前Lucene4.0在查找Term时就用到了该算法来确定此Term在字典中的位置。       FST 可以

无敌三脚猫的专栏 1万+

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

java数据结构与算法总结(三十二)--Finite State Transducers

原文链接 一、 简介 Finite State Transducers简称FST, 中文名:有穷状态转换器。在自然语言处理等领域有很大应用,其功能类似于字典的功能(STL中的map,C#中的Dictionary),但其查找是O(1)的,仅仅等于所查找的key长度。目前Lucene4.0在查找Term时就用到了该算法来确定此Term在字典中的位置。 FST可以表示成FST<Key, Value>的形式,我们可以用O(length(key))的复杂度,找到ke...

秋天的猿 600

lucene源代码学习之FST(Finite State Transducer)在SynonymFilter中的实现思想

Finite StateTransducers 简称 FST,中文名:有穷状态转换器。在自然语言处理等领域有很大应用,其功能类似于字典的功能(STL 中的map,C# 中的Dictionary),但其查找是O(1)的,仅仅等于所查找的key长度。目前Lucene4.0在查找Term时就用到了该算法来确定此Term在字典中的位置。       FST 可以表示成FST的形式,我们可以用O(leng

J_bean的博客 3921

Elasticsearch 倒排索引中词条索引原理分析 — 基于 Lucene FST(ES 7 / Lucene 8)

Elasticsearch 倒排索引中词条索引原理分析 — 基于 Lucene FST(ES 7 / Lucene 8)

J_bean的博客 850

百万数据毫秒处理---lucene字典数据结构-FST

FST fast-serialization 是重新实现的 Java 快速对象序列化的开发包。序列化速度更快(2-10倍)、体积更小,而且兼容 JDK 原生的序列化。要求 JDK 1.7 支持。 Maven: 1 <dependency> 2 <groupId>de.ruedigermoeller</groupId> 3 <artifactId>fst</artifactId> 4 <version>1.36&l

u010797364的博客 1017

Finite State Transducers

一, 简介 Finite State Transducers 简称 FST, 中文名:有穷状态转换器。在自然语言处理等领域有很大应用,其功能类似于字典的功能(STL 中的map,C# 中的Dictionary),但其查找是O(1)的,仅仅等于所查找的key长度。目前Lucene4.0在查找Term时就用到了该算法来确定此Term在字典中的位置。 FST 可以表示成FST...

weixin_30896511的博客 124

Elasticsearch倒排索引

倒排索引前言一、倒排索引的内部结构1.Term index2.Term Dictionary字典数据结构3.与mysql对比二、FST(Finite State Transducer)总结 前言 Elasticsearch 使用一种称为 倒排索引 的结构,它适用于快速的全文搜索。一个倒排索引由文档中所有不重复词的列表构成,对于其中每个词,有一个包含它的文档列表。在搜索引擎中,每个文档都有一个对应的文档 ID,文档内容被表示为一系列关键词的集合。例如,文档 1 经过分词,提取了 20 个关键词,每个关键词都

j_ychen的博客 616
上一篇: ElasticSearch的原理
下一篇: Bitmap索引
AAA821
博客等级 码龄14年 19粉丝 58原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值