NLTK学习之四:文本信息抽取

自然语言处理(NLP)之四:信息抽取 0. 信息抽取 信息抽取(information extraction, IE)是将非结构化或半结构化描述的自然语言文本转化成结构化特征的一种基础自然语言处理(NLP)任务,它包括三类子任务: 抽取文本中指定类型的实体(实体抽取/命名实体识别,NER); 抽取实体之间的语义关系(关系抽取,RE); 文本中的事件(event)。 1. 实体抽取(命名实体识别,NER) 实体抽取(Entity Extraction)又名命名实体识别(Named Entity Recognition, NER)或专名识别,是 阅读详情

1 信息抽取

从数据库中抽取信息是容易的,但对于从自然文本中抽取信息则不那么直观。通常信息抽取的流程如下图:
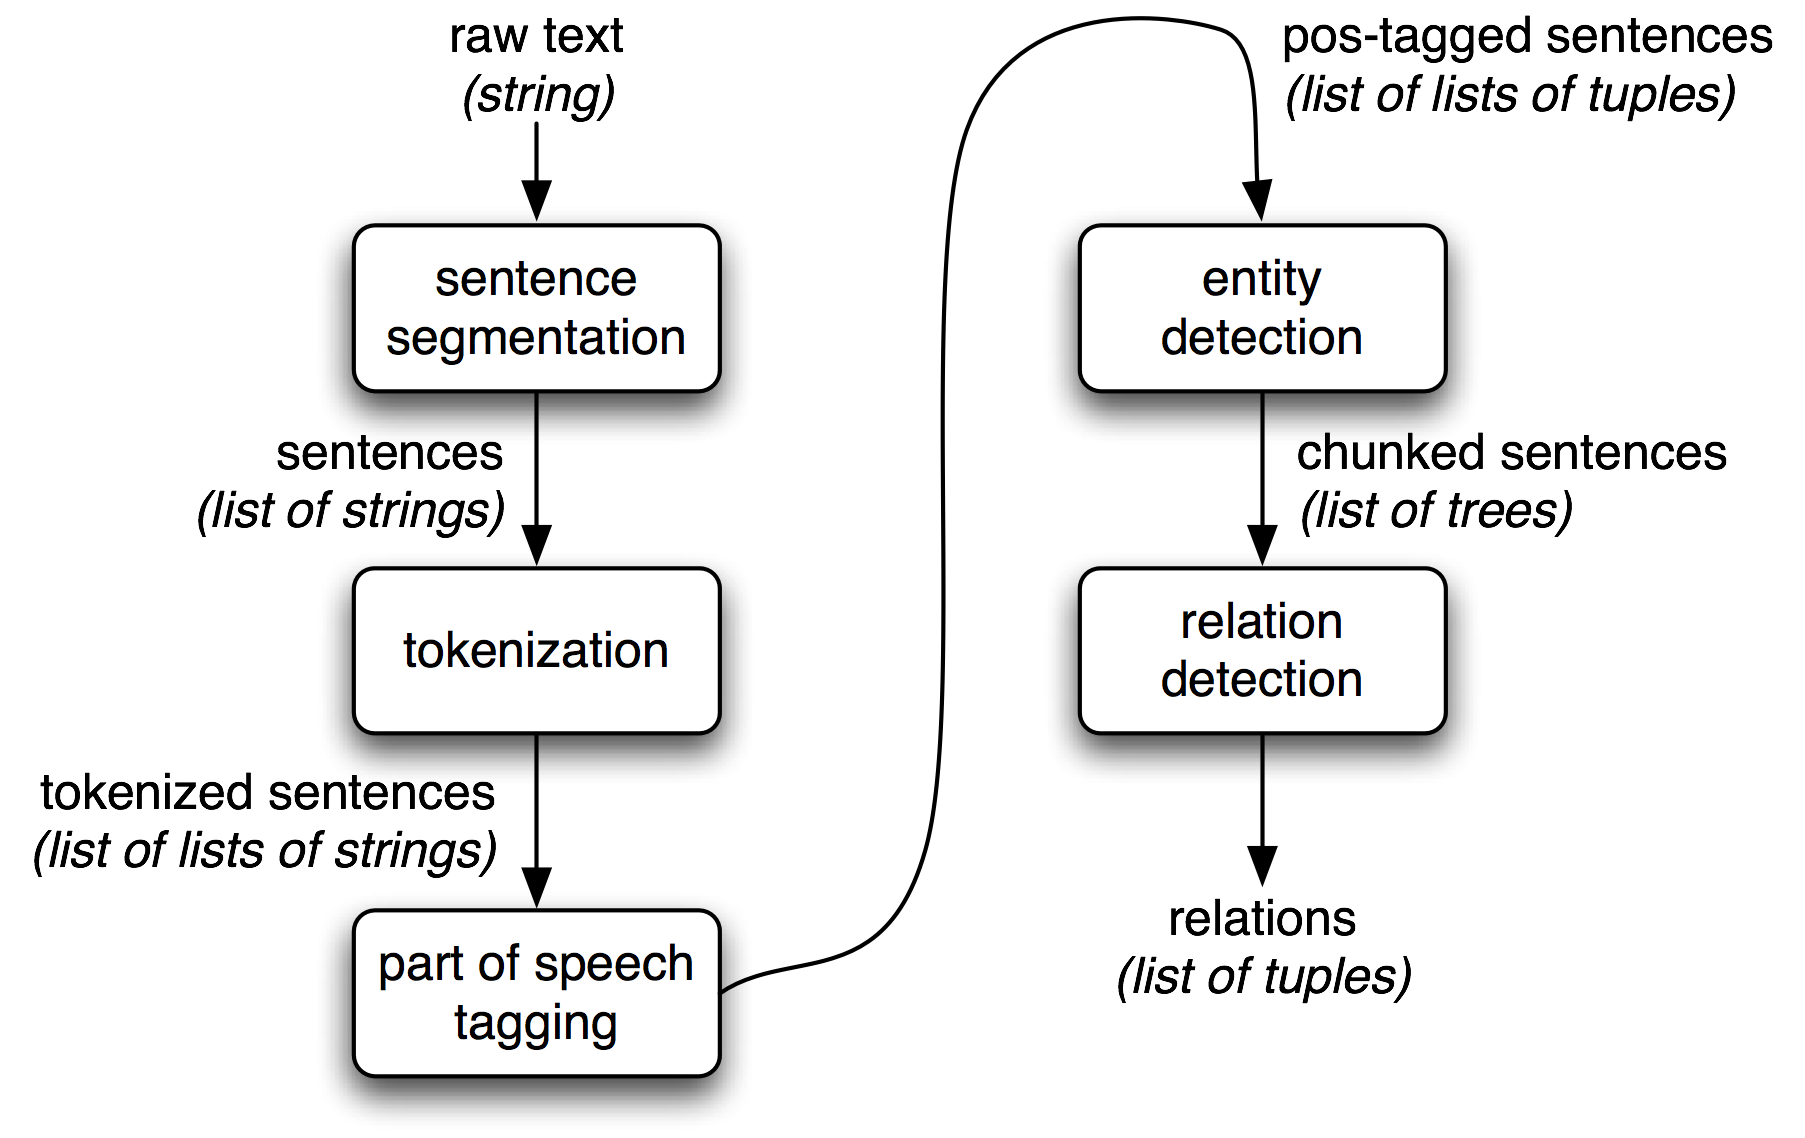
信息抽取流程
它开始于分句,分词。接下来进行词性标注,识别其中的命名实体,最后使用关系识别搜索相近实体间的可能的关系。

2 分块

分块是实体识别(NER)使用的基本技术,词性标注是分块所需的最主要信息。本节以名词短语(NP)为例,展示如何分块。类似的还可以对动词短语,介词短语等进行分块。下图展示了NP分块的概念。
分块示意图
分块可以简单的基于经验,使用正则表达式来匹配,也可以使用基于统计的分类算法来实现。主节先介绍NLTK提供的正则分块器。

2.1 基于正则的匹配

NLTK提供了一个基于词性的正则解析器RegexpParser,可以通过正则表达式匹配特定标记的词块。每条正则表达式由一系列词性标签组成,标签以尖括号为单位用来匹配一个词性对应的词。例如<NN>用于匹配句子中出现的名词,由于名词还有细分的如NNP,NNS等,可以用<NN.*>来表示所有名词的匹配。下面的代码演示了匹配上图中冠词-形容词-名词构成的短语块。

import nltk

sent = sentence = [("the", "DT"), ("little", "JJ"), ("yellow", "JJ"),("dog", "NN"), ("barked", "VBD"), ("at", "IN"),  ("the", "DT"), ("cat", "NN")]

grammer = 'NP:{<DT>*<JJ>*<NN>+}'
cp = nltk.RegexpParser(grammer)
tree = cp.parse(sent)

print tree
tree.draw()

词性标注树

2.2 处理递归

为了支持语言结构的递归,匹配规则是支持引用自身的,如下面的代码,先定义了NP的规则,而在VP和CLAUSE的定义中,互相进行了引用。

import nltk

grammar = r"""
NP: {<DT|JJ|NN.*>+} 
PP: {<IN><NP>} 
VP: {<VB.*><NP|PP|CLAUSE>+$}
CLAUSE: {<NP><VP>}
"""
cp = nltk.RegexpParser(grammar,loop=2)
sentence = [("Mary", "NN"), ("saw", "VBD"), ("the", "DT"), ("cat", "NN"),("sit", "VB"), ("on", "IN"), ("the", "DT"), ("mat", "NN")]

cp.parse(sentence)

3 基于分类的分块器

本节将使用nltk.corpus的conll2000语料来训练一个分块器。conll语料使用IOB格式对分块进行了标注,IOB是Inside,Outside,Begin的缩写,用来描述一个词与块的关系,下图是一个示例。
IOB分块边界

语料库中有两个文件:train.txt,test.txt。另外语料库提供了NP,VP和PP的块标注类型。下表对此语料类的方法进行解释:

方法作用
tagged_sents(fileid)返回词性标注的句子列表,列表元素(word,pos_tag)
chunked_sents(fileid,chunk_types)返回IOB标记的语树tree,树的节点元素(word,pos_tag,iob_tag)

下表对nltk.chunk包提供工具方法进行介绍:

方法作用
tree2conlltags(tree)将conll IOB树转化为三元列表
conlltags2tree(sents)上面方法的逆,将三元组列表转为树

下面的代码使用最大熵分类器训练一个iob标记分类器,然后利用标记进行分块。分类器的训练数据格式为((word,pos_tag),iob_tag),经过学习,分类器就可以对新见到的(word,pos_tag)对进行iob分类,从而打上合适的标签。

import nltk
from nltk.corpus import conll2000

# define feature base on pos and prevpos 
def npchunk_features(sentence, i, history):
    word, pos = sentence[i]
    if i == 0:
        prevword, prevpos = "<START>", "<START>"
    else:
        prevword, prevpos = sentence[i-1]
    return {"pos": pos, "prevpos": prevpos}

# A tagger based on classifier uses pos info
class ContextNPChunkTagger(nltk.TaggerI):
    def __init__(self, train_sents):
        train_set = []
        for tagged_sent in train_sents:
            untagged_sent = nltk.tag.untag(tagged_sent)
            history = []
            for i, (word, tag) in enumerate(tagged_sent):
                featureset = npchunk_features(untagged_sent, i, history)
                train_set.append((featureset, tag))
                history.append(tag)
        self.classifier = nltk.MaxentClassifier.train(train_set)

    def tag(self, sentence):
        history = []
        for i, word in enumerate(sentence):
            featureset = npchunk_features(sentence, i, history)
            tag = self.classifier.classify(featureset)
            history.append(tag)
        return zip(sentence, history)

#wrap tagger to tag sentence
class ContextNPChunker(nltk.ChunkParserI):
    def __init__(self, train_sents):
        tagged_sents = [[((w, t), c) for (w, t, c) in nltk.chunk.tree2conlltags(sent)]
                        for sent in train_sents]
        self.tagger = ContextNPChunkTagger(tagged_sents)

    def parse(self, sentence):
        tagged_sents = self.tagger.tag(sentence)
        conlltags = [(w, t, c) for ((w, t), c) in tagged_sents]
        return nltk.chunk.conlltags2tree(conlltags)

test_sents = conll2000.chunked_sents('test.txt', chunk_types=['NP'])
train_sents = conll2000.chunked_sents('train.txt', chunk_types=['NP'])

chunker = ContextNPChunker(train_sents)
print(chunker.evaluate(test_sents))

''' output
ChunkParse score:
    IOB Accuracy:  93.6%%
    Precision:     82.0%%
    Recall:        87.2%%
    F-Measure:     84.6%%
'''

4 命名实体识别

命名实体识别系统的目标是识别文字提及的命名实体。可以分解成两个子任务:确定NE的边界和确定其类型。
命名实体识别也是适合基于分类器类型的方法来处理。通常标注语料库会标注下列的命名实体:['LOCATION', 'ORGANIZATION', 'PERSON', 'DURATION','DATE', 'CARDINAL', 'PERCENT', 'MONEY', 'MEASURE', 'FACILITY', 'GPE']
NLTK提供了一个训练好的NER分类器,nltk.chunk.named_entify.py源码展示了基于ace_data训练一个命名实体识注器的方法。浏览源码 :-)
下面代码使用nltk.chunk.ne_chunk()进行NE的识别。

import nltk

tagged = nltk.corpus.brown.tagged_sents()[0]
entity = nltk.chunk.ne_chunk(tagged)
print entity

5 关系抽取

一旦文本中的命名实体被识别,就可以提取其间的关系,通常是寻找所有 (e1,relation,e2) 形式的三元组。

在nltk.sem.extract.py中实现对语料库ieer,ace,conll2002文本的关系提取。所以下面的代码可以使用正则表达式r'.*\bpresident\b'来提取某组织主席(PER president ORG)的信息。

import re
import nltk
def open_ie():
    PR = re.compile(r'.*\president\b')
    for doc in nltk.corpus.ieer.parsed_docs():
        for rel in nltk.sem.extract_rels('PER', 'ORG', doc, corpus='ieer', pattern=PR):
            return nltk.sem.rtuple(rel)

print open_ie()
'''output
[PER: u'Kiriyenko'] u'became president of the' [ORG: u'NORSI']
[PER: u'Bill Gross'] u', president of' [ORG: u'Idealab']
[PER: u'Abe Kleinfield'] u', a vice president at' [ORG: u'Open Text']
[PER: u'Kaufman'] u', president of the privately held' [ORG: u'TV Books LLC']
[PER: u'Lindsay Doran'] u', president of' [ORG: u'United Artists']
[PER: u'Laura Ziskin'] u', president of' [ORG: u'Fox 2000']
[PER: u'Tom Rothman'] u', president of production at' [ORG: u'20th Century Fox']
[PER: u'John Wren'] u', the president and chief executive at' [ORG: u'Omnicom']
[PER: u'Ken Kaess'] u', president of the' [ORG: u'DDB Needham']
[PER: u'Jack Ablin'] u', president of' [ORG: u'Barnett Capital Advisors Inc.']
[PER: u'Lloyd Kiva New'] u', president emeritus of the' [ORG: u'Institute of American Indian Art']
[PER: u'J. Jackson Walter'] u', who served as president of the' [ORG: u'National Trust for Historic Preservation']
[PER: u'Bill Gamba'] u', senior vice president and manager of bond trading at' [ORG: u'Cowen &AMP; Co.']
'''
信息抽取 信息抽取 一,信息抽取概述 信息抽取定义:从自然语言文本中抽取指定类型的实体、关系、事件等事实信息,并形成结构化数据输出的文本处理技术。 信息抽取的主要任务有: 实体识别与抽取 实体消歧 关系抽取 事件抽取 二,实体识别与抽取 1,实体识别 任务:识别出待处理文本中七类(人名、机构名、地名、时间、日期、货币和百分比)命名实体。 两个子任务:实体边界识别和确定实体类型。 特点: 人名、地名、机... 阅读详情

相关推荐

QClaw:基于混合智能的文本信息抽取实战指南

信息抽取是自然语言处理(NLP)的核心任务之一,旨在从非结构化文本中自动识别并结构化关键信息,如实体、关系和事件。其技术原理通常结合了基于规则的精准匹配与基于深度学习的泛化理解,通过混合智能系统实现高准确率与强适应性的平衡。这种技术对于构建知识图谱、驱动智能决策具有重要价值,广泛应用于金融风控、舆情分析、智能客服和文档自动化等场景。本文聚焦的QClaw项目,正是这样一个融合了声明式查询语言与端到端管道的文本挖掘工具,它通过规则与模型的协同,有效解决了传统NLP工具在业务语义鸿沟和领域适配高成本方面的痛点,为

weixin_29061531的博客 300

【数据挖掘】从“文本”到“知识”:信息抽取(Information Extraction)

这是一个大数据的时代。随着太阳东升西落,每一天都在产生大量的数据信息。人们通常更擅长处理诸如数字之类的结构化数据。但实际情况是,非结构化数据往往比结构化的数据多。当我们从互联网上获取了大量的如文本之类的非结构化数据,如何去有效地分析它们来帮助我们更好地做出决策呢?这将是本文要回答的问题。

Data · Model · Agent · Repeat 4591

基于Python与spaCy构建文本信息抽取与结构化存储系统

在实际技术开发和安全运维领域,我们经常需要处理来自不同数据源、格式各异的信息,并对其进行清洗、分析和结构化存储。这类任务的核心挑战在于如何设计一个健壮、可扩展的数据处理管道,能够自动识别关键实体、事件和关系,同时过滤掉无关或冗余的噪音信息。对于开发者、数据分析师和安全研究人员而言,掌握一套从原始文本中提取结构化信息并将其转化为可查询知识图谱或数据库记录的方法,是提升数据价值的关键。 本文将以一个模拟的、中性的国际新闻事件数据流处理为背景,介绍如何构建一个技术中立的文本信息处理与结构化存储系统。我们将不涉及任

weixin_33811539的博客 357

信息抽取总结

信息抽取

therain123的博客 2569

从文本提取信息(基于nltk)

如果我们不是集中我们的精力在问题或“实体关系”的有限集合,例如:“不同的设施位于何处”或“谁被什么公司雇用”上,我们就能取得重大进展。一个重要的形式是结构化数据:实体和关系的可预测的规范的结构。我们将用于实体识别的基本技术是词块划分,它分割和标注多词符的序列,如 2.1 所示。然而,只需创建一个包含递归规则的多级的词块语法,就可以建立任意深度的词块结构。另外,级联过程只能产生固定深度的树(不超过级联级数),完整的句法分析这是不够的。在本节中,我们将在较深的层面探讨词块划分,以词块的定义和表示开始。

sikh_0529的博客 1万+

文本信息抽取:从非结构化数据中提取知识

1. 背景介绍 随着互联网和数字化时代的到来,我们生活在一个信息爆炸的时代。每天都有海量的文本数据产生,例如新闻报道、社交媒体帖子、电子邮件、客户评论等等。这些文本数据中蕴藏着大量有价值的信息和知识,但它们往往是非结构化的,难以被计算机直接理解和利用。因此,如何从这些非结构化文本数据中自动提取出有用的信息和知识,成为了自然语言处理领域的一个重要研究方

AI天才研究院 904

NLTK学习笔记——信息抽取(1)

信息抽取的内容在《Natural Language Processing》第7章,对于文本的信息抽取,命名实体及其关系的识别是至关重要要的,信息抽取分为以下几个步骤: 1. 文本切分,将string类型的文本划分为list类型的句子 2. 句子切分,将每个list类型的句子划分成由单词或chunk组成的list 3. 词性标注,生成由一个list,其组成内容是多个形如(word,labl

cangqiong112758的博客 8409

【安全加固】应对Sweet32攻击:TLS/SSL协议3DES漏洞深度解析与修复指南

本文深度解析了CVE-2016-2183(Sweet32攻击)漏洞,该漏洞利用TLS/SSL协议中3DES加密算法的64位块大小缺陷,通过大量数据流量实施“生日攻击”导致信息泄露。文章提供了从原理分析、系统排查到跨平台修复的完整指南,重点指导如何在Windows、Linux服务器及网络设备中禁用不安全的3DES密码套件,并采用AES-GCM等更安全的加密方式,以彻底修复此TLS/SSL漏洞。

weixin_29230649的博客 585

实体关系抽取方法

论文《实体关系抽取方法研究综述》(李冬梅)阅读笔记

weixin_61878385的博客 1254

Python中优化模块scipy.optimize的优化算法介绍

如果你有一个特殊的优化问题,你可以使用对象来自定义问题的求解。# 自定义目标函数# 自定义优化问题custom_problem.fun = custom_objective_function # 目标函数custom_problem.x = [1, 1] # 初始猜测# 执行优化# 打印结果在上述例子中,我们自定义了一个对象,并指定了目标函数和初始猜测,然后使用minimize函数进行求解。Scipy的优化模块提供了丰富的功能,适用于各种优化问题。

Pandas120的博客 3047

关于RS485通讯TVS器件选择的经验

先说经验结论 如果你的RS485用于频繁热拔插, 比如作为手持终端使用, 且手持器与目标板非隔离, 那么使用6.8CA可能是更好的选择.因为有热拔插会产生浪涌, 而且在非隔离的场合有些工业设备接地也是无法保障的.对于使用场景较为单一的, 点对点或点对多场合. 可以使用最大峰值脉冲电流较小的SM712.这是在长期的产品设计中得到的经验. 仅供参考 一. TVS的工作原理和作用 瞬态电压抑制二极管 ...

qq_20163075的博客 6509

python 命名实体识别_Python NLTK学习11(命名实体识别和关系抽取)

Python NLTK学习11(命名实体识别和关系抽取)发表于:2017年7月27日阅读:18262除特别注明外,本站所有文章均为小杰Code原创本系列博客为学习《用Python进行自然语言处理》一书的学习笔记。命名实体识别命名实体识别(NER)系统的目标是识别所有文字提及的命名实体。可以分解成两个子任务:确定NE的边界和确定其类型。命名实体识别非常适用于基于分类器类型的方法来处理的任务。...

weixin_39630762的博客 2250

从外包到转正:一个华为OD亲历者的真实工作体验与避坑指南

本文分享了一位华为OD员工从外包到转正的真实经历与实用建议。通过详细解析华为OD的日常工作、转正核心指标、机试备考技巧及职场突围策略,为读者提供了一份全面的避坑指南。特别针对机试E卷的高频考点和刷题方法,给出了具体的数据分析和实战经验。

weixin_33686714的博客 697

Python NLTK库【NLP核心库】全面解析

NLTK是 Python 中用于自然语言处理(NLP)的核心库,提供了丰富的文本处理工具、算法和语料库。文本预处理(分词、词干提取、词形还原)句法分析(词性标注、分块、句法解析)语义分析(命名实体识别、情感分析)语料库管理(内置多种语言语料库)机器学习集成(分类、聚类、信息抽取)加载本地文本文件corpus_root = './my_corpus' # 本地文件夹路径file_pattern = r'.*\.txt' # 匹配所有txt文件# 访问语料库内容。

记录点滴 3752

OpenClaw 3.13 + Mac mini M4 集成 qmd 记忆存储:qmd embed 卡死 / 报错 sqlite-vec 不可用 终极解决教程

模型加速让 qmd 从国内镜像下载模型,避免网络超时;SQLite 扩展支持:修改 qmd 源码后,Bun 不再使用内置 SQLite,而是调用 Homebrew 安装的,该版本支持接口,可正常加载vec0.dylib向量扩展;OpenClaw 3.13 适配:核心逻辑与 OpenClaw 3.13 的 qmd 记忆调用逻辑完全兼容,无需额外调整;sqlite-vec 加载:qmd 自动通过sqlite-vec包获取vec0.dylib路径,调用完成向量扩展加载,实现高效向量搜索。

wuanxionglidui的博客 1304

b站up“麦辣翅翅”《YOLOv8修改损失函数》问题解决RuntimeError: The size of tensor a (4) must match the size of tensor

b站up“麦辣翅翅”《YOLOv8修改损失函数》问题解决RuntimeError: The size of tensor a (4) must match the size of tensor ;TypeError: bbox_iou() got an unexpected keyword argument 'xywh‘

weixin_68331871的博客 3020

【Python】已解决:nltk.download(‘punkt’) [nltk_data] Error loading punkt: [WinError 10060] [nltk_data]

在使用Python的自然语言处理库NLTK(Natural Language Toolkit)时,经常需要下载和使用各种数据包,如punkt用于句子分割。然而,在执行nltk.download(‘punkt’)时,有时会遇到[nltk_data] Error loading punkt: [WinError 10060]这样的错误。通过以上的分析和解决方案,你应该能够解决nltk.download(‘punkt’)时遇到的[WinError 10060]错误。

屿小夏.的知识博客 2452

《C#零基础入门之百识百例》(七十一)委托介绍 -- 战士升级示例

委托的存在是因为,我们有时候需要将一个函数作为另一个函数的参数,这时就要用的委托(Delegate)机制。委托用关键字`delegate`声明,他实际上定义了一种“函数类型”,明确规定了函数参数类型和返回值类型。

陈言必行 -- Unity游戏开发领域优质博主 2109

python的nltk中文使用和学习资料汇总帮你入门提高

nltk是一个python工具包, 用来处理和自然语言处理相关的东西. 包括分词(tokenize), 词性标注(POS), 文本分类, 等等现成的工具. 1. nltk的安装 资料1.1: 黄聪:Python+NLTK自然语言处理学习(一):环境搭建  http://www.cnblogs.com/huangcong/archive/2011/08/29/2157437.html   这个图...

天才幻想家 1117

BART non-Cartesian 重建:并行成像 压缩感知

本文主要使用并行成像和压缩感知方法实现non-Cartesian MRI 数据的重建。

张哥频道:电生理信号和磁共振成像 1181

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

收纳一些学习nltk过程中遇到的问题

收纳一些学习nltk过程中遇到的问题 python3使用nltk.download()时出错的解决办法 / 离线安装nltk_data

makesomethings的博客 201

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

NLTK学习笔记(七):文本信息提取

版权声明:更多原创文章请访问: http://yuanxin.me/ https://blog.csdn.net/AsuraDong/article/details/73477666   实体识别分块技术 分块语法的构建 树状图 IOB标记 开发和评估分块器 命名实体识别和信息提取   如何构建一个系统,用于从非结构化的文本中提取结构化的信息和数据?...

qq_34504481的博客 1542

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

nltk

python的nltk中文使用和学习资料汇总帮你入门提高nltk是一个python工具包, 用来处理和自然语言处理相关的东西. 包括分词(tokenize), 词性标注(POS), 文本分类, 等等现成的工具. nltk的安装 资料1.1: 黄聪:Python+NLTK自然语言处理学习(一):环境搭建 http://www.cnblogs.com/huangcong/archive/2011/0

perfectmanman的博客 1053

【Python】已解决:ModuleNotFoundError: No module named ‘nltk‘

然而,在实际开发过程中,很多开发者在运行代码时遇到了 ModuleNotFoundError: No module named ‘nltk’ 这样的错误。通过上述步骤和注意事项,开发者可以轻松解决 ModuleNotFoundError: No module named ‘nltk’ 错误,并顺利进行自然语言处理项目的开发。已解决:ModuleNotFoundError: No module named ‘nltk‘为了正确解决这个报错问题,首先需要确保已经安装了 nltk 库。

屿小夏.的知识博客 1191
上一篇: NLTK学习之三:文本分类与构建基于分类的词性标注器
下一篇: 线性代数之一:方程组与矩阵
zzulp
博客等级 码龄19年 464粉丝 176原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

