


目录
关于obj类,重写equals一定要重写hashcode原因
DK 7及以前版本:HashMap是数组+链表结构(即为链地址法)
JDK 8版本发布以后:HashMap是数组+链表+红黑树实现。
Java 集合
集合框架与数组的对比及概述
- 集合、数组都是对多个数据进行存储操作的结构,简称Java容器.
- 特备说明:此时的存储,主要是指能存层面的存储,不涉及到持久化的存储(.txt,.jpg,.avi,数据库中)
- 数组在存储多个数据封面的特点
- 一旦初始化以后,它的长度就确定了。不能修改
- 数组一旦定义好,它的数据类型也就确定了。我们就只能操作指定好的类型的数据了。后面会提到泛型来为集合限制数据类型
例如:String[] arr 只能存储Stirng类型的数据 - 数组中提供的方法非常有限,对于添加、删除、插入数据等操作,非常不便,同时效率不高。
- 获取数组中实际元素的个数的需求,数组没有现成的属性或方法可用
- 数组存储数据的特点:有序、可重复。对于无序、不可重复的需求,不能满足
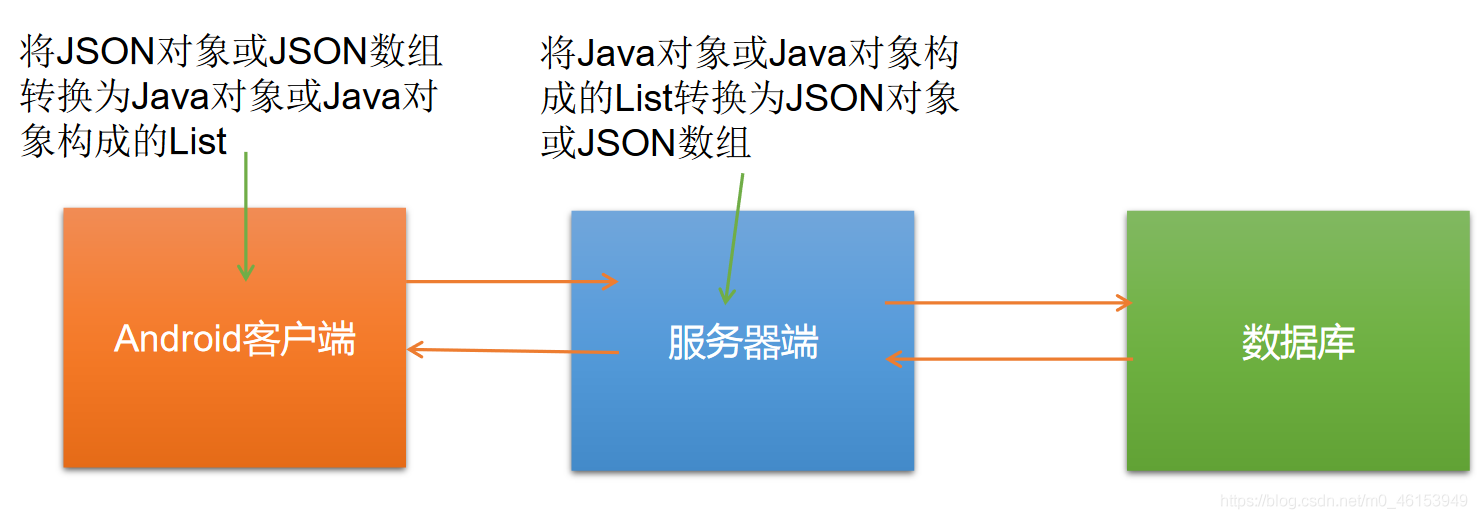
- 集合使用场景:一个常用网址功能可以存储多个具体网址信息,它的实现图和流程如下图
集合涉及到的API
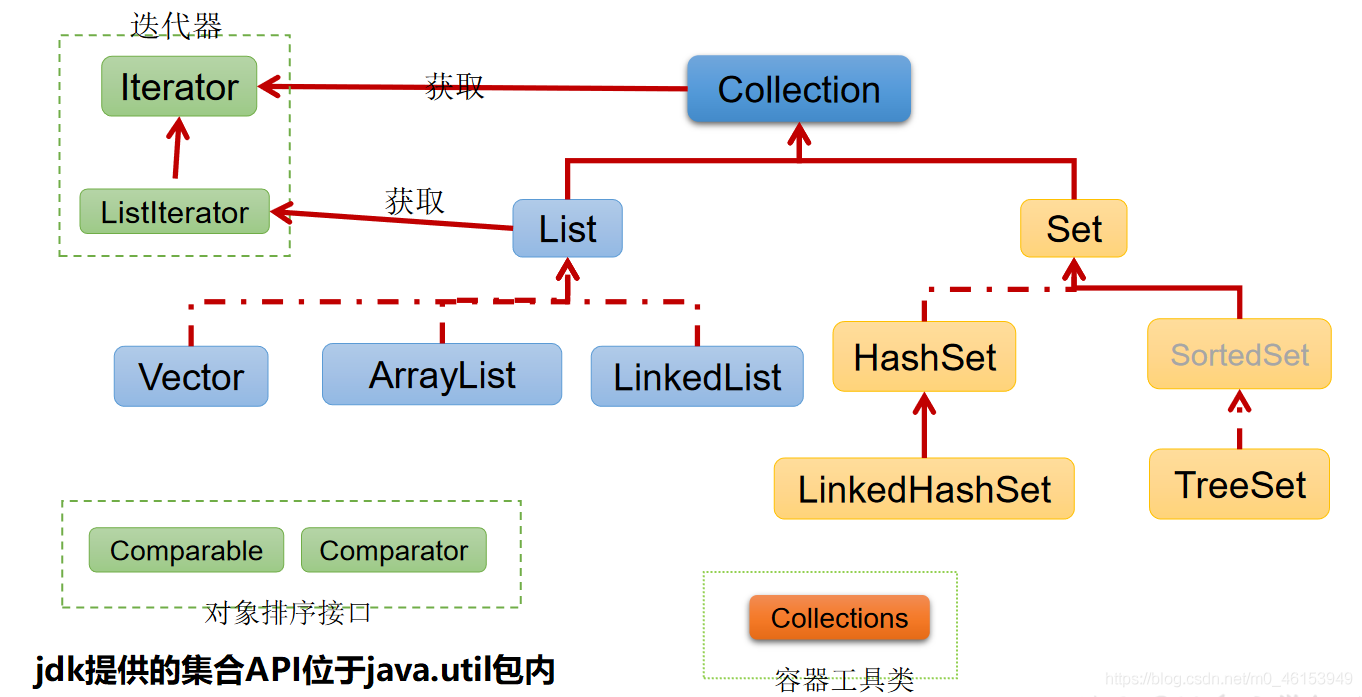
Java 集合可分为Collection和Map两种体系
-
Collection接口:- 单列数据,定义了存取一组对象的方法的集合,分别为:
List:元素有序、可重复的集合Set:元素无序、不可重复的集合
- Collection接口继承树
-
/**
 * 1. List接口框架
 *
 *    |----Collection接口:单列集合,用来存储一个一个的对象
 *          |----List接口:存储有序的、可重复的数据。  -->“动态”数组,替换原有的数组
 *              |----ArrayList:作为List接口的主要实现类;线程不安全的,效率高;底层使用Object[] elementData存储
 *              |----LinkedList:对于频繁的插入、删除操作,使用此类效率比ArrayList高;底层使用双向链表存储
 *              |----Vector:作为List接口的古老实现类;线程安全的,效率低;底层使用Object[] elementData存储
 *
 *
 * 面试题:比较ArrayList、LinkedList、Vector三者的异同?
 *        同:三个类都是实现了List接口,存储数据的特点相同:存储有序的、可重复的数据
 *        不同:见上
 *
 *
 *         |----Set接口:存储无序的、不可重复的数据   -->高中讲的“集合”
 *             |----HashSet:作为Set接口的主要实现类;线程不安全的;可以存储null值
 *                 |----LinkedHashSet:作为HashSet的子类;遍历其内部数据时,可以按照加入顺序和取出元素/数据的顺序一致。因为底层是使用了双向链表结构
 *                                    对于频繁的遍历操作,LinkedHashSet效率高于HashSet.因为集合里的每个数据还维护了两个引用,记录此数据前一个数据和后一个数据
 *             |----TreeSet:可以按照添加对象的指定属性,进行排序。底层使用红黑树结构存储数据,查询速度比List快
 */
- 单列数据,定义了存取一组对象的方法的集合,分别为:
-
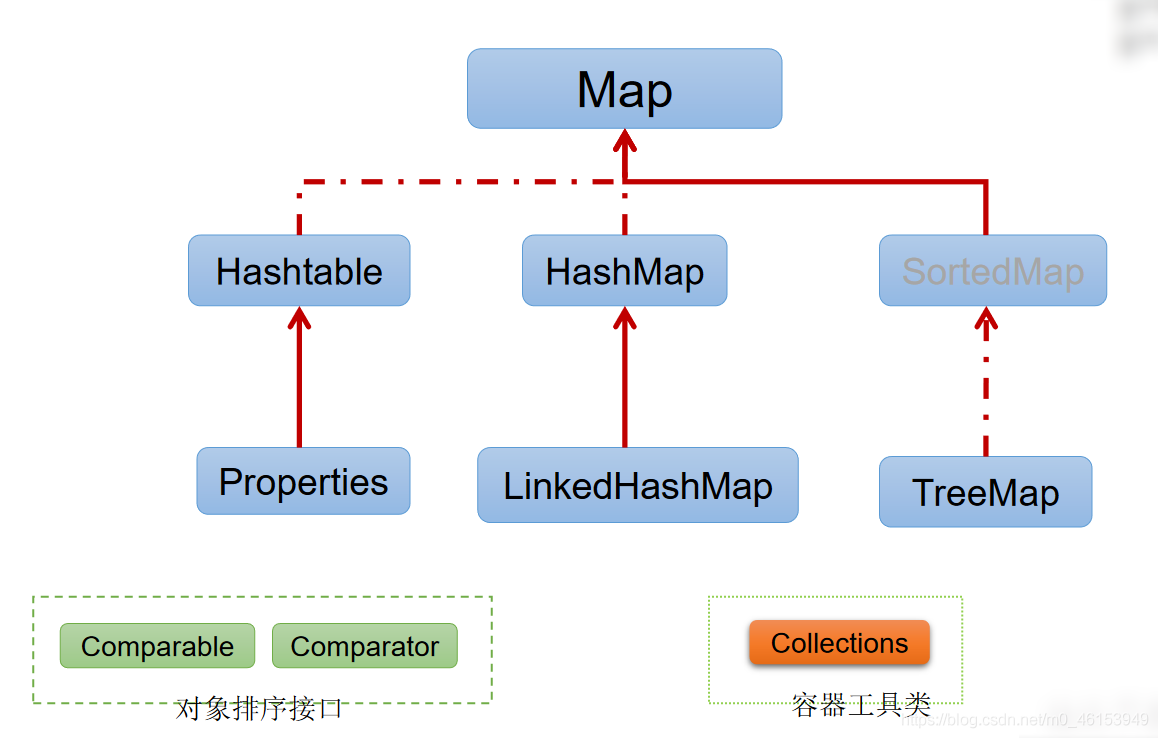
Map接口:- 双列数据,保存具有映射关系“key-value对”的集合
-
一、Map的实现类的结构:
 *  |----Map:双列数据,存储key-value对的数据   ---类似于高中的函数:y = f(x)
 *         |----HashMap:作为Map的主要实现类;线程不安全的,效率高;存储null的key和value
 *              |----LinkedHashMap:保证在遍历map元素时,可以按照添加的顺序实现遍历。
 *                      原因:在原有的HashMap底层结构基础上,添加了一对指针,指向前一个和后一个元素。
 *                      对于频繁的遍历操作,此类执行效率高于HashMap。
 *         |----TreeMap:保证按照添加的key-value对进行排序,实现排序遍历。此时考虑key的自然排序或定制排序
 *                      底层使用红黑树
 *         |----Hashtable:作为古老的实现类;线程安全的,效率低;不能存储null的key和value
 *              |----Properties:常用来处理配置文件。key和value都是String类型
 *
 *
 *      HashMap的底层:数组+链表  (jdk7及之前)
 *                    数组+链表+红黑树 (jdk 8)
 *
 *  面试题:
 *  1. HashMap的底层实现原理?
 *  2. HashMap 和 Hashtable的异同?
 *  3. CurrentHashMap 与 Hashtable的异同?(暂时不讲)
- 双列数据,保存具有映射关系“key-value对”的集合
Collection接口方法
- Collection 接口是List、Set 和Queue 接口的父接口,该接口里定义的方法既可用于操作Set 集合,也可用于操作List 和Queue 集合。
- JDK不提供此接口的任何直接实现,而是提供更具体的子接口(如:Set和List)实现。
- 在Java5 之前,Java 集合会丢失容器中所有对象的数据类型,把所有对象都当成Object 类型处理;从JDK 5.0 增加了泛型以后,Java 集合可以记住容器中对象的数据类型
Collection接口中的常用方法
- 前提:在添加Object类型对象在集合之前,要确保其类要重写了hashCode和equal方法,否则大部分基于Object类型对象的equals()方法的Collection的API将会实效。
- 添加
- add(Objec tobj) 为集合添加一个元素,在没有泛型的限制下,集合可以存不同类型的数据,存入的基本数据类型会自动装箱成包装类型
- addAll(Collection coll) 将coll集合中的元素添加到当前的集合中
- 获取集合中有效元素(也就是在使用中的元素个数)
- int size()
- 清空集合元素
- void clear()
- 是否是空集合
- boolean isEmpty()
- 是否包含某个元素
- boolean contains(Object obj):判断集合中是否包含obj对象,是通过元素的equals方法来判断是否是同一个对象,比较的是数据类型和具体的值
- boolean containsAll(Collection c):也是调用元素的equals方法来比较的。拿两个集合的元素挨个比较,判断集合c里所有元素是否存在于当前集合中
- boolean contains(Object obj):判断集合中是否包含obj对象,是通过元素的equals方法来判断是否是同一个对象,比较的是数据类型和具体的值
- 删除
- boolean remove(Object obj) :通过元素的equals方法判断是否是要删除的那个元素。只会删除找到的第一个元素并删除,如果移除成功,则返回true,移除失败则返回false
- boolean removeAll(Collection coll):差集:从当前集合中移除coll1中含有的所有的元素,coll1元素当前元素多了也没所谓。
- 取两个集合的交集:boolean retainAll(Collection c):把交集的结果存在当前集合中,不影响c
- 集合是否相等:boolean equals(Object obj)
- 集合转成对象数组:Object[] toArray()
- 将传入的一个或多个参数转换成List集合返回:List<T> asList(T... a) #参数为Object[]类型的(可变)形参.Arrays.asList方法返回的集合,继承了AbstractList,但是没有重写add和remove方法,相当于把集合固定了。后面使用API会有BUG
- 获取集合对象的哈希值:hashCode()
package javase13;

import org.junit.Test;

import java.util.*;

public class Collection1 {

    @Test
    public void test1(){
        Collection c1 = new ArrayList();//采用多态创建一个ArrayList集合对象

        //add(Object e):将元素e添加到集合coll中,在没有泛型的限制下,集合可以存不同类型的数据
        c1.add("AA");
        c1.add("BB");
        c1.add(123);  //自动装箱
        c1.add(new Date());

        //size():获取集合中有效元素(也就是在使用中的元素个数)
        System.out.println(c1.size());//4

        Collection c2 = new ArrayList();
        //addAll(Collection coll1):将coll1集合中的元素添加到当前的集合中
        c2.addAll(c1);
        System.out.println(c2.size());//4

        //clear():清空集合元素
        c2.clear();
        System.out.println(c2.size());//0
        //isEmpty():判断当前集合是否为空
        boolean b1 = c2.isEmpty();
        System.out.println(b1);//true
    }

    @Test
    public void test2(){

        Collection c3 = new ArrayList();
        c3.add(new Person("Ben",18));
        c3.add(new Person("Tom",18));
        c3.add(1);
        c3.add(2);

        //boolean contains(Object obj):判断集合中是否包含obj对象,是通过元素的equals方法来判断是否是同一个对象,比较的是数据类型和具体的值
        Person tom = new Person("Tom", 18);
        System.out.println(c3.contains(tom));//true
        System.out.println(c3.contains(1));//true

        Collection c4 = Arrays.asList(1, 2);//将传入的参数转换成List集合返回
        //boolean containsAll(Collection c):也是调用元素的equals方法来比较的。拿两个集合的元素挨个比较,判断集合c里所有元素是否存在于当前集合中
        System.out.println(c3.containsAll(c4));//true

    }

    @Test
    public void test3(){
        //被注释的代码块部分的remove方法有BUG
//        Collection c5 = Arrays.asList(123,456,new Person("Jerry",20),new String("Tom"),false);
//        // boolean remove(obj)  通过元素的equals方法判断是否是要删除的那个元素。只会删除找到的第一个元素并删除,如果移除成功,则返回true,移除失败则返回false
//        boolean b1 = c5.remove(123456);
//        System.out.println(b1);
//        boolean b2 = c5.remove(new Integer(123));
//        System.out.println(c5);
        Collection c5 = new ArrayList();
        c5.add(123);
        c5.add(456);
        c5.add(new Person("Jerry",20));
        c5.add(new String("Tom"));
        c5.add(false);
        // boolean remove(obj)  通过元素的equals方法判断是否是要删除的那个元素。只会删除找到的第一个元素并删除,如果移除成功,则返回true,移除失败则返回false
        boolean b1 = c5.remove(123456);
        System.out.println(b1);//fasle
        boolean b2 = c5.remove(123);
        System.out.println(b2+""+c5);//true[456, Person{name='Jerry', age=20}, Tom, false],123元素被溢出

        Collection c6 = new ArrayList();
        c6.add(123);
        c6.add(456);
        c6.add(new Person("Jerry",20));
        c6.add(new String("Tom"));
        c6.add(false);

        //4. removeAll(Collection coll1):差集:从当前集合中移除coll1中含有的所有的元素,coll1元素当前元素多了也没所谓。
        c5.removeAll(c6);
        System.out.println(c5);//[],c5集合已经被清空
    }

    @Test
    public void test4(){
        Collection c7 = new ArrayList();
        c7.add(123);
        c7.add(456);
        c7.add(new Person("Jerry",20));
        c7.add(new String("Tom"));
        c7.add(false);

        //retainAll(Collection coll1):交集:获取当前集合和coll1集合的交集,并返回给当前集合
        Collection c8 = Arrays.asList(123,456,789);
        c7.retainAll(c8);//c7已经被修改
        System.out.println(c7);//[123, 456]

        //boolean equals(Object obj) ,两个集合是否类型相同,元素相同
        Collection c9 = Arrays.asList(123,456,789);
        boolean b4 = c8.equals(c9);
        System.out.println(b4);//true

    }

    @Test
    public void test5(){
        Collection c9 = new ArrayList();
        c9.add(123);
        c9.add(456);
        c9.add(new Person("Jerry",20));
        c9.add(new String("Tom"));
        c9.add(false);

//        hashCode():返回当前对象的哈希值
        System.out.println(c9.hashCode());//-1200490100,根据元素生成的hash值

        //集合 --->数组:toArray()
        Object[] arr1 = c9.toArray();
        System.out.println(Arrays.toString(arr1));//[123, 456, Person{name='Jerry', age=20}, Tom, false]

//        数组 --->集合:
        //调用Arrays类的静态方法asList(),跟数组对应的集合一定是一个List
        List<String> c10 = Arrays.asList(new String[]{"AA", "BB", "CC"});
        System.out.println(c10);//[AA, BB, CC]

        //注意!!!!!:他把int[]看成一个元素了,不像new String[]一样把数组里面的每一个元素看做是集合的每一个元素
        List<int[]> arr2 = Arrays.asList(new int[]{123, 456});
        System.out.println(arr2.size());//1,因此集合可用元素为1

        //这样写就能区分每一个元素
        List arr3 = Arrays.asList(123, 456);
        System.out.println(arr3);//[123, 456]

        //包装类型对象与上同理
        List arr4 = Arrays.asList(new Integer[]{123, 456});
        System.out.println(arr4.size());//2
    }
}

//创建一个Person类
class Person {

    //私密属性
    private String name;
    private int age;

    //无参构造器
    public Person() {
        super();
    }

    //全参构造器
    public Person(String name, int age) {
        this.name = name;
        this.age = age;
    }

    //Getter Setter方法
    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public int getAge() {
        return age;
    }

    public void setAge(int age) {
        this.age = age;
    }

    //toString()
    @Override
    public String toString() {
        return "Person{" +
                "name='" + name + '\'' +
                ", age=" + age +
                '}';
    }

    //equals,hashCode,在添加Object类型对象在集合之前,要确保其类要重写了hashCode和equal方法,否则大部分基于Object类型对象的equals()方法的Collection的API将会实效
    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;
        Person person = (Person) o;
        return age == person.age &&
                Objects.equals(name, person.name);
    }

    @Override
    public int hashCode() {

        return Objects.hash(name, age);
    }
}
Iterator迭代器接口
- Iterator对象称为迭代器(设计模式的一种),主要用于遍历Collection 集合中的元素。
- GOF给迭代器模式的定义为:提供一种方法访问一个容器(container)对象中各个元素,而又不需暴露该对象的内部细节。迭代器模式,就是为容器而生。类似于“公交车上的售票员”、“火车上的乘务员”、“空姐”。
- Collection接口继承了java.lang.Iterable接口,该接口有一个iterator()方法,那么所有实现了Collection接口的集合类都有一个iterator()方法,用以返回一个实现了Iterator接口的对象。
- Iterator 仅用于遍历集合,Iterator本身并不提供承装对象的能力。如果需要创建Iterator 对象,则必须有一个被迭代的集合。
- 集合对象每次调用iterator()方法都得到一个全新的迭代器对象,默认游标都在集合的第一个元素之前。
-
Collection迭代器方法:
- 遍历:iterator():
集合对象每次调用iterator()方法都得到一个全新的迭代器对象,默认游标都在集合的第一个元素之前。用于集合遍历
- 遍历:iterator():
-
迭代器对象iterator()方法:
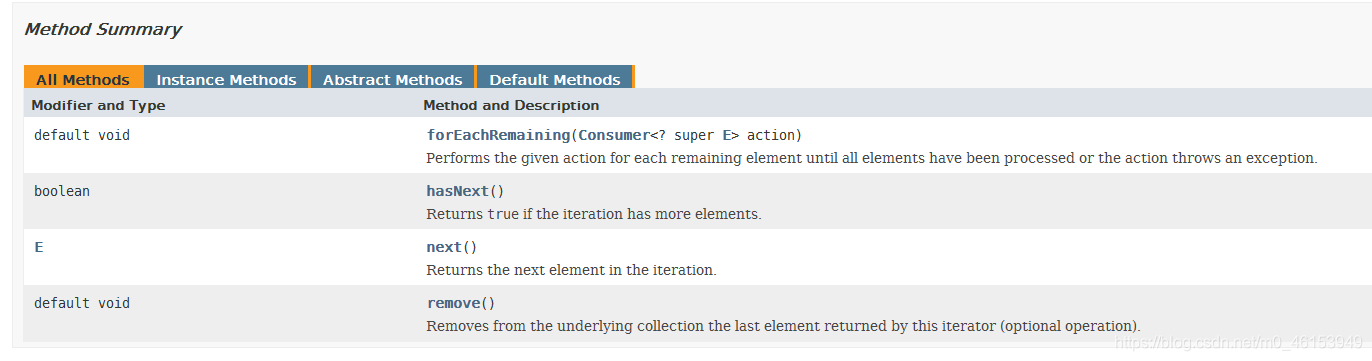
- hasNext():.hasNext()进行检测下一条是否有记录,有则返回true
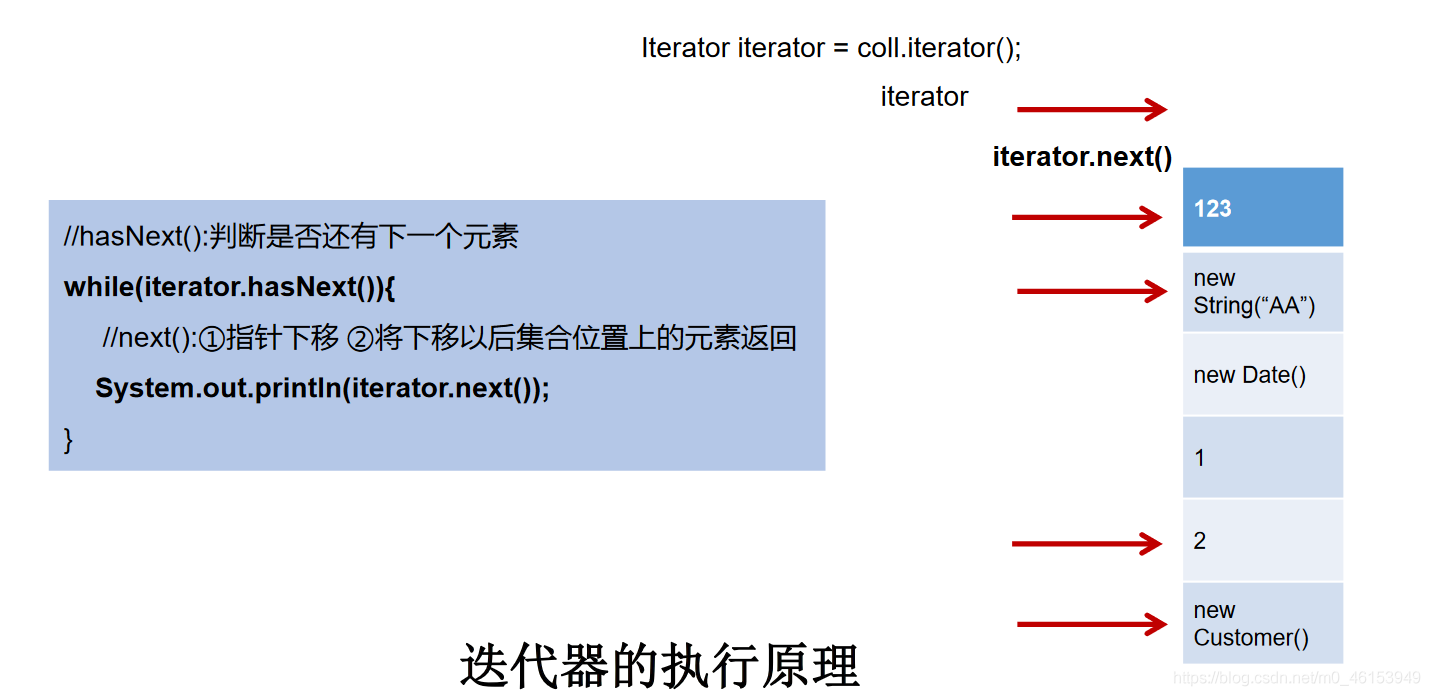
- next():会从默认游标开始遍历该数组的元素,每调用一次游标位置向右移动一位,然后返还当前游标指向的元素;在调用.next()若该集合没有下一条记录,直接调用.next()会抛出NoSuchElementException运行异常。因此使用迭代器的.next()方法一般都需要配合.hasNext()进行检测下一条是否有记录,有则返回true
- remove():删除游标指向的集合元素。注意集合对象每次调用iterator()方法都得到一个全新的迭代器对象,默认游标都在集合的第一个元素之前,不指向任何一个元素。如果删除不存在的元素会抛出IllegalStateException异常。同理,如果上一次调用 next 方法之后已经调用了 remove 方法,再调用remove都会报IllegalStateException,因为该游标指的位置已经没有元素了。Iterator的.remove()可以删除集合的元素,但是是遍历过程中通过迭代器对象的remove方法,不是集合对象的remove方法
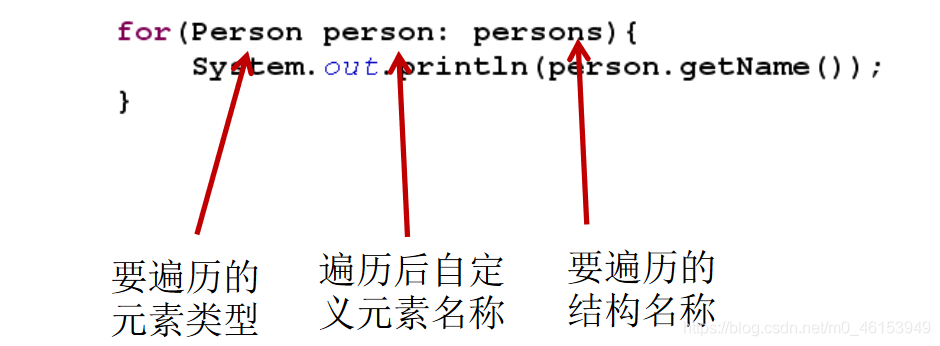
- for(集合元素的类型 局部变量 : 集合对象){方法体}:可以遍历集合,内部仍然调用了iterator迭代器。也可以遍历集合
- 迭代器执行原理图
JDK1.5新特性foreach循环遍历集合或数组
说明:通过高效for循环遍历集合和数组
- Java 5.0 提供了foreach循环迭代访问Collection和数组。
- 遍历操作不需获取Collection或数组的长度,无需使用索引访问元素。
- 遍历集合的底层调用Iterator完成操作。
- foreach还可以用来遍历数组。
代码演示迭代器对象iterator()方法
package javase13;

import org.junit.Test;

import java.util.ArrayList;
import java.util.Collection;
import java.util.Iterator;

public class Collection2 {

    //.next() , .hasNext()
    @Test
    public void test1(){
        Collection c1 = new ArrayList();
        c1.add(123);
        c1.add(456);
        c1.add(789);
        c1.add(10);

        //iterator():集合对象每次调用iterator()方法都得到一个全新的迭代器对象,默认游标都在集合的第一个元素之前。用于集合遍历
        Iterator it1 = c1.iterator();

        //遍历集合方法1:
        //迭代器对象方法.next(),会从默认游标开始遍历该数组的元素并返回单个元素,每调用一次游标位置向右移动一位
//        System.out.println(it1.next());//123
//        System.out.println(it1.next());//456
//        System.out.println(it1.next());//789
//        System.out.println(it1.next());//10
//        System.out.println(it1.next());//NoSuchElementException运行异常,因为在调用it.next()若没有下一条记录,直接调用it.next()会抛出异常。

        //遍历集合方法2:
        //因此使用迭代器的.next()方法一般都需要配合.hasNext()进行检测下一条是否有记录,有则返回true
        while(it1.hasNext()){//因为要发挥hasNext()的作用,因此最简单就是使用while
            System.out.println(it1.next());
        }
        /*
        * 123
        * 456
        * 789
        * 10
        * */
    }

    //.remove()
    @Test
    public void test2(){
        Collection c1 = new ArrayList();
        c1.add(123);
        c1.add(456);
        c1.add("Tom");
        c1.add(10);

        Iterator iterator = c1.iterator();
        while(iterator.hasNext()){
            //集合对象每次调用iterator()方法都得到一个全新的迭代器对象,默认游标都在集合的第一个元素之前,这里是删除一个不指向任何元素的游标,因此
//            iterator.remove();//出现IllegalStateException异常
            Object obj = iterator.next();
            if("Tom".equals(obj)){
                iterator.remove();
                //上一次调用 next 方法之后已经调用了 remove 方法,再调用remove都会报IllegalStateException,因为该游标指的位置已经没有元素了
//                iterator.remove();
            }
        }
        //Iterator的.remove()可以删除集合的元素,但是是遍历过程中通过迭代器对象的remove方法,不是集合对象的remove方法
        System.out.println(c1);//[123, 456, 10]
    }

    //foreach()
    @Test
    public void test3(){
        Collection c1 = new ArrayList();
        c1.add(123);
        c1.add(456);
        c1.add("Tom");
        c1.add(10);

        //for(集合元素的类型 局部变量 : 集合对象),内部仍然调用了iterator迭代器。
        for(Object obj : c1){
            System.out.println(obj);
        }
        //还可以用来遍历数组
        int[] arr = new int[]{1,2,3,4,5,6};
        //for(数组元素的类型 局部变量 : 数组对象)
        for(int i : arr){
            System.out.println(i);
        }
    }
}
Collection子接口之一:List接口
- 链表和数组是Java两种最基本的数据结构。后面学的数和族都是由这两种基本数据类型改造而来的。
- 鉴于Java中数组用来存储数据的局限性,我们通常使用List替代数组
- List集合类中元素有序、且可重复,集合中的每个元素都有其对应的顺序索引。
- List容器中的元素都对应一个整数型的序号记载其在容器中的位置,可以根据序号存取容器中的元素。
- JDK API中List接口的实现类常用的有:ArrayList、LinkedList和Vector。
- 不同点:
- ArrayList:作为List接口的主要实现类;线程不安全的,效率高;底层使用Object[] elementData存储
- LinkedList:对于频繁的插入、删除操作,使用此类效率比ArrayList高;底层使用双向链表存储
- Vector:作为List接口的古老实现类;线程安全的,效率低;底层使用Object[] elementData存储
- 相同点:
- 三个类都是实现了List接口,存储数据的特点相同:存储有序的、可重复的数据
- 不同点:
-
ArrayList的源码分析
- ArrayList是List 接口的典型实现类、主要实现类
- 本质上,ArrayList是对象引用的一个”变长”数组
- JDK1.7
- ArrayList list = new ArrayList();//底层创建了长度是10的Object[]数组elementData
- list.add(123);//elementData[0] = new Integer(123);
- list.add(11);//如果此次的添加导致底层elementData数组容量不够,则扩容。默认情况下,扩容为原来的容量的1.5倍,同时需要将原有数组中的数据复制到新的数组中。
- 建议开发中使用带参的构造器:ArrayList list = new ArrayList(int capacity),否则多次扩容会导致性能减弱
- jdk 8中ArrayList的变化
- ArrayList list = new ArrayList();//底层Object[] elementData初始化为{}.并没有创建长度为10的数组
- list.add(123);//第一次调用add()时,底层才创建了长度10的数组,并将数据123添加到elementData[0]
- 后续的添加和扩容操作与jdk 7 无异。
- jdk7中的ArrayList的对象的创建类似于单例的饿汉式,而jdk8中的ArrayList的对象的创建类似于单例的懒汉式,延迟了数组的创建,节省内存
-
LinkedList的源码分析
- 对于频繁的插入或删除元素的操作,建议使用LinkedList类,效率较高
- LinkedList:双向链表,内部没有声明数组,而是在类中定义了Node类型的first和last属性,用于记录首末元素。同时,Node为LinkedList的私密静态内部类,定义内部类Node,作为LinkedList中保存数据的基本结构(也就是用链表每一个元素代表一个实例Node,实例Node来存储具体的值和上一个实例Node和下一个实例Node的地址信息,具体参考下图)
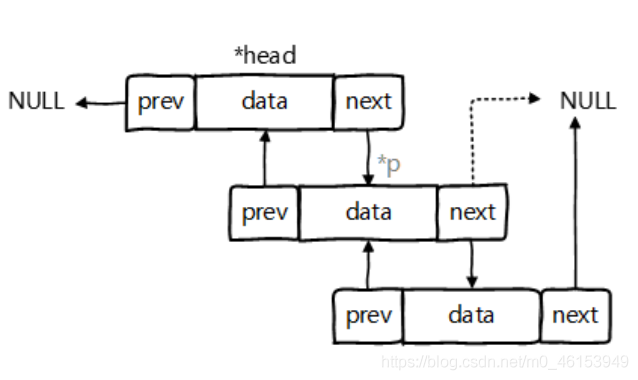
- LinkedList list = new LinkedList(); 内部声明了Node类型的first和last属性,默认值为null
- list.add(123);//内部创建了内部类Node的实例对象,将123封装到实例Node中。
void linkLast(E e) { final Node<E> l = last;//获取末尾元素 final Node<E> newNode = new Node<>(l, e, null);//实例化一个内部类Node,然后存放末尾元素的地址值、传入来的数据和null last = newNode;//新传入的数据变成末尾元素,由此可见LinkLast是按顺序存储的 if (l == null)//也就是进来的数据是LinkedList第一次进来的数据 first = newNode;//那会被放在LinkedList的首元素 else l.next = newNode;//否则就不是第一次进来的数据,就末尾元素的尾部记录新进来数据的地址值 size++;//链表有效元素增加 modCount++;//记录这个列表在结构上被修改的次数(看翻译是这么说的,先不管) } - 其中,Node定义为:体现了LinkedList的双向链表的说法
    private static class Node<E> {
        E item;
        Node<E> next;
        Node<E> prev;

        Node(Node<E> prev, E element, Node<E> next) {//Node的全参构造方法,给Node实例属性赋值
            this.item = element;//传入的新数据
            this.next = next;//上一个元素地址值
            this.prev = prev;//下一个元素地址值
        }
    }
-
Vector的源码分析
- Vector 是一个古老的集合,JDK1.0就有了。大多数操作与ArrayList相同,区别之处在于Vector是线程安全的。
- 在各种list中,最好把ArrayList作为缺省选择。当插入、删除频繁时,使用LinkedList;Vector总是比ArrayList慢,所以尽量避免使用。
- jdk7和jdk8中通过Vector()构造器创建对象时,底层都创建了长度为10的数组。在扩容方面,默认扩容为原来的数组长度的2倍。
-
(ArrayList)List接口中的常用方法测试
- List除了从Collection集合继承的方法外,List 集合里添加了一些根据索引来操作集合元素的方法。
- 常用方法:
- 增:
- void add(intindex, Object ele):在index位置插入ele元素
- boolean addAll(int index, Collection eles):从index位置开始将eles集合中的所有元素添加进来
- 查:
- Object get(int index):获取指定index位置的元素
- int indexOf(Object obj):返回obj在集合中首次出现的位置
- int lastIndexOf(Object obj):返回obj在当前集合中末次出现的位置
- List subList(int fromIndex, int toIndex):返回从fromIndex到toIndex位置的子集合
- 删:
- Object remove(int index):移除指定index位置的元素,并返回此元素
- 改
- Object set(int index, Object ele):设置指定index位置的元素为ele
- 增:
package javase13;


import org.junit.Test;

import java.util.ArrayList;
import java.util.Arrays;
import java.util.List;


public class Collection3 {
    @Test
    public void test1() {
        ArrayList a1 = new ArrayList();
        a1.add(123);
        a1.add(456);
        a1.add("Tom");
        a1.add(10);

        //void add(int index, Object ele):在index位置插入ele元素
        a1.add(0, "头");
        System.out.println(a1);//[头, 123, 456, Tom, 10]

        //boolean addAll(int index, Collection eles):从index位置开始将eles中的所有元素添加进来
        List list1 = Arrays.asList(1, 2, 3);
        a1.addAll(a1.size(), list1);
        System.out.println(a1);//[头, 123, 456, Tom, 10, 1, 2, 3]
        System.out.println(a1.size());//8

        //Object get(int index):获取指定index位置的元素
        System.out.println(a1.get(0));//头

        //int indexOf(Object obj):返回obj在集合中首次出现的位置
        System.out.println(a1.indexOf("Tom"));//3

        //int lastIndexOf(Object obj):返回obj在当前集合中末次出现的位置
        a1.add(1);
        System.out.println(a1.lastIndexOf(1));//8

        //List subList(int fromIndex, int toIndex):返回从fromIndex到toIndex位置的子集合
        List list2 = a1.subList(0, a1.size() - 1);
        System.out.println(list2);//[头, 123, 456, Tom, 10, 1, 2, 3]

        //Object remove(int index):移除指定index位置的元素,并返回此元素
        Object remove = a1.remove(0);
        System.out.println(a1 + "中被移除的元素为:" + remove);//[123, 456, Tom, 10, 1, 2, 3, 1]中被移除的元素为:头

        //Object set(int index, Object ele):设置指定index位置的元素为ele
        Object set = a1.set(0, 321);
        System.out.println(a1 + "中被更改的元素为" + set);//[321, 456, Tom, 10, 1, 2, 3, 1]中被更改的元素为123

    }

    //面试题:区分ArrayList中remove(int index)和remove(Object obj)
    @Test
    public void test2() {
        List list = new ArrayList();
        list.add(1);
        list.add(2);
        list.add(3);
        updateList(list);
        System.out.println(list);//[1]
    }
    private void updateList(List list) {
        list.remove(2);//这里判定为下标,使用的是下标查询,移除的是元素值3
        list.remove(new Integer(2));//这里判定为Object参数,因此移除的是元素值2
    }
}
Collection子接口之二:Set接口
- Set接口是Collection的子接口,set接口没有提供额外的方法,使用的都是Collection中声明过的方法。
- Set 集合不允许包含相同的元素,如果试把两个相同的元素加入同一个Set 集合中,则添加操作失败。
- Set 判断两个对象是否相同不是使用
==运算符,而是根据equals()方法,因此添加的obj需要重写equals()和hashCode()方法 - Set实现类的对比
- HashSet:作为Set接口的主要实现类;线程不安全的;可以存储null值
- LinkedHashSet:作为HashSet的子类;遍历其内部数据时,可以按照添加的顺序遍历,对于频繁的遍历操作,LinkedHashSet效率高于HashSet,但是插入性能一般
- TreeSet:可以按照添加对象的指定属性,进行排序。
- HashSet:作为Set接口的主要实现类;线程不安全的;可以存储null值
- 无序性:不等于随机性。存储的数据在底层数组中并非按照数组索引的顺序添加,而是根据数据的哈希值决定的。
- 不可重复性:保证添加的元素按照equals()判断时,不能返回true.即:相同的元素只能添加一个。
package javase13;


import org.junit.Test;

import java.util.*;


public class Collection4 {
    @Test
    public void test1() {
        Set set = new HashSet();
        set.add(123);
        set.add(456);
        set.add("fgd");
        set.add("book");

        Iterator i1 = set.iterator();
        while(i1.hasNext()){
            System.out.println(i1.next());//顺序是根据对象的hashCode决定的
        }
        /*
        *fgd
        * book
        * 456
        * 123
        * */
    }
}
HashSet中源码分析
-
HashSet是Set接口的典型实现,大多数时候使用Set 集合时都使用这个实现类。 -
HashSet按Hash算法来存储集合中的元素,因此具有很好的存取、查找、删除性能。 -
HashSet具有以下特点:不能保证元素的排列顺序-
HashSet不是线程安全的 -
集合元素可以是
null
-
-
HashSet集合底层是HashMap,是数组+链表+红黑树结构,按照Hash算法排序,删除增删改查速度性能较好,存储数据可以是null,线程不安全,懒汉式、初始容量为16,当如果使用率超过0.75,也就是16*0.75=12个元素就会扩大容量为原来的2倍。(16扩容为32,依次为64、128等......),默认数组最大就是64、链表是8,在JDK1.8后,如果按照最大数组是64、链表是8,先是链表达到了最大的8,然后再到数组进行扩容64,在64及64之内中长度超过8的链表是暂时不会树化,只有数组扩容到超过64才会树化,只要其中一个不成立就不会将超过8个的链表树化。树化的目的是为了提高查询效率,如果下次resize调整数组大小方法时判断树的结点个数低于6个,也会把红黑树再转为链表
-
HashSet集合判断两个元素相等的标准:两个对象通过hashCode()方法比较相等,并且两个对象的equals()方法返回值也相等 -
对于存放在
Set容器中的对象,对应的类一定要重写equals()和hashCode(Object obj)方法,以实现对象相等规则。即:“相等的对象必须具有相等的散列码”。 -
HashSet集合添加add()流程:
-
在JDK1.8中,Hashset和ArrayList一样采用延迟了数组的创建,节省内存
-
HashSet底层:数组+链表的结构。
-
HashSet集合添加add()流程:先取出对象的Hash值通过HashSet的Hash算法算出数组的索引,如果重复则该对象对比该数组索引位置下的对象的Hash值,Hash值又重复了就对比对象的equals,如果都重复了添加失败,不重复就将新元素存放(JDK1.7时,新元素存放到数组,并且新元素为链表第一个元素指向旧元素,但多线程修改会有死链问题,形象描述就是楼里新来了个一楼。JDK1.8就是新元素被旧元素指向,形象描述就是新来个顶楼)
-
LinkedHashSet的使用
- LinkedHashSet是HashSet的子类
- LinkedHashSet根据元素的hashCode值来决定元素的存储位置,但它同时使用双向链表维护元素的次序,这使得元素看起来是以插入顺序保存的。
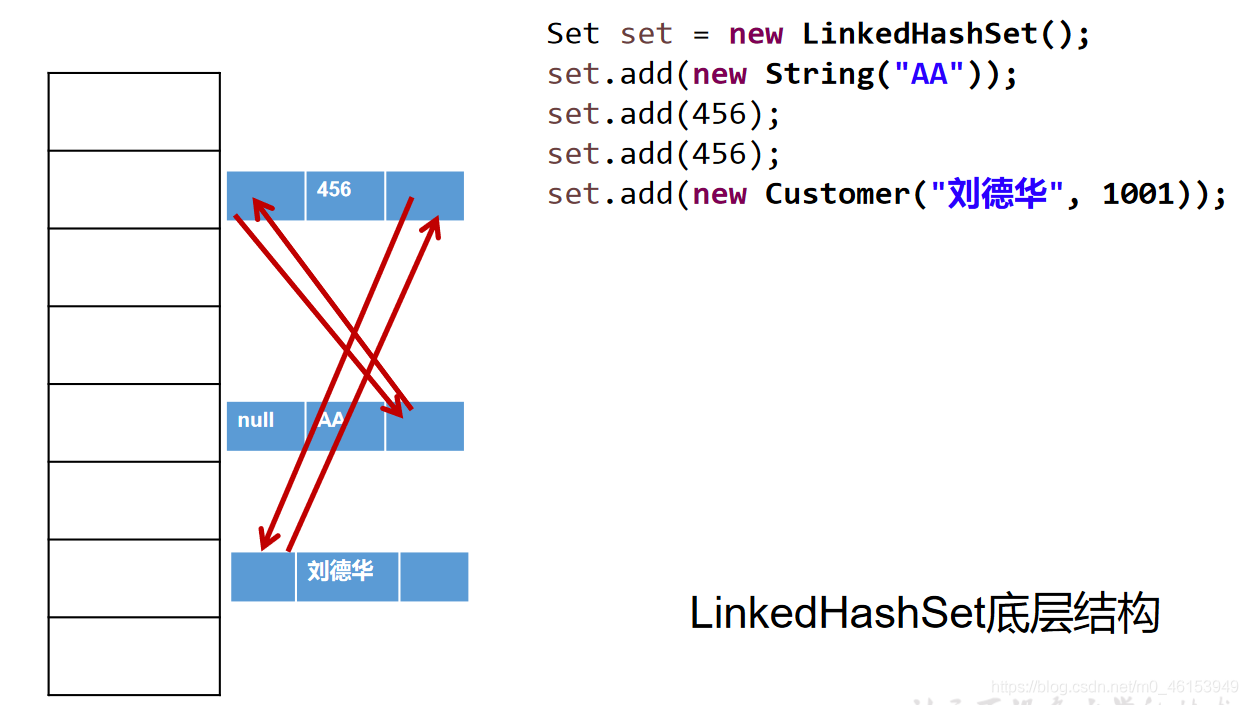
- LinkedSet是HashSet的子类,底层是哈希表 = 数组 + 链表/红黑树 + 链表,插入性能略低于HashSet,多了一条链表是有序的,性能较HashSet弱因为在添加数据的同时,每个数据还维护了两个引用,记录此数据前一个数据和后一个数据。但在迭代访问Set 里的全部元素时有很好的性能
- LinkedHashSet不允许集合元素重复。
- LinkedHashSet集合添加元素过程
package javase13;


import org.junit.Test;

import java.util.Iterator;
import java.util.LinkedHashSet;
import java.util.Set;


public class Collection5 {
    @Test
    public void test1() {
        Set set = new LinkedHashSet();
        set.add(456);
        set.add(123);
        set.add(123);
        set.add("AA");
        set.add("CC");
        set.add(new User("Tom",12));
        set.add(new User("Tom",12));
        set.add(129);


        Iterator iterator = set.iterator();
        while(iterator.hasNext()){
            System.out.println(iterator.next());
        }

        /*
        456
        123
        AA
        CC
        User{name='Tom', age=12}
        129
        */
    }
}

class User{
    private String name;
    private int age;

    public User() {
    }

    public User(String name, int age) {
        this.name = name;
        this.age = age;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public int getAge() {
        return age;
    }

    public void setAge(int age) {
        this.age = age;
    }

    @Override
    public String toString() {
        return "User{" +
                "name='" + name + '\'' +
                ", age=" + age +
                '}';
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;

        User user = (User) o;

        if (age != user.age) return false;
        return name != null ? name.equals(user.name) : user.name == null;
    }

    @Override
    public int hashCode() { //return name.hashCode() + age;
        int result = name != null ? name.hashCode() : 0;
        result = 31 * result + age;
        return result;
    }
}
TreeSet的两种排序方式
TreeSet的自然排序
- TreeSet集合只能存同一种类型的对象,因为TreeeSet可以指定根据对象的属性来对集合里的所有对象进行排序,查询速度比List快。
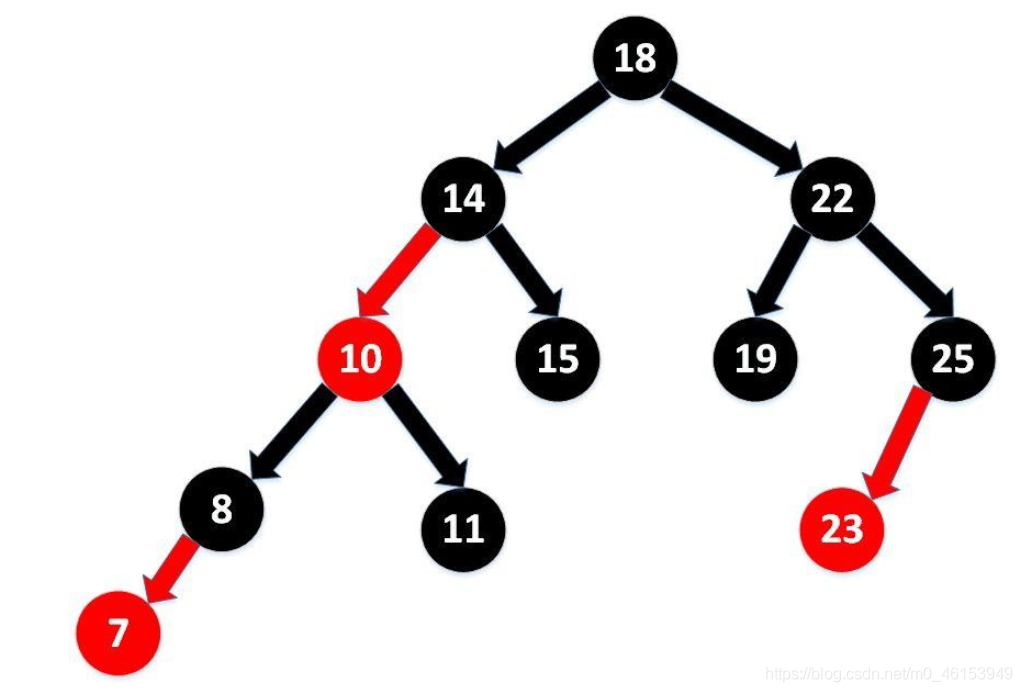
TreeSet是SortedSet接口的实现类,TreeSet可以确保集合元素处于排序状态。TreeSet底层使用红黑树结构存储数据- 新增的方法如下:(了解)
Comparator comparator()Object first()Object last()Object lower(Object e)Object higher(Object e)SortedSet subSet(fromElement, toElement)SortedSet headSet(toElement)SortedSet tailSet(fromElement)
TreeSet两种排序方法:自然排序和定制排序。默认情况下,TreeSet采用自然排序。TreeSet和后面要讲的TreeMap采用红黑树的存储结构- 特点:有序,查询速度比
List快 - 自然排序:
TreeSet会调用集合元素的compareTo(Object obj)方法来比较元素之间的大小关系,然后将集合元素按升序(默认情况)排列。 - 如果试图把一个对象添加到TreeSet时,则该对象的类必须实现Comparable 接口。
- 实现
Comparable的类必须实现compareTo(Object obj)方法,两个对象即通过compareTo(Object obj)方法的返回值来比较大小
- 实现
Comparable的典型实现:BigDecimal、BigInteger以及所有的数值型对应的包装类:按它们对应的数值大小进行比较Character:按字符的unicode值来进行比较Boolean:true 对应的包装类实例大于false 对应的包装类实例String:按字符串中字符的unicode 值进行比较Date、Time:后边的时间、日期比前面的时间、日期大
向TreeSet中添加元素时,只有第一个元素无须比较compareTo()方法,后面添加的所有元素都会调用compareTo()方法进行比较。- 因为只有相同类的两个实例才会比较大小,所以向
TreeSet中添加的只能是同一个类的对象。 - 对于
TreeSet集合而言,它判断两个对象是否相等的唯一标准是:两个对象通过compareTo(Object obj)方法比较返回值。 - 当需要把一个对象放入
TreeSet中,重写该对象对应的equals()方法时,应保证该方法与compareTo(Object obj)方法有一致的结果:如果两个对象通过equals()方法比较返回true,则通过compareTo(Object obj)方法比较应返回0。否则,让人难以理解,因为该集合不存在属性完全相等的对象。 - 定制排序和自然排序中,比较两个对象是否相同的标准为:compareTo()返回0.不再是equals()
- 个人理解总结:在自然排序中,被排序的元素的类需要实现Comparable接口,然后实现compare方法,属性之间具体参数怎么比可以自定义,最终按该方法返回值来排序,也就是说该类已经具备了排序功能
- 红黑树(以BigInteger为例子)
代码演示TreeSet的自然排序
package javase13;


import org.junit.Test;

import java.util.Iterator;
import java.util.TreeSet;

public class Collection6 {
    @Test
    public void test1() {
        TreeSet set = new TreeSet();

        //失败:不能添加不同类的对象,TreeSet集合只能存同一种类型的对象,因为TreeeSet可以指定根据对象的属性来对集合里的所有对象进行排序
//        set.add(123);
//        set.add(456);
//        set.add("AA");//出现"ClassCastException: java.lang.Integer cannot be cast to java.lang.String"编译异常
//        set.add(new User("Tom",12));//同上异常

        //成功案例1:  在Integer包装类型中,根据数的大小来排序
//        set.add(34);
//        set.add(-34);
//        set.add(43);
//        set.add(11);
//        set.add(8);

        //成功案例2: 在User类型中,按照姓名从大到小排列来排序,如果姓名相同,则按照年龄有小到大排序,需要重写User类中的comparable()方法,记住,该集合不存在属性完全相等的对象
        set.add(new User1("Tom",12));
        set.add(new User1("Jerry",32));
        set.add(new User1("Jim",2));
        set.add(new User1("Mike",65));
        set.add(new User1("Jack",33));
        set.add(new User1("Jack",56));

        //迭代集合
        Iterator iterator = set.iterator();
        while(iterator.hasNext()){
            System.out.println(iterator.next());
        }
        /**/
    }
}

//继承Comparable,重写里面的方法
class User1 implements Comparable{
    private String name;
    private int age;

    public User1() {
    }

    public User1(String name, int age) {
        this.name = name;
        this.age = age;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public int getAge() {
        return age;
    }

    public void setAge(int age) {
        this.age = age;
    }

    @Override
    public String toString() {
        return "User1{" +
                "name='" + name + '\'' +
                ", age=" + age +
                '}';
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;

        User1 user1 = (User1) o;

        if (age != user1.age) return false;
        return name != null ? name.equals(user1.name) : user1.name == null;
    }

    @Override
    public int hashCode() { //return name.hashCode() + age;
        int result = name != null ? name.hashCode() : 0;
        result = 31 * result + age;
        return result;
    }

    //设置排序规则:按照姓名从大到小排列,年龄从小到大排列
    @Override
    public int compareTo(Object o) {
        if (o instanceof User1) {
            User1 user1 = (User1) o;
//            return this.name.compareTo(user1.name);  //按照姓名从小到大排列
//            return -this.name.compareTo(user1.name);  //加了负数,按照姓名从大到小排列
            int compare = -this.name.compareTo(user1.name);  //按照姓名从大到小排列
            if(compare != 0){   //年龄从小到大排列
                return compare;
            }else{//因为可能名字有相同的人,这时候又要添加多一个排序规则,按照年龄从小到大排序
                return Integer.compare(this.age,user1.age);
            }
        } else {
            throw new RuntimeException("输入的类型不匹配");
        }
    }
}
TreeSet的定制排序
- TreeSet的自然排序要求元素所属的类实现Comparable接口,如果元素所属的类没有实现Comparable接口,或不希望按照升序(默认情况)的方式排列元素或希望按照其它属性大小进行排序,则考虑使用定制排序。定制排序,通过Comparator接口来实现。需要重写compare(T o1,T o2)方法。
- 利用
int compare(T o1,T o2)方法,比较o1和o2的大小:如果方法返回正整数,则表示o1大于o2;如果返回0,表示相等;返回负整数,表示o1小于o2。 - 要实现定制排序,需要将实现
Comparator接口的实例作为形参传递给TreeSet的构造器,这样创建出来的TreeSet集合不按照类的compareTo(Object o)方法排序,而是根据定制排序。 - 仍然只能向
TreeSet中添加类型相同的对象。否则发生ClassCastException异常。 - 定制排序和自然排序中,比较两个对象是否相同的标准为:compareTo()返回0.不再是equals()
- 个人理解总结:在定制排序中,需要通过匿名内部类的方式实现Comparator接口,然后实现compare方法,属性之间具体参数怎么比可以自定义,最终按该方法返回值来排序,然后传入到TreeSet的含参构造中,也就是该TreeSet集合已经具备了排序功能
TreeSet的定制排序代码演示(在Collection6的代码上再补充)
    //定制排序,实现comparator接口,重写compare方法
    @Test
    public void test2() {
        Comparator com = new Comparator() {//Comparator类型的匿名实现类非匿名对象
            //按照年龄从小到大排列
            @Override
            public int compare(Object o1, Object o2) {
                if(o1 instanceof User1 && o2 instanceof User1){
                    User1 u1 = (User1)o1;
                    User1 u2 = (User1)o2;
                    return Integer.compare(u1.getAge(),u2.getAge());
                }else{
                    throw new RuntimeException("输入的数据类型不匹配");
                }
            }
        };

        TreeSet set = new TreeSet(com);//使用代参构造器创建TreeSet集合,参数为Comparator类型的匿名实现类非匿名对象,不按照类的compareTo(Object o)方法排序,而是根据定制排序
        set.add(new User1("Tom",12));
        set.add(new User1("Jerry",32));
        set.add(new User1("Jim",2));
        set.add(new User1("Mike",65));
        set.add(new User1("Mary",33));//如果是age相同,且没有别的条件,那么就遵循先来后到的原则
        set.add(new User1("Jack",33));
        set.add(new User1("Jack",56));


        Iterator iterator = set.iterator();
        while(iterator.hasNext()){
            System.out.println(iterator.next());
        }
        /*
        * User1{name='Jim', age=2}
        * User1{name='Tom', age=12}
        * User1{name='Jerry', age=32}
        * User1{name='Mary', age=33}
        * User1{name='Jack', age=56}
        * User1{name='Mike', age=65}
        * */
    }
}
Set课后两道面试题(List集合去重和Set的底层理解)
package javase13;

import org.junit.Test;

import java.util.ArrayList;
import java.util.HashSet;
import java.util.List;

public class Collection7 {
    //取出List集合里面的重复数据
    @Test
    public void test1(){
        List list1 = new ArrayList();
        list1.add(new Integer(1));
        list1.add(new Integer(2));
        list1.add(new Integer(2));
        list1.add(new Integer(4));
        list1.add(new Integer(4));
        List list2 = removeDuplicateList(list1);
        System.out.println("list2:"+list2);
    }

    //设置利用set集合去除List集合里面的重复数据方法
    public static List removeDuplicateList(List list) {
        HashSet set = new HashSet();
        set.addAll(list);
        System.out.println("set:"+set);
        return new ArrayList(set);//ArrayList(Collection<? extends E> c),构造一个包含指定集合元素的列表,按集合的迭代器返回元素的顺序排列
    }

    @Test
    public void test3(){
        HashSet set = new HashSet();
        Person1 p1 = new Person1(1001,"AA");
        Person1 p2 = new Person1(1002,"BB");

        //此时的p1、p2是根据现在的属性值计算获得的hash值来指定存放在HashSet集合的位置
        set.add(p1);
        set.add(p2);
        System.out.println(set);//[Person1{id=1002, name='BB'}, Person1{id=1001, name='AA'}]

        p1.name = "CC";//改变HashSet存放的p1的name属性
        set.remove(p1);//底层通过id=1001,name="CC"这两个属性换算的hash值来找索引,很大可能是找不到的当初的数据.
        System.out.println(set);//[Person1{id=1002, name='BB'}, Person1{id=1001, name='CC'}]
        set.add(new Person1(1001,"CC"));//底层通过id=1001,name="CC"这两个属性换算的hash值来找索引存放该对象,和p1不冲突,因为p1是根据id=1001,name="AA"存放的
        System.out.println(set);//[Person1{id=1002, name='BB'}, Person1{id=1001, name='CC'}, Person1{id=1001, name='CC'}]
        set.add(new Person1(1001,"AA"));//HashSet是链表+数组,新进来的属性hash值是相同的,但是equals不相同,因此在JDK1.8中,新来的对象存放在p1下面链表并且被p1指向
        System.out.println(set);//[Person1{id=1002, name='BB'}, Person1{id=1001, name='CC'}, Person1{id=1001, name='CC'}, Person1{id=1001, name='AA'}]

    }
}

class Person1 {

    int id;
    String name;

    public Person1(int id, String name) {
        this.id = id;
        this.name = name;
    }

    public Person1() {

    }

    @Override
    public String toString() {
        return "Person1{" +
                "id=" + id +
                ", name='" + name + '\'' +
                '}';
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;

        Person1 person = (Person1) o;

        if (id != person.id) return false;
        return name != null ? name.equals(person.name) : person.name == null;
    }

    @Override
    public int hashCode() {
        int result = id;
        result = 31 * result + (name != null ? name.hashCode() : 0);
        return result;
    }
}
关于obj类,重写equals一定要重写hashcode原因
重写hashCode() 方法的基本原则
- 在程序运行时,同一个对象多次调用
hashCode()方法应该返回相同的值 - 当两个对象的
equals()方法比较返回true时,这两个对象的hashCode()方法的返回值也应相等。 - 对象中用作
equals()方法比较的Field属性时,也要用Field属性计算得出hashCode值。 - 查看重写的代码,不重写默认就是使用Object类的hashCode(),根据对象地址值来生成hashcode
- Arrays.hashCode(values)方法有31的原因:
- 选择系数的时候要选择尽量大的系数。因为如果计算出来的hash地址越大,所谓的“冲突”就越少,查找起来效率也会提高。(减少冲突)
- 并且31只占用5bits,相乘造成数据溢出的概率较小。
- 31可以由i*31== (i<<5)-1来表示,现在很多虚拟机里面都有做相关优化。(提高算法效率)
- 31是一个素数,素数作用就是如果我用一个数字来乘以这个素数,那么最终出来的结果只能被素数本身和被乘数还有1来整除!(减少冲突)
public static int hash(Object... values) {
        return Arrays.hashCode(values);
    }


-->


    public static int hashCode(Object a[]) {
        if (a == null)
            return 0;

        int result = 1;

        for (Object element : a)
            result = 31 * result + (element == null ? 0 : element.hashCode());

        return result;
    }


-------->


public native int hashCode();
重写equals() 方法的基本原则
- 当一个类有自己特有的“逻辑相等”概念,当改写equals()的时候,总是要改写hashCode(),根据一个类的equals方法(改写后),两个截然不同的实例有可能在逻辑上是相等的,但是,根据Object.hashCode()方法,它们仅仅是两个对象。
因此,违反了“相等的对象必须具有相等的散列码”。 - 复写
equals方法的时候一般都需要同时复写hashCode方法。通常参与计算hashCode的对象的属性也应该参与到equals()中进行计算。 - 查看重写的equals()代码
    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;
        Person person = (Person) o;
        return age == person.age &&
                Objects.equals(name, person.name);
    }
重写equals一定要重写hashcode总结:
- 假如只重写equals而不重写hashcode,那么Student类的hashcode方法就是Object默认的hashcode方法,由于默认的hashcode方法是根据对象的内存地址经哈希算法得来的,显然此时s1!=s2,故两者的hashcode不一定相等。
- 然而重写了equals,且s1.equals(s2)返回true,根据hashcode的规则,两个对象相等其哈希值一定相等,所以矛盾就产生了,因此重写equals一定要重写hashcode,而且从Student类重写后的hashcode方法中可以看出,重写后返回的新的哈希值与Student的两个属性有关
- 两个对象相等,hashcode一定相等
- 两个对象不等,hashcode不一定不等
- hashcode相等,两个对象不一定相等
- hashcode不等,两个对象一定不等
Map接口
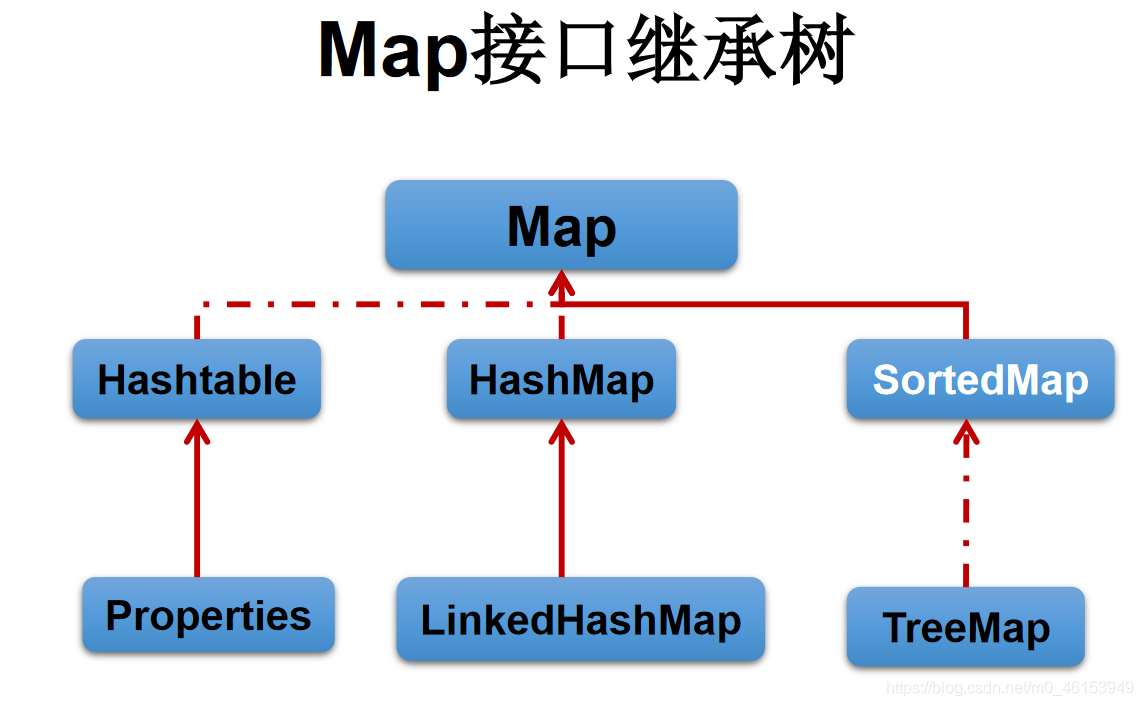
(强调) Map接口及其多个实现类的对比
一、Map的实现类的结构:
* |----Map:双列数据,存储key-value对的数据 ---类似于高中的函数:y = f(x)
* |----HashMap:作为Map的主要实现类;线程不安全的,效率高;存储null的key和value
* |----LinkedHashMap:保证在遍历map元素时,可以按照先进先出的方式遍历,并且效遍历效率比HashMap好。
* 原因:在原有的HashMap底层结构基础上,添加了一对指针,指向前一个和后一个元素。
* 对于频繁的遍历操作,此类执行效率高于HashMap。
* |----TreeMap:保证按照添加的key-value对进行排序,实现排序遍历。此时可以参考之前Set的实现类TreeSet,在TreeMap中会根据key值来自然排序或定制排序
* 底层使用红黑树
* |----Hashtable:作为古老的实现类;线程安全的,因为底层很多方法都用了synchronized修饰,但效率低,且不能存储null的key和value。(后面也不会因为线程安全问题而采用Hashtable这个实现类代替HashMap)
* |----Properties:常用来处理配置文件。key和value都是String类型
*
*
* HashMap的底层:
* 数组+链表 (jdk7及之前)
* 数组+链表+红黑树 (jdk 8)
*
* 面试题:
* 1. HashMap的底层实现原理?
* 2. HashMap 和 Hashtable的异同?
* 3. CurrentHashMap 与 Hashtable的异同?(暂时不讲,涉及到分段锁,多个线程访问不同的共享数据)
Map中存储的key-value的特点
Map与Collection并列存在。用于保存具有映射关系的数据:key-valueMap中的key和value都可以是任何数据类型Map中的key用Set来存放,不允许重复,即同一个Map对象所对应的类,须重写hashCode()和equals()方法- 常用
String类作为Map的“键” key和value之间存在单向一对一关系,即通过指定的key总能找到唯一的、确定的valueMap接口的常用实现类:HashMap、TreeMap、LinkedHashMap和Properties。其中,HashMap是Map接口使用频率最高的实现类
HashMap的底层实现原理
-
HashMap源码中的重要常量
/* * DEFAULT_INITIAL_CAPACITY : HashMap的默认容量,16 * DEFAULT_LOAD_FACTOR:HashMap的默认加载因子:0.75 * threshold:扩容的临界值,=容量*填充因子:16 * 0.75 => 12 * TREEIFY_THRESHOLD:Bucket中链表长度大于该默认值,转化为红黑树:8 * MIN_TREEIFY_CAPACITY:桶中的Node被树化时最小的hash表容量:64 */ -
HashMap中的内部类:Nodestatic class Node<K,V> implements Map.Entry<K,V> { final int hash; final K key; V value; Node<K,V> next;//单向链表 -
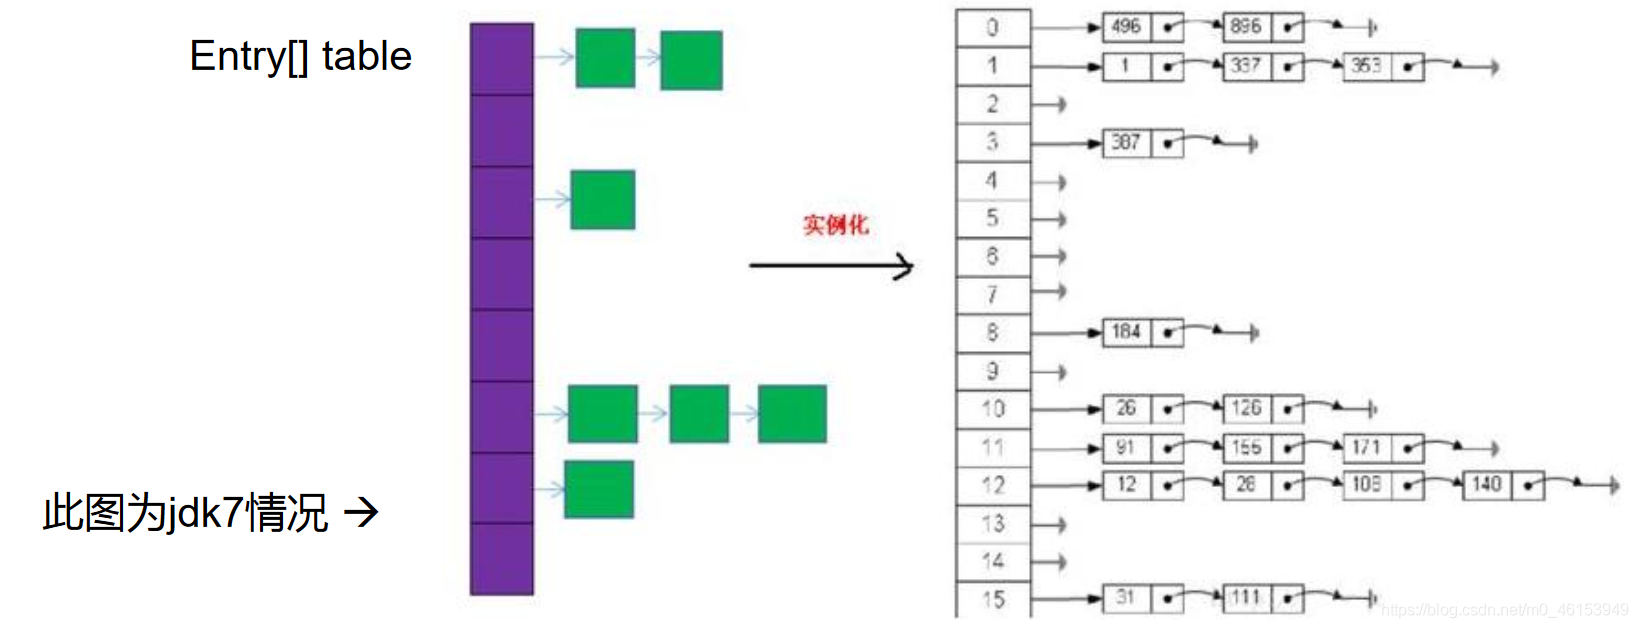
DK 7及以前版本:HashMap是数组+链表结构(即为链地址法)
-
HashMap的内部存储结构其实是数组和链表的结合。当实例化一个HashMap时,系统会创建一个长度为Capacity的Entry[]数组,这个长度在哈希表中被称为容量(Capacity),在这个数组中可以存放元素的位置我们称之为“桶”(bucket),每个bucket都有自己的索引,系统可以根据索引快速的查找bucket中的元素。
- 每个
bucket中存储一个元素,即一个Entry对象,但每一个Entry对象可以带一个引用变量,用于指向下一个元素,因此,在一个桶中,就有可能生成一个Entry链。而且新添加的元素作为链表的head。也就是之前说的"七上八下中的七" - 添加元素的过程:
- 向
HashMap中添加entry1(key,value),需要首先计算entry1中key的哈希值(根据key所在类的hashCode()计算得到),再通过特定的hash()算法计算出此哈希值对于数组种的索引,得到在底层Entry[]数组中要存储的位置i。- 如果位置
i上没有元素,则entry1直接添加成功。 - 如果位置
i上已经存在entry2(或还有链表存在的entry3,entry4),则需要通过遍历的方法,依次比较entry1中key的hash值和其他的entry的hash值。- 如果彼此
hash值不同,则直接添加成功。 - 如果
hash值相同,继续比较二者equals- 如果返回值为
true,则使用entry1的value去替换equals为true的entry的value。 - 如果遍历一遍以后,发现所有的
equals返回都为false,则entry1仍可添加成功。entry1指向原有的entry元素,entry1就作为链表的head(七上八下的七上)。
- 如果返回值为
- 如果彼此
- 如果位置
- 向
-
JDK7 HashMap的扩容
- 提示:当HashMap中的元素越来越多的时候,hash冲突的几率也就越来越高,因为数组的长度是固定的。所以为了提高查询的效率,就要对HashMap的数组进行扩容,而在HashMap数组扩容之后,最消耗性能的点就出现了:原数组中的数据必须重新计算其在新数组中的位置,并放进去,这就是resize(调整数组大小)
- 当HashMap中的元素个数超过数组大小(数组总大小length,不是数组中个数size)*loadFactor时,就会进行数组扩容,loadFactor的默认值(DEFAULT_LOAD_FACTOR)为0.75,这是一个折中的取值。也就是说,默认情况下,数组大小(DEFAULT_INITIAL_CAPACITY)为16,那么当HashMap中元素个数超过16*0.75=12(这个值就是代码中的threshold值,也叫做临界值)的时候,就把数组的大小扩展为2*16=32,即扩大一倍,然后重新计算每个元素在数组中的位置。而这是一个非常消耗性能的操作。所以如果我们已经预知HashMap中元素的个数,那么预设元素的个数能够有效的提高HashMap的性能。
-
图示
-
-
JDK 8版本发布以后:HashMap是数组+链表+红黑树实现。
-
HashMap的内部存储结构其实是数组+链表+红黑树的结合。当实例化一个HashMap时,会初始化initialCapacity和loadFactor属性,在put第一对映射关系时,系统才会创建一个长度为initialCapacity的Node数组,延迟创建节约内存,这个长度在哈希表中被称为容量(Capacity),在这个数组中可以存放元素的位置我们称之为“桶”(bucket),每个bucket都有自己的索引,系统可以根据索引快速的查找bucket中的元素
-
每个bucket中存储一个元素,即一个Node对象,但每一个Node对象可以带一个引用变量next,用于指向下一个元素,因此,在一个桶中,就有可能生成一个Node链。也可能是一个一个TreeNode对象,每一个TreeNode对象可以有两个叶子结点left和right,因此,在一个桶中,就有可能生成一个TreeNode树。而新添加的元素作为链表的last,或树的叶子结点(最是最外边的叶子)。
-
图示
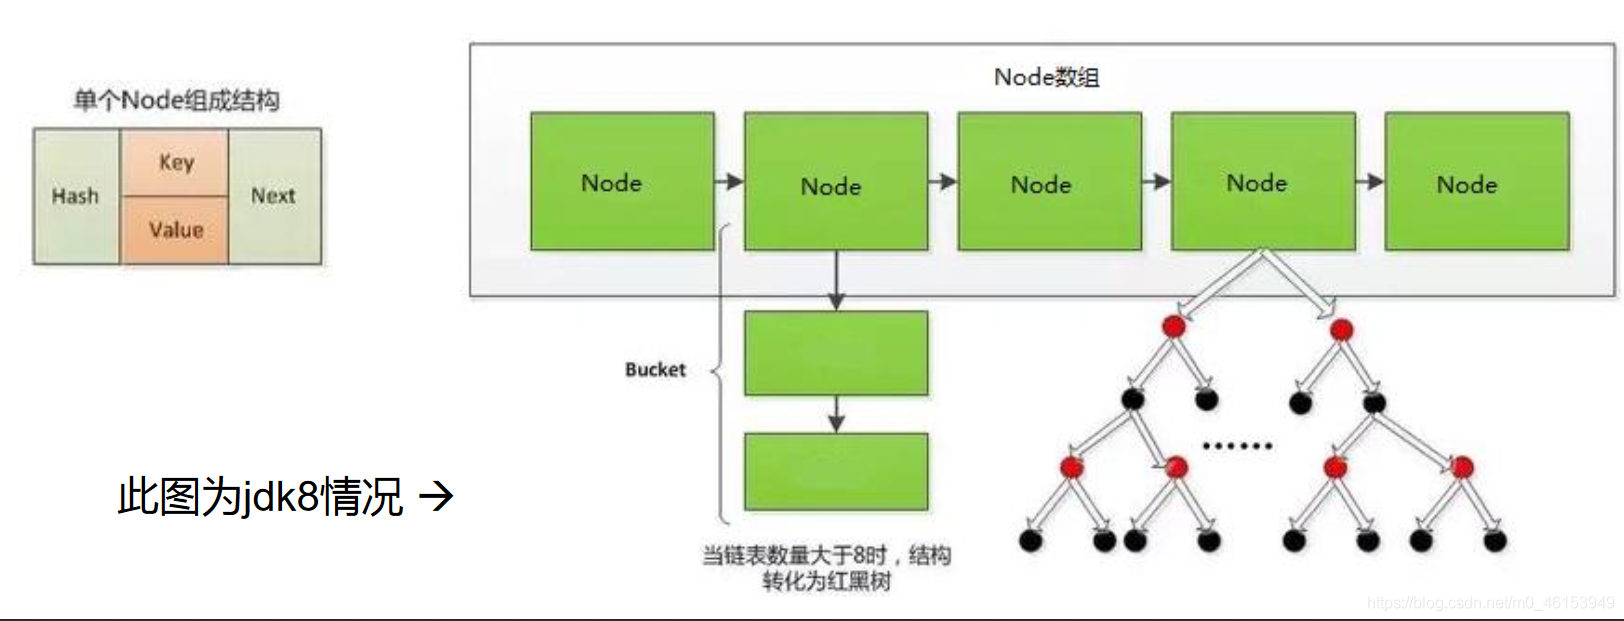
-
JDK8 HashMap的扩容
-
当HashMap中的元素个数超过数组大小(数组总大小length,不是数组中个数size)*loadFactor时,就会进行数组扩容,loadFactor的默认值(DEFAULT_LOAD_FACTOR)为0.75,这是一个折中的取值。也就是说,默认情况下,数组大小(DEFAULT_INITIAL_CAPACITY)为16,那么当HashMap中元素个数超过16*0.75=12(这个值就是代码中的threshold值,也叫做临界值)的时候,就把数组的大小扩展为2*16=32,即扩大一倍,然后重新计算每个元素在数组中的位置,而这是一个非常消耗性能的操作,所以如果我们已经预知HashMap中元素的个数,那么预设元素的个数能够有效的提高HashMap的性能。
-
在JDK8中,当HashMap中的其中一个链的对象个数如果达到了8个,此时如果capacity没有达到64,那么HashMap会先扩容解决,如果已经达到了64,那么这个链会变成红黑树,结点类型由Node变成TreeNode类型。当然,如果当映射关系被移除后,下次resize调整数组大小方法时判断树的结点个数低于6个,也会把红黑树再转为链表。
-
-
-
提示:Map中的映射关系的key不要修改,同理:“Set的对象属性也不要修改”
-
映射关系存储到
HashMap中会存储key的hash值,这样就不用在每次查找时重新计算每一个Entry或Node(TreeNode)的hash值了,因此如果已经put到Map中的映射关系,再修改key的属性,而这个属性又参与hashcode值的计算,那么会导致匹配不上。(Set也是同理,可以参考Set两道面试题)
-
-
提示:注意区分Set和Map集合,Set集合是元素一样则添加失败,Map集合元素一样则将元素中的value取代
(总结)jdk8 相较于jdk7在底层实现方面的不同:
- JDK1.8 new HashMap():底层没有创建一个长度为16的数组,首次调用put()方法时,底层才创建长度为16的数组
- JDK1.8 Node[],而非JDK1.7及之前的Entry[]
- jdk7底层结构只有:数组+链表。jdk8中底层结构:数组+链表+红黑树。
- 形成链表时,七上八下(jdk7:新的元素指向旧的元素。jdk8:旧的元素指向新的元素)
- JDK1.8中 当数组的某一个索引位置上的元素以链表形式存在的数据个数 > 8 且当前数组的长度 > 64时,此时此索引位置上的所数据才改为使用红黑树存储。其内部变化是先扩容数组到64,然后链表如果有大于8且当前索引位置下的元素个数大于8时,当前索引位置才会将链表转换成红黑树。下次resize调整数组大小方法时判断树的结点个数低于6个,也会把红黑树再转为链表。
LinkedHashMap的底层实现原理(了解)
-
LinkedHashMap是HashMap的子类 -
在
HashMap存储结构的基础上,使用了一对双向链表来记录添加元素的顺序 -
与
LinkedHashSet类似,LinkedHashMap可以维护Map的迭代顺序:迭代顺序与Key-Value对的插入顺序一致 -
LinkedHashMap中的内部类:Entrystatic class Entry<K,V> extends HashMap.Node<K,V> { Entry<K,V> before, after;//能够记录添加的元素的先后顺序 Entry(int hash, K key, V value, Node<K,V> next) { super(hash, key, value, next); } }
Map中的常用方法
- 添加(修改)
- Object put(Object key,Object value):将指定key-value添加到(或修改)当前map对象中
- void putAll(Map m):将m中的所有key-value对存放到当前map中
- 删除
- Object remove(Object key):移除指定key的key-value对,并返回value
- void clear():清空当前map中的所有数据,将底层的Node数组中的元素引用全部变成null
    public void clear() {
        Node<K,V>[] tab;
        modCount++;
        if ((tab = table) != null && size > 0) {
            size = 0;
            for (int i = 0; i < tab.length; ++i)
                tab[i] = null;
        }
    }
- 查询
- Object get(Object key):获取指定key对应的value
- boolean containsKey(Object key):是否包含指定的key
- boolean containsValue(Object value):是否包含指定的value
- int size():返回map中key-value对的个数
- boolean isEmpty():判断当前map是否为空
- boolean equals(Object obj):判断当前map和参数对象obj是否相等
- 元视图操作方法
- Set keySet():返回所有key构成的Set集合
- Collection values():返回所有value构成的Collection集合
- Set entrySet():返回所有key-value对构成Entry对象的Set集合
- 提示:
-
如果只是获取key,或者value,推荐使用keySet或者values方式
-
如果同时需要key和value推荐使用entrySet
-
如果需要在遍历过程中删除元素推荐使用Iterator
-
如果需要在遍历过程中增加元素,可以新建一个临时map存放新增的元素,等遍历完毕,再把临时map放到原来的map中
-
Map中的常用方法代码演示
package javase13;

import org.junit.Test;

import java.util.*;

public class Collection8 {
    @Test
    public void test1(){
        Map map = new HashMap();

        //添加
        map.put("AA",123);
        map.put(45,123);
        map.put("BB",56);
        //修改
        map.put("AA",87);

        System.out.println(map);//{AA=87, BB=56, 45=123}

        Map map1 = new HashMap();
        map1.put("CC",123);
        map1.put("DD",456);
        map.putAll(map1);

        System.out.println(map);//{AA=87, BB=56, CC=123, DD=456, 45=123}

        //remove(Object key)
        Object value = map.remove("CC");
        System.out.println(value);
        System.out.println(map);

        //clear()
        map.clear();//与map = null操作不同,将底层的Node数组中的元素引用全部变成null
        System.out.println(map.size());//0
        System.out.println(map);//{}
    }

    @Test
    public void test2(){
        Map map = new HashMap();
        map.put("AA",123);
        map.put(45,123);
        map.put("BB",56);
        // Object get(Object key)获取key对应的value
        System.out.println(map.get(45));//123

        //containsKey(Object key)是否存在这个key
        boolean isExist = map.containsKey("BB");
        System.out.println(isExist);//true

        //containsValue(value)是否UC你在这个value
        isExist = map.containsValue(123);//是否存在这个value
        System.out.println(isExist);//true

        //isEmpty()是否为空
        map.clear();
        System.out.println(map.isEmpty());//true
    }

    @Test
    public void test3(){
        Map map = new HashMap();
        map.put("AA",123);
        map.put(45,1234);
        map.put("BB",56);

        //遍历所有的key集:keySet()
        Set set = map.keySet();
        Iterator iterator = set.iterator();
        while(iterator.hasNext()){
            System.out.println(iterator.next());
        }
        /*
        * AA
        * BB
        * 45
        * */
        System.out.println("*****************");

        //遍历所有的values集:values()
        Collection values = map.values();
        for(Object obj : values){
            System.out.println(obj);
        }
        /*
        * 123
        * 56
        * 1234
        * */
        System.out.println("***************");

        //遍历所有的key-values方式一(推荐使用):
        //Set entrySet():返回所有key-value对构成Entry对象的Set集合
        Set entrySet = map.entrySet();
        System.out.println(entrySet);//[AA=123, BB=56, 45=1234]
        Iterator iterator1 = entrySet.iterator();//获取Set集合的迭代器对象
        while (iterator1.hasNext()){
            Object obj = iterator1.next();//获取存放在set集合的Entry对象
            Map.Entry entry = (Map.Entry) obj;//将Object强转成Map内部类Entry对象
            System.out.println(entry.getKey() + "---->" + entry.getValue());//通过内部类对象的getKey()和getValue获取K V值
            /*
            * AA---->123
            * BB---->56
            * 45---->1234
            * */
        }
        System.out.println("***************");

        //遍历所有的key-values方式二:
        Set keySet = map.keySet();//获取所有的key值
        Iterator iterator2 = keySet.iterator();//通过Set的迭代器对象将Key遍历出来
        while(iterator2.hasNext()){
            Object key = iterator2.next();
            Object value = map.get(key);//通过key获取value值
            System.out.println(key + "=====" + value);
        }
        /*
        * AA=====123
        * BB=====56
        * 45=====1234
        * */
    }


    @Test
    public void test4() {
        Map map = new HashMap();
        map.put("AA", 123);
        map.put(45, 1234);
        map.put("BB", 56);


        Set set = map.entrySet();
        System.out.println(set);//[AA=123, BB=56, 45=1234]
        System.out.println("******************");


        Iterator iterator = set.iterator();
        while(iterator.hasNext()){
            Object next = iterator.next();
            Map.Entry entry = (Map.Entry)next;
            if (entry.getKey().equals(45))iterator.remove();//移除Map集合里面的key为45的元素
        }
        System.out.println(map);//{AA=123, BB=56},key为45的元素已经被移除
    }
}
TreeMap两种添加方式的使用
TreeMap存储Key-Value对时,需要根据key-value对进行排序。TreeMap可以保证所有的Key-Value对处于有序状态。TreeSet底层使用红黑树结构存储数据TreeMap的Key的排序:- 自然排序:
TreeMap的所有的Key必须实现Comparable接口,而且所有的Key应该是同一个类的对象,否则将会抛出ClasssCastException - 定制排序:
创建TreeMap时,传入一个Comparator 对象,该对象负责对TreeMap中的所有key 进行排序。此时不需要Map 的Key实现Comparable 接口
- 自然排序:
TreeMap判断两个key相等的标准:两个key通过compareTo()方法或者compare()方法返回0
TreeMap代码演示
package javase13;

import org.junit.Test;

import java.util.*;

public class Collection9 {
    //自然排序
    @Test
    public void test1() {
        TreeMap map = new TreeMap();
        User2 u1 = new User2("Tom",23);
        User2 u2 = new User2("Jerry",32);
        User2 u3 = new User2("Jack",20);
        User2 u4 = new User2("Jack",21);
        User2 u5 = new User2("Rose",18);

        map.put(u1,98);
        map.put(u2,89);
        map.put(u3,76);
        map.put(u4,100);
        map.put(u5,100);

        Set entrySet = map.entrySet();
        Iterator iterator = entrySet.iterator();
        while (iterator.hasNext()){
            Object next = iterator.next();
            Map.Entry entry = (Map.Entry) next;
            System.out.println(entry.getKey()+"==>"+entry.getValue());//根据名字由大到小排序,名字相同则根据年龄由小到排序
        }
        /*
        * User2{name='Tom', age=23}==>98
        * User2{name='Rose', age=18}==>100
        * User2{name='Jerry', age=32}==>89
        * User2{name='Jack', age=20}==>76
        * User2{name='Jack', age=21}==>100
        * */
    }

    @Test
    public void test2(){
        TreeMap map = new TreeMap(new Comparator() {//使用TreeMap(Comparator<? super K> comparator)构造器生成一个定制排序的map集合
            @Override
            public int compare(Object o1, Object o2) {
                if(o1 instanceof User && o2 instanceof User){
                    User u1 = (User)o1;
                    User u2 = (User)o2;
                    return Integer.compare(u1.getAge(),u2.getAge());//根据年龄由小到大排序
                }
                throw new RuntimeException("输入的类型不匹配!");
            }
        });
        User u1 = new User("Tom",23);
        User u2 = new User("Jerry",32);
        User u3 = new User("Jack",20);
        User u4 = new User("Rose",18);

        map.put(u1,98);
        map.put(u2,89);
        map.put(u3,76);
        map.put(u4,100);

        Set entrySet = map.entrySet();
        Iterator iterator1 = entrySet.iterator();
        while (iterator1.hasNext()){
            Object obj = iterator1.next();
            Map.Entry entry = (Map.Entry) obj;
            System.out.println(entry.getKey() + "---->" + entry.getValue());//根据年龄有小到大排序

            /*
            * User{name='Rose', age=18}---->100
            * User{name='Jack', age=20}---->76
            * User{name='Tom', age=23}---->98
            * User{name='Jerry', age=32}---->89
            * */
        }
    }
}

class User2 implements Comparable{
    private String name;
    private int age;

    public User2() {
    }

    public User2(String name, int age) {
        this.name = name;
        this.age = age;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public int getAge() {
        return age;
    }

    public void setAge(int age) {
        this.age = age;
    }

    @Override
    public String toString() {
        return "User2{" +
                "name='" + name + '\'' +
                ", age=" + age +
                '}';
    }

    @Override
    public boolean equals(Object o) {
        System.out.println("User2 equals()....");
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;

        User2 user = (User2) o;

        if (age != user.age) return false;
        return name != null ? name.equals(user.name) : user.name == null;
    }

    @Override
    public int hashCode() { //return name.hashCode() + age;
        int result = name != null ? name.hashCode() : 0;
        result = 31 * result + age;
        return result;
    }

    //按照姓名从大到小排列,年龄从小到大排列
    @Override
    public int compareTo(Object o) {
        if(o instanceof User2){
            User2 user = (User2)o;
//            return -this.name.compareTo(user.name);
            int compare = -this.name.compareTo(user.name);
            if(compare != 0){
                return compare;
            }else{
                return Integer.compare(this.age,user.age);//否则就根据年龄由小到大排序
            }
        }else{
            throw new RuntimeException("输入的类型不匹配");
        }

    }
}
Hashtable
Hashtable是个古老的Map实现类,JDK1.0就提供了。不同于HashMap,Hashtable是线程安全的。Hashtable实现原理和HashMap相同,功能相同。底层都使用哈希表结构,查询速度快,很多情况下可以互用。- 与
HashMap不同,Hashtable不允许使用null作为key和value - 与
HashMap一样,Hashtable也不能保证其中Key-Value对的顺序,但是HashMap的子类LinkedHashMap和Map的TreeMap实现类可以有特有的顺序 Hashtable判断两个key相等、两个value相等的标准,与HashMap一致。
Properties处理属性文件
Properties类是Hashtable的子类,该对象用于处理属性文件- 由于属性文件里的
key、value都是字符串类型,所以Properties里的key和value都是字符串类型 - 存取数据时,建议使用
setProperty(String key,Stringvalue)方法和getProperty(String key)方法 - 新建jdbc.properties属性文件
- 如果要在jdbc.properties文件中写入为中文,为了防止jdbc.properties出现中文乱码,可在编写配置文件前先设置勾选该如下图选项
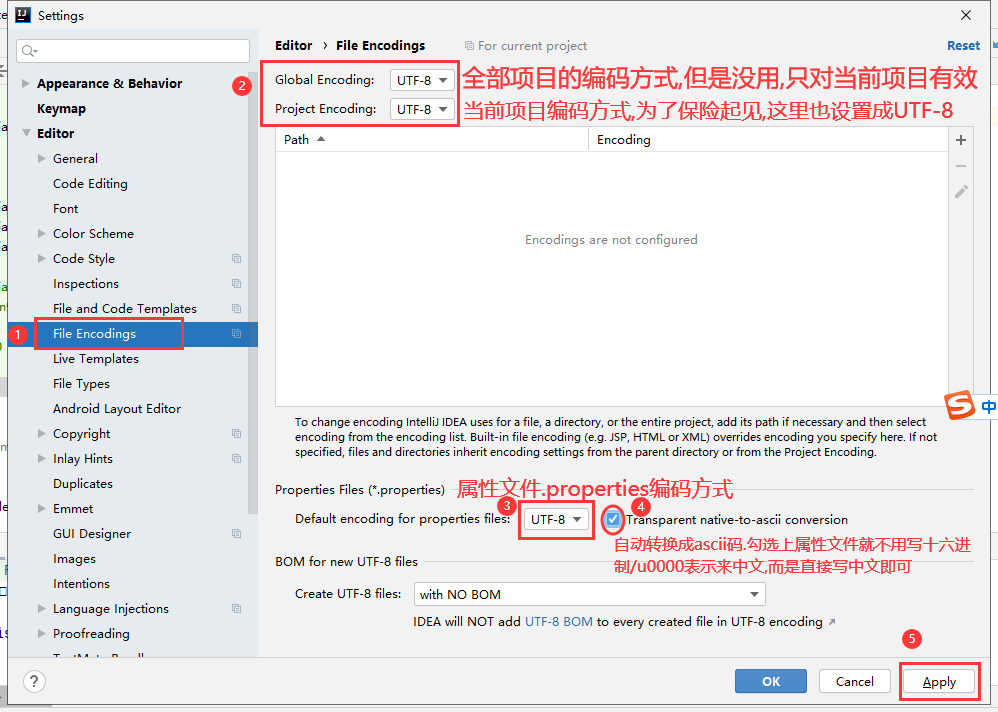
提示:所有在项目里进行的设置都只应用于当前项目,如果要进行全局的设置,需:File -> closeProject 回到初始界面,然后 configure -> settings 进行设置 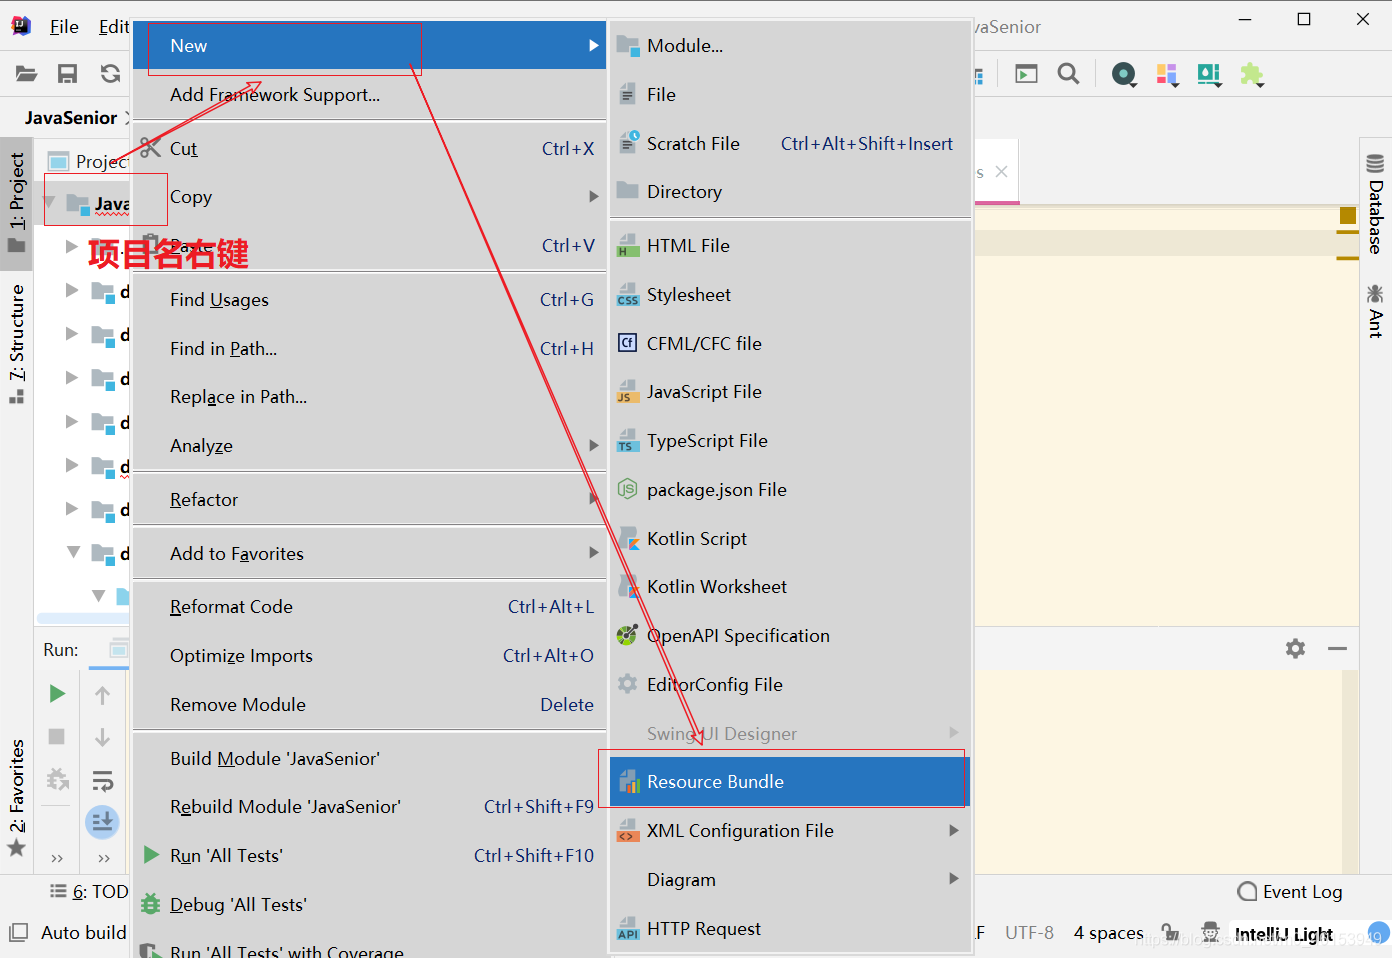
-
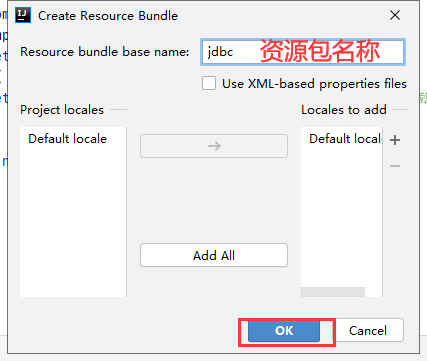
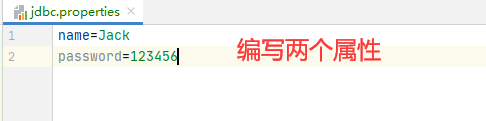
package javase13;

import java.io.FileInputStream;
import java.io.IOException;
import java.util.Properties;


public class Collection11 {
    //Properties:常用来处理配置文件。key和value都是String类型
    public static void main(String[] args){
        //try catch快捷键:ALT+Shift+Z
        FileInputStream fis = null;
        try {
            Properties pros = new Properties();
            fis = new FileInputStream("jdbc.properties");
            pros.load(fis); //加载流对应文件

            String name = pros.getProperty("name");
            String password = pros.getProperty("password");

            System.out.println("name = " + name + ",password = " + password);
        } catch (IOException e) {//捕获IO流可能出现的异常
            e.printStackTrace();
        } finally {
            if(fis != null){
                try {
                    fis.close();//执行必须的关流操作
                } catch (IOException e) {
                    e.printStackTrace();//解决关流的必须解决的异常
                }
            }
        }
    }
}
Collections工具类常用方法
常见的Collections面试题
问:Collection 和 Collections的区别?
答:Collection是集合类的上级接口,继承于他的接口主要有Set 和List.
Collections是针对集合类的一个帮助类,他可以操作Collection、Map的工具类。他提供一系列静态方法实现对各种集合的搜索、排序、线程安全化等操作.
Collections常用方法
- reverse(List):反转 List 中元素的顺序
- shuffle(List):对 List 集合元素进行随机排序
- sort(List):根据元素的自然顺序对指定 List 集合元素按升序排序
- sort(List,Comparator):根据指定的 Comparator 产生的顺序(定制排序)对 List 集合元素进行排序
- swap(List,int i, int j):将指定 list 集合中的索引 i 处元素和索引 j 处元素进行交换
- Object max(Collection):根据元素的自然顺序,返回给定集合中的最大元素
- Object max(Collection,Comparator):根据 Comparator 指定的顺序,返回给定集合中的最大元素
- Object min(Collection):根据元素的自然顺序,返回给定集合中的最小元素
- Object min(Collection,Comparator):根据 Comparator 指定的顺序,返回给定集合中的最小元素
- int frequency(Collection,Object):返回指定集合中指定元素的出现次数
- void copy(List dest,List src):将List(目标)集合src(源)中的内容复制到List集合dest中,源码中可以得知,源比目标元素多就会抛出IndexOutOfBoundsException("Source does not fit in dest")异常。
- boolean replaceAll(List list,Object oldVal,Object newVal):使用新值替换 List 对象的所有旧值。成功替换返回true,否则为false
- List<T> synchronizedList(List<T> list):该方法可使将指定集合包装成线程同步的集合,从而可以解决多线程并发访问集合时的线程安全问题
package javase13;


import org.junit.Test;

import java.util.ArrayList;
import java.util.Arrays;
import java.util.Collections;
import java.util.List;

public class Collection10 {
    @Test
    public void test(){
        List list = new ArrayList();
        list.add(123);
        list.add(43);
        list.add(765);
        list.add(765);
        list.add(765);
        list.add(-97);
        list.add(0);

        System.out.println(list);//[123, 43, 765, 765, 765, -97, 0]

        Collections.reverse(list);//反转List中元素
        System.out.println("reverse:"+list);//reverse:[0, -97, 765, 765, 765, 43, 123]

        Collections.shuffle(list);//随机排序List集合
        System.out.println("shuffle:"+list);//shuffle:[765, 123, 43, 0, 765, 765, -97]

        Collections.sort(list);//自然排序升序,也就是有小到大
        System.out.println("sort:"+list);//sort:[-97, 0, 43, 123, 765, 765, 765]

        Collections.swap(list,1,2);//将指定 list 集合中的索引 i 处元素和索引 j 处元素进行交换
        System.out.println("swap:"+list);//swap:[-97, 43, 0, 123, 765, 765, 765]

        int frequency = Collections.frequency(list, 123);//返回指定集合中指定元素的出现次数
        System.out.println(frequency);//1
    }

    @Test
    public void test2(){
        List list = new ArrayList();
        list.add(123);
        list.add(43);
        list.add(765);
        list.add(-97);
        list.add(0);

        //错误使用void copy(List dest,List src)方法
//        List dest = new ArrayList();
//        dest.addAll(list);
//        System.out.println(dest);
//        Collections.copy(dest,list);//报异常:IndexOutOfBoundsException("Source does not fit in dest"),源不适合目标,源比目标元素多就会抛出该异常
        //错误2
//        List dest = new ArrayList(list.size());
//        System.out.println(dest.size());//0
//        Collections.copy(dest,list);

        //正确使用void copy(List dest,List src)方法
        List dest = Arrays.asList(new Object[list.size()]);//创建一个list.size()大小的全部元素都是null的数组然后转换成List集合,
        System.out.println(dest.size());//5
        Collections.copy(dest,list);//[123, 43, 765, -97, 0],复制成功

        System.out.println(dest);

        /**
         * Collections 类中提供了多个 synchronizedXxx() 方法,
         * 该方法可使将指定集合包装成线程同步的集合,从而可以解决
         * 多线程并发访问集合时的线程安全问题
         */
        //返回的list1即为线程安全的List
        List list1 = Collections.synchronizedList(list);
    }
}
(了解已经弃用的接口)Enumeration
Enumeration接口是Iterator迭代器的“古老版本”- 常用方法
- boolean hasloreElenents():此时枚举是否包含跟多的元素
- nextElenent():如果该枚举对象至少还有一个元素需要提供,则返回该枚举的下一个元素。

 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


