Kmeans(K均值)与Kmeans++和KNN(K近邻)算法比较

机器学习——KNN算法 阅读详情

K-Means介绍

       K-means算法是聚类分析中使用最广泛的算法之一。它把n个对象根据他们的属性分为k个聚类以便使得所获得的聚类满足:同一聚类中的对象相似度较高;而不同聚类中的对象相似度较小。其聚类过程可以用下图表示:


        如图所示,数据样本用圆点表示,每个簇的中心点用叉叉表示。(a)刚开始时是原始数据,杂乱无章,没有label,看起来都一样,都是绿色的。(b)假设数据集可以分为两类,令K=2,随机在坐标上选两个点,作为两个类的中心点。(c-f)演示了聚类的两种迭代。先划分,把每个数据样本划分到最近的中心点那一簇;划分完后,更新每个簇的中心,即把该簇的所有数据点的坐标加起来去平均值。这样不断进行”划分—更新—划分—更新”,直到每个簇的中心不在移动为止。

该算法过程比较简单,但有些东西我们还是需要关注一下,此处,我想说一下”求点中心的算法”

一般来说,求点群中心点的算法你可以很简的使用各个点的X/Y坐标的平均值。也可以用另三个求中心点的的公式:

1)Minkowski Distance 公式 —— λ 可以随意取值,可以是负数,也可以是正数,或是无穷大。
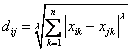
2)Euclidean Distance 公式 —— 也就是第一个公式 λ=2 的情况
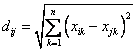
3)CityBlock Distance 公式 —— 也就是第一个公式 λ=1 的情况
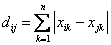
这三个公式的求中心点有一些不一样的地方,我们看下图(对于第一个 λ 在 0-1之间)。
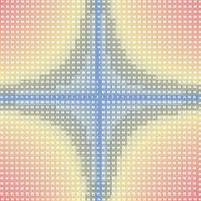
(1)Minkowski Distance (2)Euclidean Distance (3)CityBlock Distance

上面这几个图的大意是他们是怎么个逼近中心的,第一个图以星形的方式,第二个图以同心圆的方式,第三个图以菱形的方式。


Kmeans算法的缺陷

  • 聚类中心的个数K 需要事先给定,但在实际中这个 K 值的选定是非常难以估计的,很多时候,事先并不知道给定的数据集应该分成多少个类别才最合适
  • Kmeans需要人为地确定初始聚类中心,不同的初始聚类中心可能导致完全不同的聚类结果。(可以使用Kmeans++算法来解决)
针对上述第2个缺陷,可以使用Kmeans++算法来解决
K-Means ++ 算法
 k-means++算法选择初始seeds的基本思想就是:初始的聚类中心之间的相互距离要尽可能的远。
  1. 从输入的数据点集合中随机选择一个点作为第一个聚类中心
  2. 对于数据集中的每一个点x,计算它与最近聚类中心(指已选择的聚类中心)的距离D(x)
  3. 选择一个新的数据点作为新的聚类中心,选择的原则是:D(x)较大的点,被选取作为聚类中心的概率较大
  4. 重复2和3直到k个聚类中心被选出来
  5. 利用这k个初始的聚类中心来运行标准的k-means算法
 从上面的算法描述上可以看到,算法的关键是第3步,如何将D(x)反映到点被选择的概率上,一种算法如下:

  1. 先从我们的数据库随机挑个随机点当“种子点”
  2. 对于每个点,我们都计算其和最近的一个“种子点”的距离D(x)并保存在一个数组里,然后把这些距离加起来得到Sum(D(x))。
  3. 然后,再取一个随机值,用权重的方式来取计算下一个“种子点”。这个算法的实现是,先取一个能落在Sum(D(x))中的随机值Random,然后用Random -= D(x),直到其<=0,此时的点就是下一个“种子点”。
  4. 重复2和3直到k个聚类中心被选出来
  5. 利用这k个初始的聚类中心来运行标准的k-means算法

可以看到算法的第三步选取新中心的方法,这样就能保证距离D(x)较大的点,会被选出来作为聚类中心了。至于为什么原因比较简单,如下图 所示:  


      假设A、B、C、D的D(x)如上图所示,当算法取值Sum(D(x))*random时,该值会以较大的概率落入D(x)较大的区间内,所以对应的点会以较大的概率被选中作为新的聚类中心。

k-means++代码:http://rosettacode.org/wiki/K-means%2B%2B_clustering

KNN(K-Nearest Neighbor)介绍

算法思路: 如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别。该方法在定类决策上只依据最邻近的一个或者几个样本的类别来决定待分样本所属的类别。
看下面这幅图:

KNN的算法过程是是这样的:

       从上图中我们可以看到,图中的数据集是良好的数据,即都打好了label,一类是蓝色的正方形,一类是红色的三角形,那个绿色的圆形是我们待分类的数据。

     如果K=3,那么离绿色点最近的有2个红色三角形和1个蓝色的正方形,这3个点投票,于是绿色的这个待分类点属于红色的三角形

     如果K=5,那么离绿色点最近的有2个红色三角形和3个蓝色的正方形,这5个点投票,于是绿色的这个待分类点属于蓝色的正方形

     我们可以看到,KNN本质是基于一种数据统计的方法!其实很多机器学习算法也是基于数据统计的。

     KNN是一种memory-based learning,也叫instance-based learning,属于lazy learning。即它没有明显的前期训练过程,而是程序开始运行时,把数据集加载到内存后,不需要进行训练,就可以开始分类了。

具体是每次来一个未知的样本点,就在附近找K个最近的点进行投票。

再举一个例子,Locally weighted regression (LWR)也是一种 memory-based 方法,如下图所示的数据集。


用任何一条直线来模拟这个数据集都是不行的,因为这个数据集看起来不像是一条直线。但是每个局部范围内的数据点,可以认为在一条直线上。每次来了一个位置样本x,我们在X轴上以该数据样本为中心,左右各找几个点,把这几个样本点进行线性回归,算出一条局部的直线,然后把位置样本x代入这条直线,就算出了对应的y,完成了一次线性回归。也就是每次来一个数据点,都要训练一条局部直线,也即训练一次,就用一次。LWR和KNN很相似,都是为位置数据量身定制,在局部进行训练。


KNN和K-Means的区别

KNN

K-Means

1.KNN是分类算法

2.监督学习

3.喂给它的数据集是带label的数据,已经是完全正确的数据

1.K-Means是聚类算法

2.非监督学习

3.喂给它的数据集是无label的数据,是杂乱无章的,经过聚类后才变得有点顺序,先无序,后有序

没有明显的前期训练过程,属于memory-based learning 有明显的前期训练过程
K的含义:来了一个样本x,要给它分类,即求出它的y,就从数据集中,在x附近找离它最近的K个数据点,这K个数据点,类别c占的个数最多,就把x的label设为c K的含义:K是人工固定好的数字,假设数据集合可以分为K个簇,由于是依靠人工定好,需要一点先验知识


相似点:都包含这样的过程,给定一个点,在数据集中找离它最近的点。即二者都用到了NN(Nears Neighbor)算法,一般用KD树来实现NN。


参考:

1) http://www.yanjiuyanjiu.com/blog/20130225/


一文读懂KNN、Kmeans K最近邻算法 K最近邻(K-Nearest Neighbors,KNN)算法是一种分类算法,也是最简单易懂的机器学习算法。应用场景有字符识别,文本分类,图像识别等领域。该算法的思想是:一个样本与数据中的K个样本最相似,如果这K个样本中的大多数属于某一类别,则该样本也属于这个类别。通常k是不大于20的整数。 说明:KNN没有显示的训练过程,它是“懒惰学习”的代表,它在训练阶段只是把数据保存下来,... 阅读详情

相关推荐

K-means与K-means++

参考: https://blog.youkuaiyun.com/u013129109/article/details/80063111 https://blog.youkuaiyun.com/sorawa/article/details/6630729 https://blog.youkuaiyun.com/u011204487/article/details/59624571 原始k-means算法: 1. K-means算法优点...

National_Committee的博客 1250

KNN算法(k近邻算法)原理及总结

KNN 算法,或者称 k最邻近算法,是有监督学习中的分类算法。它可以用于分类或回归问题,但它通常用作分类算法。

m0_74405427的博客 14万+

总结一下 KNN、K-means 和 SVM【附代码实现】

在机器学习中感觉经常被问的几个算法:K近邻算法(K-Nearest Neighbors, KNN)、K均值聚类算法(K-means)以及支持向量机(Support Vector Machine, SVM)。给自己做个总结笔记,并贴出来,如果有误欢迎指出。

xiaoh_7的博客 2358

KNN算法(一) KNN算法原理

一.KNN算法概述 KNN可以说是最简单的分类算法之一,同时,它也是最常用的分类算法之一,注意KNN算法是有监督学习中的分类算法,它看起来和另一个机器学习算法Kmeans有点像(Kmeans是无监督学习算法),但却是有本质区别的。那么什么是KNN算法呢,接下来我们就来介绍介绍吧。 二.KNN算法介绍 KNN的全称是K Nearest Neighbors,意思是K个最近的邻居,从这个名字我们就能看出一些KNN算法的蛛丝马迹了。K个最近邻居,毫无疑问,K的取值肯定是至关重要的。那么最近的邻居又是怎么回事呢

weixin_45014385的博客 12万+

【AI概念】K均值聚类(K-Means Clustering)与K-近邻算法(KNN)是什麽?有什么区别?机器学习中担任什么角色?|算法流程与数学推导、典型代码实现、工程应用建议|聚类、回归、分类任务

大家好,我是爱酱。本篇将会系统梳理K-Means聚类与K-最近邻(KNN)的定义、核心思想、主要区别、机器学习中的典型应用与工程意义。内容适合初学者和进阶读者,配合公式和对比表格,帮助你一文看懂两大经典算法。 注:本文章含大量数学算式、详细例子说明及大量代码演示,大量干货,建议先收藏再慢慢观看理解。新频道发展不易,你们的每个赞、收藏跟转发都是我继续分享的动力! 爱酱也单独发过K-近邻算法和K均值聚类的单独文章介绍,内容非常深入,并包含大量代码演示跟范例,欢迎大家去看看,加深对这两个算法的了解!

AI人工智能爱酱~你的AI学习好帮手~ 1829

kmeans和knn相同点和不同点:

kmeans和knn相同点和不同点: 一、K最近邻(kNN,k-NearestNeighbor)分类算法,找到最近的k个邻居(样本),在前k个样本中选择频率最高的类别作为预测类别。 步骤: 1)算距离:给定测试对象,计算它与训练集中的每个对象的距离 2)找邻居:圈定距离最近的k个训练对象,作为测试对象的近邻 3)做分类:根据这k个近邻归属的主要类别,来对测试对象分类 二、K-Means算法...

cranberrycookie的博客 7349

Kmeans算法与KNN算法的区别

转载自:https://www.cnblogs.com/peizhe123/p/4619066.html 最近研究数据挖掘的相关知识,总是搞混一些算法之间的关联,俗话说好记性不如烂笔头,还是记下了以备不时之需。 首先明确一点KNN与Kmeans的算法的区别: 1.KNN算法是分类算法,分类算法肯定是需要有学习语料,然后通过学习语料的学习之后的模板来匹配我们的测试语料集,将测试语料集合进行按照预先学...

千人斩的博客 1万+

kmeans聚类和knn聚类的区别

K-Means是 “无监督的聚类工具”:用 K 个中心将数据 “抱团”,解决 “数据如何分组” 的问题。KNN是 “监督的预测工具”:用 K 个邻居的 “意见” 判断新样本的标签,解决 “新样本属于哪类” 的问题。理解二者的关键是区分无监督聚类(无标签)和监督预测(有标签)的本质差异,避免因名称中都有 “K” 而混淆。

mayaohao的博客 1096

K近邻算法(KNN)&&K-means聚类算法

1.思想: 初始随机给定K(超参数)个簇中心,这K个簇中心是在样本点中随机选择。 按照最邻近原则把待分类的样本点分到各个簇。 划分完成后按平均法重新计算各个簇的质心,从而在确定新的簇心。 一直迭代,直到簇心的移动距离小于某个给定的值。 2.k-means算法评价准则:误差平方和准则,误差平方和达到最优(小)时,可以使类内尽可能紧凑,聚类之间尽可能分开。 loss损失:是一个非凸函数,所以有许多最小值,不一定每次都能落到全局最优,有可能落到局部最优。 k:簇的个数 Ci:某个簇

h2728677716的博客 5054

斯坦福HumanPlus机器人核心技术解析:从HST强化学习框架到HIT模仿学习的实现路径

本文深入解析了斯坦福HumanPlus人形机器人的核心技术实现路径。其核心在于HST强化学习框架与HIT模仿学习架构的协同:HST作为“小脑”,通过rsl_rl框架在仿真中训练稳健的低级运动控制;HIT作为“大脑”,基于改进的Transformer架构学习高级任务规划。文章详细拆解了从算法原理、代码实现到硬件部署的全流程,为复现这一前沿机器人系统提供了实战指南。

weixin_29082143的博客 281

System Verilog学习笔记(十九)——覆盖率

覆盖率是用来衡量验证精度和完备性的数据指标。也可以告诉我们在仿真时设计的哪些结构被触发,哪些没被触发。高质量的验证需要满足以下三个条件。

ljy77882333的博客 2142

Kmeans、Kmeans++和KNN算法比较

K-means介绍 K-means算法是聚类分析中使用最广泛的算法之一。它把n个对象根据他们的属性分为k个聚类以便使得所获得的聚类满足:同一聚类中的对象相似度较高;而不同聚类中的对象相似度较小。

明镜止水的博客 2641

set_data_check专题[使用,report_timing,setup/hold检查]

set_data_check用于约束『数据-对-数据』的『建立保持』时间检查,通常被称为非时序约束 ( non-sequential constraints ), 理论上set_data_check 可以设在任意的两个data pin 上,其中一个pin 称为 constrained pin 类似于寄存器的data pin, 另一个pin 称为related pin 类似于寄存器的clock pin.

cy413026的博客 1万+

K-means和K近邻算法详解

本文介绍了K-means和KNN两种机器学习算法。K-means是一种无监督聚类算法,通过迭代更新簇中心将数据划分为K个簇,并介绍了K值选择的肘部法、轮廓系数等方法。KNN是一种监督学习算法,通过计算样本距离进行分类预测,并讨论了K值选择对模型的影响。文章还提供了两种算法的Python实现代码,包括数据集处理、模型训练和评估指标计算。最后通过可视化展示了聚类结果。

weixin_75248215的博客 1688

基于STM32L4XX、HAL库的RTL8201F 以太网收发器(PHY)驱动程序设计

define PHY_RESET_DELAY 1000 // PHY复位延迟(ms)#define PHY_AUTONEGO_DELAY 3000 // 自动协商延迟(ms)/* 检查PHY ID (RTL8201F的ID为0x001CC816) *//* 系统时钟配置,确保ETH有50MHz时钟 *//* 初始化CPU, AHB和APB总线时钟 */

zhusl6688的博客 808

使用强化学习快速让AI学会玩贪食蛇游戏(轻量级二十分钟训练+代码)

如何让AI玩会贪食蛇,甚至比你厉害概述构建问题(强化学习求解的一般步骤)环境动作定义状态定义奖励设计训练奖励值收敛图效果代码 概述 所用技术:强化学习(Deep Reinforcement Learning),属于一种无监督学习,利用奖励rewardrewardreward教会智能体AgentAgentAgent在合适的场景做合适的决策。 采用算法:试过两种算法D3QN和离散版本的PPO算法,最终采用离散版本PPO算法+GAE(PPO是我用过的性能最好的算法之一) 编程语言与深度学习框架:Python3.

ZYunfei的博客 2万+

KNN 与KMEANS算法

KNN算法 k近邻(KNN)是一种基本分类与回归方法。 其思路如下: 给一个训练数据集和一个新的实例,在训练数据集中找出与这个新实例最近的k 个训练实例,然后统计最近的k 个训练实例中所属类别计数最多的那个类,就是新实例的类。 它的特点是完全跟着数据走,没有数学模型可言。 其流程如下所示: 1、计算训练样本和测试样本中每个样本点的距离(常见的距离度量有欧式距离,马氏距离等); 2、对上面所有的距离值进行排序; 3、选前k 个最小距离的样本; 4、根据这k 个样本的标签进行投票,得到最后的分类类

weixin_36378508的博客 2770

【半导体工业实战】C#.NET开发SECS/GEM协议上位机(完整可运行源码+全进制转换工具类+工业级通信封装)

在半导体这个高精尖的工业领域,SECS/GEM协议是设备通信的基石,而C#.NET凭借其稳定性、高效的字节处理能力、Windows工控机的深度适配,成为SECS上位机开发的最优选择。本文从半导体行业的专属认知出发,提供了完整的进制转换工具类、工业级的SECS通信封装、实战的报文解析与业务调用示例、半导体专属的避坑指南,所有内容均为真实项目经验的沉淀,无空洞理论、无AI冗余文字,所有源码均可直接编译运行、无缝移植到半导体项目中。半导体工控开发的核心,从来不是炫技,而是。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 897

【Python机器学习】2.2. 聚类分析算法理论:K均值聚类(KMeans Analysis)、KNN(K近邻分类)、均值漂移聚类(MeanShift)

K均值算法是以空间中K个点为中心进行聚类,对最靠近他们的对象归类,是聚类算法中最为基础但也最为重要的算法

A Rookie in San Domenico School 1773

Jetson Nano之CSI摄像头操作方法

jetson端csi摄像头的应用方法

ZONGXP的博客 1万+

2026年全国青少年信息素养大赛算法应用主题赛(C++赛项复赛模拟卷1:文末附答案)

2026年全国青少年信息素养大赛算法应用主题赛(C++赛项复赛模拟卷1:文末附答案)

王老师青少年编程 1613

模型比较:K近邻与KMeans

1.背景介绍 随着数据量的增加,人工智能技术的发展越来越快,我们需要更高效、更准确的算法来处理和分析这些数据。在机器学习领域,我们经常会遇到不同类型的算法,这篇文章我们将关注两种常见的算法:K近邻(K-Nearest Neighbors)和K均值聚类(K-Means Clustering)。这两种算法在处理不同类型的问题时有不同的优缺点,我们将深入探讨它们的原理、算法和应用。 2.核心概念与联...

AI天才研究院 794

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

机器学习——k-近邻算法、K-均值算法、PCA、异常检测算法、上限分析

K Nearest Neighbor算法⼜叫KNN算法,这个算法是机器学习⾥⾯⼀个⽐较经典的算法如果⼀个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的⼤多数属于某⼀个类别,则该样本也属于这个类别。d=∑i=1n(x1i−x2i)2d = \sqrt{\sum_{i=1}^n(x_{1i}- x_{2i})^2}d=∑i=1n​(x1i​−x2i​)2​ 二、K-均值算法(K Means) K-均值算法是一种聚类算法,同时也是非监督学习的算法。它首先随机生成几个聚类中心,然后在每次递归时实现簇分

胡图图不糊涂的博客 1481

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

k近邻算法_面试|k近邻(KNN)算法与k均值(kmeans)聚类算法有何不同?

1 K近邻是一种用于分类的有监督学习算法;K均值是一种用于聚类的无监督学习算法。2 通过可视化理解K近邻和K均值的差异。K近邻算法可视化K均值算法可视化3 KNN是监督学习算法,意味着训练数据集需要有label或者类别,KNN的目标是把没有标签的数据点(样本)自动打上标签或者预测所属类别。Kmeans是无监督学习算法,意味着数据集没有label,它根据无label的数据点和事先设定的超参...

weixin_39973410的博客 3450

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

机器学习(一)KNN与Kmeans总结

机器学习(一)KNN与Kmeans总结 一. 关于KNN算法(K近邻算法) 1.算法介绍: 如果一个样本在特征空间中的K个最相似(即特征空间中最近邻)的样本中的大多数属于一个类别,则这个样本也属于这个类别。 2.算法要点 a) K值的选择:K值的选择会对结果产生重大影响。较小的K值可以减少近似误差,但是会增加估计误差;较大的K值可以减少估计误...

hua111hua的博客 706
上一篇: python异常处理try...except
下一篇: str和repr的区别
Kola_Abner
博客等级 码龄14年 27粉丝 19原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值