


使用 CLIP 对食物图像进行基于文本的图像编辑
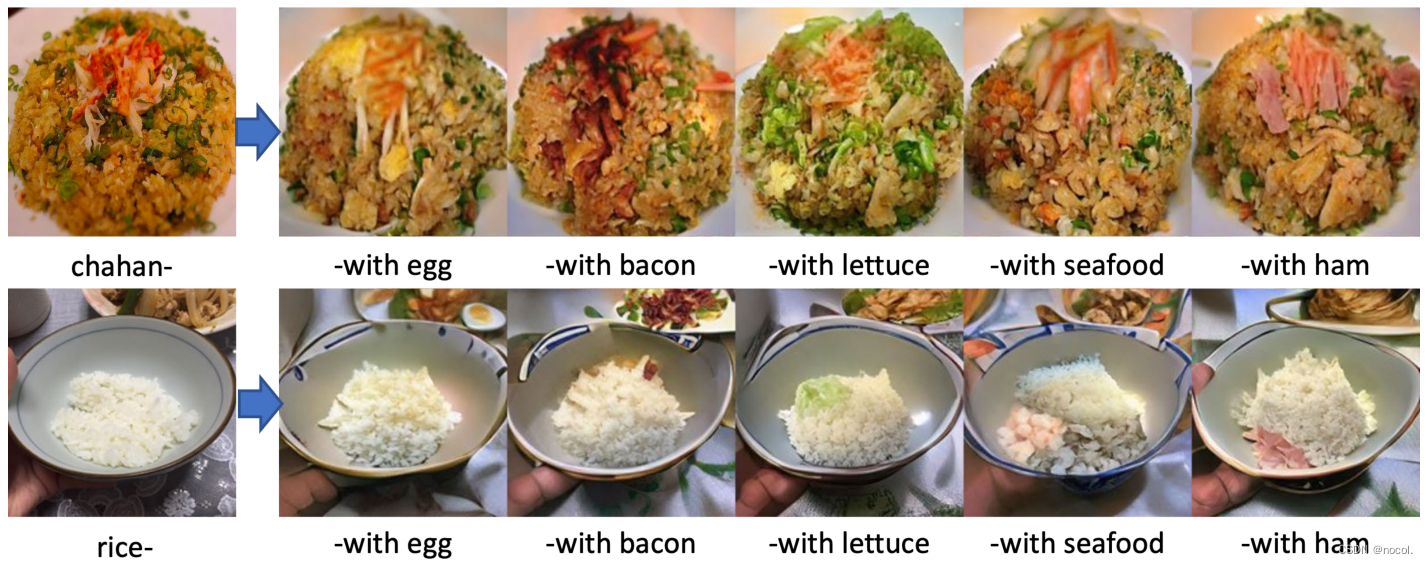
图1:通过文本对食品图像进行处理的结果示例。最左边一栏显示的是原始输入图像。"Chahan"(日语中的炒饭)和 "蒸饭"。左起第二至第六列显示了VQGAN-CLIP所处理的图像。每个操作中使用的提示都是将食物名称和 "与 "一个配料名称结合起来。例如,第二列中的两幅图像分别是用提示语 "chahan with egg "和 "rice with egg "生成的。
摘要
最近,大规模的语言-图像预训练模型,如CLIP,由于其对各种任务,包括分类和图像合成的显著能力而引起了广泛的关注。CLIP和GAN的组合可用于基于文本的图像处理和基于文本的图像合成。迄今为止,已经提出了几个CLIP和GAN的组合模型。然而,它们在食品图像领域的有效性还没有得到全面的研究。在本文中,我们报告了使用VQGANCLIP进行基于文本的食品图像处理的实验结果,并讨论了通过文本进行食品图像处理的可能性。
关键词
基于文本的图像处理,食物图像处理,语言图像预训练模型,CLIP
1 介绍
随着智能手机和社交媒体的发展,人们在互联网上发布了各种照片。其中,最常张贴的照片之一是吃饭。漂亮的、巨大的、古怪的饭菜照片在一年中很容易成为社交媒体上的一个话题。一些餐馆发布许多好看的照片,通过成为社交媒体上的潮流来增加他们的销售额。
拍摄一张看起来美味或新奇的照片需要很多试错过程。拍完照片后,他们经常使用先进的图像编辑软件进行编辑。这种软件需要高水平的操作技能或知识
从2014年的GAN开始,用深度神经网络编辑图像的技术在计算机视觉领域有了显著的发展。在这种演变中,使用自然语言的图像编辑,如ManiGAN和StyleCLIP,作为一种新的图像编辑方式引起了人们的注意,因为它们不需要特殊的技能或知识进行编辑。然而,这些模型大多没有被应用于食品图像,主要应用于人脸和动物图像。
此外,大规模语言图像预训练模型,如 CLIP,最近因其在分类和图像合成等各种任务中出色的zero-shot能力而备受关注。 CLIP 和 GAN 的结合可以用于基于文本的图像处理和基于文本的图像合成。几个结合CLIP和GAN的模型已经被提出,如StyleCLIP和StyleGAN-NADA。这些方法可以在不训练操纵模型的情况下操纵带有文本的图像。这是可能的,因为 CLIP 接受了 4 亿对文本和图像的训练,并且它了解语言和视觉之间的关系。
然而,它们在食品图像领域的有效性尚未得到全面检验。本文通过许多实验检验了基于文本的食物图像处理的可能性。作为图像处理方法,我们使用了 VQGANCLIP 。结果,我们证实了在食品领域使用 CLIP 进行基于文本的图像处理的有效性。
2 相关工作
自然语言图像编辑模型有两种主要类型:
一种是从头开始学习图像-文本对的模型。另一种是使用预先训练的视觉语言模型的模型
ManiGAN,它学习图像-文本对,包含一个新的文本-图像仿生组合模块和一个细节校正模块。这个GAN通过文本生成转换为指定颜色或纹理的图像。细节校正模块可以提高在编辑细节时保持不相关部分的性能。TediGAN是使用预先训练好的StyleGAN的模型。它有一个相似性模块,通过将图像和文本映射到相同的潜在空间来学习它们之间的相似性。使用在面部图像上训练的StyleGAN,TediGAN不需要生成器的GAN训练时间。然而,这个GAN限制了生成图像的面部领域。从头开始学习图像-文本对的模型需要大量的训练时间和带有文本的图像,限制了编辑的图像类型和操作。
最近的编辑模型经常使用预先训练好的视觉语言模型的文本编码器和图像编码器。特别是,CLIP是最常见的作为预训练的视觉语言模型。CLIP在从互联网上收集的4亿个图像-文本对数据上进行训练。虽然从头开始训练的模型有有限的训练和狭窄的语言-视觉特征,但CLIP有相当大的训练量和全面的语言-视觉特征。因此,它已被应用于各种计算机视觉任务,如图像分类、检测、分割、VQA和图像合成。
StyleCLIP通过结合StyleGAN(图像生成中的典型GAN)和CLIP,提出了三种编辑潜空间的方法来操纵图像。有几篇论文研究了通过操纵StyleGAN的潜空间进行图像编辑。然而,这些都是在语义监督下学习的,或者需要人类指导。在本文中,CLIP自动进行这种指导。Paint by Word是一个部分图像编辑模型,它结合了StyleGAN和使用掩码的CLIP。很少有研究能改变图像的某一部分而保留背景。这个模型可以通过编辑真实图像中StyleGAN的潜伏代码w来编辑掩码中的特定部分。然而,本研究使用StyleGAN和BigGAN,它们是专门用于卧室和鸟类的GAN或通用GAN,而不是专门用于膳食。在我们的研究中,我们在膳食领域使用了经过训练的VQGAN的zˆ。我们研究的最终目的是创建一个专门用于食物的图像和文本的图像编辑模型。因此,我们使用了VQGAN-CLIP,并在一组膳食图像和文本上对它们进行了训练。我们还研究了屏蔽功能,该功能只操作图像的一部分,以方便编辑,正如他们所想的那样。
3 方法
3.1 图像操纵模型
我们用于食品图像编辑的模型是VQGAN-CLIP。通过使用VQGAN进行图像生成部分,它可以通过网格(grid)控制图像。此外,它将使用CNN学习图像组件的词汇,并使用Transformer学习它们的组成。此外,这个模型可以生成高质量的图像。CLIP可以计算出任何语言-视觉特征和图像与文本之间的相似性,而且精确度很高。在传统的图像编辑模型中,模型架构往往将文本固定在语法形式上进行训练。然而,CLIP来自互联网的训练数据,允许各种语法形式,可以处理模糊的文本。这项研究使用了CLIP,因为自然文本编辑需要理解这种模糊的文本。
我们研究了VQGAN-CLIP,它在饭菜图像上训练VQGAN和CLIP,而不是像ImageNet这样的一般数据集,这是否对饭菜特征具有鲁棒性。
3.2 结构
VQGAN-CLIP的结构如图2所示。
首先,对输入图像 进行调整,得到调整后的图像
 。然后,调整后的图像
 输入到VQGAN的编码器,生成初始潜伏向量
 。请注意,
 是VQGAN的编码簿的维数.接下来,潜伏向量
 被输入到VQGAN的解码器,而输出图像
 和输入提示t被输入到CLIP编码器。这些给出了图像标记I和文本标记T,而CLIP计算出了损失。然后,损失函数通过梯度下降法更新潜在向量。最后,潜向量被钳制在VQGAN编码簿的最大值和最小值之间,潜向量被更新。因此,更新的潜向量被再次输入到VQGAN的解码器,输入到计算损失的CLIP,并重复更新潜向量。
请注意,VQGAN的潜在向量是分配给每个方格ℎ × w的向量 。该模型可以通过这个来限制编辑范围。公式1显示了通过使用
 来计算潜向量的梯度。掩码
 中的1表示是可操纵的网格,0表示不是可操纵的图像。在计算潜伏向量
 的梯度时,本研究计算它们的元素相乘,使未改变的网格的梯度成为零。如果我们有一个与输入尺寸相同的遮罩图像,那么遮罩图像就会被缩小,并被转换为适合网格遮罩。


图2:用于食品图像处理的VQGAN-CLIP架构。我们用食品数据集对VQGAN和CLIP进行专业化训练。VQGAN编码器从输入图像制作一个潜伏向量。从潜伏向量,VQGAN解码器做出一个初始的编辑图像。之后,CLIP计算损失与提示。该损失优化了潜伏向量。这种模式反复迭代,得到编辑过的图像。可选的是,我们可以在它优化的时候使用一个掩码。
3.3 损失函数
操纵模型计算了公式2的损失。整个损失是CLIP损失 和图像损失
 之和。本研究将
 和
 分别定为1。

以下公式3和公式4显示了CLIP损失和图像损失。CLIP损失和图像损失使用VQGAN-CLIP实现的球面距离损失。球形距离损失的工作原理几乎是图像标记和文本标记之间的余弦相似度。这种损失也可以计算出初始和生成的图像标记之间的关系。图像标记I, 是CLIP图像编码器对生成的图像
 和调整大小的图像
 。文本标记T是CLIP文本编码器对输入提示t的输出。

3.4 食品图像数据集
表1显示了我们在实验中使用的食物图像数据集的统计结果。为了专门研究膳食,VQGAN被微调为通过三个膳食数据集来提取食物特征,这些数据集有不同数量的膳食类别和图像。另一方面,CLIP通过Recipe1M进行微调,其中包括成对的文本。本研究仅使用Recipe1M的训练和评估数据集来训练VQGAN和CLIP,并使用Recipe1M的测试数据集来测量指标。

表1:食品数据集的清单。关于Recipe1M,我们使用训练集和验证集来训练VQGAN。

表2:训练CLIP的提示清单。
3.5 训练CLIP模型的提示语
为了确定是否使用预训练的CLIP模型,我们评估了无预训练模型 "title_NoPretrain "和预训练模型 "title",它们都是用菜谱标题提示进行训练的。然后,我们检查了转移学习的学习提示,以使用预训练的模型。表2显示了学习提示的列表,菜谱标题为 "some_title",菜谱材料信息为" ingredients"。
这些提示是基于CoOp;在类别标记前添加 "a "可以提高5%以上的分类准确性。大多数时候,在文本前添加 "a的照片 "可以提高分类的准确性。此外,添加与任务相关的上下文也会有明显的改善。例如,添加 "一种花 "可以提高花卉图像数据集的分类精度。对于CLIP的训练提示,我们也添加了这些前缀和后缀,以检查性能的差异。
Recipe1M包含菜谱信息,如标题和材料。本研究将标题作为主要提示,将材料信息作为附加提示。训练提示 "成分 "只使用了成分信息。使用菜名和配料名称组合的 "配料_标题 "将标题作为 "配料",将配料作为 "一些_标题"。
4 实验
4.1 概述
首先,我们比较了图像编辑的提示。按提示的比较项目有这些:
(1)按称呼方式的差异
(2)学习领域内外的差异
(3)按口味形容词的差异
(4)按配料的差异
然后,我们展示了VQGAN在不同数据集上训练时的差异,接着是由于CLIP训练期间的提示而产生的差异。最后,我们提出了一个使用指标的VQGAN的定量评估。
4.2 评价指标
本研究中对GAN的定量评价使用了Inception score(IS),Freshet initiation distance(FID),以及Kernel-Inception distance(KID)。
IS 是生成数据的条件标签分布  和周围标签分布
 之间的 Kullback-Leibler 散度 (KL-divergence)。这个指标标得越高,图像的多样性就越显著,图像的识别就越容易管理。一般来说,较高的IS适用于图像编辑。IS是通过对所使用的图像数量i的KL-divergence进行平均而得出的。它描述为公式5。

FID是衡量真实图像和生成图像之间特征距离的著名指标之一。这个指标也被用来评估GAN的质量。让 和
 分别表示真实图像的特征向量的平均值和协方差矩阵,m和c分别表示生成图像的特征向量的平均值和协方差矩阵,FID由公式6定义。设Tr为矩阵的迹线。FID值越低,图像质量就越高。

KID是用最大平均差异(MMD)计算的异同度 样本从不同分布中独立提取。KID的定义如公式7所示。

我们在来自Recipe1M的测试数据集上的50,000张真实图像和来自训练过的VQGAN的50,000张重建图像之间计算这些指标。这些图像的大小被调整为256×256。我们在来自Recipe1M的测试数据集上的50,000张真实图像和来自训练过的VQGAN的50,000张重建图像之间计算这些指标。
这些图像被调整为256×256的大小。我们通过使用Torch-fidelity 1来测量IS。我们使用clean-fid 2来测量FID。KID也是通过使用Torch-fidelity测量的。
此外,对CLIP的评价指标使用了中位数排名(medR)、召回率(R@1,R@5,R@10)和CLIPScore[22]。 medR是中位数搜索排名。召回率是搜索结果在第一、第五和第十位内的百分比。CLIPScore评估了生成的字幕候选者的质量。使用CLIP作为损失函数,损失可能很高,即使标题是匹配的。同样地,即使提示不合适,损失也可能很低。CLIPScore用来评估文本的匹配程度。以w=2.5,c为标题标记,v为图像标记,计算如下。

我们使用随机的10k Recipe1M测试数据来评估CLIP。
OpenCLIP 3被用于CLIP训练和计算medR和Recall。作者的实现4用于测量CLIPScore。
4.3 实现细节
在本研究中,我们对以下五个VQGAN进行了微调。
(1) 训练过的ImageNet-1024模型
(2) 训练过的ImageNet-16384模型
(3) 训练过的Magical Rice Bowl模型,共59个epochs
(4) 训练过的Foodx251模型,共62epochs
(5) 训练过的Food500模型,共12个epochs
每幅图像的大小被调整为256×256的正方形,输出分辨率被设置为相同的大小。编码本的大小为256,分为16×16的网格,潜伏向量为 。CLIP使用openCLIP 3进行训练,这是CLIP的一个开源版本。OpenCLIP在Recipe1M的训练和评估数据集上训练,训练提示见表2。CLIP以ResNet50[23]为骨干,在32个epochs中进行训练。训练部分的优化函数是AdamW[24],它将批次大小设置为64,学习率为0.001,权重衰减因子为0.1。图像生成部分的优化函数使用Adam,它的步长设置为0.05。我们对一幅图像的编辑进行了1000次图像优化迭代。
5 实验结果
我们展示了从图3到图12的输出结果。图像编辑所需的时间约为每幅图像4至6分钟。
5.1 提示性的差异
我们比较了使用VQGAN-CLIP编辑图像的提示。
在这5.1部分,我们使用了在Magical Rice Bowl数据集上训练的VQGAN和ViT-B/32的预训练的CLIP。我们使用在Magical Rice Bowl数据集上训练的VQGAN来澄清图4中训练和未训练的图像之间是否存在差异。

图3:以呼叫方式的差异。我们比较了 "形容词+英文餐名"、"形容词+日文餐名 "和 "仅形容词"。用作提示语的形容词(颜色)列在底部,餐名列在左边。例如,最左边一栏的提示语是 "红色炒饭"、"红色恰罕",以及从上往下的 "红色"。
图3比较了饭菜的称呼方式。Magical Rice Bowl数据集只有10个类别的日本菜。我们比较了 "形容词+英文餐名"、"形容词+日文餐名 "和 "仅形容词"。在图3的所有输出图像中,每个提示的颜色在不同的地方都可以看到。在只用形容词的情况下,颜色的变化范围很大,而且其变化也是平坦的,就像画出来的一样,而不是只用形容词的情况下,颜色的变化是由成分决定的。比较 "形容词+英文名称 "和 "形容词+日文餐名","形容词+日文名称 "看起来更自然。如果把英文餐名分成两个词,如 "炒饭",可能会被认为是一个烹饪过程,而不是一个食物名称。

图4:VQGAN上的学习领域内外的差异。左边是学习内的领域,右边是学习外的领域。下面列出了输入提示。VQGAN的学习域与否在图像编辑方面没有明显的区别。

图5:按口味形容词的差异。所用的提示语列在下面。除了 "油腻",外观没有明显变化。
接下来,我们展示了神奇饭碗数据集中所包含和排除的饭菜之间的区别。在这里,我们选择了牛肉碗(gyudon)、海鲜碗(kaisendon)和炒面(yakisoba)作为神奇的米饭数据集中包含的图像,而牛排、比萨和意大利面则作为不包含的图像。图4显示了其结果。当我们输入gyudon的提示时,出现了gyudon成分的物体。当提示是炒面时,在两个输入图像中都出现了类似面条的物体。此外,我们还看到了牛排的颜色和形状以及比萨饼的颜色,这并不包括神奇饭碗数据集中的十种膳食。因此,所有的输出图像中都有一些变化。包括在神奇的米饭碗数据集中的饭菜和不包括的饭菜之间没有明显的区别。在VQGAN的训练域中的包含或排除对图像编辑没有明显影响。因此,这些图像变化不是由VQGAN的训练引起的,而是取决于CLIP。
此外,为了观察味觉形容词的差异,我们在餐名中加入了典型的味觉形容词。所选的口味是热的、甜的、咸的、酸的、苦的和油的。图5显示了输入味觉形容词的提示时的输出。除了油性以外,在所有图像中都没有观察到明显的外观变化。从这些输出中,我们推断出与味道有关的输入可能不会有太大的变化,因为视觉意义很弱。为了进行这些编辑,我们应该在另一个视觉变化中添加诸如辛辣成分等词语。
最后,我们在图1中展示了使用添加配料的提示的输出结果。在这里,我们考虑了模型通过添加鸡蛋、培根、生菜、海鲜和火腿这五种成分的词来改变图像,在添加 "与 "字之后。如图1所示,输出可见的五种成分并不存在于神奇饭碗数据集的类别中。它是通过与大规模预训练的视觉语言模型CLIP联系起来发生的。我们还发现,有些情况下会编辑不同的部分,例如 "鸡蛋饭 "中右上方的菜。因此,我们研究了一个输入掩码的功能。
添加配料的功能是这个图像编辑模型的一个特点。因此,下面由VQGAN和CLIP模型进行的比较使用了关于加料的提示。
5.2 训练过的VQGAN的区别
图6显示了用食物数据集训练的VQGAN的模型之间的差异。我们使用图中所示的VQGAN和预先训练的ViT-B/32 CLIP。

图6:VQGAN的训练数据集的差异。下面列出了这些提示,左边是用于训练VQGAN的数据集。在所有的训练模型中,质量没有明显的差异。
在所有的输出中,图像编辑有差异,但它们是按照提示编辑的。所有训练模型的质量没有明显差异,只有微小的差别。
5.3 受过训练的CLIP的不同之处
图7和8比较了用Recipe1M训练CLIP时的训练提示。除了ViT-B/32预训练的CLIP,我们使用了从表2所示的提示中学习到的CLIP,用于原始CLIP。本节输出使用ImageNet1024预训练的VQGAN
比较 "title_NoPretrain "和 "title",前者是用从头开始的CLIP的标题学习,后者是用预训练的CLIP的标题学习,没有明显的区别。因此,我们在其他学习提示中使用了预训练的模型。包括成分在内的 "成分 "和 "成分_标题 "提示的输出有类似的人工智能。此外,那些CLIP模型不能根据提示操作图像,而且观察到图像编辑的质量较低。我们可以假设,用食物成分学习CLIP并不能提高图像质量。这个猜想意味着材料在图像的外观上并没有直接发挥重要作用。我们还发现,用饭菜图像训练CLIP并不能抑制整个结果图像中的GAN特定伪影。至于 "APhotoOfA "和 "APhotoOfA_ATOF",两个模型受到的干扰都比较小,但 "APhotoOfA_ATOF "的整体输出被破坏得比较少。"APhotoOfA_ATOF "也比 "APhotoOfA "更稳定。在图7中,我们可以看到 "APhotoOfA_ATOF "中图像右上方的培根、生菜和海鲜与米饭放在不同的盘子里。另外,在图8中,我们可以在 "APhotoOfA_ATOF "中看到一个鸡蛋、培根和火腿。最后,比较原始CLIP和整个训练后的CLIP,原始CLIP随着提示显示了一些变化,但图像质量很粗糙。

图7:按CLIP学习提示对大米的差异。这些提示列在下面,左边是CLIP学习的提示(见表2)。title_NoPretrain "和 "title "之间没有明显差异。图像编辑的质量在 "成分 "和 "成分_标题 "中较低,在 "APhotoOfA_ATOF "和 "PhotoOfA "中较高。
5.4 有掩盖和无掩盖的差异
在本节中,我们展示了使用掩盖的结果。图9到12显示了结果。这些图像使用了在Magical Rice Bowl数据集上训练的VQGAN和在ViT-B/32上预先训练的CLIP。此外,在图9中,我们手动创建了覆盖米饭的方形面具,而在其他图10到12中,我们使用了UECFoodPixComplete的mask。
在图9中,配料被放置在米饭上,周围的背景在蒙版中没有变化。
在图10中,我们使用了一个从UECFoodPixComplete的遮罩图像中得到的圆形遮罩,我们可以确认,模型将配料添加到咖喱中。在图11中,我们使用了一个从UECFoodPixComplete得到的大的矩形遮罩。在没有遮罩的情况下,浇头甚至有时是可见的,但有了遮罩后所有的浇头都是可见的。
在图12中,我们使用了从UECFoodPixComplete得到的一个大的不均匀的面具,像一个圆形。即使没有蒙版,浇头也是存在的。但有了masks,浇头就会明显地生成。此外,该模型使用面具不改变勺子的形状。

图8:按CLIP学习提示在Chahan上的差异。提示语列在下面,CLIP学习的提示语在左边。结果几乎与图7相同。

表3: VQGAN中50,000张膳食图像的重构指标

图9:在水稻图像上使用手工创建的网格掩码,其输出结果的差异。上面的小图像是输入图像和输入掩码。提示显示在底部。上面的图像是没有掩码的输出结果,下面的图像是有掩码的输出结果。结果显示,背景被保留了下来。

图10:在咖喱图像上使用掩码,输出的差异。其格式与图9相同。这些结果使用了从UECFoodPixComplete掩膜图像中得到的圆形掩膜。对模型进行了编辑,在蒙版上添加了配料

图11:在炒面图像上使用掩膜,输出的差异。其格式与图9相同。在没有遮罩的情况下,有时甚至可以看到浇头,但使用遮罩后,所有的浇头都可以看到。

表4: 对CLIP的定量评价

图12:在Chahan图像上使用掩膜的输出的差异。其格式与图9相同。这些结果使用了从UECFoodPixComplete得到的一个大的不均匀的蒙版。勺子的形状通过使用掩码得到了保持。
使用遮罩,该模型没有在指定的位置编辑图像,被操纵的图像没有被破坏。此外,这个模型对非蒙版区域进行了适当的编辑,在蒙版边界附近的图像损坏较少。当图像的编辑范围较小时,没有遮罩的编辑往往导致不能很好地被编辑,因为操纵的注意力被吸引到各个位置。相反,当图像的编辑范围很广时,即使没有遮罩也经常进行编辑。然而,如图12所示,一个事物的形状,如勺子,是由遮罩保持的。因此,我们可以说,在任何情况下,有遮罩的编辑质量都会更好。虽然需要输入蒙版,但当我们想指定编辑点或想进行大幅度的编辑时,输入蒙版图像是一种非常有效的方法。
5.5 模型的定量评价
表3显示了VQGAN的评价。在food500上预训练的VQGAN的FID和KID最低,而在Magical Rice Bowl数据集上训练的VQGAN的FID最高。ImageNet16384和foodx251的FID与在food500上预训练的FID相当,但ImageNet16384的KID与food500相比有一定差距。IS的比较表明,ImageNet1024是最好的,它表示最容易识别和最多样化的,但food500也差不了多少,总体来说,food500是质量最高的模型。
表3和图6对VQGAN的训练数据集之间的差异进行了定量和定性的评估。图6中训练数据集之间的差异显示,输出的图像没有明显的差异。然后,当我们看表3时,我们发现food500模型具有最高的准确性。定量评价显示了数值上的差异,但在图像编辑的质量上没有明显的差异。这表明通过定量评价的定性评价是复杂的。在图像编辑方面,如本研究,还没有形成标准的评价指标和基准,定量评价并不能直接评价图像编辑的优劣。在图像编辑中需要建立一个新的定量评价指标。
表4显示了CLIP的定量评价。"title"、"APhotoOF "和 "APhotoOf_ATOF "相对占优势。"title_NoPretrain "有最高的CLIPScore,但可能对文本和图像之间的相似性不成熟。图7和图8也显示了CLIP的训练提示之间的差异。当模型得到一个好的定量评价时,输出的图像也往往是好的。因此,与GAN定量评价不同,CLIP评价有可能通过定量评价提供定性评价。
6 结论
在这项研究中,我们研究了VQGAN-CLIP在编辑与膳食有关的图像方面的有效性。为了进一步将模型专门用于膳食图像,我们在膳食图像数据集上训练了VQGAN,在具有各种训练提示的食谱数据集上训练了CLIP。
我们通过编辑提示、VQGAN的训练数据集和CLIP的训练提示,使用掩码或不使用掩码来比较差异。我们发现,VQGAN的训练数据集在输出的图像中没有显示出明显的差异。然而,评价指标是用饭菜图像数据集更好。"APhotoOfA_ATOF "的图像损坏相对较少,在CLIP训练提示中的定量评价中得分较高。屏蔽图像的功能是一个非常有效的图像编辑工具。
我们将考虑增加一个自动输入掩码的模型。我们还将考虑VQGAN模型以外的图像生成模型,如PPDM[26]。
原文链接:https://doi.org/10.1145/3552484.3555751
1) https://github.com/toshas/torch-fidelity
2) https://github.com/GaParmar/clean-fid
3) https://github.com/mlfoundations/open_clip
4) https://github.com/jmhessel/clipscore
 1357


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


