【赫兹威客】伪分布式Flink测试教程

UE5 SplineMesh与StaticMesh性能对比:生成1000米路径的帧率与内存实测 本文深度对比了UE5中SplineMesh与StaticMesh在生成1000米路径时的性能差异,包括帧率、内存占用及实现复杂度。实测数据显示,SplineMesh在Draw Call优化和动态变形场景中表现更优,而StaticMesh适合需要复杂材质变化的场景。文章还提供了优化技巧和选型指南,帮助开发者根据项目需求做出科学决策。 阅读详情

本文档为伪分布式大数据环境(1台虚拟机:hadoop)中Flink组件的功能测试教程,涵盖Flink依赖服务启停、进程验证、WebUI访问、核心测试命令执行及服务关闭等核心场景。严格遵循视频操作流程,结合参考文档中的测试命令,详细说明每个步骤的操作要点、执行命令及预期结果,助力高效完成Flink组件可用性及任务运行功能验证。

一、前期准备:环境基础信息

测试前需确认环境配置符合要求,避免因基础环境问题导致测试流程中断:

  • 虚拟机配置:1台虚拟机(命名为hadoop),硬盘配置100GB,已完成伪分布式部署
  • 系统账号:优先使用hertz账号(密码:hertz);特殊操作使用root账号(密码:1)
  • 工具准备:Mobaxterm远程连接工具(已安装并可正常使用)、本地浏览器(如Chrome、Edge)

二、Flink测试详细步骤

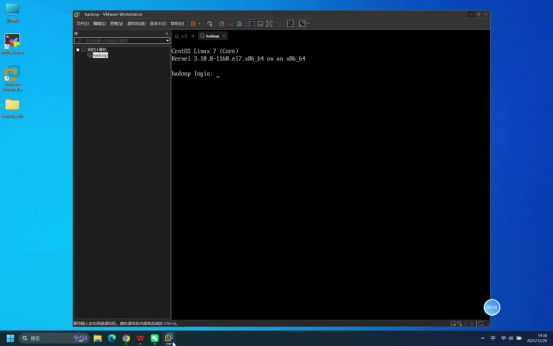
步骤1:确认虚拟机启动状态

操作说明:启动虚拟机,等待系统加载完成,直至出现登录页面。

预期结果:虚拟机正常启动,显示系统登录界面,无启动报错。
步骤2:使用Mobaxterm连接虚拟机

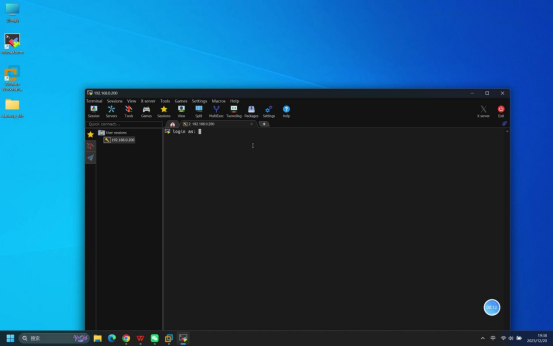
操作说明:打开本地Mobaxterm工具,按照伪分布式部署教程中的详细步骤建立与虚拟机的远程连接。

核心操作要点:

  • 新建远程连接,选择SSH连接方式
  • 输入虚拟机IP地址(需提前确认正确)
  • 选择登录账号类型(默认为普通用户)

预期结果:Mobaxterm连接成功,进入连接等待登录状态。
步骤3:输入账号密码完成登录

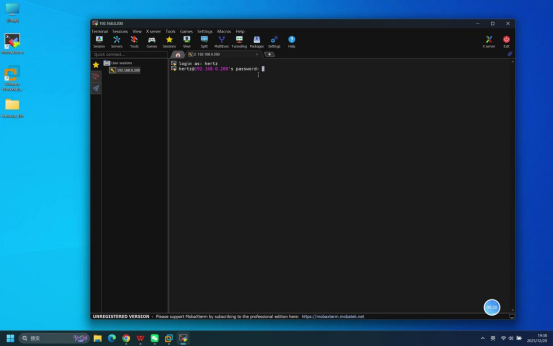
操作说明:在Mobaxterm连接成功后的登录界面,依次完成账号和密码输入。

具体操作:

  • 当终端显示账号输入提示时,输入:hertz
  • 回车后,终端显示密码输入提示,输入:hertz(密码输入时默认不显示明文)
  • 再次回车确认

预期结果:登录成功,终端界面显示当前登录用户及主机信息(如[hertz@hadoop ~]$)。
步骤4:启动Flink相关服务

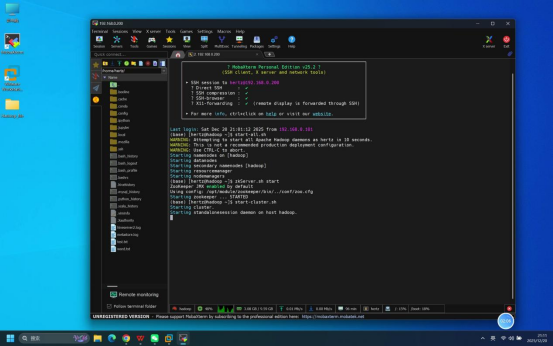
操作说明:在登录成功的Mobaxterm终端中,按依赖顺序启动相关服务(先启动基础依赖服务,待稳定后再启动Flink服务)。

具体命令:

  • 启动ZooKeeper服务:zkServer.sh start
  • 启动Hadoop服务:start-all.sh(一键启动HDFS和YARN相关进程,为Flink提供资源支持)
  • 等待10秒左右(确保依赖服务稳定运行),启动Flink服务:start-cluster.sh(一键启动Flink Standalone集群,含JobManager和TaskManager服务)

说明:启动过程中若出现权限提示,直接回车确认即可;需等待前一个服务启动完成(无报错)后,再执行下一个启动命令。

预期结果:所有服务启动无报错,终端依次显示各服务的启动日志信息。
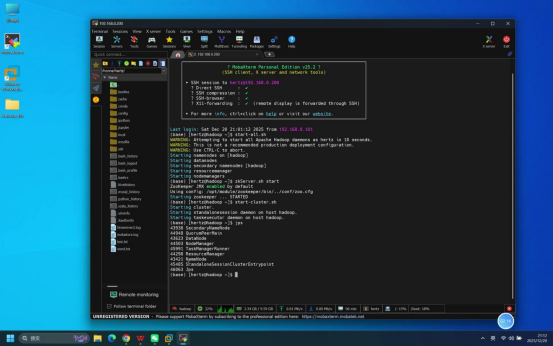
步骤5:执行jps命令验证进程状态

操作说明:服务启动完成后,在终端中输入jps命令,查看当前运行的Java进程。

具体命令:jps

预期结果:终端输出进程列表,包含以下核心进程,说明相关服务启动正常:

  • NameNode、DataNode、ResourceManager、NodeManager(Hadoop相关进程)
  • QuorumPeerMain(ZooKeeper进程)
  • StandaloneSessionClusterEntrypoint(Flink JobManager进程)
  • TaskManagerRunner(Flink TaskManager进程)
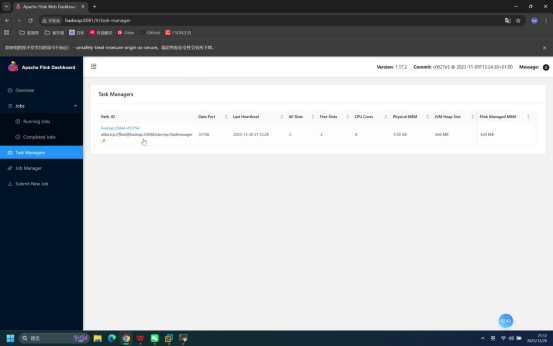
步骤6:浏览器访问Flink WebUI

操作说明:打开本地浏览器,输入Flink WebUI访问地址,查看Task Manager等集群信息。

具体操作:

  • 打开浏览器(如Chrome)
  • 地址栏输入:hadoop:8081
  • 进入页面后,定位并查看「Task Managers」模块

预期结果:浏览器成功加载Flink WebUI页面,「Task Managers」模块显示当前运行的TaskManager节点信息(伪分布式下为1个),包含节点ID、状态、资源使用情况等,集群状态正常。
步骤7:执行Flink测试命令

操作说明:回到Mobaxterm终端,执行Flink测试命令,完成任务提交等核心功能验证。

具体操作:

  • 确认测试文件:复用Hadoop测试的/input/word.txt文件
  • 查看是否存在目录:hdfs dfs -ls /test_flink_output
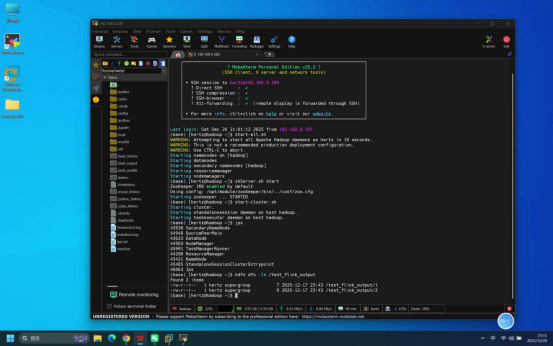
  • 清理历史输出目录(若存在):输入命令:hdfs dfs -rm -r /test_flink_output
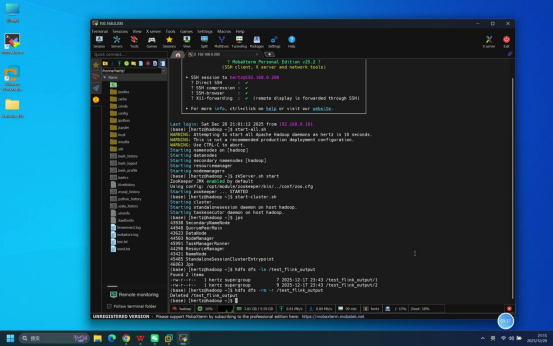
  • 提交Flink批处理测试任务:输入命令:flink run $FLINK_HOME/examples/batch/WordCount.jar --input hdfs://hadoop:8020/input/word.txt --output hdfs://hadoop:8020/test_flink_output
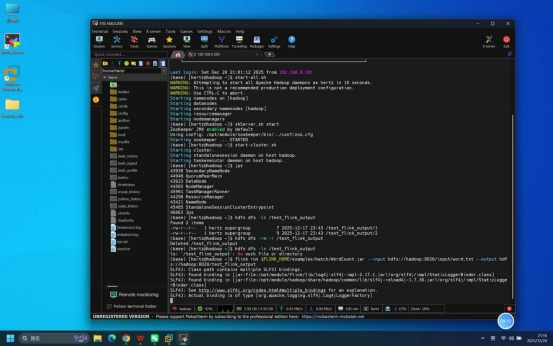
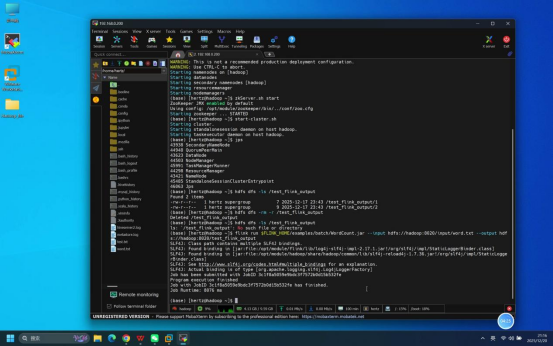
  • 查看任务执行结果:输入命令:hdfs dfs -cat /test_flink_output/*
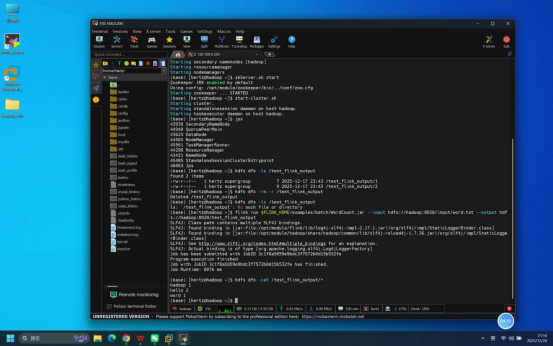
预期结果:所有测试命令执行无报错,Flink批处理任务正常提交并运行完成;查看结果时,终端输出包含“hadoop 1”“hello 2”“word 1”的统计信息,与Hadoop单词计数测试结果一致。

步骤8:关闭Flink相关服务

操作说明:测试完成后,在终端中按与启动相反的顺序关闭所有相关服务,避免资源占用或数据损坏。

具体操作与命令:

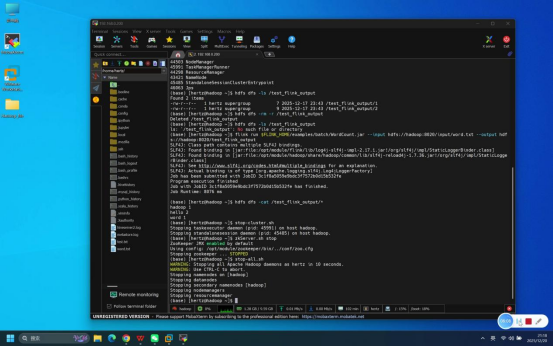
  • 关闭Flink服务:输入命令:stop-cluster.sh
  • 关闭Hadoop服务:输入命令:stop-all.sh
  • 关闭ZooKeeper服务:输入命令:zkServer.sh stop

预期结果:所有服务均正常关闭,无报错提示。
RV1106G3的AOV下的yolov5调试记录 本文介绍了基于LuckFoxPicoMax开发板的RV1106芯片调试经验,重点包括AOV(Always-On Vision)和Yolov5目标检测的实现。在硬件方面,板载1TOPS NPU、256MB内存,并更换为SPI NOR存储。软件调试涉及MK配置文件修改、设备树调整(按键唤醒和sensor配置)以及程序自启动设置。Yolov5模型优化为320*320尺寸,推理时间约45ms。系统采用VI采图与AI识别通过共享内存通信的方案,实测功耗在20-35mA范围。文章还指出了当前存在的功耗优化、ISP调试等 阅读详情

相关推荐

【推荐算法】召回模型总结

【推荐算法】召回模型总结

m0_48086806的博客 6237

AI分布式Token中转站网关底层实现-东方仙盟

在终端优先同步架构下,所有终端智能体请求不再直连上游 MaaS 平台(千帆、百炼、DeepSeek 等),全部经由分布式 Token 中转站网关统一中继。网关承担虚拟客户密钥签发、上游子账号路由、前置内容安全审计、事务路由调度、可控网络震荡多上游链路容灾、SSE 流式透传、用量记账、封禁熔断、原始 IP 封包签名溯源等核心职责。本文基于 Go 实现分布式网关核心底座,复用架构原有无状态 Token 穿透、事务 ID 幂等、链路探活、多节点中继能力;区分两层密钥体系:面向终端客户的虚拟 Key。

cybersnow精通 28 门计算机语言,凭借其超凡的技术能力,成功开发过上万个应用,广泛涉及政府、商业、个人等众多领域,甚至在检察院、环保局、公安局等专业场景中也大放异彩。不仅熟练掌握单片机和物联网开发,在软件架构设计方面更是独树一帜,自创了跨平台软件 207

STM32裸机开发基础:寄存器直接操作详解

寄存器是微控制器内部的特殊存储单元,直接与硬件电路连接,用于控制和监视硬件功能。与普通内存不同,寄存器的每一位(bit)通常都有特定的硬件含义。寄存器就是机器的控制面板上的各种开关和指示灯每个开关控制一个具体功能(如打开LED、启动通信)每个指示灯显示一个具体状态(如数据接收完成、错误发生)// GPIO引脚定义1。

2401_88760782的博客 2186

集中式与分布式怎么选:从订单读写看 KingbaseES 的架构边界

以订单系统为例,一笔付款会扣账户余额、写一条流水、更新订单状态;月末报表则可能按日期统计所有租户的订单。前者要求几项变更一起提交,后者关心查询会覆盖多大范围。讨论集中式与分布式,先把读写请求分开,比先数数据库节点更容易看清问题。KingbaseES 核心数据库是集中式关系数据库。KES RAC 和 KES TDC 也都可以部署为多节点形态,但它们的数据组织方式并不相同。

todoitbo的博客 8331

MMI分束器仿真优化:用Lumerical FDTD实现95%耦合效率的实战技巧

本文详细介绍了使用Lumerical FDTD软件对MMI分束器进行仿真优化的实战技巧。通过构建高保真模型、精确配置光源与边界条件,并重点优化波导结构与taper设计,系统性地将器件的耦合效率提升至95%以上。文章还分享了利用参数扫描、varFDTD加速等高级方法,帮助硅光芯片设计工程师高效实现高性能MMI分束器设计。

rainy的博客 770

5步搞定ABB机器人RobotStudio与S7-1500PLC的Profinet通讯(附PLCSIM调试技巧)

本文详细介绍了如何利用RobotStudio与TIA Portal软件,结合PLCSIM Advanced仿真器,在零硬件条件下实现ABB机器人与西门子S7-1500 PLC之间的Profinet通讯虚拟调试。通过五个核心步骤,从环境搭建、网络配置、信号映射到联合仿真与高级调试,帮助工程师在项目前期高效验证逻辑、压缩现场调试周期,并掌握实用的PLCSIM调试技巧。

weixin_29188043的博客 505

编队系列(二)|固定翼如何依靠邻居信息保持队形?一致性控制、通信拓扑与分布式仿真实现,附仿真代码

一致性编队将通信关系写入邻接矩阵和拉普拉斯矩阵,各机根据本机与邻居的协同变量误差生成局部修正量。普通位置一致性会使成员趋向同一点;固定翼编队需要对带槽位偏置的虚拟参考点、航迹角、速度或路径参数执行一致性,再由路径跟踪和单机制导层生成可飞参考。本文例程对二维虚拟参考点坐标进行一致性,并将路径速度、路径收敛速度和一致性速度组合为期望运动,再复用 LQR 与姿态控制接口。该结构适合验证静态环形拓扑下的多机编队,但其收敛与安全性仍受消息有效性、通信时延、拓扑变化、速度饱和、转弯曲率和机间避碰约束影响。

2302_80148937的博客 281

知识图谱_知识图谱 | 知识图谱做用户画像

导读:最近一直在思考怎么用知识图谱做推荐,但是目前能知道的内容都是基于路径的推荐和基于图特征的推荐,所以能不能换一个角度,探究一下用知识图谱怎么做用户画像,因为画像也是推荐系统重要的一部分。现在的知识图谱+推荐怎么做的传统的用户画像怎么做现在的知识图谱+推荐怎么做的?基于路径:可以理解成基于图谱的多路径召回,或者多路径推荐,然后根据路径的转移概率进行排序从而达到推荐的效果,基于路径比较适合简单的推...

weixin_28801659的博客 1460

微服务架构落地:业务域全景与 DDD 落地 —— 如何避免把微服务写成“分布式单体”?

本文首发于微信公众号

helloword_monkey的博客 301

i茅台APP加密参数逆向分析:MT-Device-ID与mt-v生成算法

在移动应用安全领域,参数加密是防止API滥用的重要手段。通过对通信协议的逆向分析,可以揭示加密参数的生成原理,这对理解移动应用安全机制具有重要意义。以i茅台APP为例,其关键接口使用了MT-Device-ID和mt-v两个加密参数,前者基于设备硬件信息生成,后者则通过动态签名机制确保请求时效性。这类技术广泛应用于电商、金融等需要高安全性的场景。通过抓包工具和逆向工程手段,可以还原出从设备指纹生成到动态签名的完整技术链条,其中涉及MD5、SHA256等常见哈希算法的应用。掌握这些加密参数的生成逻辑,不仅有助于

weixin_28568819的博客 320

CentOS 7 常用命令大全

CentOS中Linux命令

m0_63075763的博客 2017

模型调参怎么自动化?CubeStudio NNI 超参搜索实操(14 种算法 / 单机多进程 vs 多机分布式 / 搜索空间 / 结果上报)

CubeStudio是一款开源、云原生的一站式AI平台,支持机器学习、深度学习与大模型全链路管理。其内置微软NNI超参搜索(HPO)功能,通过get_next_parameter()接收超参、report_final_result()上报结果,实现自动调参。支持14种算法(如TPE、Hyperband)、单机/多机分布式并行(基于Volcano),提供可视化界面与分布式日志管理。用户仅需改造两行代码,即可完成从搜索空间定义到实验运行的全流程,显著提升调参效率。平台原生适配国产算力,支持私有化部署,已服务数千

258

解析 RABAX during SAPGUI Logon 错误及其解决方案

登录用户关联了初始启动程序,该程序由于未处理的异常导致运行时错误。在 ST22 查看错误的程序名和错误行。修复初始程序代码中的逻辑问题。重新部署修复后的代码。示例代码:防止未处理的异常TRY." 模拟逻辑处理ENDTRY.此代码通过 TRY-CATCH 块捕获潜在错误,避免程序崩溃。是 SAP 系统中常见的运行时错误,其根源可能涉及多个方面,包括用户配置、系统状态、数据库连接和自定义开发等。通过结合 ST22、SM21 等诊断工具,以及完善的代码实践和系统监控,可以有效预防和解决此类问题。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1779

分布式详解

分布式系统由多台独立节点通过网络协作,对外提供统一服务。其核心挑战在于部分失败、无全局时钟与网络不可靠。为应对这些难题,系统需在不可靠环境中保证协同正确性。分布式主要解决高吞吐、高可用、业务拆分与数据扩展问题。根据CAP定理,系统需在一致性(C)、可用性(A)与分区容错(P)中取舍,多数互联网应用选择AP,遵循BASE理论:基本可用、软状态、最终一致。分布式ID常用雪花算法,兼顾有序性与唯一性。

m0_50953782的博客 106

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

工商业屋顶、地面电站、山地分布式:三类场景的光伏接入选型

自连科技智慧光伏运维平台,面向分布式与集中式电站,实现监控、运维、经营一体化。支持多品牌设备非侵入旁路接入,96 台设备秒级在控,告警到工单全闭环。演示态覆盖 8 座电站、96 台设备、13.42MWp,详解其运转逻辑与落地价值。

Alinket的博客 432

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

OpenWiFi与LibreNMS集成实践:构建分布式异构网络管理体系

面向多厂商园区网络,详解 OpenWiFi 与 LibreNMS 的集成架构:SNMP 自动发现、MIB 指纹识别、边缘轮询与统一告警。破解数据孤岛,构建统一运维视图。

asterfusion的博客 277

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

智能家居全国交付中随需配套的分布式节点架构设计与实现:需求驱动下的交付半径扩展

平台在目标城市筛选交付工程师,按技能标签、交付质量、准时率、配合度、主体状态进行认证。需求驱动的分布式节点架构把交付半径与业务半径同步扩展:B端客户业务覆盖到何处,平台在何处按统一标准筛选认证节点,规则先行,节点可替换,平台兜底。平台不定义产品,不创造流量,不直接服务C端使用端,只做全国交付基础设施。平台在目标城市筛选交付工程师,按技能标签、交付质量、准时率、配合度、主体状态进行认证。质量指标可观测:业务覆盖映射准确率、节点认证通过率、分级分布、一次交付成功率、返工率、异常闭环时长、节点替换响应时长。

weixin_43432501的博客 422

集中式与分布式怎么选:一次选型复盘,附金仓数据库建表与增删改查实践

本文以真实项目为背景,剖析集中式与分布式架构的适用场景。作者指出,盲目追求“分布式”不仅增加成本与复杂度,更可能因事务延迟、运维难度上升等问题导致系统性能下降。通过对比两类架构在事务、SQL自由度、运维与扩容等方面的差异,强调应基于业务实际需求选择方案——“不是哪个先进,而是哪个解题”。文中还拆解“伪分布式”等常见误区,并以金仓数据库实践为例,展示如何在集中式架构下高效实现订单系统设计,最终倡导“按需选型,不被概念绑架”的务实技术观。

小相探索IT世界 1485

集中式与分布式,KingbaseES 的四种形态共用一套内核

金仓数据库 KingbaseES 提供集中式(单机、ClusterWare、RWC、RAC)与分布式(TDC、Sharding、ADC)双架构,基于同一内核扩展。集中式形态零应用改造,RTO均小于1分钟,RPO为0;RAC共享存储实现多活,支持跨节点并发控制。分布式通过分片管理、分布式事务等模块构建,兼容原有运维体系,避免分库分表的外部耦合。选型核心考量:数据规模、并发量、团队经验,三者皆无则从集中式起步,后续按需扩展,成本可控。

笃行其道的博客 358

推理 INFRA 方法论(2):分布式推理:TP、DP、EP、CP 与 PP 的取舍

围绕权重、KV、激活和通信预算,分析 TP、DP、EP、CP 与 PP 的容量、通信及吞吐取舍,讨论注意力与 MoE 的并行组合,以及长上下文和流水线的额外约束。

sunny0660的博客 395

vLLM 前世今生:从 PagedAttention 到分布式推理引擎的演进之路

以显存效率为起点,以吞吐为目标,逐步长成一个通用的推理基础设施。诞生时,它用 PagedAttention 解决了 KV Cache 浪费这个最痛的问题;发展期,它不断扩展模型、量化、并行、硬件支持,从"快但窄"走向"全而稳";当下,V1 引擎、PD 分离、结构化输出、长上下文是社区最热的方向;未来,它想成为硬件无关、场景无关的推理标准层。对于使用者来说,理解 vLLM 的演进逻辑,比记住它的 API 更有价值——因为它的每一次取舍,背后都是对"推理系统到底在优化什么"这个问题的重新回答。

Maxwell_Newton的博客 337

工业网关 Quota 实战:从限流算法到分布式配额治理

工业网关通常不是单租户、单进程的简单程序:北向 API 会被多个应用调用,南向可能接入大量设备,本地还要承载数据缓存、历史导出、协议任务和云端上报。如果资源使用没有边界,一个异常应用、一个失控采集任务或一次历史导出,就可能挤占其他租户的连接、存储和上行带宽。Quota 的价值不是简单“把请求拒绝掉”,而是把资源使用显式化:谁能用、能用多少、在什么周期内用、超出后走什么策略。本文从Zenova EdgeOS工程梳理工业网关中的配额类型、限流算法、Redis 原子实现、数据模型、降级策略和监测体系。

ZenovaEdgeOS的博客 344

Cloudflare Durable Objects 支持自动重试:分布式调用如何避免重复执行?

在分布式系统中,远程调用失败可能导致操作状态不确定。Cloudflare 为 Durable Objects 引入自动重试机制,仅对可重试错误进行智能重试,并通过 retryable() 明确标记幂等操作,避免重复执行。该机制不保证全局精确一次,仍需业务层实现去重,如使用请求标识或幂等键。核心在于区分“未执行”与“已执行但响应丢失”,从而在保障可靠性的同时防止数据错乱。

weixin_47502228的博客 360

从零搭建一个 AI Infra 实验室㉑:llm-d——从单个 vLLM 走向分布式推理

本篇深入 llm-d 分布式推理架构,解析负载感知路由、前缀缓存感知、KV Cache 本地性与 Prefill/Decode 分离。基于单节点 Kubernetes 和 LLM Simulator,实测智能路由与多 Pod 请求分布,理解从单个 vLLM 走向分布式推理的关键设计与挑战。

mosespaul的博客 288

跨端数据漫游,分布式 KVStore 冲突与合并

等两台设备联网同步后,手机上的清单里只剩下了面包,牛奶凭空蒸发了。这就是典型的分布式数据同步冲突,系统底层的默认策略把你坑了。这就导致了惨剧:如果手机时间比平板快了 5 分钟,那么手机上产生的任何数据,在同步时都会无条件覆盖平板上修改的数据。总的来说,分布式同步不能全靠系统,业务层的版本控制和冲突合并才是数据一致性的定海神针。系统默认的同步策略是 Last-Write-Wins(最后写入者胜出),判断标准是设备的系统时间。要解决这个问题,绝不能依赖底层的时间戳,必须在业务层引入版本号(乐观锁)。

2502_91284977的博客 148

【HarmonyOS API 26】分布式数字身份DID:系统级可信身份体系

传统证件核验大多依赖上传证件照片这类方式,在使用过程中往往流程繁琐,还存在身份信息泄露的隐患。Online Authentication Kit 依托 DID(Decentralized Identifiers)分布式数字身份标准提供数字身份能力,助力业务实现身份凭证数字化,并安全存储于设备终端TEE中,用户通过生物认证授权即可安全便捷地使用凭证。在简化身份核验流程、提升使用体验的同时,更好地守护用户身份隐私,强化信息安全保障。:传统认证依靠证件拍照、OCR、人工核验的长链路,联调与异常处理工作量大;

HarmonyOS SDK闭源开放能力技术团队 204
上一篇: 【赫兹威客】完全分布式Hadoop测试教程
下一篇: 【赫兹威客】完全分布式Hive(on Spark)测试教程
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
