



文章目录
JVM角度看方法调用系列文章:
4.JVM角度看方法调用-性能压测篇(码字…)
5.JVM角度看方法调用-Lambda篇(码字…)
在我们平时开发中常用的方法调用有三种:直接调用、反射调用、MethodHandle调用,这一系列文章就围绕着三种调用方式进行原理剖析和性能分析,本文JDK的版本是1.8。
一、虚方法和非虚方法
在jvm的角度来看方法调用一共分为5种,对应着5种字节码:
- invokestatic:调用静态方法,编译阶段确定唯一方法版本.
- invokespecial:调用构造方法、私有方法、父类方法,编译阶段确定唯一方法版本
- invokevirtual :调用所有虚方法,运行阶段确定方法版本(除去final修饰的方法,final修饰的是编译阶段确定版本)
- invokeinterface:调用接口方法,运行阶段确定方法版本
- invokedynamic:动态调用指令
这里主要讨论前四种指令,invokedynamic指令看5.java方法调用-Lambda篇。
invokestatic、invokespecial再加上final修饰的invokevirtual为字节码指令代表调用非虚方法;invokevirtual(除去final修饰的方法)、invokeinterface代表调用虚方法。
1.1、Interpreter下执行比较
注:jvm类加载中的link-Resolve过程并不会将常量池中全部的符号引用转换为直接引用。只会将Utf8、String、int、long等常量的符号引用解析成直接引用,像Methodref、Fieldref等类型的符号引用在运行时首次调用时才会解析成直接引用,并触发相关定义类的类加载(解析阶段并不是只发生类加载期间,在方法调用期间也会存在解析操作)。
- 虚方法表(virtual method table,简称vtable)
- 接口方法表(interface method table,简称itable)
解释器解释执行的情况下:
在一个类里当一个方法(指令)首次被调用时,如果这个方法对应的指令是invokestatic、invokespecial以及带final修饰的invokevirtual时,会对这个方法进行解析并将常量池里对应的符号引用替换为直接引用,当这个方法第二次被调用时则不会重复解析直接取常量池中现有的直接引用缓存;如果这个方法时invokevirtual、invokeinterface时,每次方法被调用时都将会对操作数栈中的对象实例的vtable或itable进行查找,找到方法对应的直接引用。(其实invokevirtual、invokeinterface在第一次执行时也会产生缓存,invokevirtual缓存父类中的方法直接引用;invokeinterface缓存接口中的方法直接引用)
这里我们看下Hotspot的源码:jdk-jdk8-b120/hotspot/src/share/vm/interpreter/bytecodeInterpreter.cpp
      CASE(_invokevirtual):
      CASE(_invokespecial):
      CASE(_invokestatic): {
        u2 index = Bytes::get_native_u2(pc+1);

        ConstantPoolCacheEntry* cache = cp->entry_at(index);

        if (!cache->is_resolved((Bytecodes::Code)opcode)) {
             // 如果这个方法指令尚未解析,即常量池中还是符号引用状态,对这个指令进行解析
          CALL_VM(InterpreterRuntime::resolve_invoke(THREAD, (Bytecodes::Code)opcode),
                  handle_exception);
          // 在常量池中获取方法的直接引用缓存
          cache = cp->entry_at(index);
        }

        istate->set_msg(call_method);
        {
          Method* callee;
          if ((Bytecodes::Code)opcode == Bytecodes::_invokevirtual) {
            CHECK_NULL(STACK_OBJECT(-(cache->parameter_size())));
              // 如果这个指令是invokevirtual但被final修饰,直接返回缓存中的方法指针
            if (cache->is_vfinal()) callee = cache->f2_as_vfinal_method();
            else {
                // 如果这个指令是invokevirtual且没被final修饰,则需要获取操作数栈中的对象实例然后查询对象实例的vtable,找到方法指针并返回
              // get receiver
              int parms = cache->parameter_size();

              VERIFY_OOP(STACK_OBJECT(-parms));
              InstanceKlass* rcvrKlass = (InstanceKlass*) STACK_OBJECT(-parms)->klass();

              callee = (Method*) rcvrKlass->start_of_vtable()[ cache->f2_as_index()];
            }
          } else {
            if ((Bytecodes::Code)opcode == Bytecodes::_invokespecial) {
              CHECK_NULL(STACK_OBJECT(-(cache->parameter_size())));
            }
            // 如果这个指令是 invokespecial、invokestatic,直接返回缓存中的方法指针
            callee = cache->f1_as_method();
          }

          istate->set_callee(callee);
          istate->set_callee_entry_point(callee->from_interpreted_entry());
#ifdef VM_JVMTI
          if (JvmtiExport::can_post_interpreter_events() && THREAD->is_interp_only_mode()) {
            istate->set_callee_entry_point(callee->interpreter_entry());
          }
#endif /* VM_JVMTI */
          istate->set_bcp_advance(3);
          UPDATE_PC_AND_RETURN(0); // I'll be back...
        }
      }

invokeinterface指令的处理逻辑与invokevirtual类似只是查询的是itable。
由此可见在调用时虚方法相对与非虚方法来说多了查表这个步骤,每次都要重新获取一下直接引用,所以虚方法的调用要比非虚方法慢。由于java一个类只能单继承,但可实现多个接口,所以在设计的时候vtable要比itable简单一些,所以上述指令的执行速度为:invokestatic、invokespecial、final修饰invokevirtual>invokevirtual>invokeinterface。
注:虚函数表的构建流程可以看RednaxelaFX大大的这个回答:https://zhuanlan.zhihu.com/p/24695819
Hotspot 虚函数表的初始化分为两个步骤:
1.在ClassFileParser::parseClassFile()调用klassVtable::compute_vtable_size_and_num_mirandas(),这一步是计算虚函数表的大小并初始化空间。
2.在InstanceKlass::link_class_impl中调用klassVtable::initialize_vtable(),为虚函数表赋值
1.2、JIT下比较
为了兼顾更多情景HotSpot是采用解释器和编译器混合的执行引擎。程序刚刚启动时采用解释器逐行代码解释执行,在程序运行过程中解释器会收集profile(运行时信息如:对象类型、循环体循环次数、方法调用次数等),JIT编译器通过对profile信息进行分析,可以对热点代码进行优化如:方法内联、内联缓存、标量替换等甚至更加激进优化,JIT将优化后的代码翻译成机器指令后保存在方法区的codeCache中,后续直接执行codeCache中优化后的机器指令。
内联缓存和方法内联是JIT的优化手段中最重要也是对性能提升最大的优化。非虚函数都可以进行内联优化,虚函数则要视情况而定有时只能进行条件内联甚至不能内联。下面分析下具体原因。
1.2.1、内联缓存
内联缓存:内联缓存是一种加快动态绑定的优化技术。它能够缓存虚方法调用中调用者的动态类型,以及该类型所对应的目标方法。在之后的执行过程中,如果碰到已缓存的类型,内联缓存便会直接调用该类型所对应的目标方法。如果没有碰到已缓存的类型,内联缓存则会退化至使用基于方法表的动态绑定。在局部性较好的程序中内联缓存效果还是不错的,但是内联缓存并没有真正的进行方法内联还是会有普通函数调用开销的,同时多了个比对过程会产生类型检查开销。
举个例子解释一下:
在一家生产手机的电子厂中,员工小明负责流水线的最后一步为手机贴上价格标签**(获取虚方法直接引用),小明有个小本本(vtable)记录了每种手机的价格:苹果-3000、华为-2000、小米-1000…小明刚来工厂时比较严谨每来一个手机都检查下型号并且查看下小本本对应的价格(Interpreter解释执行),经过一段时间的摸索小明发现了这个工厂每小时内都生产同一个型号的手机(收集profile),于是小明每次查询小本本后用大脑记录查询到的手机类型及对应的价格,等下一个手机来的时候比对下是否是大脑中的类型是则直接贴上价格标签,不是再去查询小本本并更替大脑中的记录(内联缓存)**大脑检索比查小本本快很多所以小明的效率直线上升。
总结:
JIT将字节码翻译成本地机器指令后内联缓存往往采用寄存器保存,而vtable保存在内存中,所以只要程序的局部性好**(虚函数单态调用或非虚函数调用),内联缓存可以显著提升方法调用效率。如果程序局部性差(虚函数超多态调用)**,即上例中==挨着的每个手机都不同类型,基本上每次都要查询vtable,内联缓存则意义不大。
1.2.2、去虚化和方法内联
方法内联:在编译过程中遇到方法调用时,将目标方法的方法体纳入编译范围之中,并取代原方法调用的优化手段,可以降低函数调用压栈出栈的开销。通常而言,内联越多,生成代码的执行效率越高。然而,对于JIT编译器来说,内联越多,编译时间也就越长,而程序达到峰值性能的时刻也将被推迟,因此通常只会对热点代码进行内联优化。
去虚化:非虚方法在成为热点代码后可以直接进行内联优化,而虚方法由于每次调用时的方法指针不一定相同即被目标方法的方法体不一定相同,所以在JIT进行内联时不能明确目标方法的方法体所以无法内联。如果想要进行内联需要先对虚函数进行去虚化优化再进行内联,去虚化就是将一个虚函数的调用转换为多个非虚函数的直接调用,此时可以明确目标方法体进而可以进行内联优化。
举例子分析一下:
1)非虚方法内联
package jvm.jit;

public class Animal {
    public void eat(){
        System.out.println("动物吃东西");
    }

    public static void sleep(){
        System.out.println("动物睡觉");
    }
}

public class Cat extends Animal {
    @Override
    public void eat() {

        System.out.println("猫吃东西");
    }

    public static void sleep(){
        System.out.println("猫睡觉");
    }
}

public class Dog extends Animal {

    @Override
    public void eat() {

        System.out.println("狗吃东西");
    }


    public static void sleep(){
        System.out.println("狗睡觉");
    }
}

public class Rabbit extends Animal{
    @Override
    public void eat() {
         System.out.println("兔子吃东西");
    }

    public static void sleep(){
        System.out.println("兔子睡觉");
    }
}
测试类:添加jvm参数-XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining
  public class InvokestaticDemo {

    public static void main(String[] args) {
        for (int i=0;i<=100_000_00;i++){
          //invokestatic #3 <jvm/jit/InvokestaticDemo.test : (Ljvm/jit/Animal;)V>
            test(null);
        }
    }

    public static void test(Animal animal){
        Animal.sleep();//invokestatic #6 <jvm/jit/Animal.sleep : ()V>
        Cat.sleep();//invokestatic #6 <jvm/jit/Cat.sleep : ()V>
        Dog.sleep();//invokestatic #6 <jvm/jit/Dog.sleep : ()V>
    }
}
打印结果如下图,可以发现这个几个非虚方法都成功被JIT进行了内联优化

内联后的伪代码如下
 public class InvokestaticDemo {

    public static void main(String[] args) {
        for (int i=0;i<=100_000_00;i++){
            System.out.println("动物睡觉");
           	System.out.println("猫睡觉");
           	System.out.println("狗睡觉");
        }
    }
}
2)完全去虚化内联
还是使用上面的Animal、Cat、Dog、Rabbit四个类换一个测试类:
public class invokevirtualDemo {
    public static void main(String[] args) {
        Animal cat=new Cat();
        for (int i=0;i<=100_000_00;i++){
        //invokestatic #5 <jvm/jit/invokevirtualDemo.test :(Ljvm/jit/Animal;)V>
          test(cat);
        }
    }

    public static void test(Animal animal){
        animal.eat(); //invokevirtual #6 <jvm/jit/Animal.eat : ()V>
    }

}
打印结果如下图,这里也是成功内联了,因为在程序运行期间JVM在执行**invokevirtual #6 <jvm/jit/Animal.eat : ()V>**指令时收集了多次Animal的实例类型发现器始终是Cat,于是JIT作出激进优化,假设调用test的全部入参都是Cat并按Cat的eat()方法进行方法内联。
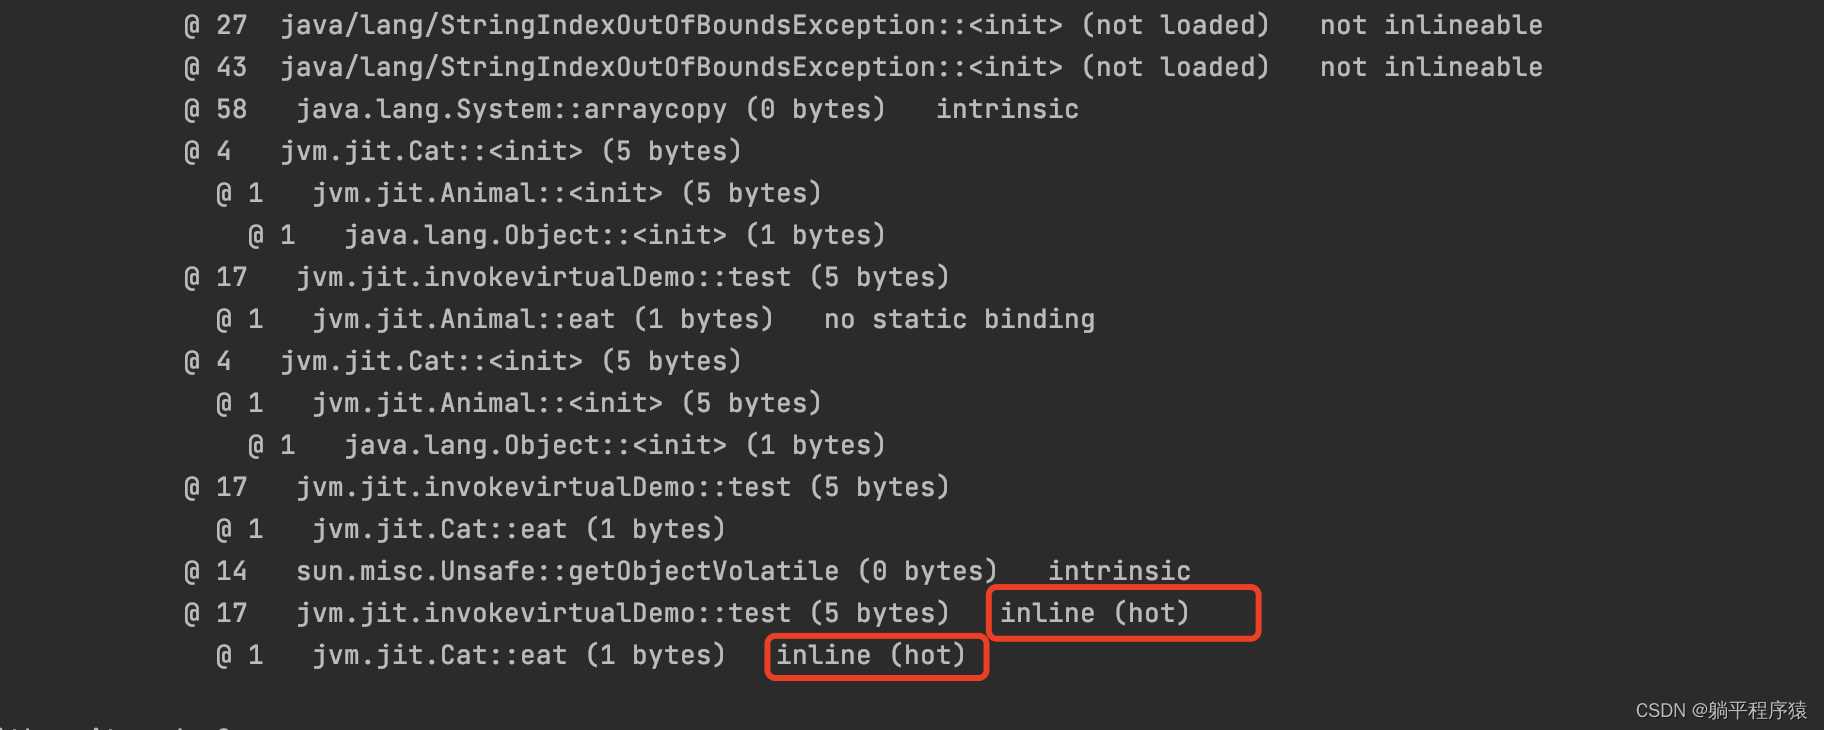
内联后的伪代码如下
public class invokevirtualDemo {
    public static void main(String[] args) {
        Animal cat=new Cat();
        for (int i=0;i<=100_000_00;i++){
          System.out.println("猫吃东西");
        }
    }
}
3)”陷阱“导致去优化
上一个例子中JIT即时编译器在收集到足够的profile后对**invokevirtual #6 <jvm/jit/Animal.eat : ()V>**指令进行了完全去虚化并且完全内联的激进优化,如果此时突然有一个Dog作为参数调用test(Animal animal)方法,此时JVM肯定不能继续执行JIT编译后的本地机器指令,否则最后结果与期望不同这是不能接受的。这时JVM会暂时切换回解释器运行的模式,继续收集profile等待下一次profile足够了再次进行编译。
HotSpot的有C1和C2两个即时编译器,为了满足启动性能优势和峰值性能优势两种场景,HotSpot虚拟机采用分层编译的方式。
- 解释执行;
- 执行不带 profiling 的 C1 代码;
- 执行仅带方法调用次数以及循环回边执行次数 profiling 的 C1 代码;
- 执行带所有 profiling 的 C1 代码;
- 执行 C2 代码。
所以由于激进优化和分层编译的存在HotSpot JVM启动初期会不断的经历 profile(收集运行时信息)——>optimization(优化)——>uncommon trap(出现‘陷阱’数据)——>deoptimization(去优化)…——>profile ——>optimization.震荡多次后才达到稳定。
下面通过一个例子证明一下,还是使用上面的Animal、Cat、Dog、Rabbit四个类换一个测试类:
public class invokevirtualDemo1 {
    public static void main(String[] args)throws Exception {
        Animal[] array=new Animal[]{new Cat(),new Rabbit()};
        Animal dog=new Dog();
        for (int i=0;i<=10_000;i++){
 						test(dog);
        }

       for(int i=0;i<=10_000;i++){
            test(array[i%2]);
        }
       Thread.sleep(5000);
    }

    public static void test(Animal animal){
        animal.eat();//invokevirtual #6 <jvm/jit/Animal.eat : ()V>
    }
}
本例中我们主要关注test()方法中 **animal.eat()**这个虚函数调用的内联情况。我们先理论分析下内联情况的变化然后再通过JITWatch来印证一下我们的分析:
-
代码刚刚启动通过解释器执行 animal.eat(),这个虚函数没有被JIT编译器编译
-
第一个for循环执完以后 **animal.eat()**变为热点代码,JIT也收集了足够的profile,此时对这个虚函数进行完全去虚化且完全内联的激进优化。
-
第二个for循环执行时 JIT发现调用 **animal.eat()**的Animal类型除了Dog之外还有Cat和Rabbit此时,JIT编译的本地机器指令进行去优化转换为解释器执行并继续收集profile
-
由于HotSpot针对虚方法进行去虚化优化的缓存profile收集条数(由JVM参数 -XX:TypeProfileWidth 控制)默认是2,此处两个循环一共出现了Cat、Dog、Rabbit三个类型调用eat()方法,所以JIT针对 animal.eat()无法进行去虚化优化,最终稳定后 **animal.eat()**还是Virtual_Call虚函数调用模式,无法被内联。
接下来我们用JITWatch验证下,看下test方法的编译情况。

下图所示一共编译了三次,第一次 **animal.eat()**为Not Compiled未编译状态,印证了我们分析的 1

下图所示第二次编译,在收集了足够的profile后 animal.eat()被内联,印证了我们分析的2

下图所示第三次编译,在第二次循环完成后 animal.eat()的最终形态是Virtual_Call虚函数调用模式,未被内联,印证了我们的分析4。而分析3发生在第二次编译到第三次编译之间,在出现了Cat和Rabbit类型后, **animal.eat()**的调用即刻从第二次编译指令执行deoptimization(去优化)到解释器执行模式。

为了避免上图同时展示了Inlined和Virtual Call两个分支引起误会(可能有人觉得这是条件去虚化),我们利用JITWatch的配置项取消分层编译(JVM参数-XX:-TieredCompilation )再执行一遍,直接看最终animal.eat()的形态,的确是Virtual_Call虚函数调用模式

4)条件去虚化内联
在上面一个案例中提到了HotSpot针对虚方法进行去虚化优化的缓存profile收集条数(又JVM参数 -XX:TypeProfileWidth 控制)默认是2,这里我们就验证下假如只有Dog、Cat两个类型是否会出现条件去虚化(guarded devirtualize)并且内联的情况。将上一个案例中的【i%2】改为【0】。
public class invokevirtualDemo1 {
    public static void main(String[] args)throws Exception {
        Animal[] array=new Animal[]{new Cat(),new Rabbit()};
        Animal dog=new Dog();
        for (int i=0;i<=10_000;i++){
 						test(dog);
        }

       for(int i=0;i<=10_000;i++){
            test(array[0]);
        }
       Thread.sleep(5000);
    }

    public static void test(Animal animal){
        animal.eat();//invokevirtual #6 <jvm/jit/Animal.eat : ()V>
    }
}
利用JITWatch直接看取消分层编译后JIT编译最终结果的内联情况,的确出现了条件去虚化且内联的情况,这里的代码执行性能仅次于完全去虚化且内联。
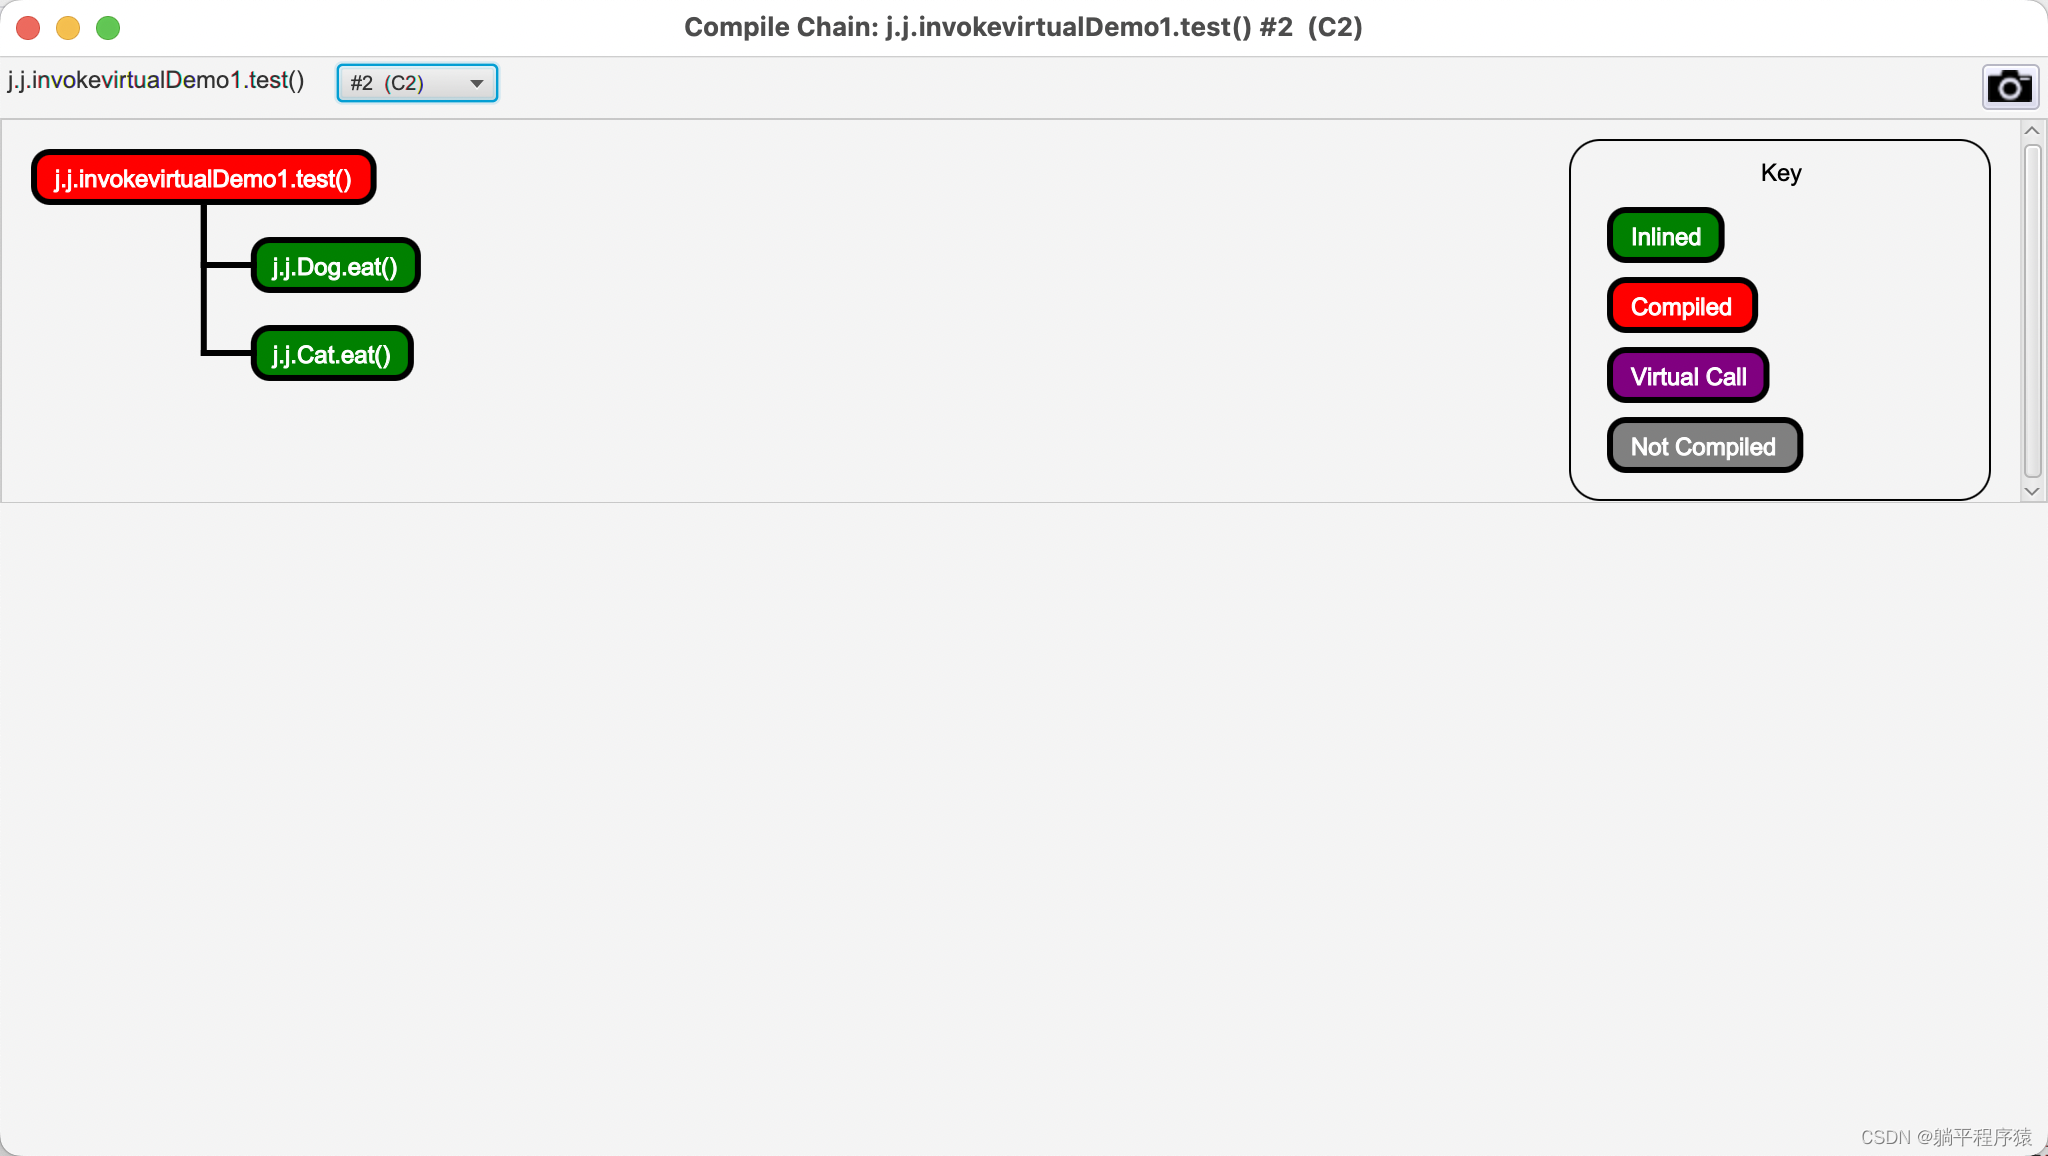
同时为代码添加-XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining参数,我们也可以在打印日志中得到印证。同时也能印证编译结果的迭代过程是由 profile——>Dog.eat的完全去虚化内联——>deoptimization(去优化)——>profile——>Dog.eat和Cat.eat条件去优化内联。

内联后的伪代码如下:
public class invokevirtualDemo1 {
    public static void main(String[] args)throws Exception {
        Animal[] array=new Animal[]{new Cat(),new Rabbit()};
        Animal dog=new Dog();
        for (int i=0;i<=10_000;i++){
 						test(dog);
        }

       for(int i=0;i<=10_000;i++){
            test(array[0]);
        }
       Thread.sleep(5000);
    }

    public static void test(Animal animal){
        if(animal.getClass()==Dog.class){
          System.out.println("狗吃东西");
        }
      	if(animal.getClass()==Cat.class){
          System.out.println("猫吃东西");
        }
    }
}
总结:
虚函数相对于非虚函数在方法内联上也是有很大区别的,同为热点代码的话 同一个调用点非虚函数肯定可以内联,虚函数则不一定,如果profile的类型小于3才可以被条件去虚化并内联,即便如此相比于非虚函数的完全内联也多了简单类型检查的开销。所以在平时开发中如果想要代码被JIT优化的性能更快,在针对虚函数调用注意下 例如:标记方法final为简单的方法内联、避免在关键位置的多态性等。
更多贴合JIT优化的代码规范可以看 怎样让你的代码更好地被 JVM JIT Inlining
最后引用下RednaxelaFX大大的总结, JIT下虚方法执行性能排序,从快到慢:
- 完全去虚化(devirtualize)并且完全内联:没有任何虚方法分派或调用开销。在C1或C2编译的代码中使用;
- 条件去虚化(guarded devirtualize)并且内联:有简单的直接类型检查开销,除此之外没有额外的调用开销。这种内联在每个调用点可以内联最多两个目标类型/方法。仅在C2编译的代码中使用;
- 完全去虚化但是没有内联:没有虚方法分派查找目标方法的开销,但是有普通的直接调用开销(所谓直接调用就是类似没有内联时的invokespecial一样,目标是固定的,不用查表)。在C1或C2编译的代码中使用;
- 条件去虚化但是没有内联:有简单的直接类型检查开销,然后有普通的直接调用开销。仅在C2编译的代码中使用;
- 单态内联缓存(monomorphic inline cache)调用:有一个简单的直接类型检查开销,然后是普通的直接调用开销。在C1或C2编译的代码中使用;
- 劣化到超多态(megamorphic)状态的内联缓存(inline cache)调用:这是(5)的劣化情况——当一个内联缓存调用点遇到多于一种实际被调用对象类型就会这样。此时实际上会通过接口方法表(interface method table,简称itable)查找目标方法,然后再调用过去。这是最慢的情况之一,在C1或C2编译的代码中使用;
- 直接通过itable查找目标然后调用:最慢的情况的另一版本。仅在解释器里使用。
上述invokeinterface的7种情况里,头5种都跟invokevirtual一样,都不需要查表,因而这些情况下两者的性能一模一样;最后两种是属于慢速情况,此时由于HotSpot VM的虚方法表(virtual method Table,简称vtable)比itable结构简单,所以invokevirtual会比invokeinterface快一些。
涉及的关键字:
- 去虚化(devirtualization)
- 条件去虚化(guarded devirtualization)
- 类层级分析(class hierarchy analysis,简称CHA)
- 性能分析引导优化(profile guided optimization,简称PGO)
- 数据流分析(data-flow analysis)
- 内联缓存调用(inline cached call)
- 单态内联缓存(monomorphic inline cache)
- 多态内联缓存(polymorphic inline cache):HotSpot VM没有使用这个,不过在讲inline cache的资料里多半会提到它所以这里也把它列举出来。
- 超多态内联缓存(megamorphic inline cache):劣化的inline cache
二、Interpreter、JIT、AOT 分析
-
Interpreter 解释器 :将字节码逐行解释成机器指令执行
-
JIT 动态编译:在系统运行过程中将热点代码编译成机器指令缓存并执行
-
AOT 静态编译 :在系统运行前将全部的字节码编译成机器指令,运行后完全执行编译的机器指令,不再依赖解释器
下面围绕一个问题来分析:HotSpot为什么采用解释器和编译器混合的执行引擎?为何不用AOT?
既然有了JIT这种神器,没必要保留解释器来’拖累’JVM的性能。这个想法是不对的,经过JIT编译和优化后的代码执行效率的确远高于解释器解释执行,但付出的代价是 编译时间(时间代价)+代码缓存(空间代码)。我们不能摒弃这两个代价只看代码执行效率来否定解释器的意义。作为客户端开发来讲用户往往不能接受启动速度的牺牲,而且很多代码往往只执行一遍 此时 编译时间+编译后代码执行时间>解释器解释执行时间没必要进行优化,而且JIT编译后的本地代码的大小是字节码的10倍以上,如果全部代码编译将耗费大量空间资源,所以对非热点代码做JIT编译再执行,可以说是得不偿失。
上面一个问题提到如果完全依赖JIT由于编译时间会影响服务启动速度,那如果采用AOT的编译模式将代码提前编译好再启动呢?这样的确解决了启动速度牺牲的问题了,但是这样静态编译来的机器指令执行效率虽然比解释器要快,但比起JIT编译的机器指令执行效率还差的远。JIT的优势就是能够借助运行时收集的profile(运行时信息)针对代码做激进优化,而AOT没有运行时信息的支持无法编译出高效的代码。
注:java 9之后,jdk自带有jaotc,其实这个aot编译器就是graal的aot编译器。
由于JIT非常注重profile信息收集和使用,所以JIT编译的时机很关键,编译太早profile收集不充分,无法编译出高效代码,所以在JIT编译之前采用解释器执行的方式,不影响启动速度还能在执行的过程中收集profile,等解释执行一段时间后再触发JIT编译,这样就可以很好的平衡启动速度与收集profile耗时这两方面。
目前HotSpot JVM在进程关闭后会释放编译后的代码和profile,再次启动后系统又需要很长时间的预热才能达到性能巅峰,那有没有可能将编译后的代码或者profile保存下来,在相同的环境下可以再次使用,使系统性能更快的达到巅峰呢。目前市场上有一款商用虚拟机-ZingVM 实现了这一想法。
Zing VM基于HotSpot VM开发,与HotSpot VM的执行模式相似,都是解释器+C1+C2的多层混合模式执行引擎,使用了自适应动态编译。一个程序可以先跑些training run把细粒度profile信息记录下来,后续执行的时候可以跳过原本收集profile的阶段,直接利用之前记录的profile信息来做优化编译。这样就减少了程序启动时收集profile的开销,让程序快速达到稳定的高性能状态。在Zing VM中,不但能通过profile信息来指导优化,还可以指导不做某些过于激进的优化,减少因过度优化而导致的“去优化”(deoptimization)。这样也有利于程序快速达到稳定的性能水平,而不必在过度优化—去优化-再优化-再去优化-⋯的震荡多次后才达到稳定。
三、JVM中可以内联和不能内联的场景
可以内联的固定场景:
- 自动拆箱总被内联
- 指令指定:-XX:CompileCommand中的inline指令指定的方法(c++)
- 注解指定:@ForceInline注解的方法
不能内联的场景:
- Throwable类的方法不能被其他类中的方法内联;
- -XX:CompileCommand中dotinline或exclude指令指定的方法;
- @Dontinline注解的方法;
- 调用字节码对应的符号引用未被解析;
- 目标方法所在的类未被初始化;
- C2不支持内联超过9层的调用(-XX:MaxInlineLevel),以及1层的直接递归调用(-
XX:MaxRecursIninleLevel) - 目标方法是native方法;
这里主要解释一下native方法为什么不能被内联,在反射篇和MethodHandle篇会用到。
我们开发中常用的方法调用 是不满足上述可以内联的固定场景条件的,能否内联完全看JIT是否对其进行优化,一段代码JIT是否会进行优化是通过解释器执行字节码指令时收集的profile(运行时信息)所决定的。而native方法的方法体没有字节码指令,是直接通过本地方法栈执行的。所以native方法不能JIT优化不能被内联到java方法的调用侧。在Hotspot虚拟机的JIT编译器设计的时候就是针对字节码指令进行优化的,而且通常关键的业务热点代码也不会利用native方法实现。
文章最后有一个疑问:
Method.invoke() 最终调用的invoke0()方法是个native方法不能被内联,这也是反射native版本性能低的原因之一,而MethodHandle.invoke()明明也是native方法为什么就可以被内联,而且性能甚至比直接调用还高呢?
这个问题再后面的篇章中会通过分析HotSpot源码找到答案。

 1814


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


