


Spark SQL之创建dataFrame的多种方法
1.Spark SQL是什么
- 官网http://spark.apache.org/sql/
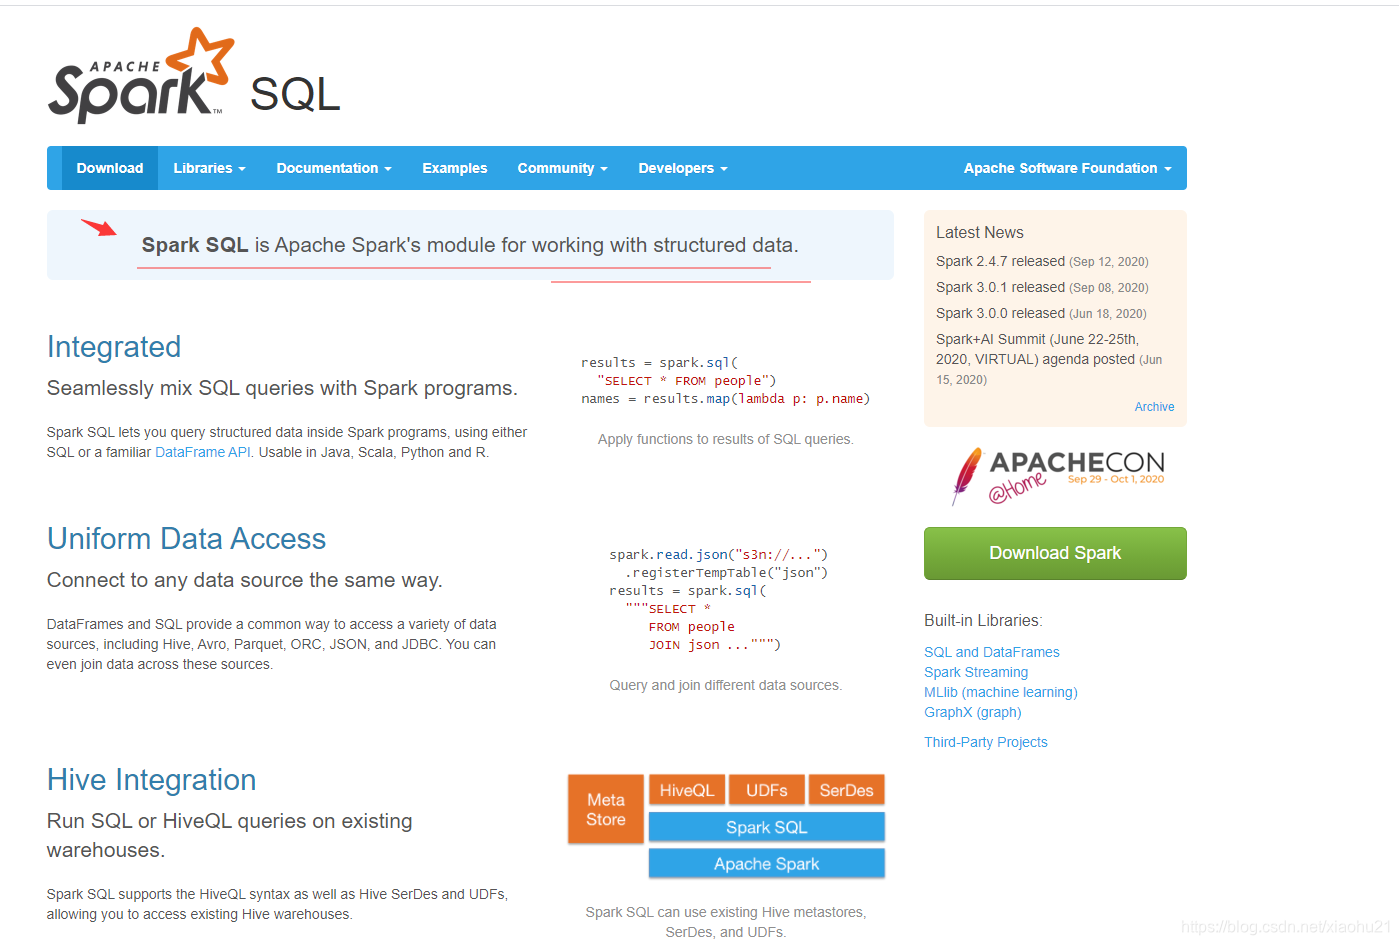
- Spark SQL顾名思义,就是通过SQL来使用Spark强大的数据分析能力,而不用去写代码。类似一Hive,可以将框架的使用门槛极大降低。因为SQL是很多人都会使用的,而编写代码门槛相对高得多。
2. dataFrame是什么
- 官网介绍
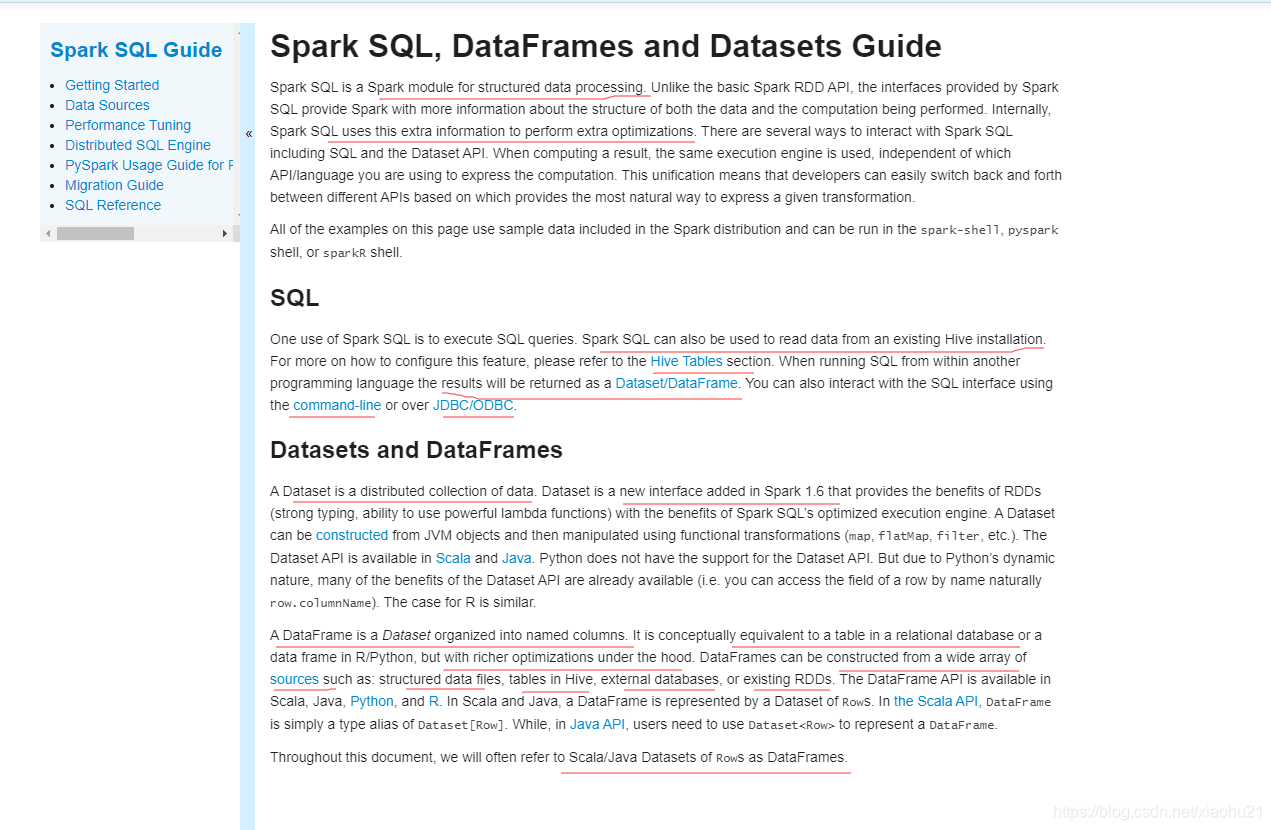
- 和RDD类似,dataFrame也是一个分布式抽象数据容器。并不存储数据,但会存储数据来源,数据操作以及数据结构化信息schema,类似一个数据库的表。
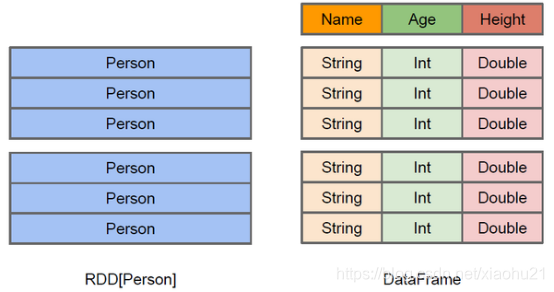
- 和hive类似,也支持嵌套数据类型,struct、map、array等。
- 对比RDD,dataframe的APi抽象层级更高,使用更加友好,门槛更低。
- dataFrame可以理解为RDD+schema,没错,就是mysql中经常听到的元数据,或者说结构信息。
- dataframe上的操作,不管是sql还是dsl的操作,最终是转换为dataframe的操作,而dataframe的操作最终是转换为针对RDD的操作,最终变成分布式物理计划执行并产生结果。
- 跟hive类似,Spark SQL也会对逻辑计划做优化,先拆解,优化逻辑计划,优化物理计划,最后执行。
- Hive则是SQL优化器,解析器将sql解析为逻辑计划,执行器将逻辑计划变为物理计划。
- Tez则是类似Spark的思路,将mapreduce的任务组合为DAG,达到对mapreduce 的提效目的,但本质并没有spark快捷。
3. Spark SQL特性
- 易集成
- 统一数据访问格式
- Hive集成方便
- 标准链接,可以使用JDBC等链接
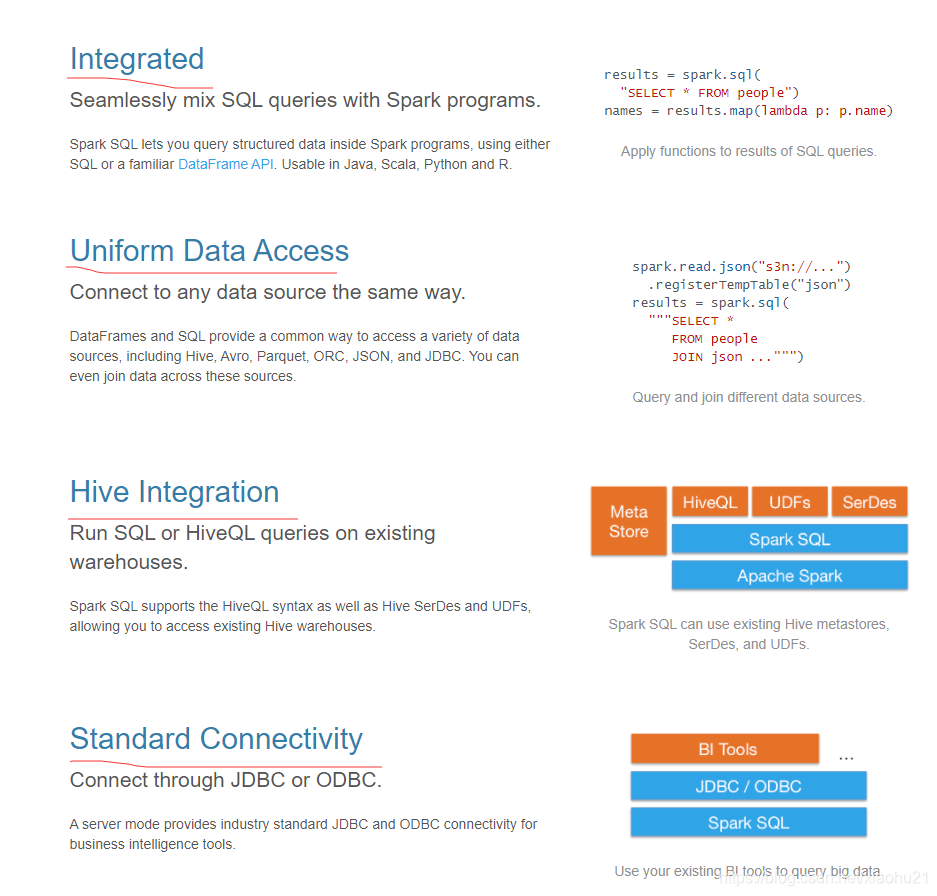
- 性能和可扩展性
- 社区庞大
4. 如何创建dataFrame
环境准备
- Idea 2020
- jdk1.8
- scala 2.12.12
- maven 3.6.3
- pom文件
<!-- 定义了一些常量 -->
    <properties>
        <maven.compiler.source>1.8</maven.compiler.source>
        <maven.compiler.target>1.8</maven.compiler.target>
        <scala.version>2.12.10</scala.version>
        <spark.version>3.0.1</spark.version>
        <hbase.version>2.2.5</hbase.version>
        <hadoop.version>3.2.1</hadoop.version>
        <encoding>UTF-8</encoding>
    </properties>

    <dependencies>
        <!-- 导入scala的依赖 -->
        <dependency>
            <groupId>org.scala-lang</groupId>
            <artifactId>scala-library</artifactId>
            <version>${scala.version}</version>
            <!-- 编译时会引入依赖,打包是不引入依赖 -->
            <!--            <scope>provided</scope>-->
        </dependency>

        <!-- https://mvnrepository.com/artifact/org.apache.httpcomponents/httpclient -->
        <dependency>
            <groupId>org.apache.httpcomponents</groupId>
            <artifactId>httpclient</artifactId>
            <version>4.5.12</version>
        </dependency>

        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-sql_2.12</artifactId>
            <version>${spark.version}</version>
        </dependency>

        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-core_2.12</artifactId>
            <version>${spark.version}</version>
            <!-- 编译时会引入依赖,打包是不引入依赖 -->
            <!--            <scope>provided</scope>-->
        </dependency>

        <!-- https://mvnrepository.com/artifact/com.alibaba/fastjson -->
        <dependency>
            <groupId>com.alibaba</groupId>
            <artifactId>fastjson</artifactId>
            <version>1.2.73</version>
        </dependency>

        <!-- https://mvnrepository.com/artifact/mysql/mysql-connector-java -->
        <dependency>
            <groupId>mysql</groupId>
            <artifactId>mysql-connector-java</artifactId>
            <version>5.1.47</version>
        </dependency>

    </dependencies>

    <build>
        <pluginManagement>
            <plugins>
                <!-- 编译scala的插件 -->
                <plugin>
                    <groupId>net.alchim31.maven</groupId>
                    <artifactId>scala-maven-plugin</artifactId>
                    <version>3.2.2</version>
                </plugin>
                <!-- 编译java的插件 -->
                <plugin>
                    <groupId>org.apache.maven.plugins</groupId>
                    <artifactId>maven-compiler-plugin</artifactId>
                    <version>3.5.1</version>
                </plugin>
            </plugins>
        </pluginManagement>
        <plugins>
            <plugin>
                <groupId>net.alchim31.maven</groupId>
                <artifactId>scala-maven-plugin</artifactId>
                <executions>
                    <execution>
                        <id>scala-compile-first</id>
                        <phase>process-resources</phase>
                        <goals>
                            <goal>add-source</goal>
                            <goal>compile</goal>
                        </goals>
                    </execution>
                    <execution>
                        <id>scala-test-compile</id>
                        <phase>process-test-resources</phase>
                        <goals>
                            <goal>testCompile</goal>
                        </goals>
                    </execution>
                </executions>
            </plugin>

            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-compiler-plugin</artifactId>
                <executions>
                    <execution>
                        <phase>compile</phase>
                        <goals>
                            <goal>compile</goal>
                        </goals>
                    </execution>
                </executions>
            </plugin>

            <!-- 打jar插件 -->
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-shade-plugin</artifactId>
                <version>2.4.3</version>
                <executions>
                    <execution>
                        <phase>package</phase>
                        <goals>
                            <goal>shade</goal>
                        </goals>
                        <configuration>
                            <filters>
                                <filter>
                                    <artifact>*:*</artifact>
                                    <excludes>
                                        <exclude>META-INF/*.SF</exclude>
                                        <exclude>META-INF/*.DSA</exclude>
                                        <exclude>META-INF/*.RSA</exclude>
                                    </excludes>
                                </filter>
                            </filters>
                        </configuration>
                    </execution>
                </executions>
            </plugin>
        </plugins>
    </build>
4.1 从RDD创建DataFrame
- 使用case class创建,DSL API
def main(args: Array[String]): Unit = {
    // dataframe是在RDD基础上更高层级的抽象,包含数据以及数据的schema信息,
    // 注意本身dataframe并不会存储数据,和RDD一样,只会记录数据来源,数据操作,还有schema数据结构信息
    val sparkSession: SparkSession = SparkSession.builder()
      .appName("DataFrameFromRDD_CaseClass")
      .master("local[*]")
      .getOrCreate()

    // 获取sparkContext对象,注意这里sparkSession中持有一个sparkContext对象,
    // 所以也可以看做sparkSession是一个sparkContext的包装类,但更加强大
    val sparkContext: SparkContext = sparkSession.sparkContext

    //   E:\DOITLearning\12.Spark\date.txt
    //   2020-08-15 10:10:10
    // 先创建RDD,
    val rdd1: RDD[String] = sparkContext.textFile("E:\\DOITLearning\\12.Spark\\date.txt")

    // RDD的数据处理
    val mapedRDD: RDD[DateModel] = rdd1.mapPartitions(iter => {
      val simpleDateFormat = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss")

      iter.map(line => {
        val date: Date = simpleDateFormat.parse(line)

        DateModel(date.getYear, date.getMonth, date.getDay)
      })
    })

    // 这里使用sparkSession对象中的隐式转换,导入时需要先创建一个对象
    import sparkSession.implicits._
    val dataFrame: DataFrame = mapedRDD.toDF()

    // DSL特定领域语言风格API处理,不需要注册视图
    import  org.apache.spark.sql.functions._
    dataFrame.select("year", "day").where($"day" >= 5).show()


    val res2: DataFrame = dataFrame.agg(avg("day") as "avg_day")
    res2.show()

    sparkSession.close()
  }
- 使用case class创建,SQL风格
object DataFrameFromRDD_CaseClass {
  def main(args: Array[String]): Unit = {

    // dataframe是在RDD基础上更高层级的抽象,包含数据以及数据的schema信息,
    // 注意本身dataframe并不会存储数据,和RDD一样,只会记录数据来源,数据操作,还有schema数据结构信息
    val sparkSession: SparkSession = SparkSession.builder()
      .appName("DataFrameFromRDD_CaseClass")
      .master("local[*]")
      .getOrCreate()

    // 获取sparkContext对象,注意这里sparkSession中持有一个sparkContext对象,
    // 所以也可以看做sparkSession是一个sparkContext的包装类,但更加强大
    val sparkContext: SparkContext = sparkSession.sparkContext

    //   E:\DOITLearning\12.Spark\date.txt
    //   2020-08-15 10:10:10
    // 先创建RDD,
    val rdd1: RDD[String] = sparkContext.textFile("E:\\DOITLearning\\12.Spark\\date.txt")

    // RDD的数据处理
    val mapedRDD: RDD[DateModel] = rdd1.mapPartitions(iter => {
      val simpleDateFormat = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss")

      iter.map(line => {
        val date: Date = simpleDateFormat.parse(line)

        DateModel(date.getYear, date.getMonth, date.getDay)
      })
    })

    // 这里使用sparkSession对象中的隐式转换,导入时需要先创建一个对象
    import sparkSession.implicits._
    val dataFrame: DataFrame = mapedRDD.toDF()

    // 创建一个session临时视图,这个是session级别的视图
    dataFrame.createTempView("v_temp_dateinfo")

    // 这个是application级别的
    dataFrame.createGlobalTempView("v_global_dateinfo")

    // 打印schema信息
    dataFrame.printSchema()

    // show 默认是20条数据
    dataFrame.show( 5)

    sparkSession.close()
  }
}

// 因为dataframe中既有数据来源,数据处理逻辑,也要包含schema信息,
// 使用case class可以使用反射获取schema信息
// schema信息有时候又称之为元数据,其实就是结构化数据的字段,字段类型等信息
case class DateModel(year: Int, month: Int, day: Int)
- 结合StructType创建
def main(args: Array[String]): Unit = {

    val sparkSession: SparkSession = SparkSession.builder()
      .appName("DataframeFromRDD_StructType")
      .master("local")
      .getOrCreate()

    val sparkContext: SparkContext = sparkSession.sparkContext

    //  E:\DOITLearning\12.Spark\netflowRollupSourceData.txt
    // 1,2020-02-18 15:37:23,2020-02-18 16:05:26,40
    val rdd1: RDD[String] = sparkContext.textFile("E:\\DOITLearning\\12.Spark\\netflowRollupSourceData.txt")

    // 将数据以Row形式组织起来
    val mapRDD: RDD[Row] = rdd1.map(line => {
      val strings: Array[String] = line.split(",")

      var row: Row = null

      try {
        val uid: String = strings(0)
        val startDate: String = strings(1)
        val endDate: String = strings(2)
        val netFlow: Double = strings(3).toDouble

        // 注意,这里的类型,以及后续的structtype类型需要一一匹配,否则就会出错
        row = Row(uid, startDate, endDate, netFlow)
      } catch {
        case e:Exception =>{
          e.printStackTrace()
        }
      }

      row
    }).filter(ele=> ele != null)

    // 创建结构化schema信息,注意这里要求是Seq,也就是有序集合,
    // 因为需要按照顺序去解析每个列的字段信息
    val structType: StructType = StructType(List(
      StructField("uid", DataTypes.StringType),
      StructField("startDate", DataTypes.StringType, false),
      StructField("endDate", DataTypes.StringType, false),
      StructField("netFlow", DataTypes.DoubleType, false),
    ))

    // 通过RDD以及对应的schema信息,创建dataFrame对象
    val dataFrame: DataFrame = sparkSession.createDataFrame(mapRDD, structType)

    // 打印schema信息
    dataFrame.printSchema()

    // 显示数据
    dataFrame.show()

    Thread.sleep(2000000000)

    sparkSession.close()
  }
- 结合tuple创建
def main(args: Array[String]): Unit = {

    val sparkSession: SparkSession = SparkSession.builder()
      .appName("DataframeFromRDD_Tuple")
      .master("local")
      .getOrCreate()

    val sparkContext: SparkContext = sparkSession.sparkContext

    val rdd1: RDD[String] = sparkContext.textFile("E:\\DOITLearning\\12.Spark\\netflowRollupSourceData.txt")

    // 将数据以元组形式组织起来
    val mapRDD: RDD[(String, String, String, Double)] = rdd1.map(line => {
      val strings: Array[String] = line.split(",")

      val uid: String = strings(0)
      val startDate: String = strings(1)
      val endDate: String = strings(2)
      val netFlow: Double = strings(3).toDouble

      (uid, startDate, endDate, netFlow)
    })

    // 导入sparkSession这个对象中定义的隐式转换
    import sparkSession.implicits._

    // 在转换toDF时,指定column的名字,不指定的话,就会以元组的序号作为默认的列名
//    val dataFrame: DataFrame = mapRDD.toDF("uid", "startDate", "endDate", "netFlow")

    //  _1  _2  _3  _4
    val dataFrame: DataFrame = mapRDD.toDF()

    // 打印schema信息
    dataFrame.printSchema()

    // 展示数据,默认是20条
    dataFrame.show()

    sparkSession.close()
  }
4.2 从结构化文件创建DataFrame
- 从带表头的CSV文件创建\
def main(args: Array[String]): Unit = {
    val sparkSession: SparkSession = SparkSession.builder()
      .appName("DataFrameFromFile_CSV_Titled")
      .master("local")
      .getOrCreate()


    // csv可以自动推断类型,但手动设置更加高效和准确,
    // 例如价格如果刚好都是整数形式,但实际要求浮点,但自动推断时会推断为整数类型
    val structType: StructType = StructType(List(
      StructField("color", DataTypes.StringType, false),
      StructField("price", DataTypes.DoubleType, false),
      StructField("brand", DataTypes.StringType, false),
      StructField("model", DataTypes.StringType, false)
    ))

    // 读取带表头的csv文件 color,price,brand,model
    // E:\DOITLearning\12.Spark  title_csv_src.csv
    val dataFrame: DataFrame = sparkSession.read
      .option("delimiter", ",")
      .option("header", true)
      /*.option("inferschema", true)*/
      .schema(structType)
      .csv("E:\\DOITLearning\\12.Spark\\title_csv_src.csv")

    dataFrame.show()

    // 将数据保存为parquet格式
    dataFrame.write.parquet("E:\\DOITLearning\\12.Spark\\parquet_src")

    sparkSession.close()
  }
- 从不带表头的CSV文件创建1
def main(args: Array[String]): Unit = {

    // csv文件是可以设置表头的,本案例不展示,另有案例展示
    val sparkSession: SparkSession = SparkSession.builder()
      .appName("DataFrameFromFile_CSV_Untitled")
      .master("local")
      .getOrCreate()

    //  E:\DOITLearning\12.Spark  wc.txt
    //  cannot assign instance of java.lang.invoke.SerializedLambda to field org
    /*
    * .option("delimiter", "|") 分割符号
      .option("header", "true")  表头
      .option("quote", "'")      注释
      .option("nullValue", "\\N") 空值
      .option("inferSchema", "true") 自动推断类型
    * */
    val dataFrame: DataFrame = sparkSession.read.option("delimiter", " ").csv("E:\\DOITLearning\\12.Spark\\wc.txt")

    // 如果设置的列名数量和实际不匹配
    // IllegalArgumentException: requirement failed: The number of columns doesn't match.
    dataFrame.toDF("word1", "word2", "word3", "word4", "word5", "word6", "word7", "word8")


    // 也可以使用structType方式设置schema信息
    val structType: StructType = StructType(List(
      StructField("word1", DataTypes.StringType, false),
      StructField("word2", DataTypes.StringType, false),
      StructField("word3", DataTypes.StringType, false),
      StructField("word4", DataTypes.StringType, false),
      StructField("word5", DataTypes.StringType, false),
      StructField("word6", DataTypes.StringType, true),
      StructField("word7", DataTypes.StringType, true),
      StructField("word8", DataTypes.StringType, true),
    ))

    sparkSession.read.schema(structType).csv()

    dataFrame.show()
  }
- 从不带表头的CSV文件创建2
def main(args: Array[String]): Unit = {
    // csv文件是可以设置表头的,本案例不展示,另有案例展示
    val sparkSession: SparkSession = SparkSession.builder()
      .appName("DataFrameFromFile_CSV_Untitled")
      .master("local")
      .getOrCreate()

    // 也可以使用structType方式设置schema信息
    val structType: StructType = StructType(List(
      StructField("word1", DataTypes.StringType, false),
      StructField("word2", DataTypes.StringType, false),
      StructField("word3", DataTypes.StringType, false),
      StructField("word4", DataTypes.StringType, false),
      StructField("word5", DataTypes.StringType, false),
      StructField("word6", DataTypes.StringType, true),
      StructField("word7", DataTypes.StringType, true),
      StructField("word8", DataTypes.StringType, true),
    ))

    //  E:\DOITLearning\12.Spark  wc.txt
    //  cannot assign instance of java.lang.invoke.SerializedLambda to field org
    /*
    * .option("delimiter", "|") 分割符号
      .option("header", "true")  表头
      .option("quote", "'")      注释
      .option("nullValue", "\\N") 空值
      .option("inferSchema", "true") 自动推断类型
    * */
    // 读取时,就设置schema信息,设置分割符号
    val dataFrame: DataFrame = sparkSession.read
      .option("delimiter", " ")
      .schema(structType)
      .csv("E:\\DOITLearning\\12.Spark\\wc.txt")

    dataFrame.show()

    sparkSession.close()
  }
- 从json文件创建
def main(args: Array[String]): Unit = {

    val sparkSession: SparkSession = SparkSession.builder()
      .appName("DataFrameFromFile_JSON")
      .master("local")
      .getOrCreate()

    // cong JSON读取数据
    // E:\DOITLearning\12.Spark\json_test_src.json
    val dataFrame: DataFrame = sparkSession.read.json("E:\\DOITLearning\\12.Spark\\json_test_src2.json")

    dataFrame.show()

    // 在针对dataframe使用sql之前,先将其注册为视图,类似一个表一样
    dataFrame.createTempView("v_test")

    // 查询数据,DSL风格
    dataFrame.select("email", "firstName").where("firstname='Brett'").show()

    sparkSession.close()
  }
- 从parquet文件创建
def main(args: Array[String]): Unit = {

    val sparkSession: SparkSession = SparkSession.builder()
      .appName("DataFrameFromFile_Parquet")
      .master("local")
      .getOrCreate()

    // 注意,这里给的是parquet文件所在的目录
    val dataFrame: DataFrame = sparkSession.read.parquet("E:\\DOITLearning\\12.Spark\\parquet_src")

    dataFrame.printSchema()
    dataFrame.show()

    dataFrame.select("price").where("price > 300").show()

    sparkSession.close()
  }
注意,这里比较特殊的是parquet格式文件,因为这个格式文件中自带索引和schema信息,因此不需要额外指定schema,同时自带压缩,列式存储等特性,是spark最推荐的一种文件格式
4.3 从外部服务器读取数据创建DataFrame
- 从JDBC创建
def main(args: Array[String]): Unit = {

    val sparkSession: SparkSession = SparkSession.builder()
      .appName("DataFrameFrom_JDBC")
      .master("local")
      .getOrCreate()

    val properties = new Properties()
    properties.setProperty("user", "root")
    properties.setProperty("password", "123456")

    // 通过jdbc,则可以访问支持jdbc的各种数据存储库,不局限于mysql了
    val dataFrame: DataFrame = sparkSession.read.jdbc("jdbc:mysql://localhost:3306/db_demo1?characterEncoding=utf-8", "tb_user", properties)

    // jdbc连接数据库中,既有数据,也有schema信息,可以直接生成dataframe,也就是类似表的对象
    // 这也可以看出,大数据的处理方式,一般都是将非结构化数据,半结构化转换为结构化数据再进行处理。
    // 因为结构化之后的数据处理技术相对最成熟,使用门槛结合sql之后,也有更低的门槛
    dataFrame.show()

    sparkSession.close()
  }
4.4 总结
- dataframe可以看做是RDD+schema,所以只要有数据,有对应结构化信息,就可以转换为dataFrame
- dataFrame可以看作是特殊化的dataset,因为包含了结构化信息
- 大数据处理中,一般会想办法将非结构化和板结构化数据转换为结构化数据再处理。因为
- 结构化数据处理可以使用SQL,使用门槛和难度较低
- 结构化数据处理技术相对最成熟,可以很好利用已有的技术优化和实现思路甚至直接使用现有的第三方库
- 结构化数据也更符合人的思维模式,开发和使用更便利




 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


