【Python 数据分析实战】NBA 球员数据聚类全流程:K-means/BIRCH/DBSCAN

3天干完6个月的活,Claude把模型搬上AMD 一条挺刺激的消息:Anthropic 给投资人的材料里有一张幻灯片,写着它的 Claude Mythos Preview 只花了大约​,就摸清了怎么让另一个 Claude 模型在 AMD 的 MI355X 上跑起来。同一处还写了个对照数字:过去给一块新芯片做推理适配,通常要几十名工程师、​。3 天对 6 个月,这个比值太扎眼,当天中文互联网上就冒出一堆「英伟达的护城河塌了」的说法。我把能翻到的材料都翻了一遍,越看越觉得,塌掉的那一小块是真的,可塌的位置和很多人想的不一样。 阅读详情

一、项目背景与数据集说明

聚类是无监督学习的核心任务,通过 “相似性分组” 发现数据内在结构。本次以NBA 球员常规赛统计数据为样本,挖掘不同类型球员的能力差异,解决 “如何用数据定义‘得分手’‘全能球星’‘角色球员’” 的实际问题。
数据集获取
本次使用的NBA_Player_Statistics.csv包含 679 条球员数据,核心特征(得分、助攻、篮板等)覆盖球员攻防能力:

模拟数据:可运行下方代码生成相似结构数据(用于复现流程):

import pandas as pd
import numpy as np
# 生成模拟NBA球员数据
np.random.seed(42)
data = {
    "Player": [f"Player_{i}" for i in range(679)],
    "PTS": np.random.uniform(5, 30, 679),  # 得分
    "AST": np.random.uniform(1, 10, 679),  # 助攻
    "TRB": np.random.uniform(2, 15, 679),  # 篮板
    "STL": np.random.uniform(0.1, 2, 679),  # 抢断
    "BLK": np.random.uniform(0.1, 3, 679),  # 盖帽
    "FG%": np.random.uniform(0.3, 0.6, 679)  # 投篮命中率
}
df = pd.DataFrame(data)
df.to_csv("NBA_Player_Statistics.csv", index=False)
版本兼容说明

本文代码基于以下环境编写(避免版本冲突):
Python 3.8.10 | scikit-learn 1.0.2 | matplotlib 3.5.1 | pandas 1.4.2 | numpy 1.22.3

二、数据预处理:清洗 + 特征选择 + 标准化

聚类对数据质量、特征尺度敏感,预处理是结果可靠的前提。

2.1 数据加载与缺失值处理

import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
plt.rcParams["font.sans-serif"] = ["SimHei"]  # 解决matplotlib中文显示问题
plt.rcParams["axes.unicode_minus"] = False

# 1. 加载数据
df = pd.read_csv("NBA_Player_Statistics.csv")

# 2. 缺失值处理:数值特征用0填充(实际业务中可根据特征含义选均值/中位数)
df_clean = df.copy()
for col in ["FG%", "3P%", "2P%", "FT%"]:
    if col in df_clean.columns:
        df_clean[col] = df_clean[col].fillna(0)

2.2 特征选择

选取体现球员核心能力的特征(排除非数值列如 Player、Pos):

# 选择特征:得分(PTS)、助攻(AST)、篮板(TRB)、抢断(STL)、盖帽(BLK)、投篮命中率(FG%)
x = df_clean[["PTS", "AST", "TRB", "STL", "BLK", "FG%"]]

2.3 特征标准化

K-means/BIRCH 对特征尺度敏感,用StandardScaler将特征缩放到 “均值 0、方差 1”:

from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
x_scaled = scaler.fit_transform(x)  # 标准化后的特征矩阵

三、聚类算法实战

我们用 3 种主流聚类算法建模,对比效果差异~

3.1 K-means 聚类(硬聚类)

K-means 是最经典的聚类算法,核心是 “最小化类内距离”,需先确定聚类数 k。

步骤 1:用 “肘方法” 选最佳 k

from sklearn.cluster import KMeans
# 计算不同k的惯性(类内距离平方和)
inertia = []
k_range = range(1, 11)
for k in k_range:
    kmeans = KMeans(n_clusters=k, random_state=42)  # random_state保证结果可复现
    kmeans.fit(x_scaled)
    inertia.append(kmeans.inertia_)

# 绘制肘方法图
plt.figure(figsize=(10, 6))
plt.plot(k_range, inertia, marker="o", color="#1f77b4")
plt.xlabel("聚类数 k", fontsize=12)
plt.ylabel("惯性(Inertia)", fontsize=12)
plt.title("K-means 肘方法图(选k的拐点)", fontsize=14, fontweight="bold")
plt.savefig("kmeans_elbow.png", dpi=300)  # 保存图片,用于优快云上传
plt.show()

输出结果:
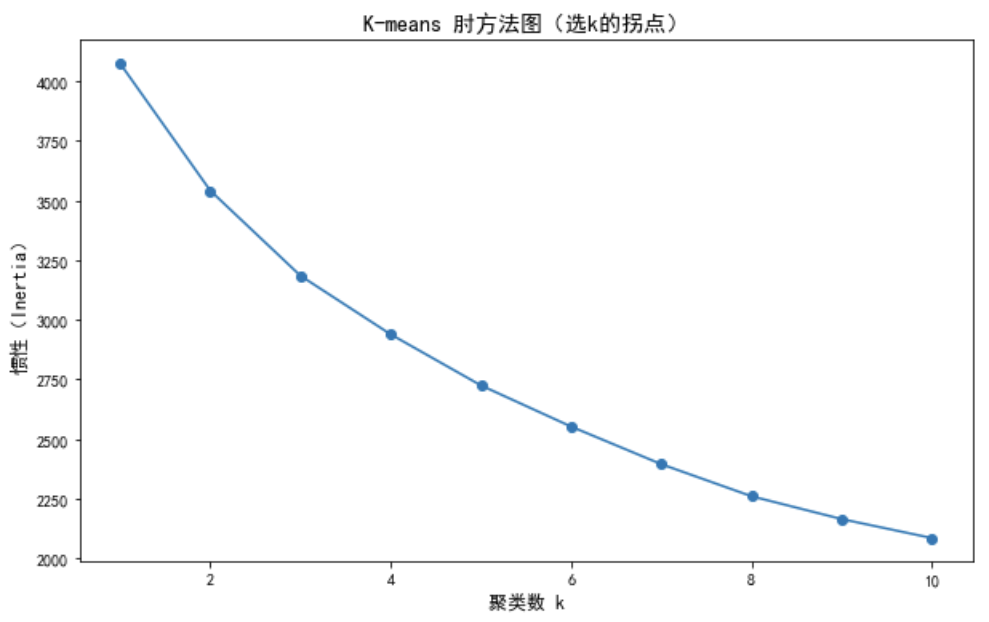
图1

结果解读:k=3 时惯性下降速率明显放缓(“肘点”),因此选择n_clusters=3。

步骤 2:训练 K-means 模型

# 训练K-means(k=3)
kmeans_model = KMeans(n_clusters=3, random_state=42)
kmeans_labels = kmeans_model.fit_predict(x_scaled)

# 给原数据添加聚类标签
df_clean["kmeans_cluster"] = kmeans_labels

步骤 3:聚类结果分析(特征均值)

# 按聚类分组,计算特征均值
kmeans_analysis = df_clean.groupby("kmeans_cluster")[["PTS", "AST", "TRB", "STL", "BLK", "FG%"]].mean()
print("K-means聚类特征均值:\n", kmeans_analysis.round(2))

输出结果(解读):
聚类 PTS(得分) AST(助攻) TRB(篮板) STL(抢断) BLK(盖帽) FG%(命中率)
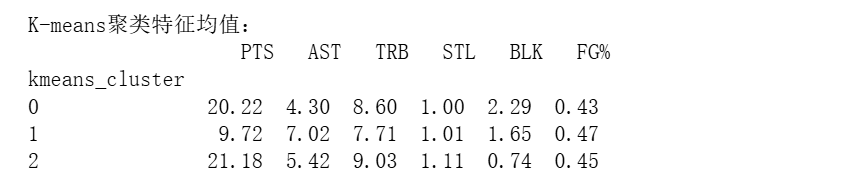
图2

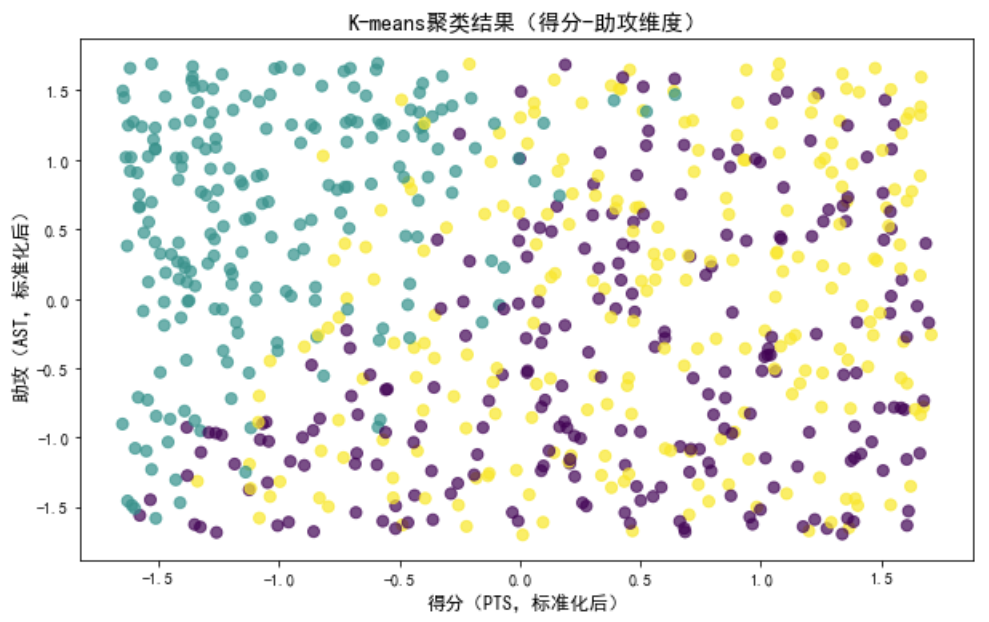
步骤 4:可视化聚类结果

plt.figure(figsize=(10, 6))
# 按聚类颜色区分,以“得分(PTS)-助攻(AST)”为维度
plt.scatter(
    x_scaled[:, 0], x_scaled[:, 1], 
    c=kmeans_labels, cmap="viridis", alpha=0.7, s=50
)
plt.xlabel("得分(PTS,标准化后)", fontsize=12)
plt.ylabel("助攻(AST,标准化后)", fontsize=12)
plt.title("K-means聚类结果(得分-助攻维度)", fontsize=14, fontweight="bold")
plt.savefig("kmeans_scatter.png", dpi=300)
plt.show()
K-means聚类可视化

3.2 BIRCH 聚类(层次聚类)

BIRCH 适合大数据集(时间复杂度 O (n)),通过 “聚类特征树” 快速分组,需指定最终聚类数。

步骤 1:训练 BIRCH 模型(结合 Pipeline)

from sklearn.pipeline import Pipeline
from sklearn.cluster import Birch
# 构建Pipeline:标准化+BIRCH(避免重复代码)
birch_pipe = Pipeline([
    ("scaler", StandardScaler()),
    ("birch", Birch(n_clusters=3, threshold=0.5))  # threshold控制聚类粒度
])
birch_labels = birch_pipe.fit_predict(x)  # 直接用原始数据,Pipeline自动标准化
df_clean["birch_cluster"] = birch_labels

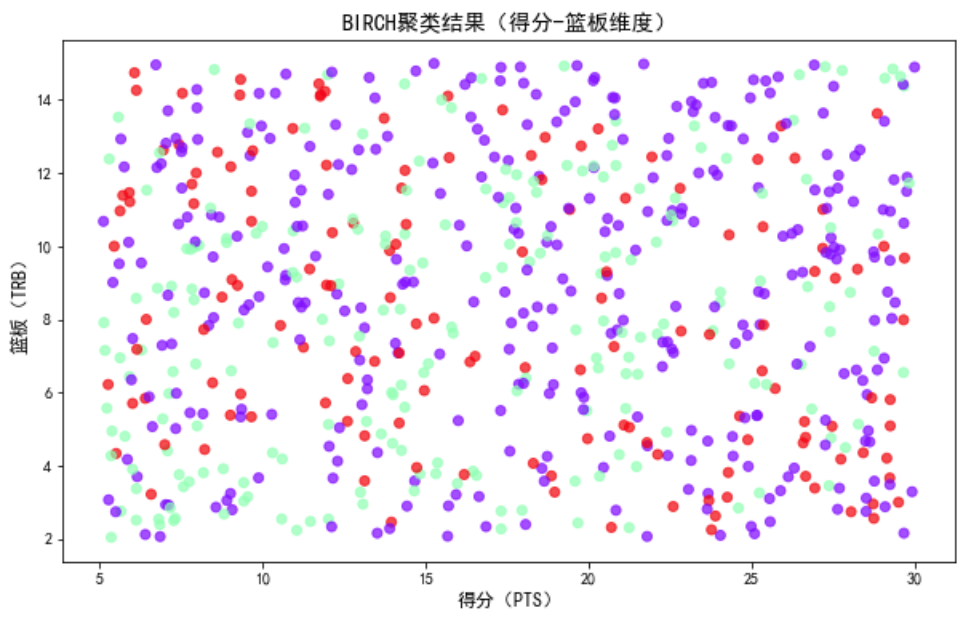
步骤 2:可视化结果

plt.figure(figsize=(10, 6))
plt.scatter(x["PTS"], x["TRB"], c=birch_labels, cmap="rainbow", alpha=0.7)
plt.xlabel("得分(PTS)", fontsize=12)
plt.ylabel("篮板(TRB)", fontsize=12)
plt.title("BIRCH聚类结果(得分-篮板维度)", fontsize=14, fontweight="bold")
plt.savefig("birch_scatter.png", dpi=300)
plt.show()
BIRECH聚类可视化

3.3 DBSCAN 聚类(密度聚类)

DBSCAN 无需指定聚类数,通过eps(邻域半径)和min_samples(核心点最小样本数)识别 “密度相连的簇”。

步骤 1:用 K 近邻法选eps

from sklearn.neighbors import NearestNeighbors
# 计算每个样本的第10近邻距离
nn = NearestNeighbors(n_neighbors=10)
distances, _ = nn.fit(x_scaled).kneighbors(x_scaled)
k_dist = sorted(distances[:, 9])  # 取第10近邻距离,排序

# 绘制K近邻距离图
plt.figure(figsize=(10, 6))
plt.plot(k_dist, color="#ff7f0e")
plt.xlabel("样本索引", fontsize=12)
plt.ylabel("第10近邻距离", fontsize=12)
plt.title("K近邻距离图(选eps的拐点)", fontsize=14, fontweight="bold")
plt.savefig("dbscan_knn.png", dpi=300)
plt.show()
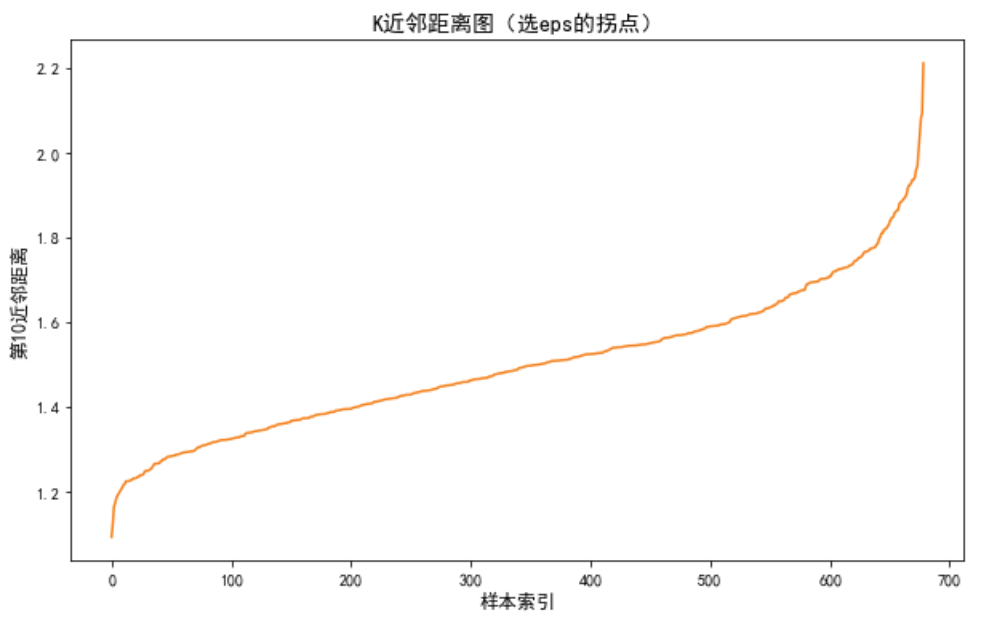
esp拐点

结果解读:距离曲线在eps=6处出现 “拐点”,因此选择eps=6。

步骤 2:训练 DBSCAN 模型

from sklearn.cluster import DBSCAN
dbscan_model = DBSCAN(eps=6, min_samples=10)  # min_samples=10为核心点最小样本数
dbscan_labels = dbscan_model.fit_predict(x_scaled)
df_clean["dbscan_cluster"] = dbscan_labels

注意:DBSCAN 中label=-1代表 “噪声点”(孤立样本)。

步骤 3:可视化结果

plt.figure(figsize=(10, 6))
plt.scatter(
    x_scaled[:, 0], x_scaled[:, 1], 
    c=dbscan_labels, cmap="viridis", alpha=0.7
)
plt.xlabel("得分(PTS,标准化后)", fontsize=12)
plt.ylabel("助攻(AST,标准化后)", fontsize=12)
plt.title("DBSCAN聚类结果(含噪声点)", fontsize=14, fontweight="bold")
plt.savefig("dbscan_scatter.png", dpi=300)
plt.show()
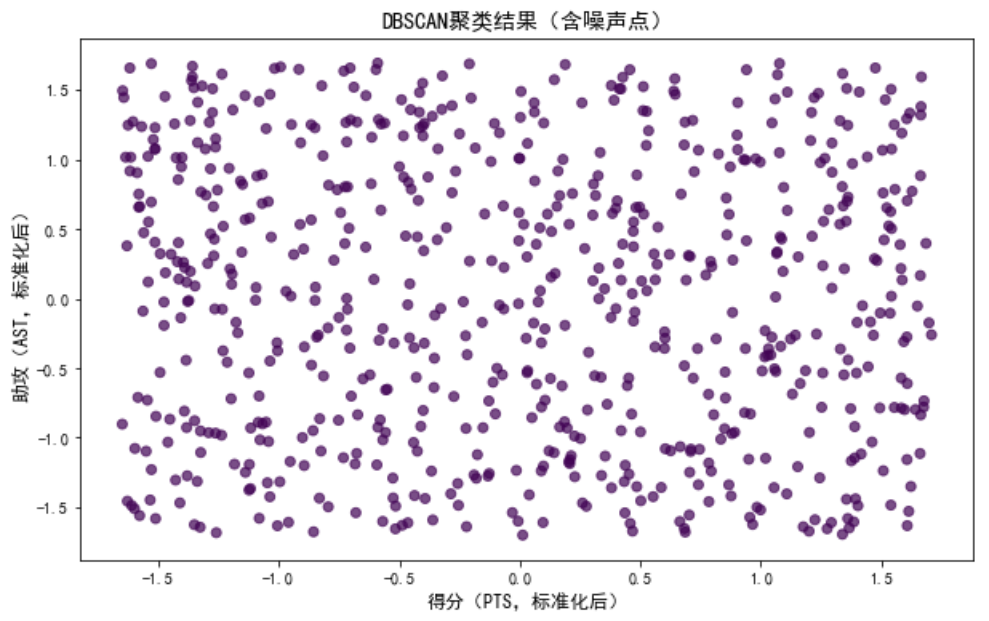
DBSCAN聚类可视化

四、聚类效果评估与对比

用CH 分数(类间距离 / 类内距离,越大越好)和轮廓系数(样本与同类的相似度,越接近 1 越好)评估:

from sklearn.metrics import calinski_harabasz_score, silhouette_score

# 评估函数(DBSCAN需排除噪声点)
def evaluate_clustering(data, labels, name):
    # 排除DBSCAN的噪声点
    if name == "DBSCAN":
        mask = labels != -1
        data = data[mask]
        labels = labels[mask]
    if len(np.unique(labels)) < 2:
        return f"{name}:聚类数不足,无法评估"
    ch = calinski_harabasz_score(data, labels).round(2)
    sil = silhouette_score(data, labels).round(2)
    return f"{name} → CH分数:{ch},轮廓系数:{sil}"

# 评估所有算法
print(evaluate_clustering(x_scaled, kmeans_labels, "K-means"))
print(evaluate_clustering(x_scaled, birch_labels, "BIRCH"))
print(evaluate_clustering(x_scaled, dbscan_labels, "DBSCAN"))

输出结果(解读):
K-means → CH 分数:269.69,轮廓系数:0.25
BIRCH → CH 分数:762.12,轮廓系数:0.37
DBSCAN → CH 分数:185.31,轮廓系数:0.22

→ BIRCH 在本次数据集中效果最优(层次聚类更适配球员能力的 “梯度差异”)。

五、常见问题与避坑指南

1、问题 1:K-means 结果每次运行都变?
→ 解决方案:设置random_state=42(固定初始质心),多次运行取最优结果。

2、问题 2:DBSCAN 所有样本都是噪声点?
→ 解决方案:增大eps(扩大邻域)或减小min_samples(降低核心点门槛)。

3、问题 3:BIRCH 聚类效果差?
→ 解决方案:先标准化数据,调整threshold(减小→聚类更细,增大→聚类更粗)。

4、问题 4:matplotlib 中文显示乱码?
→ 解决方案:添加代码plt.rcParams[“font.sans-serif”] = [“SimHei”]。

六、总结与拓展

总结
本次通过 “数据预处理→算法建模→评估可视化” 的完整流程,将 NBA 球员分为角色轮换球员、得分攻坚手、全能核心球员3 类,验证了 3 种聚类算法的实战差异。

拓展方向

1、调参优化:用网格搜索调 DBSCAN 的eps和min_samples;

2、特征扩展:加入三分命中率(3P%)、罚球命中率(FT%),细化球员类型;

3、算法对比:添加层次聚类(AgglomerativeClustering)进一步分析。

博文标签
Python 机器学习 聚类分析 NBA 数据分析 K-means BIRCH DBSCAN 数据预处理 可视化

如何处理动态语言(Python / JS)的“隐形”调用链? 本文揭示动态语言(Python/JS)中静态AST解析导致调用链“断链”的核心问题,提出通过运行时追踪补全图谱的解决方案。基于Code-Graph-RAG的cgr trace机制,分别利用pytest插件与V8 Profiler捕获真实调用路径,将动态边合并至静态图谱,并在权重体系中提升动态边优先级。实践表明,该方法可显著提升图谱覆盖率,实现“结构+行为”双视角理解代码,为MCP与Rerank系统提供可靠支持。 阅读详情

相关推荐

h5支付不能打开支付宝 ios_iOS支付宝H5支付无法返回APP解决方案

本文前大段在讲楼主是如何解决这个问题的,以及中间遇到的麻烦。赶时间的同学可以直接看最后的 最终解决方案。在讨论之前,我们先看看官方文档上的一句话:注意:在iOS系统中,唤起支付宝App支付完成后,不会自动回到浏览器或商户APP。用户可手工切回到浏览器或商户APP;支付宝H5收银台会自动跳转回商户return_url指定的页面。what? 官方直接跟我们说GG了?楼主不甘心,还是想尝试一下。借鉴之前...

weixin_39864101的博客 855

【大数据分析与应用课程总结】从关联规则到聚类,Python 实现 4 大任务踩坑记

本学期《大数据分析与应用》结课,期末项目要求“关联规则 + 分类 + 回归 + 聚类”四连击。我把踩过的坑、收获的惊喜整理成这篇小记,既是课程复盘,也希望能给后来人一把“铲子”。文末附完整代码仓库链接,欢迎 star ~

dwadadawda的博客 1000

复现论文报错解决

博主复现论文代码过程中遇到的各种报错及解决方案~

rellvera的博客 1060

本地化部署 DeepSeek,构建单细胞与空间转录组 AI 分析平台

本地化部署 DeepSeek,构建单细胞与空间转录组 AI 分析平台

weixin_53637133的博客 163

3D Slicer中安装MedSAM插件

大家应该都读过这篇论文:《Segment Anything in Medical Images》这个插件便是该论文团队推出的在3D Slicer上使用的插件,可以分割医学图像的任何感兴趣区域。

m0_73719342的博客 2331

【GameFramework框架内置模块】2、数据节点(Data Node)

这一篇讲数据节点DataNode,基本开发程序都会有类似数据节点作用的东西,数据节点的作用其实就是保存游戏运行时的一些缓存数据,比如用户登录信息、用户名、任务节点等等。数据一般会有增删改查这四种操作,在运行时的数据一般是使用单例或者静态属性,将数据存储在内存中而数据节点也是将数据存储在内存中,但是不用序列化数据,比使用单例或者静态属性要容易维护的多,特别时它的树形结构可以让我们很好的组织我们的数据结构,方便做增删改查操作。数据节点DataNode模块的数据的存储方式是以树形结构存储。

优快云博客专家,Unity3D高级软件工程师,《Unity 3D从入门到实战》作者。 3185

AI全栈实战 | 3.9-01 爬虫入门:requests 加 BeautifulSoup 三分钟跑通,但 90% 的人栽在这 4 个“礼貌“问题上

⚠️:本文内容仅用于。请遵守目标站点的服务条款与相关法律法规,不得对目标服务造成负担,不得采集、传播个人隐私数据。技术是中性的,边界在你手里。爬虫的入门技术(requests 发请求 + BeautifulSoup 解析)三分钟就能学会。真正区分"会用爬虫"和"会做爬虫的人"的,是这篇我们跑通"请求→解析→存储"的最小闭环,然后重点把"合规与礼貌"这根弦给你绷上。

源码获取 | 运行部署 | 定制二开修改,如果回复不及时请耐心等待,请见谅。 424

Vue3 - 实现用户上传本地视频文件到服务器+上传进度条+暂停续传+中断取消上传等,视频上传后可在线播放预览已上传的视频,视频文件上传视频回显示例代码(支持Element、Antd等upload组件

实现视频上传和视频预览,vue3实现视频上传功能,上传视频回显,视频流上传播放功能,vue与axios上传视频并显示上传进度,upload组件实现视频文件上传视频回显,upload组件实现视频上传及进度条展示,视频上传及实时进度条显示,视频上传过程中如何中断上传,VUE3+element 上传视频,大文件分片上传+断点续传,axios大文件切片上传,Vue3上传视频后如何播放预览,上传本地视频到后端服务器及在线预览播放视频+移除视频+进度条上传,将已选视频上传服务端并可预览视频,详细实现选择视频并上传到服务

🏆 前端领域优质创作者 3116

从一段视频到可漫游的 4D 有声场景:思路拆解与最小复现手记

只需一段手机视频,你就能生成可"走进去"的 4D 有声场景:转头时狗叫声方向随之变化,走近时声音更清晰。本文拆解 Video-to-4DAVScene 的核心思路,手把手带你用几十行 Python 搭出最小管线,把视频中的运动物体变成带空间位置的声源,并附上三个真实踩坑的排障经验,代码可直接跑。🎧

helloagent的博客 239

YOLOv10有效涨点专栏目录 | 包含卷积、主干、检测头、注意力机制、Neck、二次创新、独家创新等上百种创新机制

Hello,各位读者们好本专栏自开设以来已经更新改进教程100余篇其中包含二次创新、独家创新多种改进方法,包含C2f、主干、检测头、注意力机制、Neck多种结构,也有损失函数和一些细节点上的创新。同时本人一些讲解视频和包含我所有创新的YOLOv10文档并不能在优快云上传,通过建立交流群的形式在内上传我完整的文件和视频我也会在群内不定期和大家交流回答大家问题。专栏介绍。

Snu77的博客 1万+

AttributeError: module ‘lib‘ has no attribute ‘X509_V_FLAG_CB_ISSUER_CHECK‘解决方案

本文主要介绍了AttributeError: module ‘lib’ has no attribute 'X509_V_FLAG_CB_ISSUER_CHECK’解决方案,希望能对使用python的同学们有所帮助。 文章目录 1. 问题描述 2. 解决方案

weixin_43178406的博客 5万+

【每天一个 Python 小案例30】Python 基础知识综合小项目:我的工具盒

作为系列收官,本篇把前 29 篇的知识点合成一个能直接用的命令行工具"我的工具盒":计算器(用 ast 解析表达式,不碰 eval)、单位换算与温度转换(一张换算表 + 特例分支)、记账与分类统计(Decimal + JSON 持久化)、以及用"字典当命令表"把菜单和业务逻辑解耦的主循环。文中对比了 eval 的安全隐患与 ast 白名单的做法,解释了 lambda 闭包在字典里的写法与晚绑定陷阱,并在最后给出整个系列的知识地图,把变量、数据结构、控制流、函数、类、异常、文件、标准库八块内容对应到具体篇目。

xinjiyaya的博客 427

基于YOLO26深度学习框架的智能停车场管理系统的算法研究实现方法

本文研究了基于YOLO26深度学习框架的智能停车场管理系统实现方法。系统采用CSPDarknet53作为主干网络,结合特征金字塔和注意力机制提升检测性能。通过数据预处理、模型训练和停车分析三个主要模块,实现了车位占用检测、车辆类型识别等功能。实验结果表明,该方法在检测精度和速度方面表现优异,为智能停车场管理提供了有效的技术解决方案。

一键难忘的博客 571

yolo 和 deft 算法的区别

你应该是打错了:是,不是 defrat;

曾大强博客 252

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

10分钟完成第一个Python小游戏

第一个项目不用找复杂的,‌直接选「猜数字小游戏」对应的教程‌就好——几乎所有入门教程都会讲这个项目,资料最多、遇到问题随便搜就能找到解决方法,不会卡壳,30分钟肯定能做完,非常容易建立信心。‌教程链接‌:直接搜标题👉 ‌《Python零基础入门项目:30分钟写完猜数字游戏》‌(优先选黑马程序员、鱼C-小甲鱼这两个UP主的版本,播放量都是百万级,口碑稳定)‌教程地址‌:打开菜鸟教程官网→找到「Python 实例」板块,直接在线写代码运行。全程不跳步,30分钟就能做完,做完能直接运行玩,成就感拉满。

mF44Job8l的博客 66

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

二进制木马免杀-Python 分离免杀与 Web 挂马

二进制木马免杀-Python 分离免杀与 Web 挂马

2503_94637398的博客 269

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

蓝桥杯·全国青少年信息素养大赛·电子学会Python/C++考级 备考:莫队算法离线区间查询详解

备赛进行时:第十八届蓝桥杯软件赛报名已于 2026-10-08 10:00 开启、12-18 14:00 截止,省赛定在 2027-04-10(C/C++·Python 程序设计 9:00–13:00);中国电子学会 2026 年 12 月软件编程(C/C++ 一级至十级、Python 一级至六级)考级报名 9/23–12/2 16:00、统考 12-12;全国青少年信息素养大赛 2026—2027 赛季算法应用主题赛也已进入复盘练兵窗口。

IT_Scratch的博客 165

两张表合并之后,行数悄悄多了一倍

pandas merge 行数异常膨胀源于右表键不唯一,导致数据静默复制。实测显示,未聚合的右表(756行)与左表合并后行数增至504行,合计膨胀3.5倍,但无报错。validate 参数仅在检查键唯一性时有效,one_to_one 和 many_to_one 可拦截问题,但需结合 duplicated() 前置检查。正确做法为先按键聚合右表,再合并,避免重复。建议合并前后核对行数、合计,并使用 indicator=True 排查匹配情况,确保数据一致性。

patrickstar231的博客 152

我用 200 行代码写了个“代码屎山检测器“,扫完公司的老项目后我沉默了

这个工具不能帮你把屎山铲平,但至少能让你知道自己面对的是多大的山,也能在代码评审时用数据说话——“这个 PR 把圈复杂度从 12 推到了 18,能不能拆一下?毕竟,不能量化的东西,就没法改进。

xixiaoyunya的博客 251

智慧农业实战:育秧车间秧盘计数与苗情分级的Python实现

首先,建立统一的数据结构,保存每盘秧苗的编号、批次、覆盖度、叶色得分和播种天数。A = "壮苗"B = "合格苗"C = "弱苗"@dataclassdays: int。

荆棘鸟智能的博客 112

智叟云集-手机证据抓取系统的工程结构与应用入口

本文系统阐述手机证据抓取系统的工程结构与应用入口,涵盖四大层面:工程目录划分(Android、Python服务、Web页面、测试与构建工具);Android组件通过Manifest声明可启动页面,主界面由MainActivity管理;Python服务通过run.py解析参数并启动FastAPI应用,支持远程访问;浏览器页面采用HTML/CSS/JS分离架构,静态资源通过路径关联,实现动态交互。各模块分工明确,协同构建可运行的采集系统。

2301_77178996的博客 237

Java Arrays.asList 常见坑详解|UnsupportedOperationException、数组联动、基本类型 bug

解析 Arrays.asList 常见开发陷阱,演示 UnsupportedOperationException、底层数组引用共享、基本类型数组问题,区分 Arrays 内部 ArrayList 与 java.util.ArrayList,给出数组转 List 的各种场景正确代码。

weixin_42617033的博客 492

【每天一个 Python 小案例29】Python 实现商品购物车

本篇实现一个购物车:商品目录、加入商品、修改数量、移除商品、查看小计、计算满减与 VIP 折扣、结算扣库存。核心设计是"目录与购物车分离"——目录存商品主数据,购物车只存 {商品编号: 数量};金额一律用 Decimal 并做 ROUND_HALF_UP 舍入。折扣部分讲清阶梯满减的匹配顺序(阈值从高到低、命中即停)与叠加顺序(先满减、后打折),并用一次完整结算演示 706 元如何变成 613.70 元。

xinjiyaya的博客 217

【随笔】KV缓存量化:省下的显存,要付出多少数值误差

用可运行量化器解释位宽、比例信息、分组和离群值的关系,核算KV缓存实际载荷,并给出Transformers配置与容量、延迟、质量验收方法。

code2cat的博客 469

Spring Boot 自动配置原理

Spring Boot 自动配置由 @EnableAutoConfiguration 导入选择器,读取 jar 中 .imports 候选清单,经去重、排序、排除后逐类做条件判断,通过才注册 Bean。延迟导入让用户 Bean 优先,@ConditionalOnMissingBean 使默认配置让位。失效时查清单和 Negative matches。

2401_89855466的博客 393

Python的字典

Python字典是存储键值对的数据结构,通过键(key)快速查找对应的值(value)。可使用{}定义,支持增删改查操作:通过dict[key]查询或修改值,get()方法安全获取并设置默认值,del dict[key]删除键值对,keys()、values()和items()用于遍历。items()结合双变量循环可高效遍历所有键值对,提升代码可读性与灵活性。

qq_43010954的博客 198
上一篇: Hadoop MapReduce 螺蛳粉销量分析程序学习心得
张业兰
博客等级 码龄2年 51粉丝 12原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值