


ZAB协议
- ZAB协议是专门为zookeeper实现分布式协调功能而设计。zookeeper主要是根据ZAB协议是实现分布式系统数据一致性。
- zookeeper根据ZAB协议建立了主备模型完成zookeeper集群中数据的同步。这里所说的主备系统架构模型是指,在zookeeper集群中,只有一台leader负责处理外部客户端的事物请求(或写操作),然后leader服务器将客户端的写操作数据同步到所有的follower节点中。

- ZAB的协议核心是在整个zookeeper集群中只有一个节点即Leader将客户端的写操作转化为事物(或提议proposal)。Leader节点再数据写完之后,将向所有的follower节点发送数据广播请求(或数据复制),等待所有的follower节点反馈。在ZAB协议中,只要超过半数follower节点反馈OK,Leader节点就会向所有的follower服务器发送commit消息。即将leader节点上的数据同步到follower节点之上。

- ZAB协议中主要有两种模式,第一是消息广播模式;第二是崩溃恢复模式
消息广播模式
- 在zookeeper集群中数据副本的传递策略就是采用消息广播模式。zookeeper中数据副本的同步方式与二阶段提交相似但是却又不同。二阶段提交的要求协调者必须等到所有的参与者全部反馈ACK确认消息后,再发送commit消息。要求所有的参与者要么全部成功要么全部失败。二阶段提交会产生严重阻塞问题。
- ZAB协议中Leader等待follower的ACK反馈是指”只要半数以上的follower成功反馈即可,不需要收到全部follower反馈”
- 图中展示了消息广播的具体流程图

- zookeeper中消息广播的具体步骤如下:
4.1. 客户端发起一个写操作请求
4.2. Leader服务器将客户端的request请求转化为事物proposql提案,同时为每个proposal分配一个全局唯一的ID,即ZXID。
4.3. leader服务器与每个follower之间都有一个队列,leader将消息发送到该队列
4.4. follower机器从队列中取出消息处理完(写入本地事物日志中)毕后,向leader服务器发送ACK确认。
4.5. leader服务器收到半数以上的follower的ACK后,即认为可以发送commit
4.6. leader向所有的follower服务器发送commit消息。 - zookeeper采用ZAB协议的核心就是只要有一台服务器提交了proposal,就要确保所有的服务器最终都能正确提交proposal。这也是CAP/BASE最终实现一致性的一个体现。
- leader服务器与每个follower之间都有一个单独的队列进行收发消息,使用队列消息可以做到异步解耦。leader和follower之间只要往队列中发送了消息即可。如果使用同步方式容易引起阻塞。性能上要下降很多。
崩溃恢复
- zookeeper集群中为保证任何所有进程能够有序的顺序执行,只能是leader服务器接受写请求,即使是follower服务器接受到客户端的请求,也会转发到leader服务器进行处理。
- 如果leader服务器发生崩溃,则zab协议要求zookeeper集群进行崩溃恢复和leader服务器选举。
- ZAB协议崩溃恢复要求满足如下2个要求:
3.1. 确保已经被leader提交的proposal必须最终被所有的follower服务器提交。
3.2. 确保丢弃已经被leader出的但是没有被提交的proposal。 - 根据上述要求,新选举出来的leader不能包含未提交的proposal,即新选举的leader必须都是已经提交了的proposal的follower服务器节点。同时,新选举的leader节点中含有最高的ZXID。这样做的好处就是可以避免了leader服务器检查proposal的提交和丢弃工作。
- leader服务器发生崩溃时分为如下场景:
5.1. leader在提出proposal时未提交之前崩溃,则经过崩溃恢复之后,新选举的leader一定不能是刚才的leader。因为这个leader存在未提交的proposal。
5.2 leader在发送commit消息之后,崩溃。即消息已经发送到队列中。经过崩溃恢复之后,参与选举的follower服务器(刚才崩溃的leader有可能已经恢复运行,也属于follower节点范畴)中有的节点已经是消费了队列中所有的commit消息。即该follower节点将会被选举为最新的leader。剩下动作就是数据同步过程。
数据同步
- 在zookeeper集群中新的leader选举成功之后,leader会将自身的提交的最大proposal的事物ZXID发送给其他的follower节点。follower节点会根据leader的消息进行回退或者是数据同步操作。最终目的要保证集群中所有节点的数据副本保持一致。
- 数据同步完之后,zookeeper集群如何保证新选举的leader分配的ZXID是全局唯一呢?这个就要从ZXID的设计谈起。
2.1 ZXID是一个长度64位的数字,其中低32位是按照数字递增,即每次客户端发起一个proposal,低32位的数字简单加1。高32位是leader周期的epoch编号,至于这个编号如何产生(我也没有搞明白),每当选举出一个新的leader时,新的leader就从本地事物日志中取出ZXID,然后解析出高32位的epoch编号,进行加1,再将低32位的全部设置为0。这样就保证了每次新选举的leader后,保证了ZXID的唯一性而且是保证递增的。
ZAB协议原理
- ZAB协议要求每个leader都要经历三个阶段,即发现,同步,广播。
- 发现:即要求zookeeper集群必须选择出一个leader进程,同时leader会维护一个follower可用列表。将来客户端可以这follower中的节点进行通信。
- 同步:leader要负责将本身的数据与follower完成同步,做到多副本存储。这样也是体现了CAP中高可用和分区容错。follower将队列中未处理完的请求消费完成后,写入本地事物日志中。
- 广播:leader可以接受客户端新的proposal请求,将新的proposal请求广播给所有的follower。
Zookeeper设计目标
- zookeeper作为当今最流行的分布式系统应用协调框架,采用zab协议的最大目标就是建立一个高可用可扩展的分布式数据主备系统。即在任何时刻只要leader发生宕机,都能保证分布式系统数据的可靠性和最终一致性。
- 深刻理解ZAB协议,才能更好的理解zookeeper对于分布式系统建设的重要性。以及为什么采用zookeeper就能保证分布式系统中数据最终一致性,服务的高可用性。
Zab与Paxos
Zab的作者认为Zab与paxos并不相同,只所以没有采用Paxos是因为Paxos保证不了全序顺序:
Because multiple leaders can propose a value for a given instance two problems arise.
First, proposals can conflict. Paxos uses ballots to detect and resolve conflicting proposals.
Second, it is not enough to know that a given instance number has been committed, processes must also be able to fi gure out which value has been committed.
Paxos算法的确是不关心请求之间的逻辑顺序,而只考虑数据之间的全序,但很少有人直接使用paxos算法,都会经过一定的简化、优化。
Paxos算法优化
Paxos算法在出现竞争的情况下,其收敛速度很慢,甚至可能出现活锁的情况,例如当有三个及三个以上的proposer在发送prepare请求后,很难有一个proposer收到半数以上的回复而不断地执行第一阶段的协议。因此,为了避免竞争,加快收敛的速度,在算法中引入了一个Leader这个角色,在正常情况下同时应该最多只能有一个参与者扮演Leader角色,而其它的参与者则扮演Acceptor的角色。
在这种优化算法中,只有Leader可以提出议案,从而避免了竞争使得算法能够快速地收敛而趋于一致;而为了保证Leader的健壮性,又引入了Leader选举,再考虑到同步的阶段,渐渐的你会发现对Paxos算法的简化和优化已经和上面介绍的ZAB协议很相似了。
总结
Google的粗粒度锁服务Chubby的设计开发者Burrows曾经说过:“所有一致性协议本质上要么是Paxos要么是其变体”。这句话还是有一定道理的,ZAB本质上就是Paxos的一种简化形式。
ZAB与FastLeaderElection选主算法流程详解
这篇主要分析leader的选主机制,zookeeper提供了三种方式:
- LeaderElection
- AuthFastLeaderElection
- FastLeaderElection
默认的算法是FastLeaderElection,所以这篇主要分析它的选举机制。
选择机制中的概念
服务器ID
比如有三台服务器,编号分别是1,2,3。
编号越大在选择算法中的权重越大。
数据ID
服务器中存放的最大数据ID.
值越大说明数据越新,在选举算法中数据越新权重越大。
逻辑时钟
或者叫投票的次数,同一轮投票过程中的逻辑时钟值是相同的。每投完一次票这个数据就会增加,然后与接收到的其它服务器返回的投票信息中的数值相比,根据不同的值做出不同的判断。
选举状态
- LOOKING,竞选状态。
- FOLLOWING,随从状态,同步leader状态,参与投票。
- OBSERVING,观察状态,同步leader状态,不参与投票。
- LEADING,领导者状态。
选举消息内容
在投票完成后,需要将投票信息发送给集群中的所有服务器,它包含如下内容。
- 服务器ID
- 数据ID
- 逻辑时钟
- 选举状态
选举流程图
因为每个服务器都是独立的,在启动时均从初始状态开始参与选举,下面是简易流程图。

下面详细解释一下这个流程:
首先给出几个名词定义:
(1)Serverid:在配置server时,给定的服务器的标示id。
(2)Zxid:服务器在运行时产生的数据id,zxid越大,表示数据越新。
(3)Epoch:选举的轮数,即逻辑时钟。随着选举的轮数++
(4)Server状态:LOOKING,FOLLOWING,OBSERVING,LEADING
步骤:
一、 Server刚启动(宕机恢复或者刚启动)准备加入集群,此时读取自身的zxid等信息。
二、 所有Server加入集群时都会推荐自己为leader,然后将(leader id 、 zixd 、 epoch)作为广播信息,广播到集群中所有的服务器(Server)。然后等待集群中的服务器返回信息。
三、 收到集群中其他服务器返回的信息,此时要分为两类:该服务器处于looking状态,或者其他状态。
(1) 服务器处于looking状态
首先判断逻辑时钟 Epoch:
a) 如果接收到Epoch大于自己目前的逻辑时钟(说明自己所保存的逻辑时钟落伍了)。更新本机逻辑时钟Epoch,同时 Clear其他服务发送来的选举数据(这些数据已经OUT了)。然后判断是否需要更新当前自己的选举情况(一开始选择的leader id 是自己)
判断规则rules judging:保存的zxid最大值和leader Serverid来进行判断的。先看数据zxid,数据zxid大者胜出;其次再判断leaderServerid, leader Serverid大者胜出;然后再将自身最新的选举结果(也就是上面提到的三种数据(leader Serverid,Zxid,Epoch)广播给其他server)
b) 如果接收到的Epoch小于目前的逻辑时钟。说明对方处于一个比较OUT的选举轮数,这时只需要将自己的 (leader Serverid,Zxid,Epoch)发送给他即可。
c) 如果接收到的Epoch等于目前的逻辑时钟。再根据a)中的判断规则,将自身的最新选举结果广播给其他 server。
同时Server还要处理2种情况:
a) 如果Server接收到了其他所有服务器的选举信息,那么则根据这些选举信息确定自己的状态(Following,Leading),结束Looking,退出选举。
b) 即使没有收到所有服务器的选举信息,也可以判断一下根据以上过程之后最新的选举leader是不是得到了超过半数以上服务器的支持,如果是则尝试接受最新数据,倘若没有最新的数据到来,说明大家都已经默认了这个结果,同样也设置角色退出选举过程。
(2) 服务器处于其他状态(Following, Leading)
a) 如果逻辑时钟Epoch相同,将该数据保存到recvset,如果所接收服务器宣称自己是leader,那么将判断是不是有半数以上的服务器选举它,如果是则设置选举状态退出选举过程
b) 否则这是一条与当前逻辑时钟不符合的消息,那么说明在另一个选举过程中已经有了选举结果,于是将该选举结果加入到outofelection集合中,再根据outofelection来判断是否可以结束选举,如果可以也是保存逻辑时钟,设置选举状态,退出选举过程。
以上就是FAST选举过程。
Zookeeper具体的启动日志如下图所示:
搞懂分布式技术4:ZAB协议概述与选主流程详解 
以上就是我自己配置的Zookeeper选主日志,从一开始LOOKING,然后new election, my id = 1, proposedzxid=0x0 也就是选自己为Leader,之后广播选举并重复之前Fast选主算法,最终确定Leader。
源码分析
QuorumPeer
主要看这个类,只有LOOKING状态才会去执行选举算法。每个服务器在启动时都会选择自己做为领导,然后将投票信息发送出去,循环一直到选举出领导为止。
<pre>public void run() {
//.......
    try {
        while (running) {
            switch (getPeerState()) {
            case LOOKING:
                if (Boolean.getBoolean("readonlymode.enabled")) {
                    //...
                    try {
                       //投票给自己...
                        setCurrentVote(makeLEStrategy().lookForLeader());
                    } catch (Exception e) {
                        //...
                    } finally {
                        //...
                    }
                } else {
                    try {
                       //...
                        setCurrentVote(makeLEStrategy().lookForLeader());
                    } catch (Exception e) {
                        //...
                    }
                }
                break;
            case OBSERVING:
                //...
                break;
            case FOLLOWING:
                //...
                break;
            case LEADING:
                //...
                break;
            }

        }
    } finally {
        //...
    }
}</pre>
FastLeaderElection
它是zookeeper默认提供的选举算法,核心方法如下:具体的可以与本文上面的流程图对照。
<pre>public Vote lookForLeader() throws InterruptedException {
//...
try {
HashMap<Long, Vote> recvset = new HashMap<Long, Vote>();
        HashMap<Long, Vote> outofelection = new HashMap<Long, Vote>();

        int notTimeout = finalizeWait;

        synchronized(this){
            //给自己投票
            logicalclock.incrementAndGet();
            updateProposal(getInitId(), getInitLastLoggedZxid(), getPeerEpoch());
        }

        //将投票信息发送给集群中的每个服务器
        sendNotifications();

        //循环,如果是竞选状态一直到选举出结果

        while ((self.getPeerState() == ServerState.LOOKING) &&
                (!stop)){

            Notification n = recvqueue.poll(notTimeout,
                    TimeUnit.MILLISECONDS);

            //没有收到投票信息
            if(n == null){
                if(manager.haveDelivered()){
                    sendNotifications();
                } else {
                    manager.connectAll();
                }

                //...
            }
            //收到投票信息
            else if (self.getCurrentAndNextConfigVoters().contains(n.sid)) {

                switch (n.state) {
                case LOOKING:

                    // 判断投票是否过时,如果过时就清除之前已经接收到的信息
                    if (n.electionEpoch > logicalclock.get()) {
                        logicalclock.set(n.electionEpoch);
                        recvset.clear();
                        //更新投票信息
                        if(totalOrderPredicate(n.leader, n.zxid, n.peerEpoch,
                                getInitId(), getInitLastLoggedZxid(), getPeerEpoch())) {
                            updateProposal(n.leader, n.zxid, n.peerEpoch);
                        } else {
                            updateProposal(getInitId(),
                                    getInitLastLoggedZxid(),
                                    getPeerEpoch());
                        }
                        //发送投票信息
                        sendNotifications();
                    } else if (n.electionEpoch < logicalclock.get()) {
                        //忽略
                        break;
                    } else if (totalOrderPredicate(n.leader, n.zxid, n.peerEpoch,
                            proposedLeader, proposedZxid, proposedEpoch)) {
                        //更新投票信息
                        updateProposal(n.leader, n.zxid, n.peerEpoch);
                        sendNotifications();
                    }

                    recvset.put(n.sid, new Vote(n.leader, n.zxid, n.electionEpoch, n.peerEpoch));
                    //判断是否投票结束
                    if (termPredicate(recvset,
                            new Vote(proposedLeader, proposedZxid,
                                    logicalclock.get(), proposedEpoch))) {

                        // Verify if there is any change in the proposed leader
                        while((n = recvqueue.poll(finalizeWait,
                                TimeUnit.MILLISECONDS)) != null){
                            if(totalOrderPredicate(n.leader, n.zxid, n.peerEpoch,
                                    proposedLeader, proposedZxid, proposedEpoch)){
                                recvqueue.put(n);
                                break;
                            }
                        }

                        if (n == null) {
                            self.setPeerState((proposedLeader == self.getId()) ?
                                    ServerState.LEADING: learningState());

                            Vote endVote = new Vote(proposedLeader,
                                    proposedZxid, proposedEpoch);
                            leaveInstance(endVote);
                            return endVote;
                        }
                    }
                    break;
                case OBSERVING:
                    //忽略
                    break;
                case FOLLOWING:
                case LEADING:
                    //如果是同一轮投票
                    if(n.electionEpoch == logicalclock.get()){
                        recvset.put(n.sid, new Vote(n.leader, n.zxid, n.electionEpoch, n.peerEpoch));
                        //判断是否投票结束
                        if(termPredicate(recvset, new Vote(n.leader,
                                        n.zxid, n.electionEpoch, n.peerEpoch, n.state))
                                        && checkLeader(outofelection, n.leader, n.electionEpoch)) {
                            self.setPeerState((n.leader == self.getId()) ?
                                    ServerState.LEADING: learningState());

                            Vote endVote = new Vote(n.leader, n.zxid, n.peerEpoch);
                            leaveInstance(endVote);
                            return endVote;
                        }
                    }

                    //记录投票已经完成
                    outofelection.put(n.sid, new Vote(n.leader,
                            IGNOREVALUE, IGNOREVALUE, n.peerEpoch, n.state));
                    if (termPredicate(outofelection, new Vote(n.leader,
                            IGNOREVALUE, IGNOREVALUE, n.peerEpoch, n.state))
                            && checkLeader(outofelection, n.leader, IGNOREVALUE)) {
                        synchronized(this){
                            logicalclock.set(n.electionEpoch);
                            self.setPeerState((n.leader == self.getId()) ?
                                    ServerState.LEADING: learningState());
                        }
                        Vote endVote = new Vote(n.leader, n.zxid, n.peerEpoch);
                        leaveInstance(endVote);
                        return endVote;
                    }
                    break;
                default:
                    //忽略
                    break;
                }
            } else {
                LOG.warn("Ignoring notification from non-cluster member " + n.sid);
            }
        }
        return null;
    } finally {
        //...
    }
}</pre>
判断是否已经胜出
默认是采用投票数大于半数则胜出的逻辑。
选举流程简述
目前有5台服务器,每台服务器均没有数据,它们的编号分别是1,2,3,4,5,按编号依次启动,它们的选择举过程如下:
- 服务器1启动,给自己投票,然后发投票信息,由于其它机器还没有启动所以它收不到反馈信息,服务器1的状态一直属于Looking。
- 服务器2启动,给自己投票,同时与之前启动的服务器1交换结果,由于服务器2的编号大所以服务器2胜出,但此时投票数没有大于半数,所以两个服务器的状态依然是LOOKING。
- 服务器3启动,给自己投票,同时与之前启动的服务器1,2交换信息,由于服务器3的编号最大所以服务器3胜出,此时投票数正好大于半数,所以服务器3成为领导者,服务器1,2成为小弟。
- 服务器4启动,给自己投票,同时与之前启动的服务器1,2,3交换信息,尽管服务器4的编号大,但之前服务器3已经胜出,所以服务器4只能成为小弟。
- 服务器5启动,后面的逻辑同服务器4成为小弟。
几种领导选举场景
集群启动领导选举
初始投票给自己
集群刚启动时,所有服务器的logicClock都为1,zxid都为0。
各服务器初始化后,都投票给自己,并将自己的一票存入自己的票箱,如下图所示。
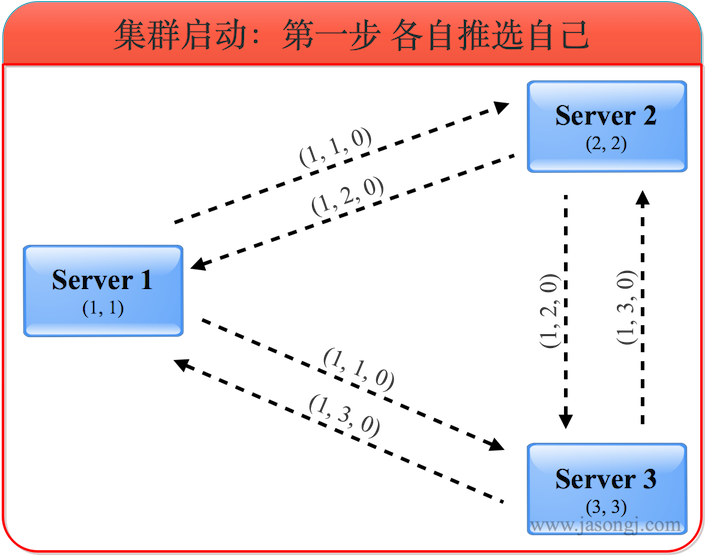
在上图中,(1, 1, 0)第一位数代表投出该选票的服务器的logicClock,第二位数代表被推荐的服务器的myid,第三位代表被推荐的服务器的最大的zxid。由于该步骤中所有选票都投给自己,所以第二位的myid即是自己的myid,第三位的zxid即是自己的zxid。
此时各自的票箱中只有自己投给自己的一票。
更新选票
服务器收到外部投票后,进行选票PK,相应更新自己的选票并广播出去,并将合适的选票存入自己的票箱,如下图所示。

服务器1收到服务器2的选票(1, 2, 0)和服务器3的选票(1, 3, 0)后,由于所有的logicClock都相等,所有的zxid都相等,因此根据myid判断应该将自己的选票按照服务器3的选票更新为(1, 3, 0),并将自己的票箱全部清空,再将服务器3的选票与自己的选票存入自己的票箱,接着将自己更新后的选票广播出去。此时服务器1票箱内的选票为(1, 3),(3, 3)。
同理,服务器2收到服务器3的选票后也将自己的选票更新为(1, 3, 0)并存入票箱然后广播。此时服务器2票箱内的选票为(2, 3),(3, ,3)。
服务器3根据上述规则,无须更新选票,自身的票箱内选票仍为(3, 3)。
服务器1与服务器2更新后的选票广播出去后,由于三个服务器最新选票都相同,最后三者的票箱内都包含三张投给服务器3的选票。
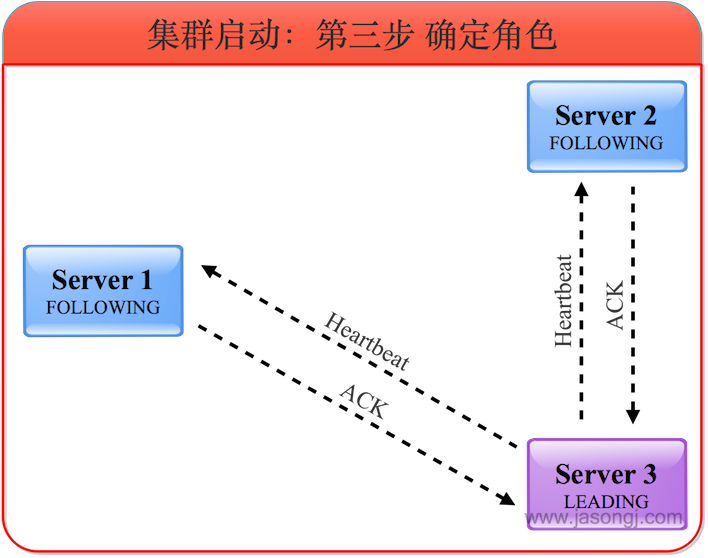
根据选票确定角色
根据上述选票,三个服务器一致认为此时服务器3应该是Leader。因此服务器1和2都进入FOLLOWING状态,而服务器3进入LEADING状态。之后Leader发起并维护与Follower间的心跳。
Follower重启
Follower重启投票给自己
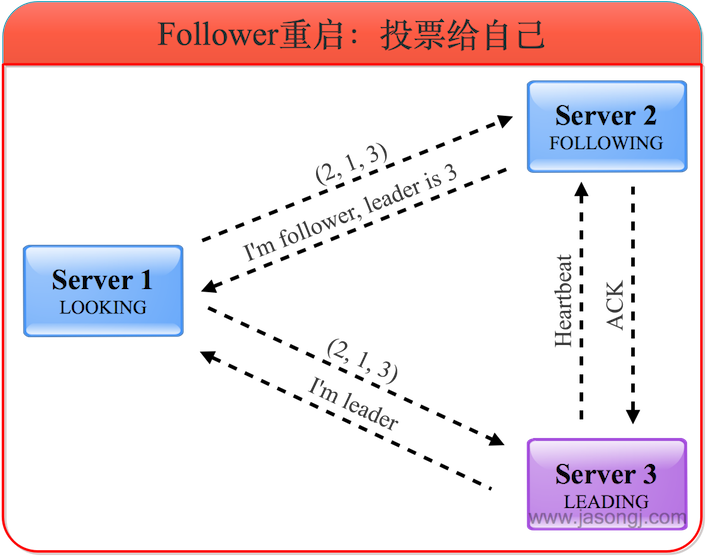
Follower重启,或者发生网络分区后找不到Leader,会进入LOOKING状态并发起新的一轮投票。
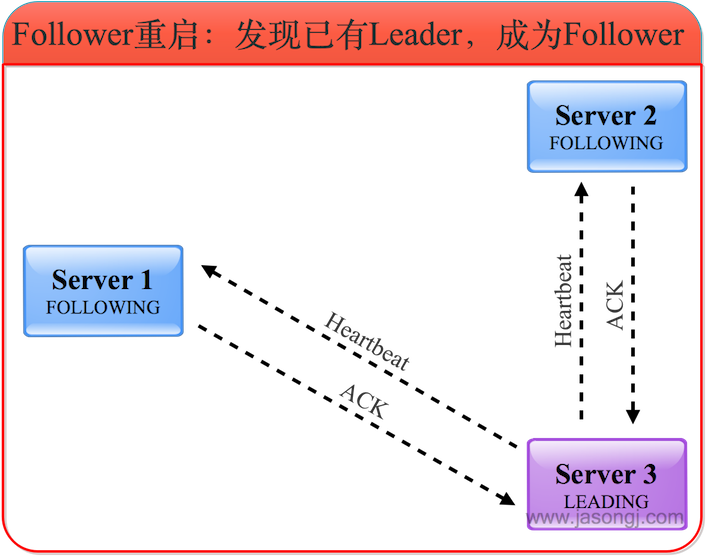
发现已有Leader后成为Follower
服务器3收到服务器1的投票后,将自己的状态LEADING以及选票返回给服务器1。服务器2收到服务器1的投票后,将自己的状态FOLLOWING及选票返回给服务器1。此时服务器1知道服务器3是Leader,并且通过服务器2与服务器3的选票可以确定服务器3确实得到了超过半数的选票。因此服务器1进入FOLLOWING状态。
Leader重启
Follower发起新投票
Leader(服务器3)宕机后,Follower(服务器1和2)发现Leader不工作了,因此进入LOOKING状态并发起新的一轮投票,并且都将票投给自己。
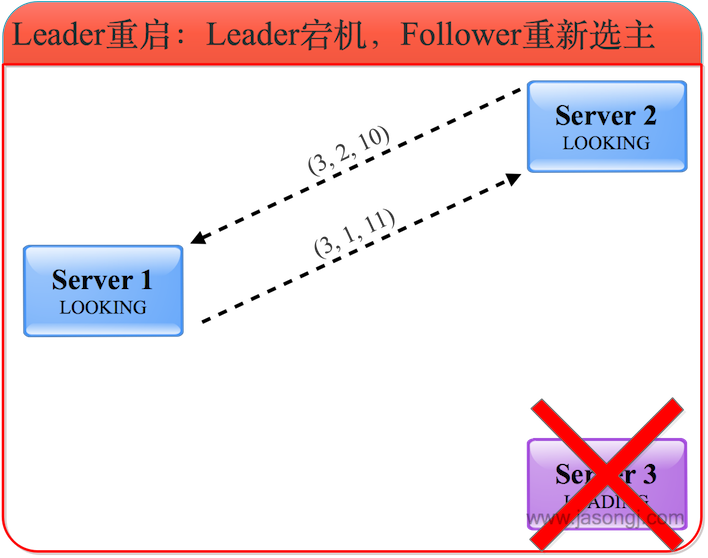
广播更新选票
服务器1和2根据外部投票确定是否要更新自身的选票。这里有两种情况
- 服务器1和2的zxid相同。例如在服务器3宕机前服务器1与2完全与之同步。此时选票的更新主要取决于myid的大小
- 服务器1和2的zxid不同。在旧Leader宕机之前,其所主导的写操作,只需过半服务器确认即可,而不需所有服务器确认。换句话说,服务器1和2可能一个与旧Leader同步(即zxid与之相同)另一个不同步(即zxid比之小)。此时选票的更新主要取决于谁的zxid较大
在上图中,服务器1的zxid为11,而服务器2的zxid为10,因此服务器2将自身选票更新为(3, 1, 11),如下图所示。

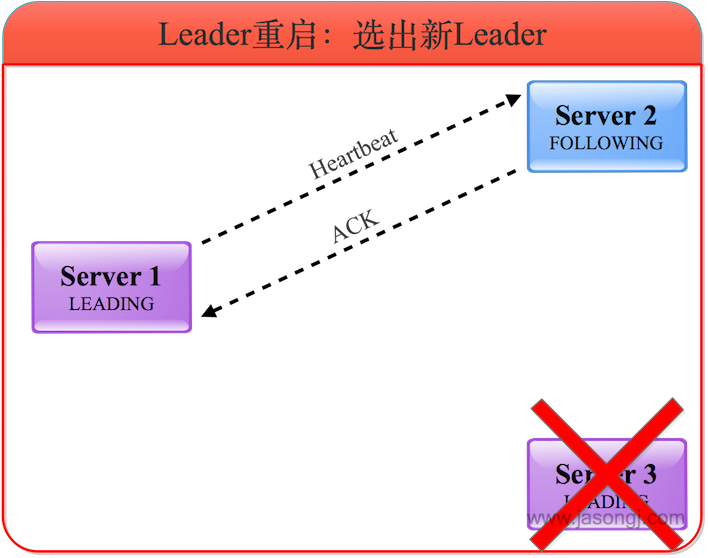
选出新Leader
经过上一步选票更新后,服务器1与服务器2均将选票投给服务器1,因此服务器2成为Follower,而服务器1成为新的Leader并维护与服务器2的心跳。
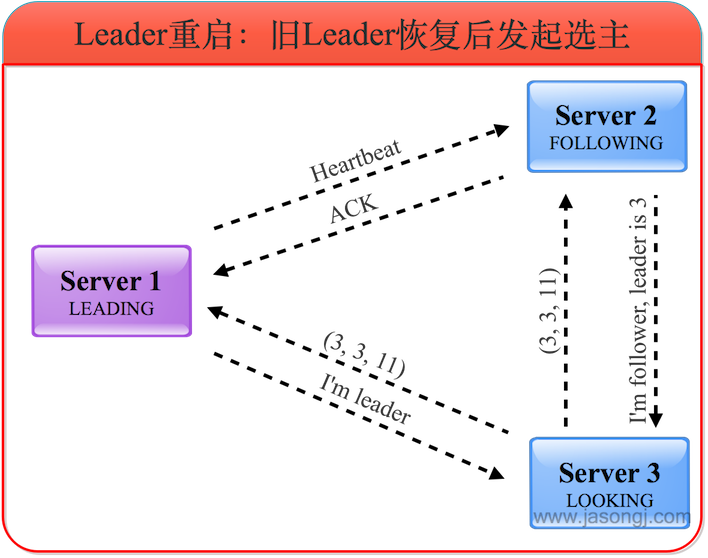
旧Leader恢复后发起选举
旧的Leader恢复后,进入LOOKING状态并发起新一轮领导选举,并将选票投给自己。此时服务器1会将自己的LEADING状态及选票(3, 1, 11)返回给服务器3,而服务器2将自己的FOLLOWING状态及选票(3, 1, 11)返回给服务器3。如下图所示。
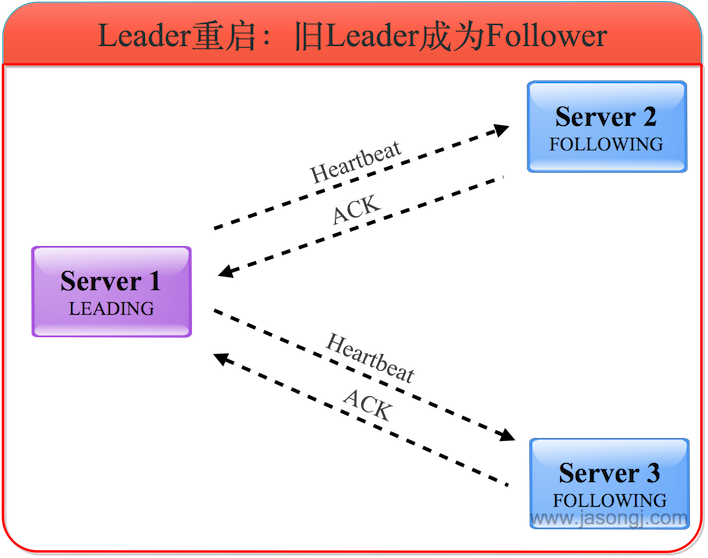
旧Leader成为Follower
服务器3了解到Leader为服务器1,且根据选票了解到服务器1确实得到过半服务器的选票,因此自己进入FOLLOWING状态。
一致性保证
ZAB协议保证了在Leader选举的过程中,已经被Commit的数据不会丢失,未被Commit的数据对客户端不可见。
Commit过的数据不丢失
Failover前状态
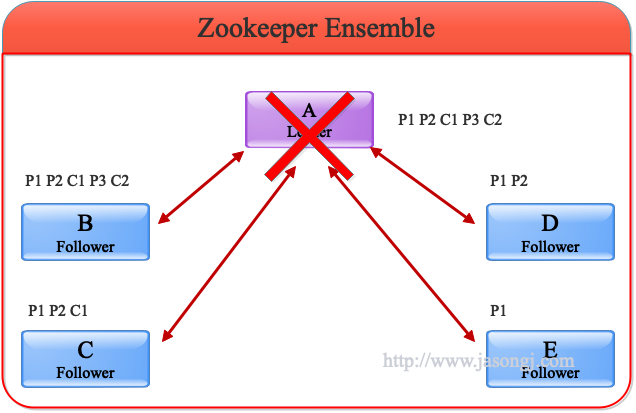
为更好演示Leader Failover过程,本例中共使用5个Zookeeper服务器。A作为Leader,共收到P1、P2、P3三条消息,并且Commit了1和2,且总体顺序为P1、P2、C1、P3、C2。根据顺序性原则,其它Follower收到的消息的顺序肯定与之相同。其中B与A完全同步,C收到P1、P2、C1,D收到P1、P2,E收到P1,如下图所示。
这里要注意
- 由于A没有C3,意味着收到P3的服务器的总个数不会超过一半,也即包含A在内最多只有两台服务器收到P3。在这里A和B收到P3,其它服务器均未收到P3
- 由于A已写入C1、C2,说明它已经Commit了P1、P2,因此整个集群有超过一半的服务器,即最少三个服务器收到P1、P2。在这里所有服务器都收到了P1,除E外其它服务器也都收到了P2
选出新Leader
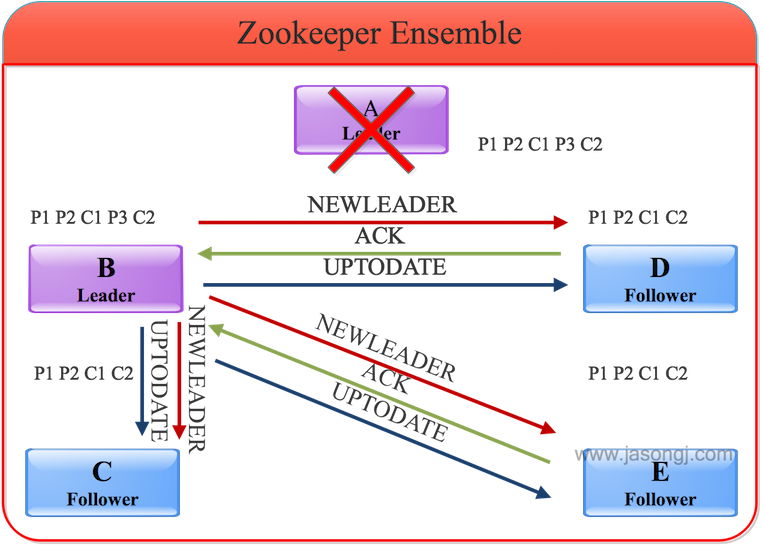
旧Leader也即A宕机后,其它服务器根据上述FastLeaderElection算法选出B作为新的Leader。C、D和E成为Follower且以B为Leader后,会主动将自己最大的zxid发送给B,B会将Follower的zxid与自身zxid间的所有被Commit过的消息同步给Follower,如下图所示。

在上图中
- P1和P2都被A Commit,因此B会通过同步保证P1、P2、C1与C2都存在于C、D和E中
- P3由于未被A Commit,同时幸存的所有服务器中P3未存在于大多数据服务器中,因此它不会被同步到其它Follower
通知Follower可对外服务
同步完数据后,B会向D、C和E发送NEWLEADER命令并等待大多数服务器的ACK(下图中D和E已返回ACK,加上B自身,已经占集群的大多数),然后向所有服务器广播UPTODATE命令。收到该命令后的服务器即可对外提供服务。
未Commit过的消息对客户端不可见
在上例中,P3未被A Commit过,同时因为没有过半的服务器收到P3,因此B也未Commit P3(如果有过半服务器收到P3,即使A未Commit P3,B会主动Commit P3,即C3),所以它不会将P3广播出去。
具体做法是,B在成为Leader后,先判断自身未Commit的消息(本例中即P3)是否存在于大多数服务器中从而决定是否要将其Commit。然后B可得出自身所包含的被Commit过的消息中的最小zxid(记为min_zxid)与最大zxid(记为max_zxid)。C、D和E向B发送自身Commit过的最大消息zxid(记为max_zxid)以及未被Commit过的所有消息(记为zxid_set)。B根据这些信息作出如下操作
- 如果Follower的max_zxid与Leader的max_zxid相等,说明该Follower与Leader完全同步,无须同步任何数据
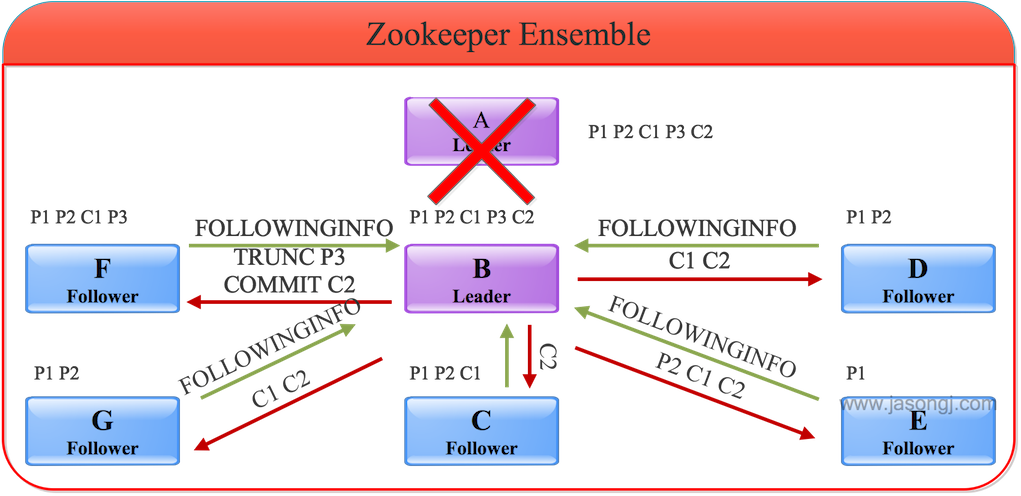
- 如果Follower的max_zxid在Leader的(min_zxid,max_zxid)范围内,Leader会通过TRUNC命令通知Follower将其zxid_set中大于Follower的max_zxid(如果有)的所有消息全部删除
上述操作保证了未被Commit过的消息不会被Commit从而对外不可见。
上述例子中Follower上并不存在未被Commit的消息。但可考虑这种情况,如果将上述例子中的服务器数量从五增加到七,服务器F包含P1、P2、C1、P3,服务器G包含P1、P2。此时服务器F、A和B都包含P3,但是因为票数未过半,因此B作为Leader不会Commit P3,而会通过TRUNC命令通知F删除P3。如下图所示。
总结
- 由于使用主从复制模式,所有的写操作都要由Leader主导完成,而读操作可通过任意节点完成,因此Zookeeper读性能远好于写性能,更适合读多写少的场景
- 虽然使用主从复制模式,同一时间只有一个Leader,但是Failover机制保证了集群不存在单点失败(SPOF)的问题
- ZAB协议保证了Failover过程中的数据一致性
- 服务器收到数据后先写本地文件再进行处理,保证了数据的持久性

 873


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


