CUDA C变成权威指南 第二章 CUDA编程模型

CUDA C编程权威指南与实践 CUDA,全称Compute Unified Device Architecture,是由NVIDIA公司推出的一种用于通用并行计算的架构。它允许开发者利用NVIDIA的GPU进行大规模数据处理和计算,极大提高了计算效率和程序性能。CUDA技术自2007年首次推出后,经历了多次迭代和升级,现已发展成为并行计算领域的重要工具。从最初支持简单的图形处理任务,到现在支持复杂的科学计算,CUDA不仅在学术界得到广泛应用,也被工业界认可和采纳,成为高性能计算的首选技术之一。 阅读详情
一、概述
1. CUDA编程结构

CUDA6.0开始提出统一寻址(Unified Memory),它连接了主机内存和设备内存空间,可使用单个指针访问CPU和GPU内存。

主机代码按照ANSI C标准进行编写,而设备代码使用CUDA C进行编写。

一个典型的CUDA程序实现流程遵循以下模式。

1. 把数据从CPU内存拷贝到GPU内存。

2.调用核函数对存储在GPU内存中的数据进行操作。

3.将数据从GPU内存传送回到CPU内存。

2. 内存管理

CUDA编程模型假设系统是由一个主机和一个设备组成,而且各自拥有独立的内存。
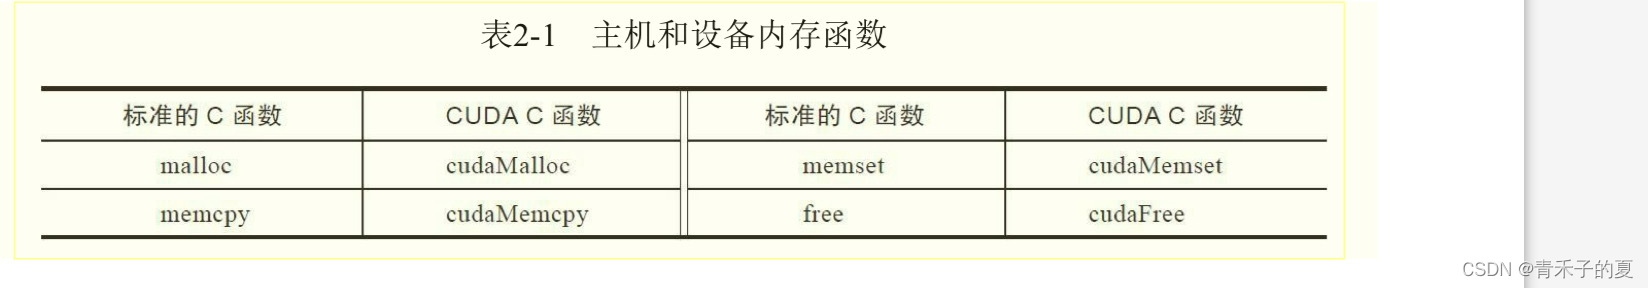
①cudaMalloc函数负责执行GPU内存分配:其函数原型为:

        cudaError_t cudaMalloc (void** devPtr, size_t size)

该函数负责向设备分配一定字节的线性内存,并以devPtr的形式返回指向所分配内存的指针。

②cudaMemcpy函数负责主机和设备之间的数据传输,其函数原型为:

        函数 cudaError_t cudaMemcpy (void* dst, const void* src, size_t count, cudaMemcpyKind kind)

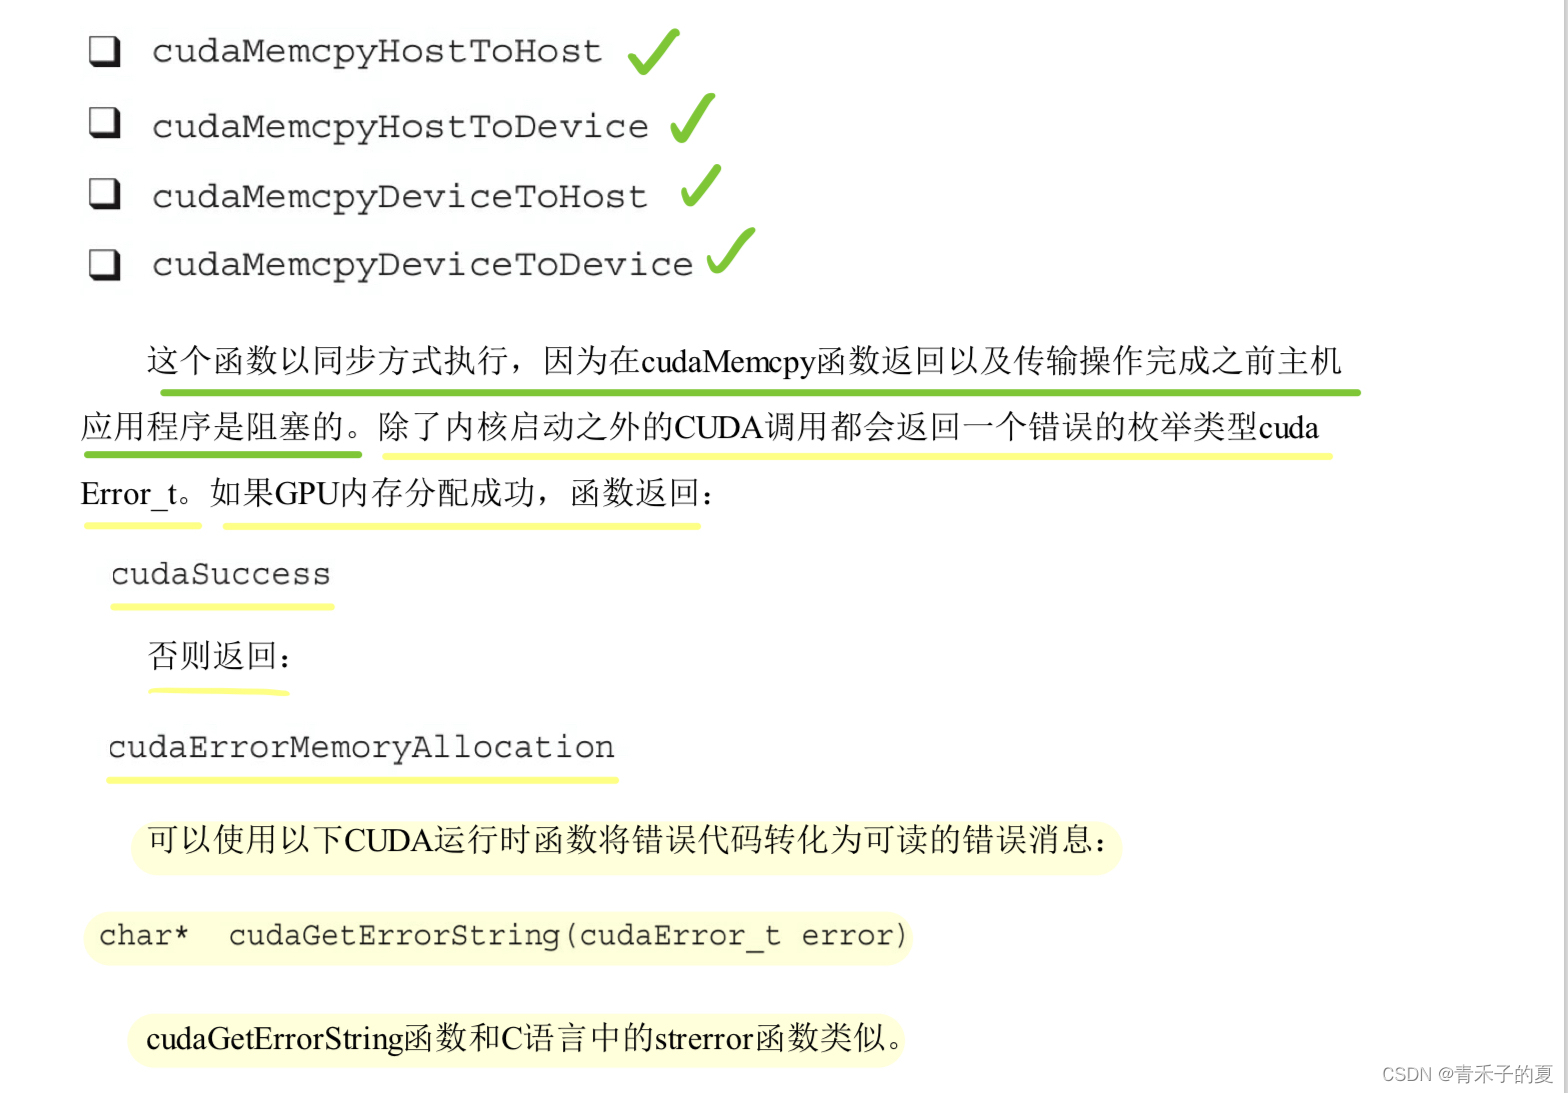
此从src指向的源存储区复制一定数量的字节到dst指向的目标存储区.复制方向由kind指定,其中的kind有以下几种:
内存层级结构

在GPU的内存层次结构中,最主要的两种内存是全局内存和共享内存。全局内存类似于CPU的系统内存,而共享内存类似于CPU的缓存。然而GPU的共享内存可以由CUDA C的内核直接控制。

一旦内核被调用,控制权立刻被传回主机。当核函数在GPU上运行时,主机可以执行其他函数。因此,内核与主机是异步的。

cudaMemcpy的调用会导致主机运行阻塞。

3. 线程管理

当核函数在主机端启动时,它的执行会移动到设备上,此时设备中会产生大量的线程,并且每个线程都执行由核函数指定的语句。
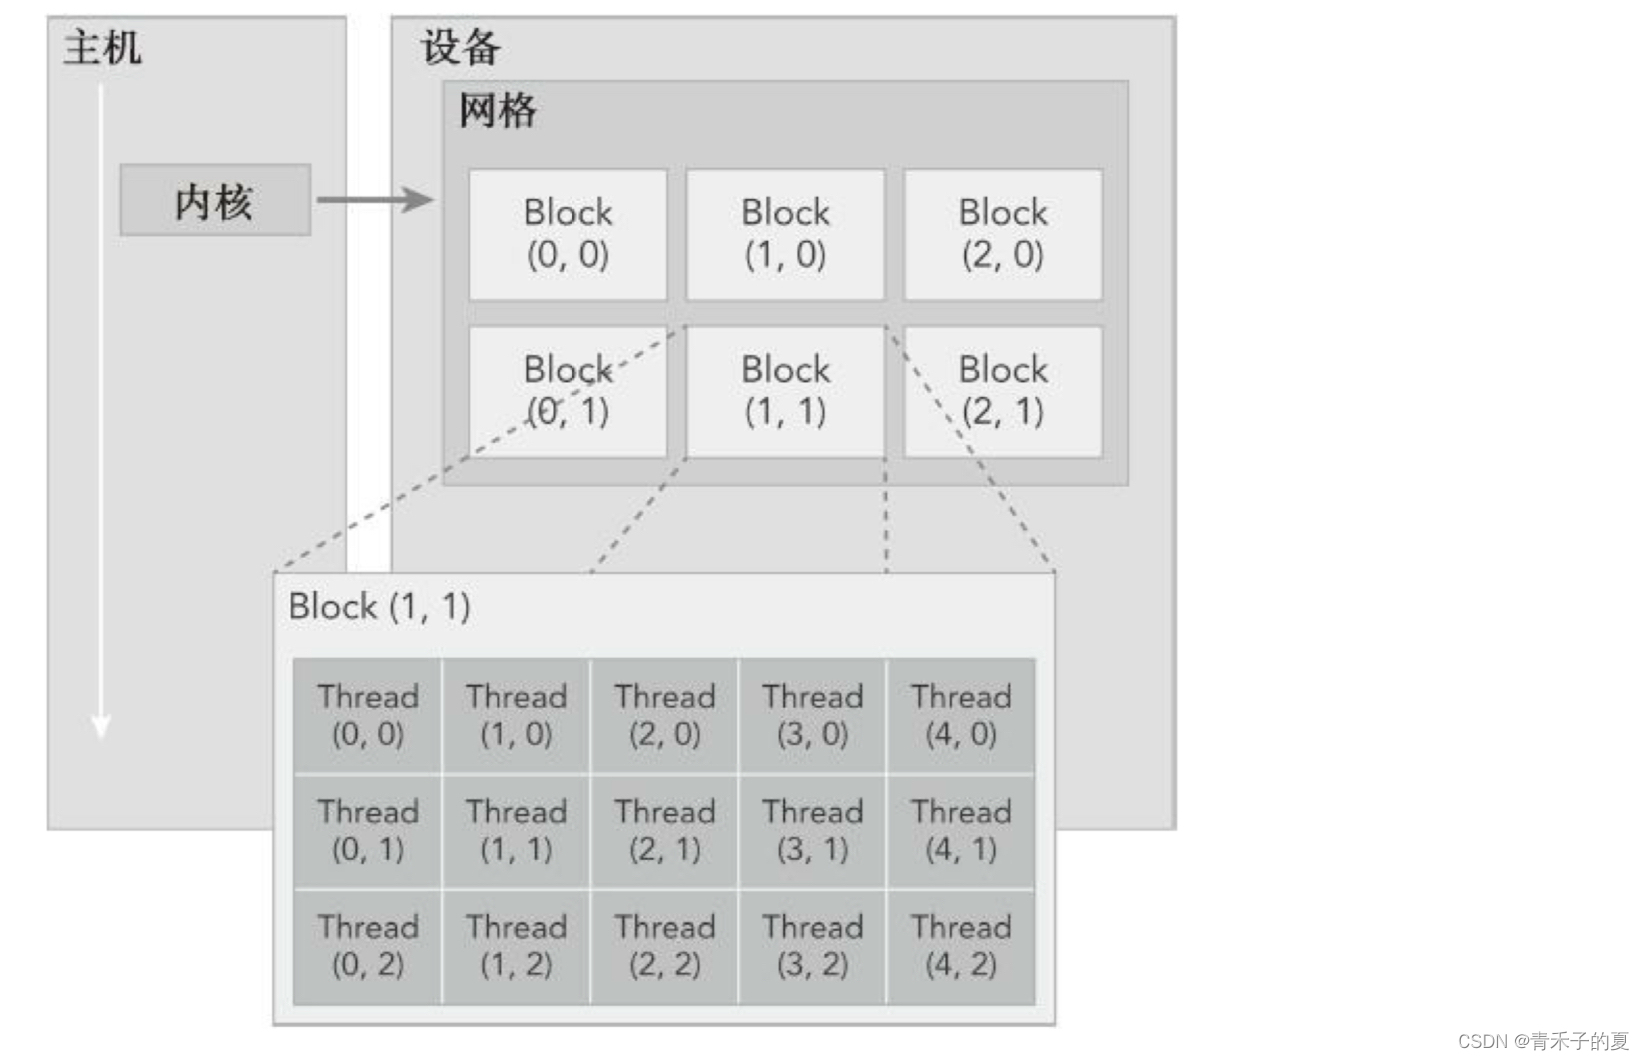
由一个内核启动所产生的所有线程统称为一个网格。同一网格中的所有线程共享相同的全局内存空间。一个网格由多个线程块构成,一个线程块包含一组线程,同一个线程块内线程协作可以通过同步和共享内存的方式实现。

不同块内的线程不能协作。

线程依靠以下两个坐标变量区分彼此。

· blockIdx(线程块在线程格内的索引)

· threadIdx(块内的线程索引)
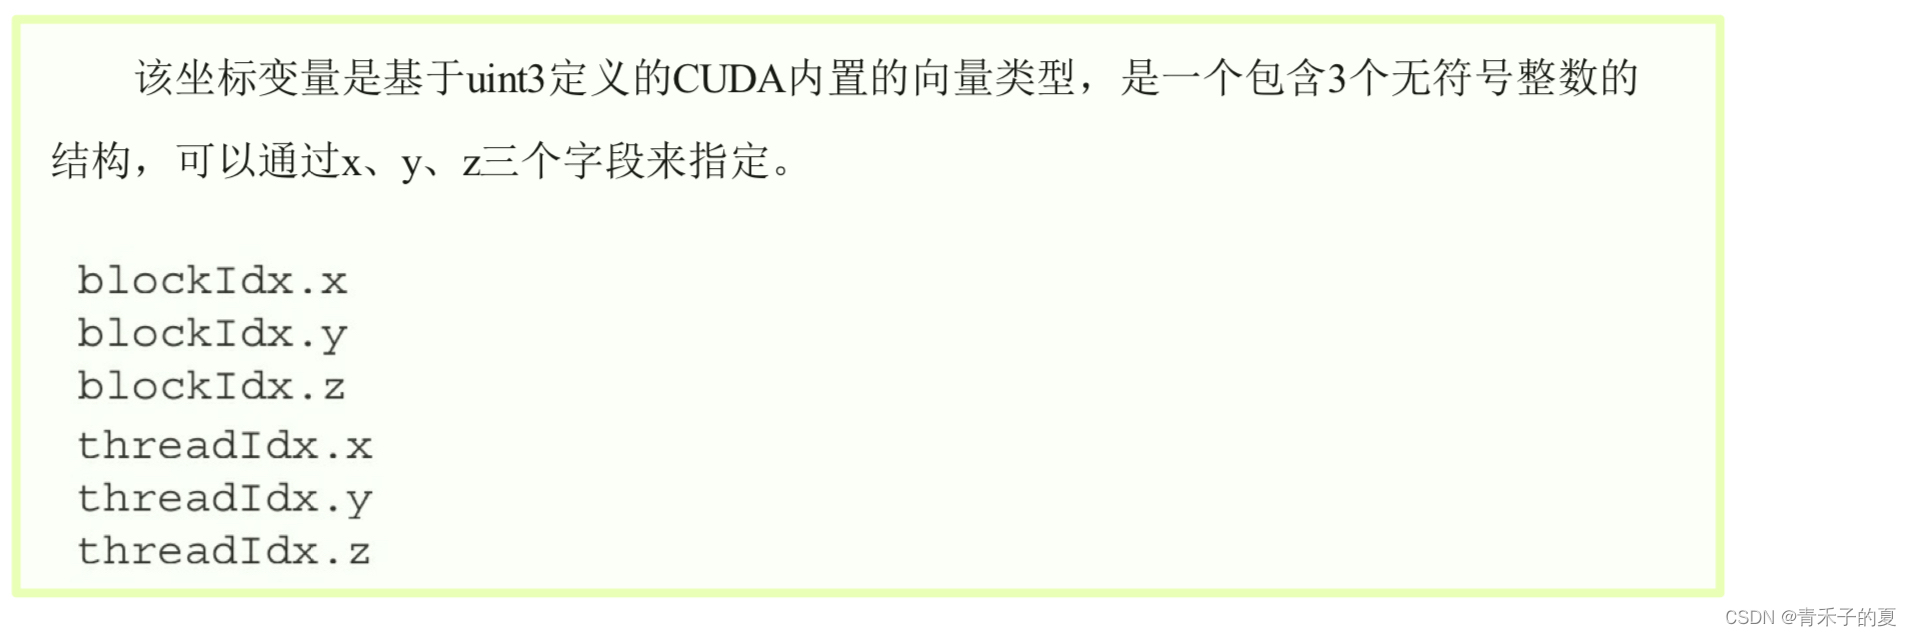
CUDA可以组织三维的网格和块。网格和块的维度由下列两个内置变量指定。

· blockDim(线程块的维度,用每个线程块中的线程数来表示)

· gridDim(线程格的维度,用每个线程格中的线程数来表示)

它们是dim3类型的变量,是基于uint3定义的整数型向量,用来表示维度。当定义一个dim3类型的变量时,所有未指定的元素都被初始化为1且忽略不计。dim3类型变量中的每个组件可以通过它的x、y、z字段获得。

网格和线程块的维度

通常,一个线程格会被组织成线程块的二维数组形式,一个线程块会被组织成线程的三维数组形式。
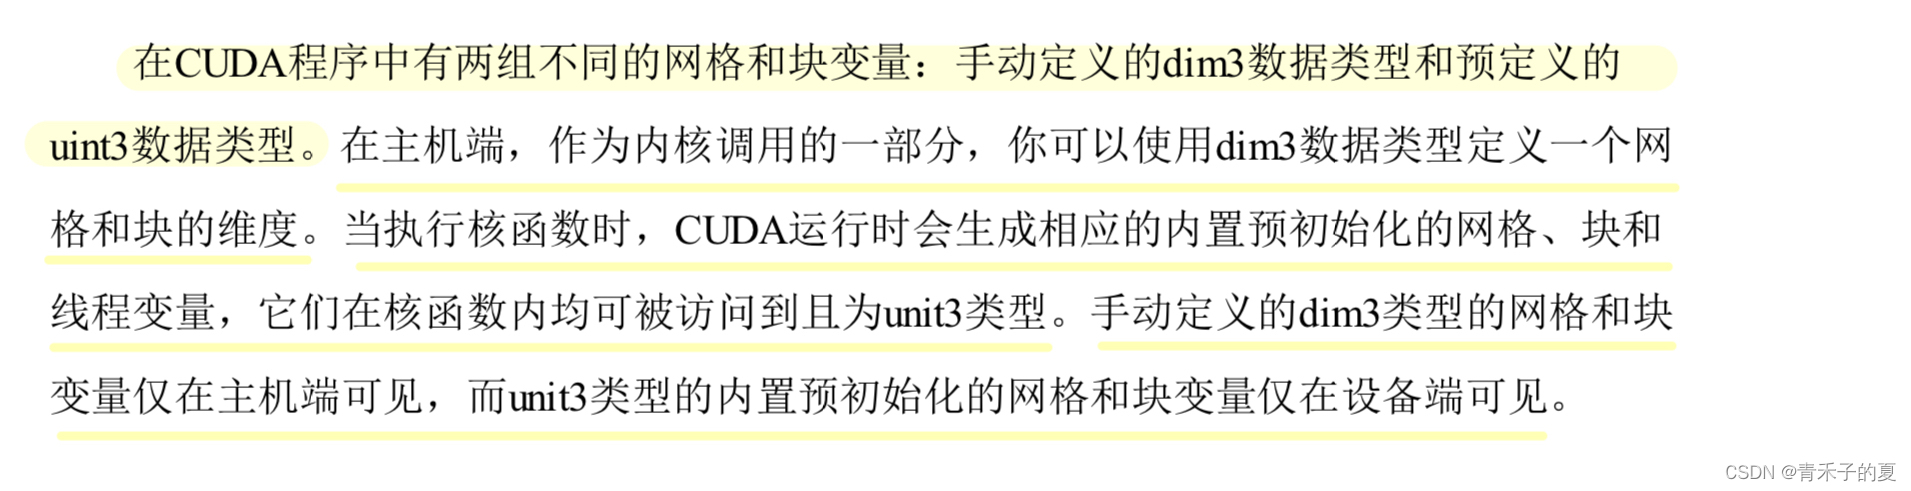
对于块大小的一个主要限制因素就是可利用的计算资源,如寄存器,共享内存等。

4. 启动一个CUDA核函数

CUDA内核调用是对C语言函数调用语句的延伸,<<<>>>运算符内时核函数的执行配置。

kernel_name <<<grid, block>>>(argument list);

执行配置中的第一个值是网格维度,也就是启动块的数目。第二个值是块维度,也就是每个块中线程的数目。

核函数的调用与主机线程是异步的。核函数调用结束后,控制权立刻返回给主机端。可以调用以下函数来强制主机端程序等待所有的核函数执行结束:

        cudaError_t cudaDeviceSynchronize(void);

一些CUDA运行时API在主机和设备之间是隐式同步的当使用cudaMemcpy函数在主机和设备之间拷贝数据时,主机端隐式同步,即主机端程序必须等待数据拷贝完成后才能继续执行程序。cudaMemcpy之前所有的核函数调用完成后开始拷贝数据。当拷贝完成后,控制权立刻返回给主机端。

异步行为

不同于C语言的函数调用,所有的CUDA核函数的启动都是异步的。CUDA内核调用完成后,控制权立刻返回给CPU。

5. 编写核函数

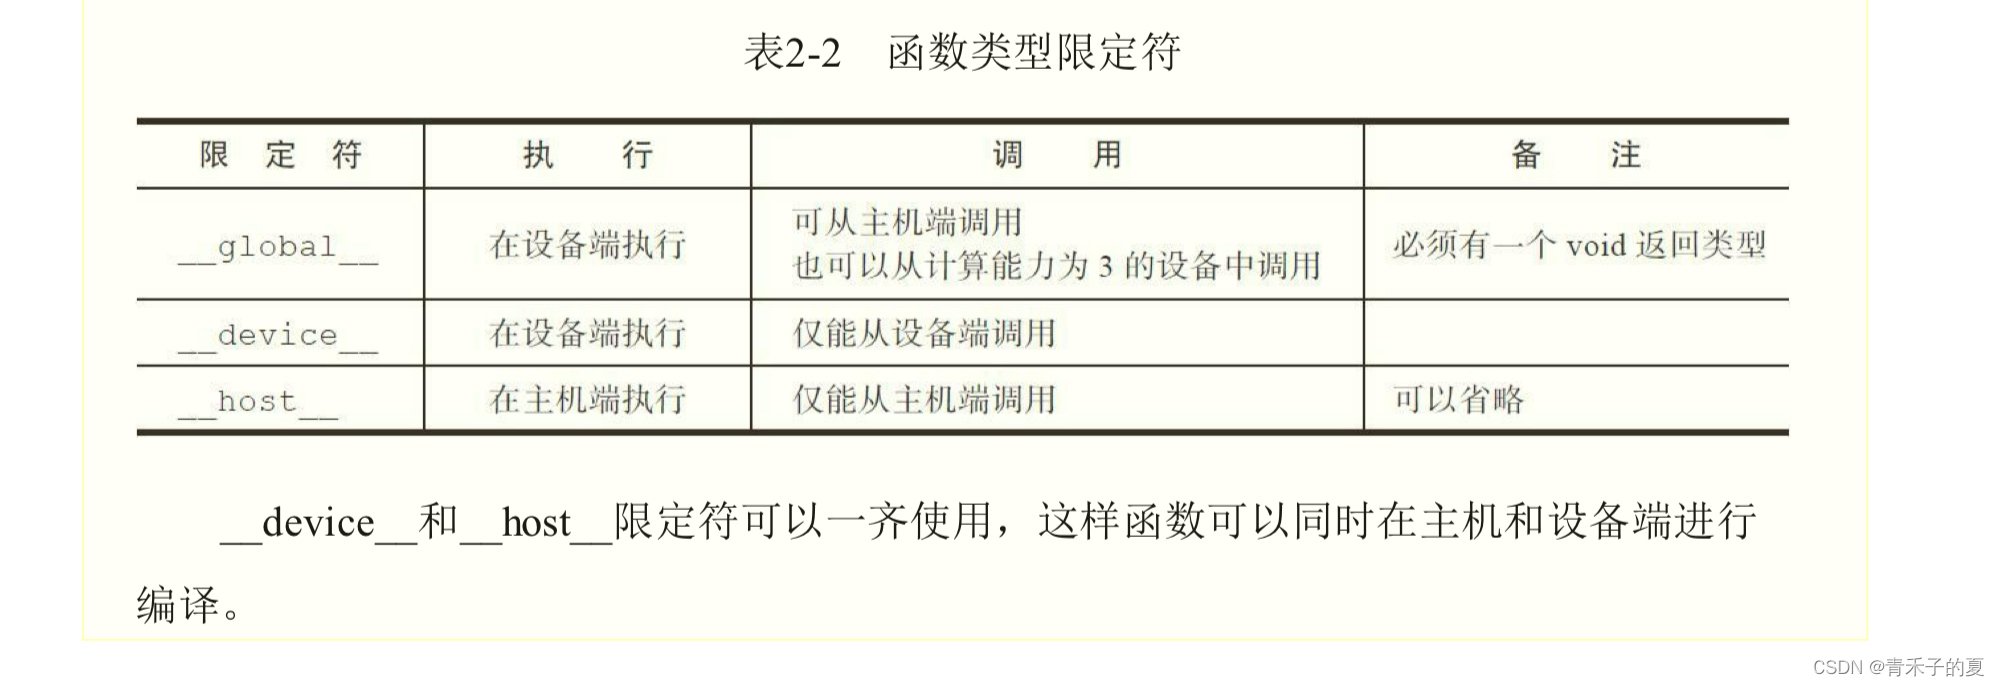
核函数是在设备端执行的代码。在核函数中,需要为一个线程规定要进行的计算以及要进行的数据访问。当核函数被调用时,许多不同的CUDA线程并行执行同一个计算任务。以下是用__global__声明定义核函数:

        __global__ void kernel_name(argument list);

核函数必须有一个void返回类型。
CUDA函数的限制

· 只能访问设备内存

· 必须具有void返回类型

· 不支持可变数量的参数

· 不支持静态变量

· 显示异步行为

6. 验证核函数
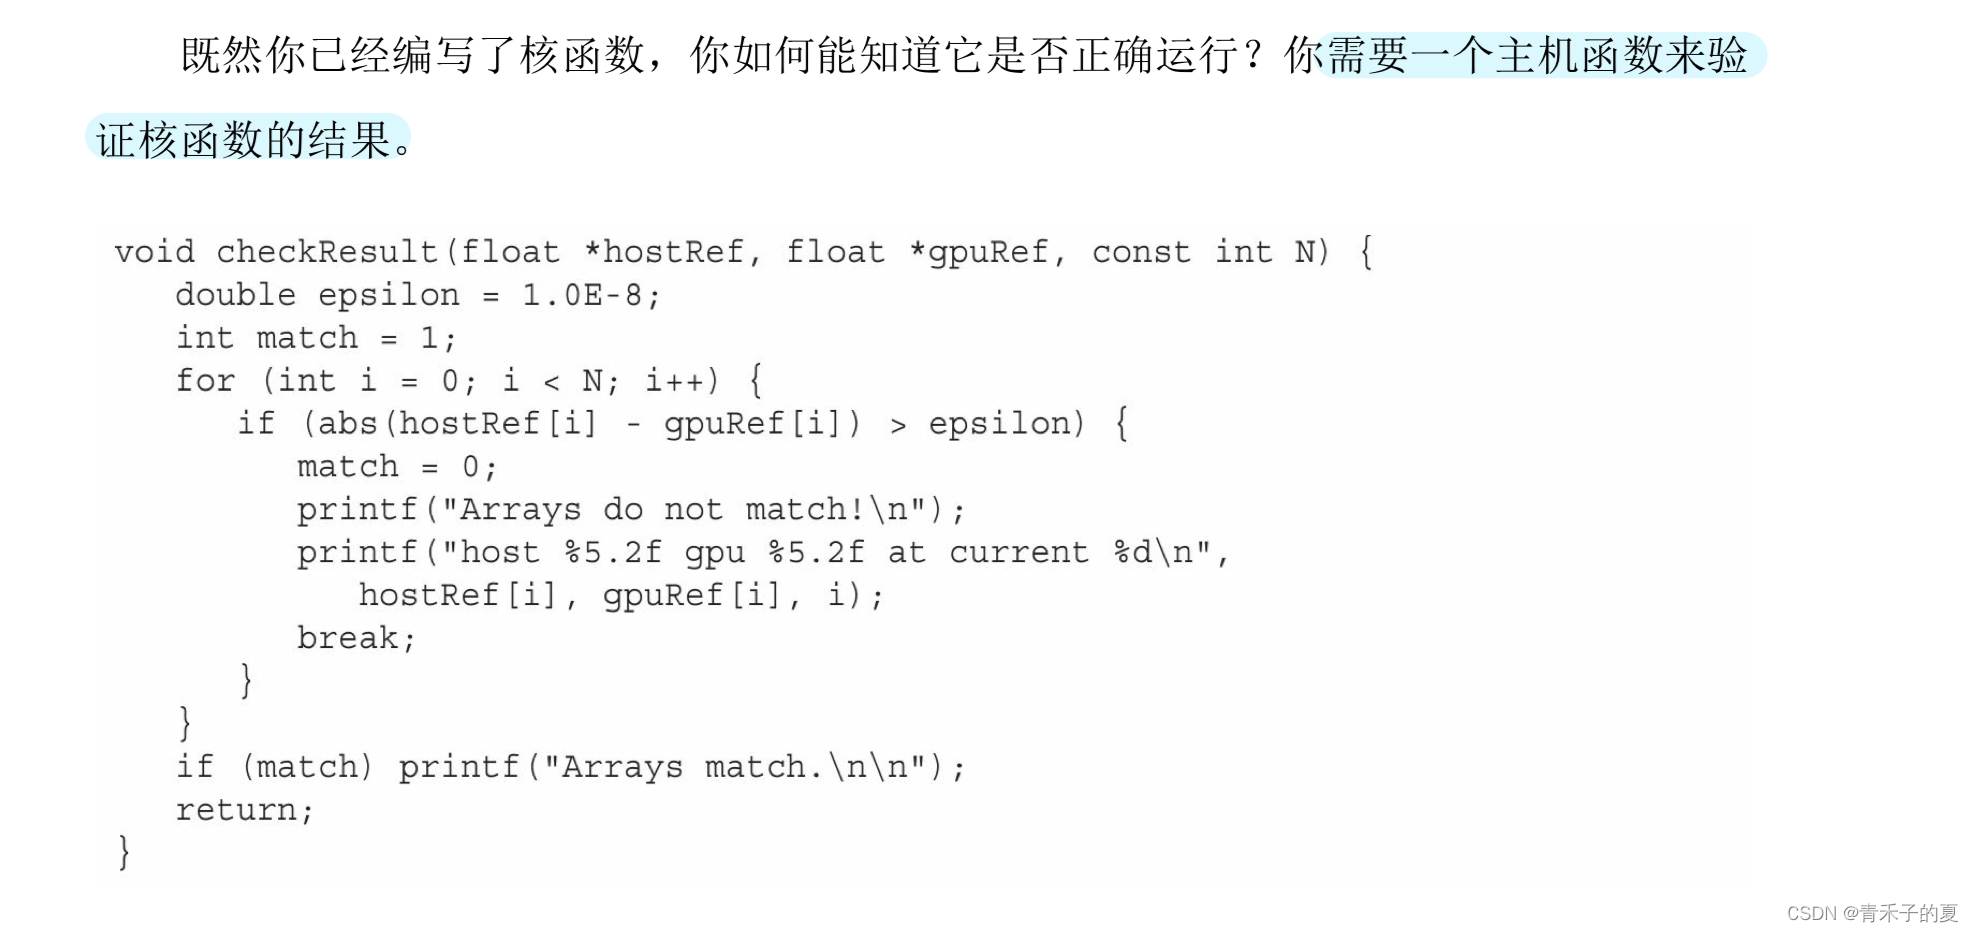
验证核函数代码

两个简单实用的方法:① 在核函数中使用printf函数。② 可以将执行参数设置为<<<1,1>>>,强制用一个块核一个线程执行核函数,模拟串行执行程序。

7. 处理错误

由于许多CUDA调用是异步的,所以有时可能很难确定某个错误是由哪一步程序引起的。定义一个错误处理宏封装所有的CUDA API调用,这简化了错误检查过程:
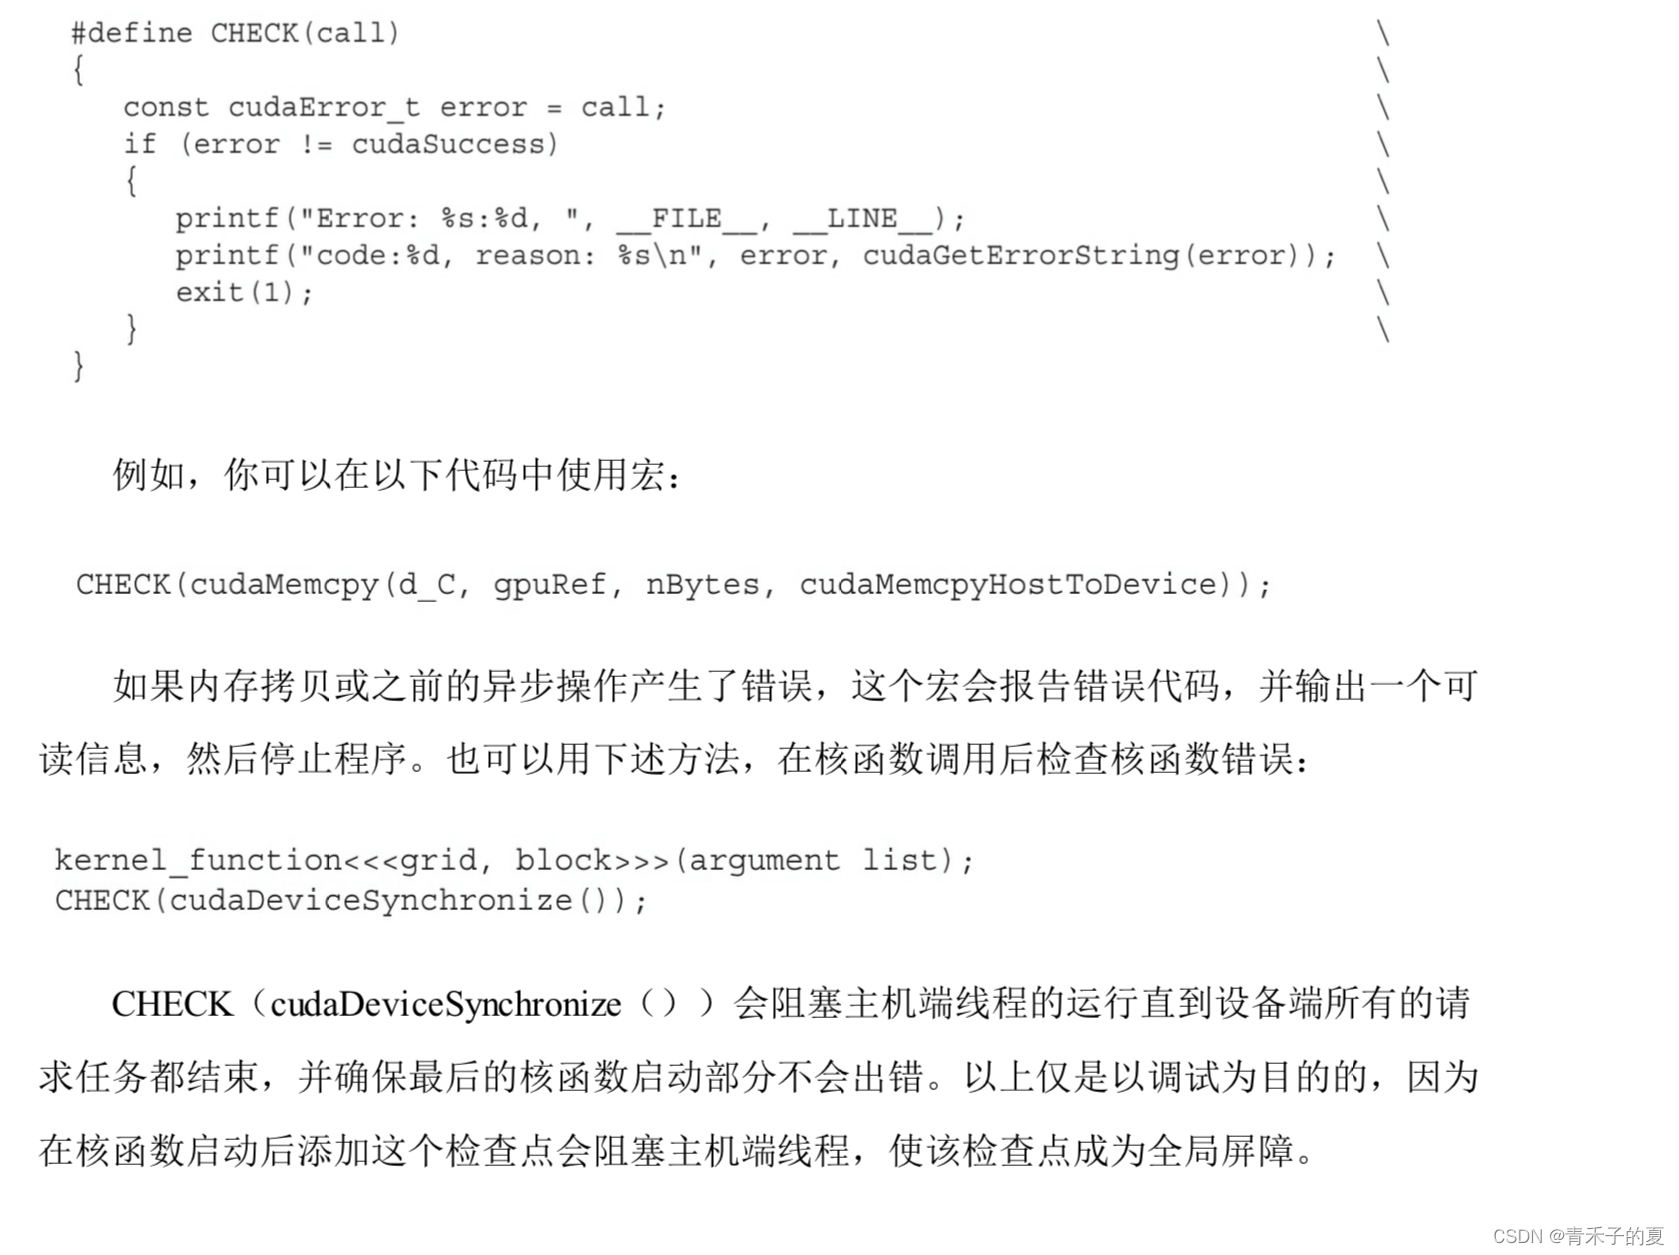
二、给核函数计时

衡量核函数性能的方法有很多,最简单的方法是在主机端使用一个CPU或GPU计时器来计算内核的执行时间。

1. 用CPU计时器计时
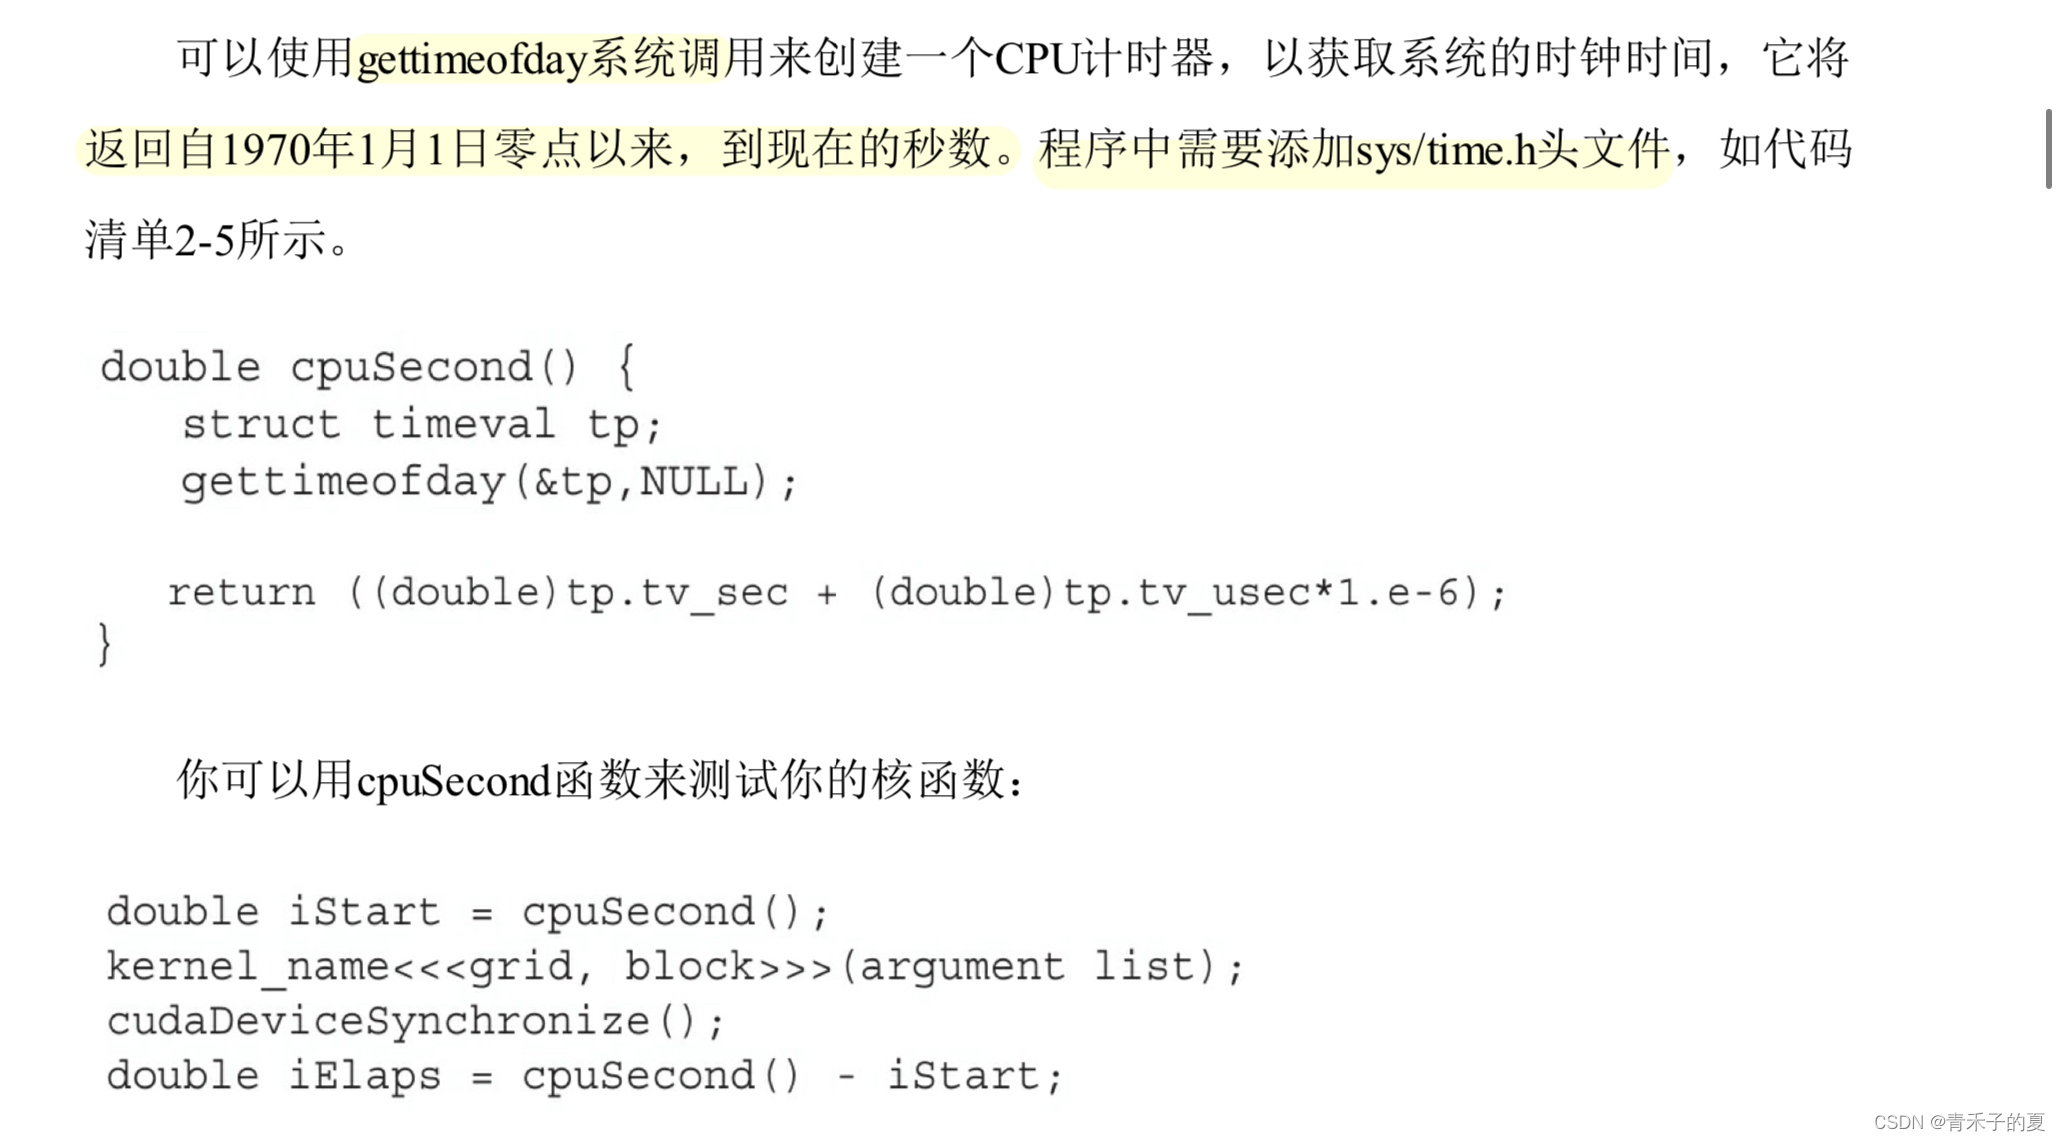
2. 用nvprof工具计时

将应用程序的测量值与理论峰值进行比较,可以判定你的应用程序时受限于算法还是受限于内存带宽。大多数HPC工作负载受内存带宽的限制。

3. 组织并行线程

· 改变执行配置对内核性能有影响

· 传统的核函数实现一般不能获得最佳性能

· 对于一个给定的核函数,尝试使用不同的网格和线程块大小可以获得更好的性能

四、 设备管理

在本节,你将通过以下两种方法学习查询和管理GPU设备:

· CUDA运行时API函数

· NVIDIA系统管理界面(nvidia-smi)命令行实用程序

对于一个有N个GPU的系统,nvidia-smi从0到N-1标记设备ID。使用环境变量CUDA_VISIBLE_DEVICES,就可以在运行时指定所选的GPU且无须更改应用程序。例如,设置CUDA_VISIBLE_DEVICES=2,3。然后在运行时,nvidia驱动程序将只使用ID为2和3的设备,并会将设备分别映射为0和1。

CUDA C编程权威指南.pdf 立即下载

相关推荐

PX4二次开发实战:从零构建自定义飞控模块

本文详细介绍了PX4二次开发的实战指南,从环境搭建到自定义飞控模块的创建,涵盖了uORB消息定义、外部传感器驱动集成、控制算法实现等关键步骤。通过具体代码示例和调试技巧,帮助开发者快速入门PX4二次开发,构建高效稳定的无人机飞控系统。

weixin_29175469的博客 339

CUDA C编程权威指南Chapter1&2

基于这些坐标,你可以将部分数据分配给 不同的线程。全局类似于CPU的系统内存,而共享内存类似于CPU的缓存。然而GPU的共享内存可以由CUDA C的内核直接控制。构成,一个线程块包含一组线程,同一线程块内 的线程协作可以通过同步和共享内存来实现。不同块内的线程不能协作。同一网格中的所有线程共享相同 的全局内存空间。(线程格的维度,用每个线程格中的线程数来表示)(线程块的维度,用每个线程块中的线程数来表示)形式,一个线程块会被组织成线程的。一个线程格会被组织成线程块的。(线程块在线程格内的索引)

m0_73535031的博客 1045

新手必看:如何用T265和ROS实现无人机室内精准定位(附PX4参数配置)

本文详细介绍了如何使用Intel Realsense T265和ROS实现无人机室内精准定位,包括硬件准备、ROS数据流架构设计、PX4参数配置及系统验证。特别针对视觉SLAM技术在室内环境中的应用,提供了从零搭建到进阶优化的全流程解析,适合无人机开发新手快速上手。

weixin_30642561的博客 406

【AI实战】CUDA 编程入门及开源项目代码分享

CUDA 编程入门及开源项目代码分享

Zack的博客 5482

逆向工程师必备:用MDL绕过游戏保护读取内存数据的完整流程(附POC代码)

本文深入探讨了内核级内存访问技术,重点介绍了如何利用MDL(Memory Descriptor List)机制稳定、隐蔽地绕过游戏反作弊系统读取进程内存。通过对比MmCopyVirtualMemory等方法的优劣,提供了完整的MDL映射实战代码与反检测策略,为逆向工程师在内核态进行安全内存操作提供了专业指导。

weixin_29227425的博客 626

MOSFET和IGBT栅极驱动器电路的基本原理学习(2)

1.PWM直接驱动 驱动主开关晶体管栅极的最简单方法是利用 PWM 控制器的栅极驱动输出,如图 (1)如 图 8中所示,PWM 控制器和 MOSFET 之间可能有较大距离。由于栅极驱动和接地环路迹线形成的环路,这个距离形成了寄生电感,从而降低了开关速度,并导致栅极驱动波形中形成振铃。为了降低与栅极驱动连接相关的电感,需要更宽的 PCB 迹线。 (2)直接栅极驱动的另一个问题是PWM 控制器的驱动电流能力有限。极少有集成电路能提供高于 1A 的峰值栅极驱动能力。 2.旁路电容的确定 (1)位置 如果是独立的

weixin_43732932的博客 5834

cuda c权威编程指南_CUDA C++程序设计模型

CUDA C++程序设计模型 本章介绍了CUDA编程模型背后的主要概念,概述了它们在C++中的暴露方式。在编程接口中给出了CUDA C++的广泛描述。 使用的矢量加法示例的完整代码可以在矢量加法CUDA示例中找到。 一. 内核 CUDA C++通过允许程序员定义C++函数,称为内核,扩展了C++,当调用时,用n个不同的CUDA线程并行执行n次,而不是像常规C++函数那样只执行一次。 一个内核使用...

weixin_39802814的博客 630

python爬取巨潮资讯网所有股票年报数据

爬虫获取巨潮资讯网数据

qq_42752524的博客 6125

CUDA C编程权威指南-chapter 3

CUDA架构是围绕一个流式多处理器的可扩展阵列搭建的。Fermi SM的关键组件:CUDA核心共享内存/一级缓存寄存器文件加载/存储单元特殊功能单元线程束调度器。每个SM都能支持数百个线程并发执行,每个GPU通常有多个SM,所以在一个GPU上并发执行数千个进程是有可能的。CUDA采用单指令多线程(SIMT)架构来管理和执行线程,每32个线程为一组,被称为。线程束中所有线程同时执行相同的指令。

m0_73535031的博客 895

如何用Python实现SPEI指数计算?从数据准备到结果可视化完整指南

本文提供了一份完整的Python实现SPEI指数计算指南,涵盖从数据准备、潜在蒸散量计算到结果可视化的全流程。详细介绍了使用Thornthwaite方法计算PET、拟合三参数log-logistic分布以及标准化转换的核心算法,并提供了模块化代码和可视化方案,帮助用户构建可复用的干旱分析工具。

cola5的博客 269

MATLAB 设置legend加标题

x1 = linspace(0,5); y1 = sin(x1/2); plot(x1,y1) hold on x2 = [0 1 2 3 4 5]; y2 = [0.2 0.3 0.6 1 0.7 0.6]; scatter(x2,y2,'filled') hold off legend({'sin(x/2)','2016'},'Location','northwest','Orientation','horizontal')%水平 legend添加标题 lgd = legend; lgd.Fon

早起CaiCai的学习空间 4714

CUDA C编程权威指南笔记

CUDA C编程权威指南笔记,浅谈CUDA编程的思想和原理

weixin_74277223的博客 1046

化工热力学软件:Aspen Plus二次开发_(9).过程控制与动态模拟v1

Aspen Plus 提供了丰富的过程控制工具和方法,可以用于静态和动态过程的模拟和控制策略的开发。通过控制回路设计、动态模拟、优化工具和数据交换接口,用户可以设计和优化各种复杂的控制策略,提高化工生产的稳定性和效率。此外,结合外部软件(如MATLAB、Simulink、LabVIEW等),可以实现更高级的控制策略,如自适应控制和模型预测控制,进一步提升过程控制的精度和灵活性。希望本文的内容能帮助用户更好地理解和应用Aspen Plus中的过程控制功能。

kkchenjj的博客 408

【亲测免费】 CUDA C编程权威指南简介

CUDA C编程权威指南简介 【下载地址】CUDAC编程权威指南简介 本资源是《CUDA C编程权威指南》系列的一部分,具体为第一部分(1/1)。本书面向希望深入学习和掌握CUDA技术的开发者,CUDA是一种由NVIDIA推出的通用并行计算平台和编程模型,它允许开发者利用GPU的强大计算能力来加速计算密集型任务 ...

gitblog_06620的博客 568

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

CUDA C编程权威指南习题解析

6.为执行核函数的每个线程提供了一个唯一的线程ID,通过内置变量threadIdx.x可以在内核中对线程进行访问。3.用cudaDeviceSynchronize 函数来替换hello.cu中的cudaDeviceReset函数,然后编译运行,看看会发生什么。4.参考1.3节,从编译器命令行中移除设备架构标志,然后按照下面的方式进行编译,看看会发生什么。2.从hello.cu中移除cudaDeviceReset函数,然后编译运行,看看会发生什么。(1)对于二维数据,沿x轴进行块划分。

谢白羽 1516

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

CUDA编程模型

本文介绍了《CUDA C编程权威指南》第二章的核心内容,重点讲解了CUDA编程模型的基础知识,还介绍了设备管理、错误检查工具以及性能优化思路。

zyh15的博客 961

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

CUDA C编程权威指南 第二章 CUDA编程模型

CUDA6.0开始 有"统一寻址"(Unified Memory)编程模型,可以用单个指针访问CPU和GPU内存,无须手动拷贝 主机启动内核后,管理权立刻返回给主机(类似启动线程后,不join) C函数 CUDA C函数 malloc cudaMalloc memcpy cudaMemcpy memset cudaMemset free cudaFree cuda...

Claroja 639

CUDA C编程权威指南 第3章 CUDA执行模型

CUDA编程模型中两个主要的抽象概念:内存层次结构和线程层次结构。它们能够控制大规模并行GPU。GPU架构是围绕一个流式多处理器(SM)的可扩展阵列搭建的。GPU中每一个SM都能支持数百个线程并发执行,每个GPU通常有多个SM,所以在一个GPU上并发执行数千个线程是可能的。当启动一个内核网格时,它的线程块被分布在了可用的SM上来执行。多个线程块可能会被分配到同一个SM上,而且是根据SM资源的可用性进行调度的。

weixin_44500921的博客 1043

cuda c权威编程指南_CUDA编程入门(一)CUDA编程模型

前一段时间做实验,发现自己写的有些代码效率比较低,GPU利用率不高。而且现在逐渐觉得用Pytorch等框架有时不够自由,导致某些idea难以实现。所以最近在学习CUDA编程,这一系列文章会整理一下所学的东西,希望能和大家共同学习共同进步。如有文中错误的地方,希望大家不吝指出,谢谢!我个人主要是通过以下三本书进行学习的,建议初学者从《CUDA C编程权威指南》入手进行学习。CUDA并行程序设计——G...

weixin_39762075的博客 518

【快速上手】探索CUDA编程的奥秘:《CUDA C 编程指南》推荐

探索CUDA编程的奥秘:《CUDA C 编程指南》推荐 ????【免费下载地址】CUDAC编程指南程润伟资源下载 本仓库提供了一份珍贵的资源文件——《CUDA C 编程指南》,由美国华裔教授大牛程润伟最新力作。这本书是学习CUDA编程的必备经典图书,适合所有对CUDA编程感兴趣的开发者、研究人员和学生。 ...

gitblog_09774的博客 803

CUDA_C编程权指南-chapter2_CUDA编程模型

CUDA编程模型提供了一个计算机架构抽象来作为应用程序和其可用的硬件之间的桥梁。GPU编程模型根据GPU架构的计算能力,提供了以下几个特有的功能:1、一种通过层次结构在GPU中组织线程的方式,2、一种通过层次结构在GPU中访问内存的方式。

邹九的个人博客 844

【亲测免费】 探索CUDA并行编程的宝藏:《CUDA并行程序设计 GPU编程指南》与源码资源

探索CUDA并行编程的宝藏:《CUDA并行程序设计 GPU编程指南》与源码资源 【下载地址】CUDA并行程序设计资源下载 CUDA并行程序设计资源下载本仓库提供了一个重要的资源文件下载,内容包括《CUDA并行程序设计 GPU编程指南》522页的电子书以及《CUDA C编程权威指南》的源码 ...

gitblog_09736的博客 992

CUDA C 编程权威指南 第一章 基于CUDA的异构并行计算

CUDA(Compute Unified Device Architecture, 统一计算设备架构)是NVIDIA提出的并行计算架构,主要用来处理密集型及并行计算。GPU和CPU是两个独立的处理器,通过单个计算节点中的PCI- Express总线相连,GPU用来提高计算密集型应用程序中并行程序段的执行速度,CPU则负责管理设备端的资源。

weixin_44500921的博客 1474

CUDA C 编程指南

CUDA C 编程指南 【下载地址】CUDAC编程指南 本仓库提供《CUDA C 编程指南》PDF文件,是一份全面且实用的技术文档,专为开发者设计,帮助掌握CUDA C编程的核心知识与技巧。指南详细介绍了CUDA C的基本概念、编程模型以及性能优化方法,适合希望提升并行计算编程能力的开发者。通过结合实际编程实践,您可以更...

gitblog_06779的博客 495

【免费下载】 NVIDIA CUDA编程指南下载

NVIDIA CUDA编程指南下载 【下载地址】NVIDIACUDA编程指南下载分享 NVIDIA CUDA编程指南下载本仓库提供了一份重要的资源文件——**CUDA_C_Programming_Guide.pdf**,该文件是NVIDIA官方发布的CUDA编程指南 ...

gitblog_06682的博客 963

《CUDA C编程权威指南》学习笔记 chap1-3

第二章 CUDA编程模型 2.1 CUDA编程模型概述 内存管理 GPU内存分配:cudaMalloc cudaError_t cudaMalloc(void** devPtr, size_t size) 该函数负责向设备分配一定字节的线性内存,并以devPtr的形式返回指向所分配内存 的指针。cudaMalloc与标准C语言中的malloc函数几乎一样,只是此函数在GPU的内存里分 配内存。通过充分保持与标准C语言运行库中的接口一致性,可以实现CUDA应用程序的 轻松接入。 2. 主机和设备之间的

ambition_zhou的博客 1012
上一篇: C++ Primer 第五版 第十三章 拷贝控制
下一篇: C++ prime 第五版 第14章 重载运算与类型转换
青禾子的夏
博客等级 码龄8年 405粉丝 68原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值