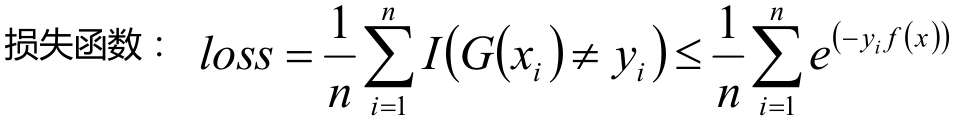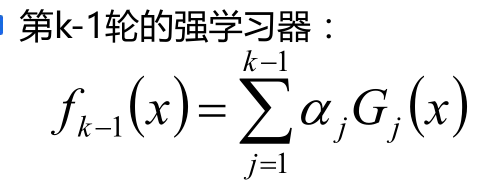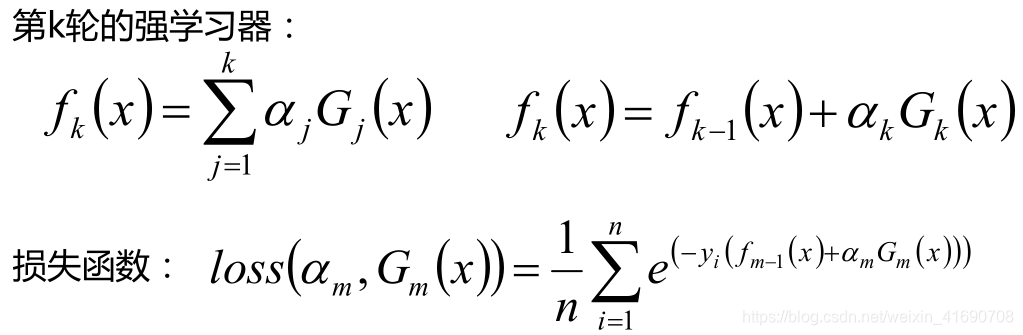Boosting(提升)算法之Adaboost

AdaBoost(Adaptive Boosting,自适应提升算法) AdaBoost 算法与随机森林算法一样都属于分类算法中的集成算法。 集成算法通常有两种方式,分别是投票选举(bagging)和再学习(boosting)。 投票选举的场景类似把专家召集到一个会议桌前,当做一个决定的时候,让 K 个专家(K 个模型)分别进行分类,然后选择出现次数最多的那个类作为最终的分类结果。 再学习相当于把 K 个专家(K 个分类器)进行加权融合,形成一个新的超级专家(强分类器),让这个超级专家做判断。 Boosting 的含义是提升,它的作用是每一次训练的时候都对上一次的训练进行 阅读详情

Boosting算法思想:

Boosting是一种框架算法,主要是通过对样本集的操作获得样本子集,然后用弱分类算法在样本子集上训练生成一系列的基分类器。他可以用来提高其他弱分类算法的识别率,也就是将其他的弱分类算法作为基分类算法放于Boosting 框架中,通过Boosting框架对训练样本集的操作,得到不同的训练样本子集,用该样本子集去训练生成基分类器;每得到一个样本集就用该基分类算法在该样本集上产生一个基分类器,这样在给定训练轮数 n 后,就可产生 n 个基分类器,然后Boosting框架算法将这 n个基分类器进行加权融合,产生一个最后的结果分类器,在这 n个基分类器中,每个单个的分类器的识别率不一定很高,但他们联合后的结果有很高的识别率,这样便提高了该弱分类算法的识别率。在产生单个的基分类器时可用相同的分类算法,也可用不同的分类算法,这些算法一般是不稳定的弱分类算法,如神经网络(BP) ,决策树(C4.5)等。如下图
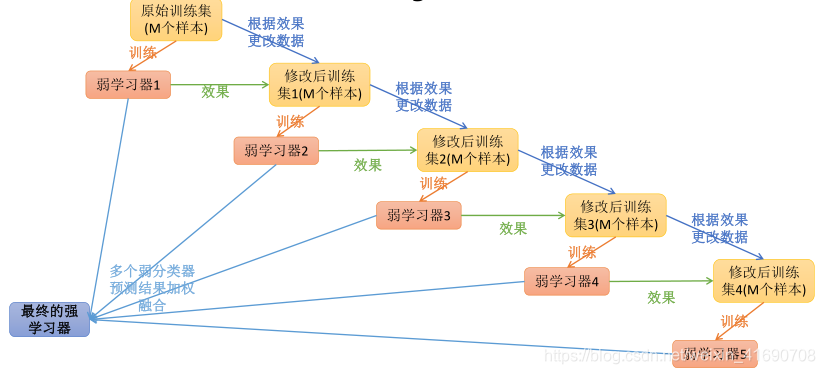
提升学习的常见算法模型为:Adaboost、GBDT、Xgboost

Adaboost算法分析

 算法原理:

Adaptive Boosting是一种迭代算法。每轮迭代中会在训练集上产生一个新的学习器,然后使用该学习器对所有样本进行预测,以评估每个样本的重要性(Informative)。换句话来讲就是,算法会为每个样本赋予一个权重,每次用训练好的学习器标注/预测各个样本,如果某个样本点被预测的越正确,则将其权重降低;否则提高样本的权重。权重越高的样本在下一个迭代训练中所占的比重就越大,也就是说越难区分的样本在训练过程中会变得越重要;整个迭代过程直到错误率足够小或者达到一定的迭代次数为止

   Adaboost的核心思想是通过反复修改数据的权重,从而使一系列弱学习器成为强可学习器.其核心步骤如下: 
- 权值调整,提升被错误分类的样本的权重,降低被正确分类的权重 
- 基分类器组合,采用加权多数表决算法,加大分类误差率较小的弱分类器的权重,减小误差大的.

可以构造出一个非常准确的强分类器。强分类器的计算公式为:
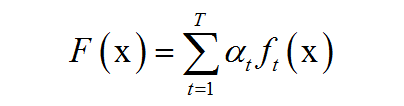
其中x是输入向量,F(x)是强分类器,ft(x)是弱分类器,αt是弱分类器的权重值,是一个正数,T为弱分类器的数量。弱分类器的输出值为+1或-1,分别对应于正样本和负样本。分类时的判定规则为:

其中sgn是符号函数。强分类器的输出值也为+1或-1,同样对应于正样本和负样本。弱分类器和它们的权重值通过训练算法得到。之所以叫弱分类器是因为它们的精度不用太高。

训练模型的过程:

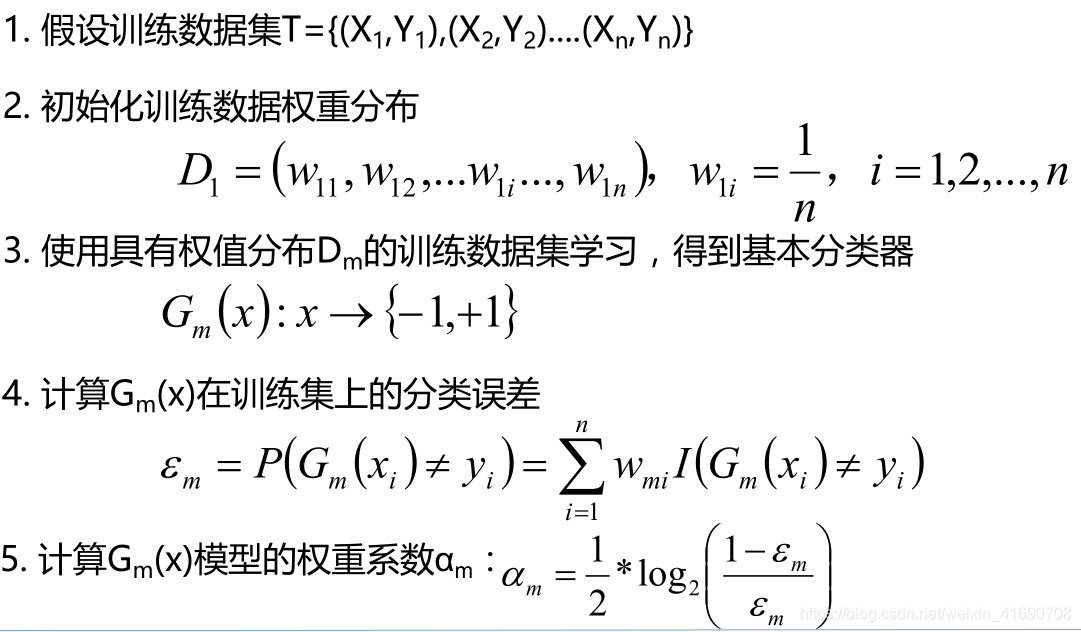
训练时,依次训练每一个弱分类器,并得到它们的权重值。训练样本同样带有权重,初始时所有样本的权重相等,被前面的弱分类器错分的样本会加大权重,反之会减小权重,因此接下来的弱分类器会更加关注这些难分的样本。弱分类器的权重值根据它的准确率构造,精度越高的弱分类器权重越大。给定l个训练样本(xi,yi),其中xi是特征向量,yi为类别标签,其值为+1或-1。训练算法的流程如下:

初始化样本权重值,所有样本的初始权重相等:

循环,对t=1,…,T依次训练每个弱分类器:

训练一个弱分类器ft(x),并计算它对训练样本集的错误率et

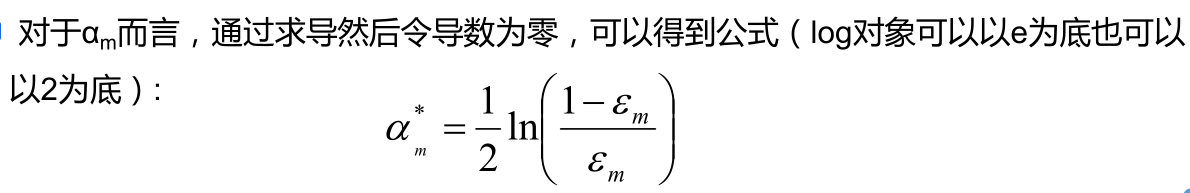
计算弱分类器的权重:
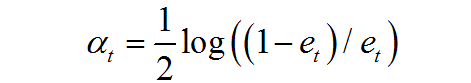
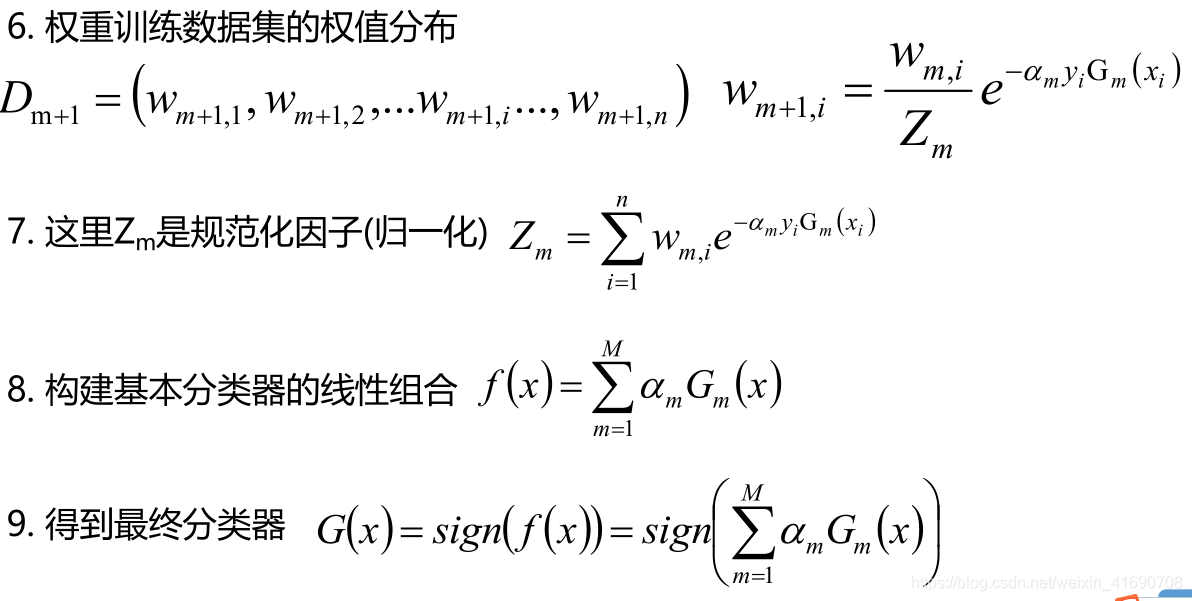
更新所有样本的权重:

其中Zt为归一化因子,它是所有样本的权重之和:
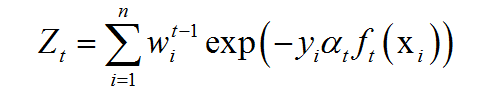
结束循环

最后得到强分类器:
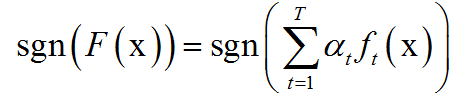
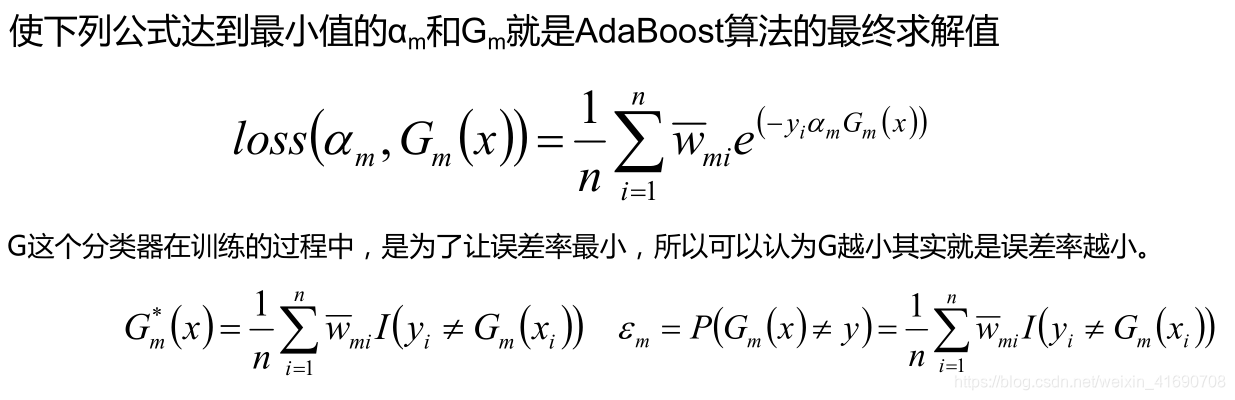
损失函数取
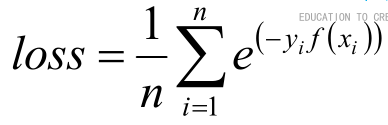
总而言之关注之前被错分的样本,准确率高的弱分类器有更大的权重。
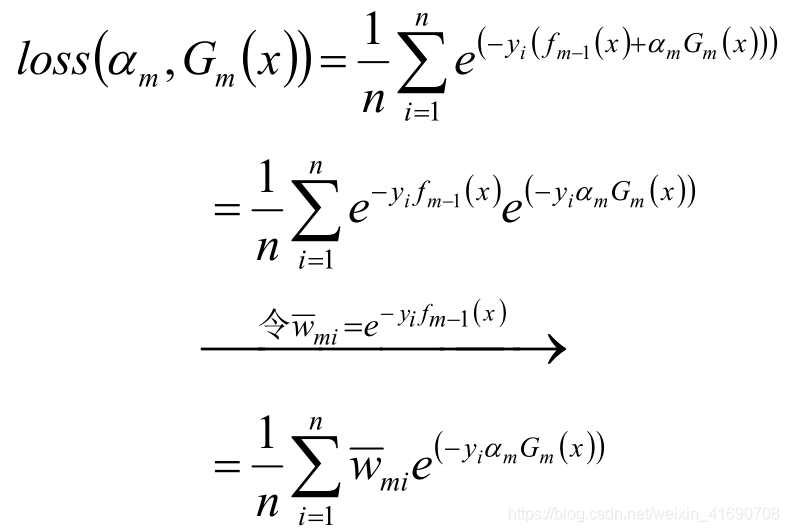
Adaboost算法构建过程:

过程1
过程2

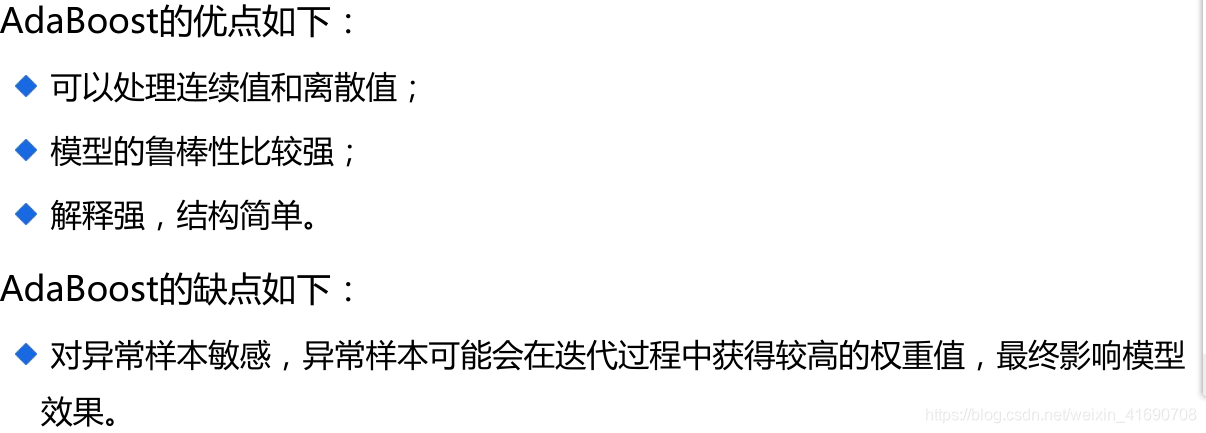
优缺点:
本文主要参考西瓜书和统计学习(李航版本)

提升法算法(Boosting)和AdaBoost算法 而AdaBoost作为提升法算法中较为经典的实现之一,通过关注错误分类样本和调整样本权重来达到提升分类性能的目的。本文将从提升法算法的基本原理出发,详细介绍AdaBoost算法的工作机制和实现过程,并提供相应的源代码示例。提升法是一种迭代的学习方法,其核心思想是通过构建一个系列的基分类器,并在每次迭代中关注被前一轮模型错误分类的样本,从而逐步提高整体模型的分类性能。AdaBoost是提升法算法中最为著名和成功的实现之一,其特点是集中关注错误分类的样本,并通过调整样本权重来强调这些样本的重要性。 阅读详情

相关推荐

BOOSTING分类器

Boosting, 也称为增强学习或提升法 , 是一种重要的集成学习技术 , 能够将预测精度仅比随 机猜度略高的弱学习器增强为预测精度高的强学习器 , 这在直接构造强学习器非常困难的 情况下 , 为学习算法的设计提供了一种有效的新思路和新方法 . 作为一种元算法框架 , Boosting 几乎可以应用于所有目前流行的机器学习算法以进一步加强原算法的预测精度 , 应用十分广泛 , 产生了极大的影响 . 而 AdaBoost 正是其中最成功的代表 , 被评为数据挖掘 十大算法之一

谈谈AdaBoost算法

菜鸟最近开始学习machine learning。发现adaboost 挺有趣,就把自己的一些思考写下来。 主要参考了http://stblog.baidu-tech.com/?p=19,其实说抄也不为过,但是我添加了一些我认为有意思的东西,所以我还是把它贴出来了,呵呵。 一 Boosting 算法的起源 boost 算法系列的起源来自于PAC Learnabilit

jingchajingxia的专栏 986

Unity Spine 3.8 (URP) 踩坑(Shader报错修改)

提供了新思路,打算尝试一下URP。但美术使用的spine版本是3.8,项目用的Unity2021.3.11f1c2,直接导入spine URP包,shader报错:half4 不能转成 SurfaceData2D;Spine-Sprite-StandardPass-URP-2D.hlsl 也报这个错,也是同样的改法即可。今天搜索spine优化,看到一篇文章。

hrlr1230的博客 4564

Boosting算法简介

一、Boosting算法的发展历史   Boosting算法是一种把若干个分类器整合为一个分类器的方法,在boosting算法产生之前,还出现过两种比较重要的将多个分类器整合为一个分类器的方法,即boostrapping方法和bagging方法。我们先简要介绍一下bootstrapping方法和bagging方法。   1)bootstrapping方法的主要过程   ...

weixin_34249367的博客 1391

LVGL9.2移植至正点原子阿波罗STM32F429开发板

LVGL(Light and Versatile Graphics Library)是一个开源的图形库,旨在为嵌入式系统提供高效、灵活的图形用户界面(GUI)解决方案。它具有小巧的内存占用和高性能的渲染能力,支持多种硬件平台,包括单片机、DSP 和 ARM 处理器等。LVGL 支持丰富的控件(如按钮、标签、图标、滚动条等),并提供强大的主题、样式和动画功能,使得开发者能够轻松设计出美观且响应迅速的界面。

m0_51149752的博客 3173

残差检验_第三十讲 R语言-Cox比例风险模型的假设检验条件

在介绍完 Cox比例风险模型的详细理论和R实现以后(插入链接!!!),我们已经知道Cox比例风险模型可以较好的同时矫正多个混杂因素对结果的影响,同时我们遗留下来了一个问题:Cox比例风险模型的假设检验条件是什么?这一讲,我们将对此进行解答。请注意,如果使用不当,统计模型可能会产生误导性的结论。因此,检查给定的模型是否适合数据类型是非常重要的!1. Cox比例风险模型的假设条件Cox比例风险模型的成...

weixin_35476698的博客 8047

实战 | AdaBoost算法

1. 写在前面 今天的主角AdaBoost算法,这是集成方法的一种方式,通过今天的学习,快速Get到AdaBoost的原理,并最后运用AdaBoost算法实现对波士顿房价的预测。 现在一...

qq_21787049的博客 875

IEEE 754浮点数与十六进制转换:从原理到实战避坑指南

在计算机系统中,数据的二进制表示与内存布局是底层开发的核心基础。IEEE 754标准定义了浮点数在内存中的精确格式,包括符号位、指数位和尾数位的分工,以及零、无穷大和NaN等特殊值的编码。理解这一原理对于处理原始字节流至关重要,尤其是在涉及跨平台或跨设备通信时。其技术价值在于,它能帮助开发者从根本上解决数据解析错误、通信协议不一致以及程序调试中的“灵异”问题。在嵌入式开发、网络通信(如Modbus协议)和固件解析等应用场景中,浮点数与十六进制的转换是高频操作。然而,字节序(大端/小端)是转换过程中最常见的“

weixin_33835103的博客 430

机器学习算法总结之Boosting:AdaBoost

写在前面 正所谓“三个臭皮匠,顶个诸葛亮”,在机器学习中也存在这样的哲理。提升方法(Boosting)就是这样的代表:通过将一系列弱学习器综合提升为强学习器的算法。Boosting族算法的工作机制:(1)先从初试训练集训练出一个基学习器;(2)再根据基学习器的表现对训练样本进行调整,使得先前基学习器做错的训练样本在后续训练中受到更多关注;(3)基于调整后的训练样本继续训练下一个基学习器;(4)如...

Kaiyuan_sjtu的博客 4421

JSP期末考试复习习题及答案

以下习题是对于平时课堂小测的整理,如有错误敬请指正! 欢迎一起交流~ 预祝各位小伙伴们考试顺利! Test1 一. 单选题 – 1.(单选题)当用户请求jsp页面时,JSP引擎就会执行该页面的字节码文件响应客户的请求,执行字节码文件的结果是() A. 发送一个JSP源文件到客户端 B. 发送一个Java文件到客户端 C. 发送一个HTML页面到客户端 D. 什么都不做 – 2.(单选题)下列动态网页和静态网页的根本区别描述错误的是( D) A. 静态网页服务器端返回的HTML文件是事先存储好的 B. 动.

技术小白 2万+

功率开关管驱动串扰(Crosstalk):深度解析与优化方案

介绍了功率开关器件驱动串扰产生机理,并整理了常见的工程应用优化措施

qq_38326420的博客 553

人工智能知识全面讲解:Boosting族算法

9.2.1 Boosting是什么Boosting是一类算法的统称,翻译成中文为“自适应”算法,它们的主要 特点是使用一组弱分类器通过“迭代更新”的方式构造一个强分类器。在每轮 迭代中会在训练集上产生一个新的弱分类器,然后使用该弱分类器对所有样本 进行分类,从而评估每个样本的重要性。从中文名可以看出来,Boosting算法 的每轮学习都会根据数据调整参数,不断提升模型的准确率。 Boosting算法的工作机制如图9-3所示。它首先基于训练样本生成一个弱 学习器,然后基于弱学习器的表现调整样本分布,即增加错误

Lee达森的博客 7771

Mac安装Claude Code的3种方式及5类报错解决方案

介绍在Mac上安装Claude Code的3种实测可行方式(官方dmg、Homebrew+ARM原生构建、Docker容器化),并针对Gatekeeper签名验证失败、Rosetta 2内存对齐崩溃、Python ABI兼容性冲突等5类高频报错提供根因分析与可复现解决方案,覆盖M1–M3及Intel

weixin_28728443的博客 361

Boosting提升算法之AdaBoost

Boosting提升算法 Boosting算法是将“弱学习算法“提升为“强学习算法”的过程,主要思想是“三个臭皮匠顶个诸葛亮”。一般来说,找到弱学习算法要相对容易一些,然后通过反复学习得到一系列弱分类器,组合这些弱分类器得到一个强分类器。Boosting算法要涉及到两个部分,加法模型和前向分步算法。 加法模型就是说强分类器由一系列弱分类器线性相加而成。一般组合形式如下: FM(x;P)=∑m=1nβmh(x;am)F _ { M } ( x ; P ) = \sum _ { m = 1 } ^ { n

cengjing12的博客 552

基于MATLAB的BOC调制信号捕获算法仿真

然而,在实际的使用过程中,由于室内信号衰减以及遮挡等因素的影响,接收机在GPS信号弱化时会很容易丢失导航信息。与其他的调制方式相比,BOC具有较好的抗多径性能和更高的频带效率。通过本文的介绍,我们可以更加深入地了解BOC调制信号的捕获算法,并且掌握了如何使用MATLAB软件对其进行仿真实现。通过实验数据的分析,我们可以看出该算法对于BOC调制信号的捕获具有较高的准确率和稳定性,因此具有一定的工程应用价值。在BOC调制完成后,我们需要进行信号的捕获,这一步涵盖了信号检测、码偏差估计、载波频率估计等过程。

2301_79326559的博客 567

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

Boosting 算法(AdaBoost,sklearn 代码示例,提升树)

Boosting 算法介绍

myDarling_的博客 1051

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

集成学习——Boosting提升方法1之AdaBoost算法

前言 Boosting方法:使用同一组数据集进行反复学习,得到一系列简单模型,然后组合这些模型构成一个预测性能十分强大的机器学习模型。显然。Boosting思想目的:通过不断减少偏差的形式 而前一篇的Bagging方法:通过Bootstrap 的方式对全样本数据集进行抽样得到抽样子集,对不同的子集使用同一种基本模型进行拟合,然后投票得出最终的预测。Bagging主要通过降低方差的方式减少预测误差 两类常用的Boosting方式:Adaptive Boosting 和 Gradient Boosting 以及

小米n416的博客 476

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

【机器学习】集成学习(Boosting)——AdaBoost提升算法(理论+图解+公式推导)

如果需要完整代码可以关注下方公众号,后台回复“代码”即可获取,阿光期待着您的光临~ 文章目录一、集成学习二、AdaBoost算法1.Boosting提升方法2.AdaBoost算法思想3.AdaBoost原理解释4.构造损失函数,求解参数5.前向分步算法 2021人工智能领域新星创作者,带你从入门到精通,该博客每天更新,逐渐完善机器学习各个知识体系的文章,帮助大家更高效学习。 一、集成学习 我们平常使用的大多数模型都为单模型方式,有时单模型方式可能会造成误判或者过拟合的现象,所以我们就像能不能有.

优快云 精品推荐 867

深入理解机器学习——集成学习(Ensemble Learning):提升法Boosting与Adaboost算法

Boosting是一族可将弱学习器提升为强学习器的算法。这族算法的工作机制类似:先从初始训练集训练出一个基学习器,再根据基学习器的表现对训练样本分布进行调整,使得先前基学习器做错的训练样本在后续受到更多关注,然后基于调整后的样本分布来训练下一个基学习器;如此重复进行,直至基学习器数目达到事先指定的值TTT,最终将这TTT个基学习器进行加权结合。 Boosting族算法最著名的代表是AdaBoost: Adaboost算法 输入: \qquad 训练集:D=(x1,y1),(x2,y2),⋯ ,(xN,yN

冯·诺依曼 1万+

提升boosting之Adaboost算法原理

AdaBoost实则是模型为加法模型、损失函数为指数函数、学习算法为前向分步算法时的二类学习方法。具体过程如下: 1.设训练数据集T 2.初始化训练数据的权值分步 3.使用具有权值分步为Dm的训练数据集学习,得到基本分类器 4.计算GM(x)在训练数据集上的误差率 5.计算GM(x)的系数 6.更新训练数据集的权值分步 7.注意 这里的Zm是规范化因子 目的是使权值和为1 8.构建基本分类...

逆光mlz 220

机器学习sklearn19.0——集成学习——boosting与梯度提升算法(GBDT)、Adaboost算法

一、boosting算法原理

loveliuzz的博客 2804

boosting算法_机器学习中最最好用的提升方法:Boosting 与 AdaBoost

在 Kaggle 及其它机器学习任务中,集成方法非常流行,不论是 XGBoost 还是随机森林,它们都强大无比。而本文作者从最基础的 Boosting 概念到 AdaBoost 算法进行了详细的介绍,并展示了如何实现 AdaBoost,这些都是走进集成方法大家族的敲门砖。最近,Boosting 技术在 Kaggle 竞赛以及其它预测分析任务中大行其道。本文将尽可能详细地介绍有关 Boosting ...

weixin_39963830的博客 310

【机器学习算法】:Boosting提升算法(Adaboost)

Boosting提升算法 所谓提升算法,即在分类问题中,通过改变训练样本的权重,学习多个分类器,并将这些分类器进行线性组合,提高分类器性能。而AdaBoost是一种典型的提升算法。 由于得到弱学习算法比强嘘唏算法更容易获取。而我们有许多将弱学习算法提升为强学习算法的Boosting方法,其中最具代表性的是AdaBoost。大多数的提升方法都是改变训练的概率分布(训练数据的权值分布),针对不同数...

yuanCruise 2142

AdaBoost(Adaptive Boosting,自适应提升算法)总结梳理

AdaBoost是一种自适应增强算法,通过迭代训练多个弱学习器(如决策树桩)并动态调整样本权重与模型权重,将弱学习器组合为强学习器。其核心在于:1)对误分类样本增加权重,使后续模型更关注难分样本;2)根据误差赋予模型不同权重,表现好的模型在最终投票中更具话语权。该算法简单高效,适合基础分类任务和数据质量验证,但存在对噪声敏感、无法并行训练等局限。相比XGBoost等后续算法,AdaBoost缺乏正则化机制,在高维稀疏数据上表现较弱。

qq_39084101的博客 1156

AdaBoost(Adaptive Boosting 自适应提升)算法

Boosting算法是一种把若干个分类器整合为一个分类器的方法,在boosting算法产生之前,还出现过两种比较重要的将多个分类器整合 为一个分类器的方法,即boostrapping方法和bagging方法。 AdaBoost 是一种迭代算法,其核心思想是针对同一个训练集训练不同的分类器,即弱分类器,然后把这些弱分类器集合起来,构造一个更强的最终分类器。 算法本身是改变数据分布

WX_Chen的博客 1178

提升方法boosting、前向分布算法--AdaBoost--提升树--梯度提升树GBDT--XGBoost--lightGBM

提升方法boosting、前向分布算法--AdaBoost--提升树--梯度提升树

weixin_44360866的博客 834
上一篇: 关于RandomForest的变种算法
下一篇: Adaboost 算法API理解
NongfuSpring-wu
博客等级 码龄9年 19粉丝 77原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值