Bagging(Bootstrap Aggregating)

Bagging(引导聚集算法)简述 目录1 概念2 原理2.1 方差2.2 模型的偏差与方差 1 概念         Bagging算法 (Bootstrap aggregating,引导聚集算法),又称装袋算法,是机器学习领域的一种团体学习算法。         Bagging算法可与其他分类、回归算法结合,提高其准确率、稳定性的同时,通过降低结果的方差,避免过拟合的发生。 b 阅读详情

思想:Bagging(bootstrap aggregating)是通过结合几个模型降低泛化误差的技术。主要想法是分别训练几个不同的模型,然后让所有模型表决测试样例的输出。 这是机器学习中常规策略的一个例子,被称为模型平均(modelaveraging)。采用这种策略的技术被称为集成方法。 
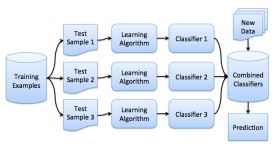
框架流程:

  1. 从原始样本集中使用Bootstraping 方法随机抽取n个训练样本,共进行k轮抽取,得到k个训练集(k个训练集之间相互独立,元素可以有重复)。
  2. 对于n个训练集,我们训练k个模型,(这个模型可根据具体的情况而定,可以是决策树,knn等)
  • 对于分类问题:由投票表决产生的分类结果;对于回归问题,由k个模型预测结果的均值作为最后预测的结果(所有模型的重要性相同)。

bagging通过在不同数据集上训练模型降低分类器的方差。换句话说,bagging可以预防过拟合。bagging的有效性来自不同训练数据集上单独模型的不同,它们的误差在投票过程中相互抵消。此外,某些bootstrap训练样本很可能略去离散值。

典型算法:与其说Bagging是一种算法啊,不如说是一种解决问题的思想,一种框架,而Random Forest是基于Bagging的一种经典装袋法。顾名思义,随机森林是一种算则分类回归树作为基模型的Bagging算法。

Random Forest :在Bagging策略的基础上进行修改后的一种算法
(1)从样本集中用Bootstrap采样选出n个样本;
(2)从所有属性中随机选择K个属性,选择出最佳分割属性作为节点创建决策树;
(3)重复以上两步m次,即建立m棵决策树;
(4)这m个决策树形成随机森林,通过投票表决结果决定数据属于那一类

随机森林的随机性体现在哪几个方面?

1、数据集的随机选取

从原始的数据集中采取有放回的抽样(bagging),构造子数据集,子数据集的数据量是和原始数据集相同的。不同子数据集的元素可以重复,同一个子数据集中的元素也可以重复。

2、待选特征的随机选取

与数据集的随机选取类似,随机森林中的子树的每一个分裂过程并未用到所有的待选特征,而是从所有的待选特征中随机选取一定的特征,之后再在随机选取的特征中选取最优的特征。

思想:

随机森林实际上是一种特殊的bagging方法,它将决策树用作bagging中的模型。首先,用bootstrap方法生成m个训练集,然后,对于每个训练集,构造一颗决策树,在节点找特征进行分裂的时候,并不是对所有特征找到能使得指标(如信息增益)最大的,而是在特征中随机抽取一部分特征,在抽到的特征中间找到最优解,应用于节点,进行分裂。随机森林的方法由于有了bagging,也就是集成的思想在,实际上相当于对于样本和特征都进行了采样(如果把训练数据看成矩阵,就像实际中常见的那样,那么就是一个行和列都进行采样的过程),所以可以避免过拟合。最终分类的时候采用多用用户投票,回归采用均值。

为什么绝大多数随机森林算法中用的都是cart树

在sklearn中的随机森林算法中用的就是cart树,在分类问题中,分裂方式不限于gini,也可以选entropy,在回归问题中,用的是mse和mae。

ID3有很多明显不足的地方:比如不能处理连续性变量;不能处理缺失值;选择分裂变量时会倾向于选择类别较多的变量(理解这个问题可以想的极端一点,如ID类的特征,每一类下都只有一个输出项);容易过拟合。

同样,C4.5也有一些问题:C4.5生成的是多叉树,即一个父节点可以有多个节点。很多时候,在计算机中二叉树模型会比多叉树运算效率高,如果采用二叉树,可以提高效率;C4.5只能用于分类,不能用于回归;C4.5由于使用了熵模型,里面有大量耗时的对数运算,如果是连续值还有大量的排序运算,运算效率较低。

cart树可以分类可以回归。

cart树里面引入了一个gini系数的概念,gini的计算相比熵要简单的多,所以可以减少一定的运算量。

cart树第二个特点在于节点的分裂上,每次节点分裂都是二叉的,所以cart树就是多个二叉树组成的,这种特点使得cart算法与C4.5算法在处理离散变量上有很大的不同,离散变量在C4.5中只有一次可能出现在分裂节点上,分裂的枝数与离散变量的类别数量有关。

因为每次都是二分裂,所以cart也没有ID3中倾向于选择类别较多的变量的缺陷。

随机森林优缺点总结 优点

  • 由于采用了集成算法,本身精度比大多数单个算法要好,所以准确性高
  • 在测试集上表现良好,由于两个随机性的引入,使得随机森林不容易陷入过拟合(样本随机,特征随机)
  • 在工业上,由于两个随机性的引入,使得随机森林具有一定的抗噪声能力,对比其他算法具有一定优势
  • 由于树的组合,使得随机森林可以处理非线性数据,本身属于非线性分类(拟合)模型
  • 它能够处理很高维度(feature很多)的数据,并且不用做特征选择,对数据集的适应能力强:既能处理离散型数据,也能处理连续型数据,数据集无需规范化
  • 训练速度快,可以运用在大规模数据集上
  • 可以处理缺省值(单独作为一类),不用额外处理
  • 由于有袋外数据(OOB),可以在模型生成过程中取得真实误差的无偏估计,且不损失训练数据量
  • 在训练过程中,能够检测到feature间的互相影响,且可以得出feature的重要性,具有一定参考意义
  • 由于每棵树可以独立、同时生成,容易做成并行化方法
  • 由于实现简单、精度高、抗过拟合能力强,当面对非线性数据时,适于作为基准模

缺点

  • 当随机森林中的决策树个数很多时,训练时需要的空间和时间会比较大
  • 随机森林中还有许多不好解释的地方,有点算是黑盒模型
  • 在某些噪音比较大的样本集上,RF的模型容易陷入过拟合
当AI换脸遇上内容审核:Facefusion NSFW检测的技术伦理与用户自主权之争 本文探讨了Facefusion开源AI换脸工具中NSFW检测机制的技术伦理困境与用户自主权之争。分析了其多层次防御机制的技术实现与社区规避方法,揭示了开源软件在安全与自由之间的平衡难题,并提出了分层权限设计等社区实践方案。 阅读详情

相关推荐

科研党必备:5分钟搞定MATLAB闪退问题(含R2020a-R2023b各版本适配)

本文针对科研人员常见的MATLAB闪退问题,提供了从R2020a到R2023b各版本的适配解决方案。通过分析六大诱因和版本定制化修复方法,帮助用户快速诊断和解决闪退问题,包括内存优化、高级调试和预防性维护等实用技巧,确保科研计算的连续性和稳定性。

t1u2v的博客 1958

什么是Bootstrap Aggregating

简介 Bootstrap Aggregating也叫作bagging,是一种机器学习领域用来做模型合并的一种算法。这种算法可以提高统计分类器和回归器的稳定性和准确度。同时也可以帮助模型避免过拟合。历史Bootstrap Aggregating最早在1994年由Leo Breiman提出,当时用来通过随机合并训练数据集,从而提高分类器的性能。算法描述Bootstrap Aggregating算法不...

weixin_34049032的博客 1053

Visual SLAM算法笔记

最近在学习SLAM算法,这里作为阅读笔记记录和总结一下。对经典的单目SLAM/VO算法做了摘要和总结,比如Nister VO、MonoSLAM、PTAM、ORB-SLAM、LSD-SLAM、SVO、DSO等,对几个单目和IMU的融合算法也做了简单总结,比如MSCKF、OKVIS、IMU-Preintegration等。

MulinB的技术博客 3万+

【机器学习】集成算法:bagging策略包含详细案例

Bagging是一种基于集成学习的算法,是一种广泛使用的机器学习技术。Bagging的全称是Bootstrap Aggregating,其思想是通过将许多相互独立的学习器的结果进行结合,从而提高整体学习器的泛化能力。本篇博客将介绍Bagging算法的工作原理,优点和缺点,以及如何在Python中实现。

qq_61260911的博客 8894

电流采样电路设计:差分放大与ADC采集详解

在电机控制、电源管理、电池监测等应用中,电流采样是一个关键环节。通常,我们使用小阻值的采样电阻将电流信号转换为电压信号,再通过运放放大后送入ADC进行采集。本文将详细分析一种基于差分放大器的电流采样电路,包括信号放大、参考电压偏置、滤波保护以及ADC转换计算等内容。

W0s477的博客 2万+

汽车氛围灯 PCBA 方案开发:从技术底层解析车载光效的核心逻辑

摘要: 车载氛围灯PCBA方案开发需兼顾性能与车规要求。主控芯片选型应关注运算能力、温度适应性和低功耗(如NXPS32K344、复旦微FM33FG065A)。电路防护需采用TVS二极管等组合设计,满足ISO7637-2浪涌防护标准。通信协议分层应用(CAN+LIN),调光需解决色准与温漂问题,动态灯效通过FIFO队列实现。开发中需进行温度循环、振动、EMC等可靠性测试,细节处理(如三防涂覆)至关重要。该领域开发需熟悉车规标准并积累实车经验。

2401_87454052的博客 1132

机器学习 - 随机森林 Random Forest

先修知识: 决策树。可以看我之前写的文章https://blog.youkuaiyun.com/weixin_41332009/article/details/112276531 集成学习。也可以看之前写的文章https://blog.youkuaiyun.com/weixin_41332009/article/details/112524432 1.什么是随机森林? 学习了决策树之后,那么会很容易理解什么是随机森林。随机森林就是通过集成学习的思想将多棵树集成的一种算法:它的基本单元就是决策树。随机森林的名称中有两个关.

weixin_41332009的博客 7881

从Reset到Read:深入解析Rolling Shutter曝光流水线

本文深入解析Rolling Shutter(卷帘曝光)的工作原理,重点探讨Reset和Read信号在图像传感器中的关键作用。通过Reset-Read流水线机制,详细解释了曝光控制、时序调优及运动伪影补偿等核心技术,帮助读者理解卷帘曝光在高速摄影和动态场景中的应用。

weixin_42531925的博客 253

Bagging(Bootstrap Aggregating)和averaging可行性分析

此处bagging具体过程不做详细介绍,我们只谈一下bagging为什么可以工作以及它的作用。 Bagging为什么可以工作 我们从回归问题的泛化误差的角度来分析(这里先不分偏差和方差)。设数据集L包含数据,其数据均采样与联合分布为P的随机变量。如此,我们的集成模型可以表示为: ...

xiaomeng29的博客 448

【学习系列】SAP RAP 7:行为定义-Draft

本文介绍了RAP框架中的草稿表(Draft)功能及其应用。草稿表允许用户临时保存数据,在激活前不影响业务逻辑,支持保存继续、暂存和设备切换功能。草稿分为独占草稿(仅限同一用户编辑)和协作草稿(允许多用户协同编辑)。启用草稿需在行为定义和投影中包含标准action,并创建包含TotalETag等管理字段的草稿表。TotalETag确保草稿转换时活动数据未被修改,而ETagmaster则防止并发修改。文章通过OData调用示例详细说明了ETag验证过程,强调草稿功能由RAP框架自动处理,开发者只需关注定义和配置

DeveloperMrMeng的博客 441

鸿蒙开发实战项目(九十二):HUAWEI Health血压测量

是华为开发的用于运动健康领域的一个开放平台, 三方APP可以借助HUAWEI Health开放平台提供的。

斌擎科技 1132

bootstrap aggregating(bagging)

bootstrap是统计学习中的一种采样技术,是用原样本自身的数据抽样形成新的样本。 它是一种有放回的抽样方法,它是非参数统计中一种重要的估计统计量方差进而进行区间估计的统计方法。其核心思想和基本步骤如下: (1) 采用重抽样技术从原始样本中抽取一定数量(自己给定)的样本,此过程允许重复抽样。 (2) 根据抽出的样本计算给定的统计量T。 (3) 重复上述N次(一般大于1000),得到N个统计量T。...

weixin_43396435的博客 575

infercnv的实操

摘要: 博主在infercnv分析中遇到执行困难,外包服务不可靠(未按要求使用HMM方法)。通过优化策略(逐样本处理、精简细胞至1000个、固定随机种子)解决了运行问题,但HMM功能仍无法实现。最终参考Cell期刊标准设置阈值完成分析,后续将继续更新进展。该案例凸显了生物信息分析中自主优化的重要性。(150字)

xiaoyusang的博客 308

Bagging (bootstrap aggregating) - 集成方法之一

Bagging(装袋法),bootstrap aggregating(自举汇聚法) 的简称,是一个通过组合多个模型来减少泛化误差的技术。其原理是单独训练数个不同的模型,然后让多个模型在测试集的输出上投票。这是一个在机器学习中普遍应用的被称作model averaging(模型平均) 的策略。使用这种策略的技术被称作ensemble methods(集成方法)。 下面以一张图展示该方法的大致过程...

Steve Wang's blog 3538

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

Bagging(Bootstrap aggregating)、随机森林(random forests)、AdaBoost

在这篇文章中,我会详细地介绍Bagging、随机森林和AdaBoost算法的实现,并比较它们之间的优缺点,并用scikit-learn分别实现了这3种算法来拟合Wine数据集。全篇文章伴随着实例,由浅入深,看过这篇文章以后,相信大家一定对ensemble的这些方法有了很清晰地了解。

踩风火轮的乌龟 2万+

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Bagging(Bootstrap Aggregating)详解-ChatGPT4o作答

Bagging 是一种通过并行训练多个基模型来提高预测性能的集成学习方法。它在高方差模型上表现优异,并且通过引入随机性和模型融合有效提升了模型的泛化能力。Bagging 的代表算法有随机森林,它广泛应用于分类和回归任务中。

qq_46215223的博客 1392

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Bagging(Bootstrap Aggregating)算法详解

分类回归Bagging 是一种通过Bootstrap 采样 + 模型集成的方法,能够有效降低方差,提高泛化能力。它适用于高方差模型(如决策树),但对高偏差模型提升有限。随机森林就是 Bagging 的典型代表,应用广泛。

2501_91641025的博客 750

Bootstrap aggregating----Bagging

一、简介 Bootstrap aggregating 又称为Bagging  是一种用来增强学习算法准确度的算法,由 Leo Breiman 在1994年提出,能够用来提高不稳定算法的准确度和稳定性,通常用于统计分类和回归中,它能够减小方差并避免过拟合。基本思想是利用Bootstrap算法从训练集中有放回的抽样,得到M个训练集,利用机器学习算法获得在每个新的训练集上的结果,对于分类,对M个结

hqh45的专栏 1988

机器学习笔记:Bagging(套袋法,bootstrap aggregating)

格式驾驭不了,图片大小不会改,可以直接看我的有道笔记:http://note.youdao.com/noteshare?id=2d13d050bd683d9f3dee525a85ded041   Bagging 和Boosting的区别: 样本选择上: Bagging:训练集是有放回选取的,各轮训练集之间独立 Boosting:每一轮的训练集不变,只是训练集中每个样例在分类器中的权...

十里倾城 4753

Bagging(bootstrap aggregating)

在误差完全相关即 c = v 的情况下,均方误差减少到 v,所以模型平均没有任何帮助。在错误完全不相关即 c = 0 的情况下,该集成平方误差的期望仅为 1/k * v。这意味着集成平方误差的期望会随着集成规模增大而线性减小。换言之,平均上,集成至少与它的任何成员表现得一样好,并且如果成员的误差是独立的,集成将显著地比其成员表现得更好。Bagging是一种允许重复多次使用同一种模型、训练算法和目标...

weixin_40759186的博客 652

机器学习笔记(8)——集成学习之Bootstrap aggregating(Bagging)装袋算法

Bootstrap aggregating自举汇聚法 Bagging装袋法 1.概念 是一种在原始数据集上通过有放回抽样重新选出S个新数据集来训练分类器的集成技术。也就是说这些新数据集是允许重复的。 使用训练出来的分类器集合来对新样本进行分类,然后用多数投票或者对输出求均值的方法统计所有分类器的分类结果,结果最高的类别即为最终标签。为了提高模型的方差(variance, 差

icepoint的博客 1万+

【漫话机器学习系列】010.Bagging算法(Bootstrap Aggregating)

Bagging(Bootstrap Aggregating 的缩写)是一种集成学习方法,通过构建多个弱学习器(例如决策树)并将它们的结果进行平均(回归)或投票(分类),来提高模型的稳定性和准确性,减少过拟合。Bagging 是集成学习的重要组成部分,其简单高效的特点使其在多种任务中表现出色。

IT古董 1865

学习记录——集成学习 Bagging(Bootstrap Aggregating)

从原始训练集中随机抽取多个不同的训练子集(可能包含重复样本),然后针对每个子集分别训练一个基学习器。最终的预测结果是所有基学习器预测结果的平均值(回归问题)或投票表决(分类问题)。它通过构建多个基学习器(通常是相同类型的模型),并结合它们的预测结果来减少方差和提高准确性。提高稳定性:由于每个基学习器都是在不同的训练子集上训练的,因此模型更稳定。可能会影响模型的解释性:由于集成了多个模型,最终预测结果可能较难解释。降低过拟合风险:通过组合多个模型的预测结果,减少了单个模型的方差,提高了泛化能力。

m0_58979029的博客 792

C语言经典算法之Bagging(Bootstrap Aggregating)算法(伪代码)

Bagging(Bootstrap Aggregating)算法是一种集成学习方法,它通过训练多个基模型并汇总其预测结果来提高机器学习模型的稳定性和准确率。在C语言中实现一个完整的Bagging算法会涉及数据抽样、模型训练、预测以及结果整合等多个步骤。

weixin_56154577的博客 1675
上一篇: 集成学习综述
下一篇: 随机森林API的理解(sklearn.ensemble.RandomForest)
NongfuSpring-wu
博客等级 码龄9年 19粉丝 77原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
