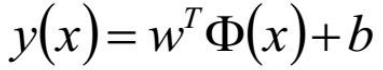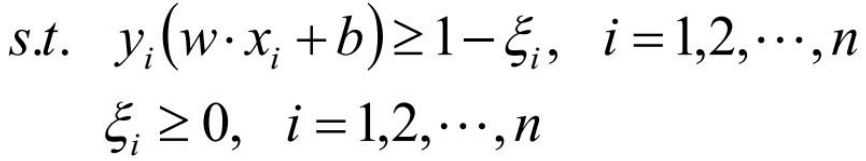支持向量机(SVM)

详解支持向量机SVM 详解支持向量机SVM详解支持向量机 SVM支持向量机预备知识 深入理解超平面间隔最大化 间隔最大化最优值求解方法 拉格朗日乘数法 拉格朗日乘数法与KKT条件 拉格朗日对偶性间隔最大化最优值求解 阅读详情

线性分类器

一、线性分类器:
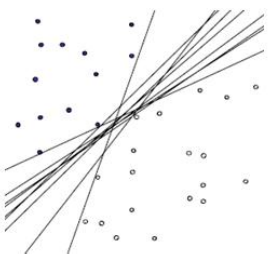
首先给出一个非常非常简单的分类问题(线性可分),我们要用一条直线,将下图中黑色的点和白色的点分开,很显然,图上的这条直线就是我们要求的直线之一(可以有无数条这样的直线)
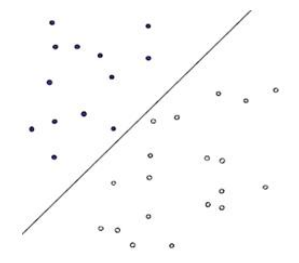
假如说,我们令黑色的点 = -1, 白色的点 = +1,直线f(x) = w.x + b当向量x的维度=2的时候,f(x) 表示二维空间中的一条直线, 当x的维度=3的时候,f(x) 表示3维空间中的一个平面,当x的维度=n > 3的时候,表示n维空间中的超平面

一个很直观的感受是,让这条直线到给定样本中最近的点最远分的最好,这句话读起来比较拗口,下面给出几个图,来说明一下:
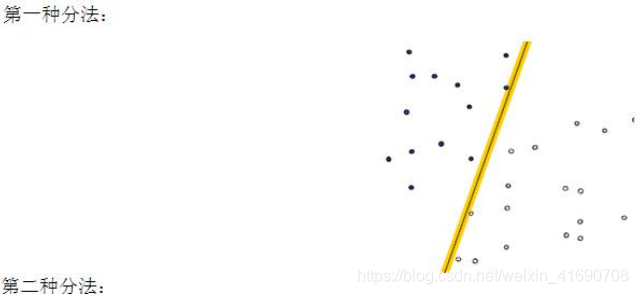
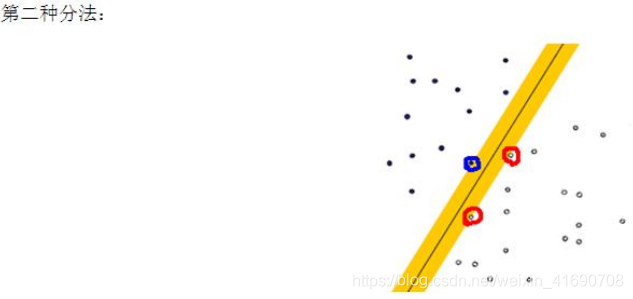
这两种分法哪个更好呢?很明显第二种分的更加明显。

就像我们平时判断一个人是男还是女,就是很难出现分错的情况,这就是男、女两个类别之间的间隙非常的大导致的,让我们可以更准确的进行分类。在SVM中,称为Maximum Marginal,是SVM的一个理论基础之一。选择使得间隙最大的函数作为分割平面是有很多道理的,比如说从概率的角度上来说,就是使得置信度最小的点置信度最大(听起来很拗口),也就是说最近的点分的最开,从实践的角度来说,这样的效果非常好。上图被红色和蓝色的线圈出来的点就是所谓的支持向量(support vector)。

线性可分支持向量机

针对线性可区分,求超平面推导
超平面的公式可以定义为 : W * X + b = 0 W表示权重向量 W={w1,w2,w3,w4.....,wn},n为特征值的个数 , X为训练实例, b表示偏移量
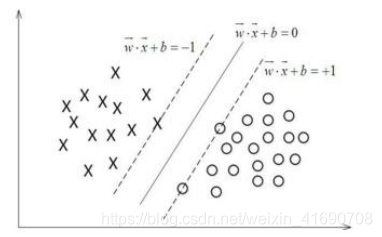
数学建模

求解这个"决策面"的过程,就是最优化。一个最优化问题通常有两个基本的因素:1)目标函数,也就是你希望什么东西的什么指标达到最好;2)优化对象,你期望通过改变哪些因素来使你的目标函数达到最优。在线性SVM算法中,目标函数显然就是那个"分类间隔",而优化对象则是决策面。所以要对SVM问题进行数学建模,首先要对上述两个对象("分类间隔"和"决策面")进行数学描述。按照一般的思维习惯,我们先描述决策面。

数学建模的时候,先在二维空间建模,然后再推广到多维。

根据距离公式

现在,将直线方程扩展到多维,求得我们现在的超平面方程,对公式进行如下变形:

机器学习实战教程(八):支持向量机原理篇之手撕线性SVM

这个d就是"分类间隔"。其中||w||表示w的二范数,求所有元素的平方和,然后再开方。比如对于二维平面:

机器学习实战教程(八):支持向量机原理篇之手撕线性SVM

那么,

机器学习实战教程(八):支持向量机原理篇之手撕线性SVM

目标函数

把w1和w2看成一个向量,x1,x2也是一个向量则有

限制条件:|w*x+b|能够相对的表示点x到距离超平面的远近,而w*x+b的符号与类标记y的符号是否一致表示分类是否正确,所以,可以用量y*(w*x+b)的正负性来判定或表示分类的正确性和确信度。
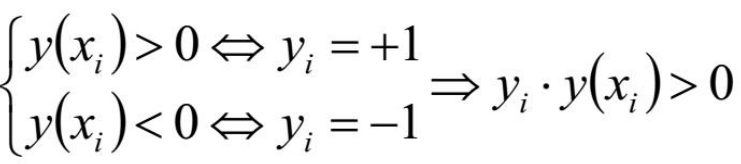
最大间隔分离超平面:

w,b等比例缩放,等价于点到超平面的距离缩放,从而
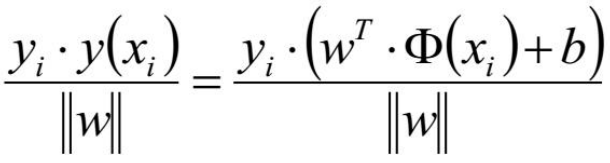

前面已经提到过,让这条直线到给定样本中最近的点最远,即目标函数是
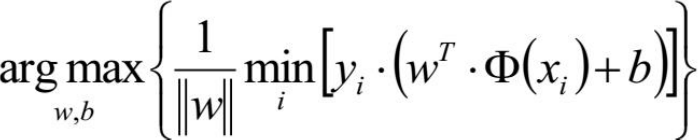
最近的点最远

因为这里的约束条件是支持向量点到超平面的距离为1,即

到这里,我们前面的问题转化为了求
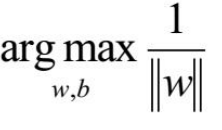
||w||的意思是w的二范数,跟 表达式是一个意思,之前得到,求SVM的关键就是,最大化这个式子等价于最小化||w||, 另外由于||w||是一个单调函数,为了在进行最优化的过程中对目标函数求导时比较方便,我们可以对其加入平方,和前面的系数。
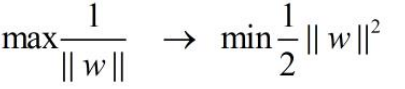
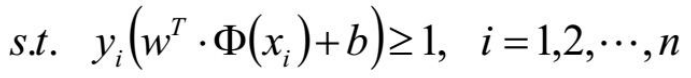
转化为对偶问题,并优化求解:
这个优化问题可以用拉格朗日乘子法去解,使用了KKT条件的理论,这里直接作出这个式子的拉格朗日目标函数:
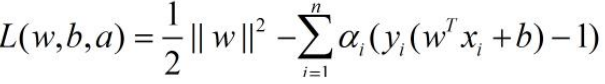

求解这个式子的过程需要拉格朗日对偶性的相关知识

原问题是极小极大问题
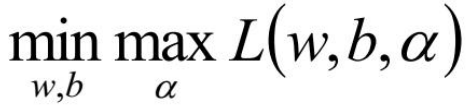

问题的对偶问题,是极大极小问题
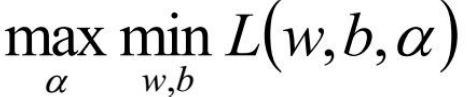
通过拉格朗日函数

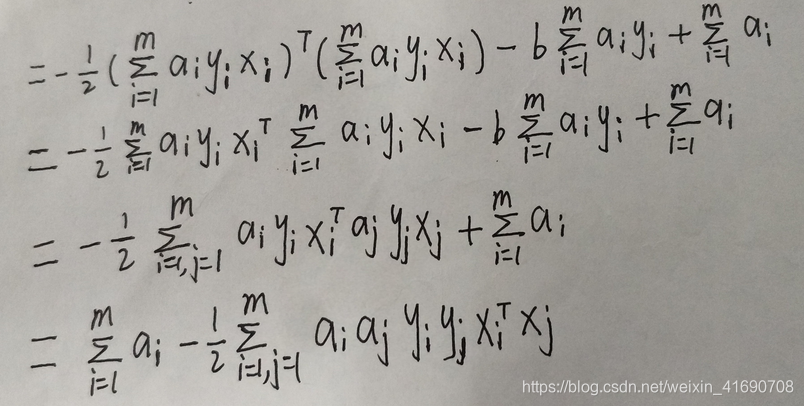
首先让L关于w,b最小化,分别令L关于w,b的偏导数为0,得到关于原问题的一个表达式
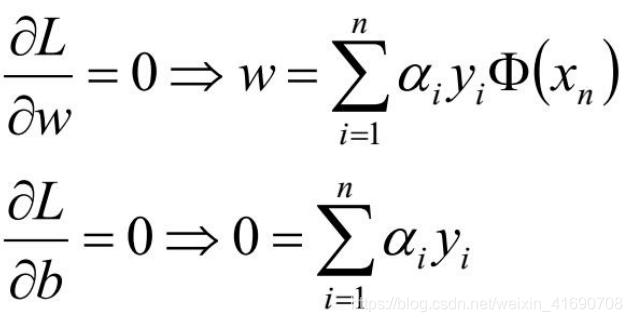
推导过程如下:
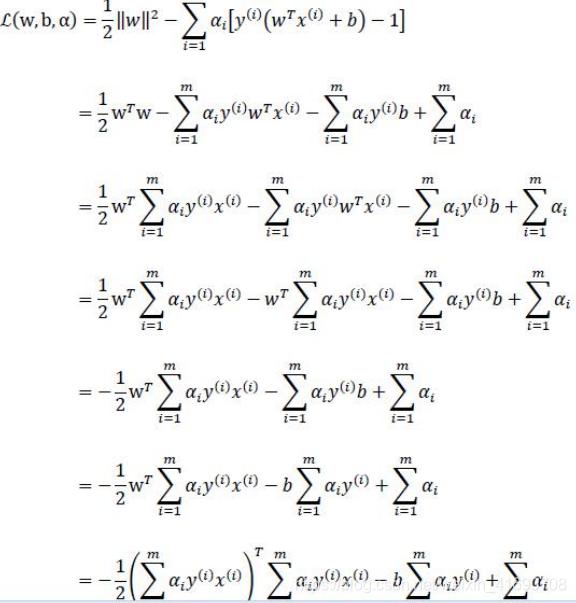
结果加个负号得到
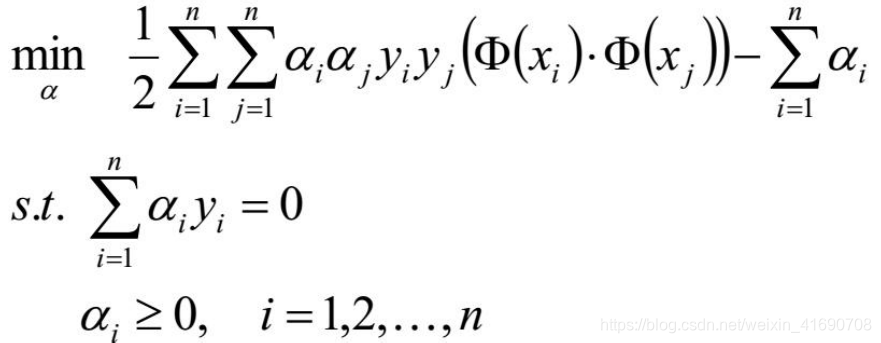
 

线性不可分

线性可区分(linear separable)和线性不可区分(linear inseparable)
上面是线性可区分的,很容易找到一个超平面将数据分割成两类,但如果不能直接划分出来呢?


线性支持向量机
若是存在离群点呢?如果使用实线来划分,拟合的精度会高一些,但是模型的泛化能力会很差,即测试的时候出现误差过大,即过拟合,这时候我们就需要适当的允许一些离群的点可以超出边界,就是图中的虚线。
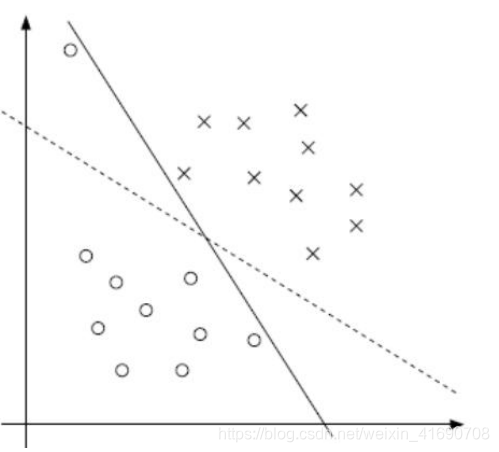
我们知道所有数都不那么干净,不能100%线性可分。我们可以通过引入松弛变量,来允许有些数据点可以处于分割面的错误的一侧
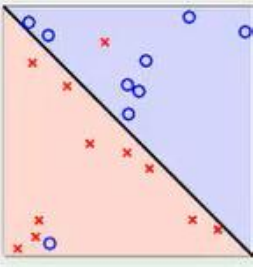
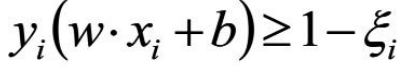
                     

需要加一个松弛因子 ξi≥0

目标函数:
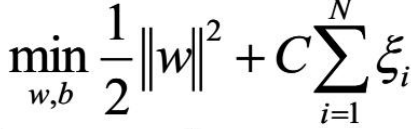
拉格朗日函数:
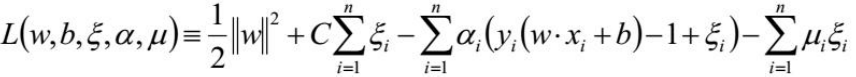
C代表惩罚系数,即如果某个x是属于某一类,但是它偏离了该类,跑到边界上后者其他类的地方去了,C越大表明越不想放弃这个点,边界就会缩小(sklearn里面默认是1)

接下来就是同样的,求解一个拉格朗日对偶问题,得到一个原问题的对偶问题的表达式:

对 求偏导:
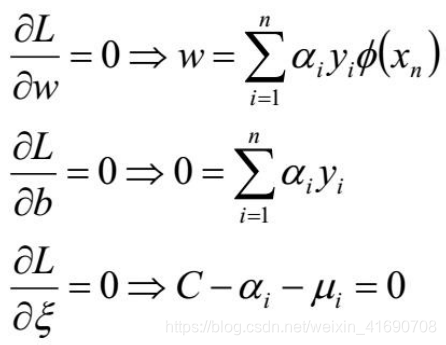
带入得:
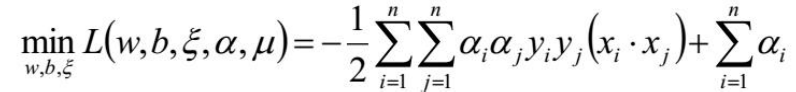

求极大得:

整理得:
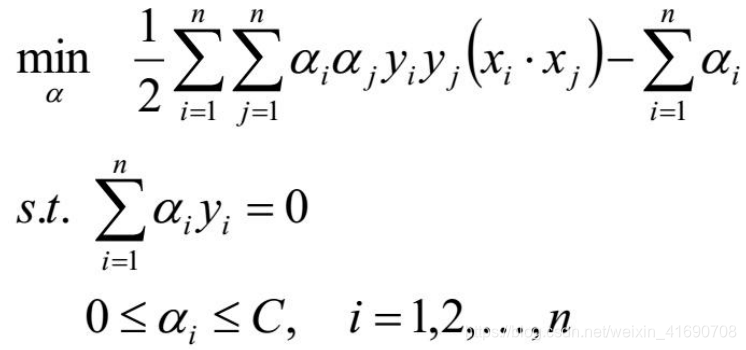
\alpha _{i} 的取值范围是与线性可分的对偶问题表达式的不同之处。在线性不可分情况下得到的对偶问题,不同的地方就是α的范围从[0, +∞),变为了[0, C],增加的惩罚ε没有为对偶问题增加什么复杂度。


求对的极大,即是关于对偶变量dual variable的优化问题,从上面的式子得到:

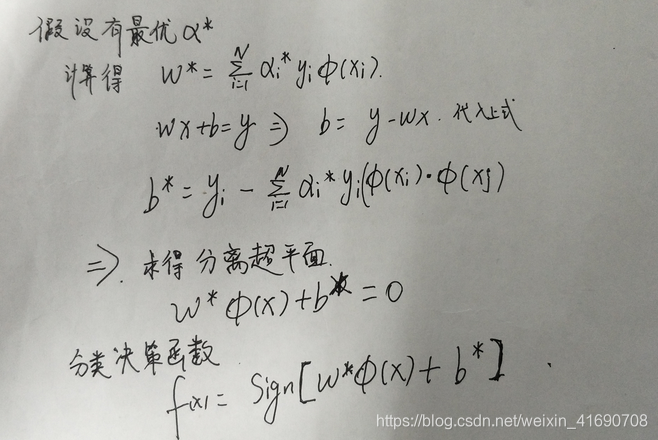
(不得不提醒下读者:经过上面第一个步骤的求w和b,得到的拉格朗日函数式子已经没有了变量w,b,只有,而反过来,求得的将能导出w,b的解,最终得出分离超平面和分类决策函数。为何呢?因为如果求出了,根据,即可求出w。然后通过,即可求出b )怎么求对偶变量的值可能依然心存疑惑。实际上,关于的求解过程即是我们常说的SMO算法,这里省略。

核函数Kernel

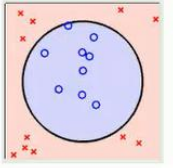
事实上,大部分时候数据并不是线性可分的,这个时候满足这样条件的超平面就根本不存在。在上文中,我们已经了解到了SVM处理线性可分的情况,那对于非线性的数据SVM如何处理呢?对于非线性的情况,SVM 的处理方法是选择一个核函数 κ,通过将数据映射到高维空间,来解决在原始空间中线性不可分的问题。具体来说,在线性不可分的情况下,支持向量机首先在低维空间中完成计算,然后通过核函数将输入空间映射到高维特征空间,最终在高维特征空间中构造出最优分离超平面,从而把平面上本身不好分的非线性数据分开。
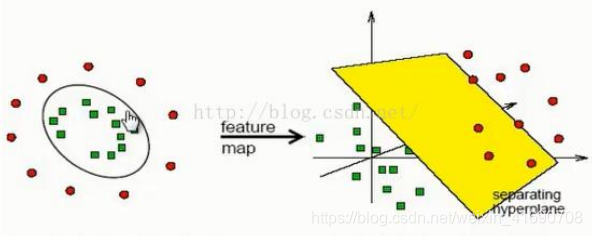
核函数

定理:任意两个样本点在扩维后的空间的内积,如果等于这两个样本点在原来空间经过一个函数后的输出,那么这个函数就叫核函数。

公式:

常用的几个核函数:

线性核:

优点:

  • 方案首选,奥卡姆剃刀定律
  • 简单,可以求解较快一个QP问题
  • 可解释性强:可以轻易知道哪些feature是重要的

限制:只能解决线性可分问题

多项式核:

基本原理:依靠升维使得原本线性不可分的数据线性可分;
升维的意义:使得原本线性不可分的数据线性可分;

优点:

  • 可解决非线性问题
  • 可通过主观设置幂数来实现总结的预判

缺点:

  • 对于大数量级的幂数,不太适用
  • 比较多的参数要选择

通常只用在已经大概知道一个比较小的幂数的情况

例如:

高斯核函数 RBF:

优点:

  • 可以映射到无限维
  • 决策边界更为多样
  • 只有一个参数,相比多项式核容易选择

缺点:

  • 可解释性差(无限多维的转换,无法算w)
  • 计算速度比较慢(解一个对偶问题)
  • 容易过拟合(参数选不好时容易overfitting)
  • 采用Sigmoid函数作为核函数时,支持向量机实现的就是一种多层感知器神经网络,应用SVM方法,隐含层节点数目(它确定神经网络的结构)、隐含层节点对输入节点的权值都是在设计(训练)的过程中自动确定的。而且支持向量机的理论基础决定了它最终求得的是全局最优值而不是局部最小值,也保证了它对于未知样本的良好泛化能力而不会出现过学习现象。
  • 在实战中更多的是:

  • 特征维数高选择线性核
  • 样本数量可观、特征少选择高斯核(非线性核)
  • 样本数量非常多选择线性核(避免造成庞大的计算量)

SVM学习问题可以表示为凸优化问题,因此可以利用已知的有效算法发现目标函数的全局最小值

核函数与之前计算的区别:
1、一个是映射到高维空间中,然后再根据内积的公式进行计算;
2、而另一个则直接在原来的低维空间中进行计算,而不需要显式地写出映射
后的结果。
我们把这里的计算两个向量在隐式映射过后的空间中的内积的函数叫做核函数(Kernel Function) 

核函数的本质:
实际中,我们会经常遇到线性不可分的样例,此时,我们的常用做法是把样例特征映射到高维空间中去(如上文的那幅图所示,映射到高维空间后,相关特征便被分开了,也就达到了分类的目的)。但进一步,如果凡是遇到线性不可分的样例,一律映射到高维空间,那么这个维度大小是会很高。此时,就需要核函数,核函数的价值在于它虽然也是将特征进行从低维到高维的转换,但核函数它事先在低维上进行计算,而将实质上的分类效果表现在了高维上,也就如上文所说的避免了直接在高维空间中的复杂计算。

SVM有如下主要几个特点:


(1)  非线性映射是SVM方法的理论基础,SVM利用内积核函数代替向高维空间的非线性映射;

(2)  对特征空间划分的最优超平面是SVM的目标,最大化分类边际的思想是SVM方法的核心;

(3)  支持向量是SVM的训练结果,在SVM分类决策中起决定作用的是支持向量。

(4)  SVM 是一种有坚实理论基础的新颖的小样本学习方法。它基本上不涉及概率测度及大数定律等,因此不同于现有的统计方法。从本质上看,它避开了从归纳到演绎的传统过程,实现了高效的从训练样本到预报样本的“转导推理”,大大简化了通常的分类和回归等问题。

(5)  SVM 的最终决策函数只由少数的支持向量所确定,计算的复杂性取决于支持向量的数目,而不是样本空间的维数,这在某种意义上避免了“维数灾难”。

(6)  少数支持向量决定了最终结果,这不但可以帮助我们抓住关键样本、“剔除”大量冗余样本,而且注定了该方法不但算法简单,而且具有较好的“鲁棒”性。这种“鲁棒”性主要体现在: 

        ①增、删非支持向量样本对模型没有影响;

        ②支持向量样本集具有一定的鲁棒性;

        ③有些成功的应用中,SVM 方法对核的选取不敏感

(7)  SVM学习问题可以表示为凸优化问题,因此可以利用已知的有效算法发现目标函数的全局最小值。而其他分类方法(如基于规则的分类器和人工神经网络)都采用一种基于贪心学习的策略来搜索假设空间,这种方法一般只能获得局部最优解。

(8)  SVM通过最大化决策边界的边缘来控制模型的能力。尽管如此,用户必须提供其他参数,如使用核函数类型和引入松弛变量等。

(9)  SVM在小样本训练集上能够得到比其它算法好很多的结果。支持向量机之所以成为目前最常用,效果最好的分类器之一,在于其优秀的泛化能力,这是是因为其本身的优化目标是结构化风险最小,而不是经验风险最小,因此,通过margin的概念,得到对数据分布的结构化描述,因此减低了对数据规模和数据分布的要求。SVM也并不是在任何场景都比其他算法好,对于每种应用,最好尝试多种算法,然后评估结果。如SVM在邮件分类上,还不如逻辑回归、KNN、bayes的效果好。

(10)  它基于结构风险最小化原则,这样就避免了过学习问题,泛化能力强。

(11)  它是一个凸优化问题,因此局部最优解一定是全局最优解的优点。

(12)  泛华错误率低,分类速度快,结果易解释


不足之处:


(1) SVM算法对大规模训练样本难以实施

        SVM的空间消耗主要是存储训练样本和核矩阵,由于SVM是借助二次规划来求解支持向量,而求解二次规划将涉及m阶矩阵的计算(m为样本的个数),当m数目很大时该矩阵的存储和计算将耗费大量的机器内存和运算时间。针对以上问题的主要改进有有J.Platt的SMO算法、T.Joachims的SVM、C.J.C.Burges等的PCGC、张学工的CSVM以及O.L.Mangasarian等的SOR算法。

        如果数据量很大,SVM的训练时间就会比较长,如垃圾邮件的分类检测,没有使用SVM分类器,而是使用了简单的naive bayes分类器,或者是使用逻辑回归模型分类。


(2) 用SVM解决多分类问题存在困难

        经典的支持向量机算法只给出了二类分类的算法,而在数据挖掘的实际应用中,一般要解决多类的分类问题。可以通过多个二类支持向量机的组合来解决。主要有一对多组合模式、一对一组合模式和SVM决策树;再就是通过构造多个分类器的组合来解决。主要原理是克服SVM固有的缺点,结合其他算法的优势,解决多类问题的分类精度。如:与粗集理论结合,形成一种优势互补的多类问题的组合分类器。


(3)对缺失数据敏感,对参数和核函数的选择敏感

        支持向量机性能的优劣主要取决于核函数的选取,所以对于一个实际问题而言,如何根据实际的数据模型选择合适的核函数从而构造SVM算法.目前比较成熟的核函数及其参数的选择都是人为的,根据经验来选取的,带有一定的随意性.在不同的问题领域,核函数应当具有不同的形式和参数,所以在选取时候应该将领域知识引入进来,但是目前还没有好的方法来解决核函数的选取问题.

支持向量机的主要应用和研究的热点

        目前支持向量机主要应用在模式识别领域中的文本识别,中文分类,人脸识别等;同时也应用到许多的工程技术和信息过滤等方面.

        当前研究的热点主要是对支持向量机中算法的优化,包括解决SVM中二次规划求解问题,对大规模SVM的求解问题,对SVM中QP问题的求解问题等.另外就是如何更好的构造基于SVM的多类分类器,如何提高SVM的归纳能力和分类速度等.如何根据实际问题确定核函数也是一个重要的研究热点.

 

文章部分来源于:https://www.cnblogs.com/hanxiaosheng/p/9908763.html

使用支持向量机SVM进行分类 欢迎关注”生信修炼手册”!SVM, 全称为support vector machines, 翻译过来就是支持向量机。该算法最常见的应用场景就是解决二分类问题,当然也可以用于回归和异常值检... 阅读详情

相关推荐

支持向量机 Support Vector Machine (SVM)初步理解

文章目的:对支持向量机的内容有一个初步的了解。为了弄懂其中的内容查阅了很多资料,所以里面应该会有引用其他帖子的部分内容,如果原作者看到可以私信我,我会将您的帖子的地址付到下面。 简介 支持向量机(support vector machines)是一种二分类模型,它的目的是寻找一个超平面来对样本进行分割,分割的原则是间隔最大化,最终转化为一个凸二次规划问题来求解。 SVM可分为三种模型:线性可...

count_on_me的博客 1754

机器学习:支持向量机(SVM)

支持向量机(SVM)是一类按监督学习方式对数据进行二元分类的广义线性分类器,其决策边界是对学习样本求解的最大边距超平面,可以将问题化为一个求解凸二次规划的问题。与逻辑回归和神经网络相比,支持向量机,在学习复杂的非线性方程时提供了一种更为清晰,更加强大的方式。

燕双嘤 20万+

支持向量机(Support Vector Machine,SVM)

支持向量机是一种基于统计学习理论的模式识别方法。SVM的目的是为了找到一个超平面,使得它能够尽可能多的将两类数据点正确的分开,同时使分开的两类数据点距离分类面最远

m0_67531118的博客 2270

支持向量机(SVM算法)

概念;支持向量机,英文全称“Support Vector Machines”(简称 SVM),它是机器学习中最常用的一种“分类算法”。SVM 是一种非常优雅的算法,有着非常完善的数学理论基础,其预测效果,在众多机器学习模型中可谓“出类拔萃”。在深度学习没有普及之前,“支持向量机”可以称的上是传统机器学习中的“霸主”,下面我们将介绍本节的主人公——支持向量机(SVM)。支持向量机是有监督学习中最有影响力的机器学习算法之一,该算法的诞生可追溯至上世纪 60 年代, 前苏联学者 Vapnik 在解决模式识别问题时

m0_62064241的博客 8946

SVM支持向量机算法

参考资料:http://www.cppblog.com/sunrise/archive/2012/08/06/186474.html                       http://blog.youkuaiyun.com/sunanger_wang/article/details/7887218 我的数据挖掘算法代码:https://github.com/linyiqun/DataMining

走在前往架构师的路上 1万+

支持向量机(Support Vector Machine, SVM)

tags: 机器学习本文目录:(注:为推导方便,若无特别说明以下讨论均在输出为±1±1±1的二分类任务上进行。)线性支持向量机(Linear SVM)也叫硬间隔支持向量机(Hard-margin SVM)。假设数据集{(x(1),y(1)),...,(x(N),y(N))}\{(x^{(1)},y^{(1)}),...,(x^{(N)},y^{(N)})\}{(x(1),y(1)),...,(x(N),y(N))}是线性可分的,其中x∈Rdx \in \Bbb{R}^dx∈Rd,y∈{−1,+1}y \in

AI天才研究院 1万+

【机器学习原理】SVM支持向量机分类算法

文章目录一、支持向量机:线性分类器的“王者”1. 距离2. 支持向量3. 从更高维度看“线性不可分”二、支持向量机分类的算法原理1. 基本思路(1) 最大间隔(2) 高维映射(3) 核函数(4) 支持向量机的真正运行机制(5) 核技巧2. 数学解析(1) 点到超平面的距离(2) 间隔最大化(3) 核函数3. 具体步骤三、在Python中使用支持向量机分类算法四、支持向量机分类算法的使用场景 一、支持向量机:线性分类器的“王者” 最大间隔 高维映射 核方法 1. 距离 我们已经从用线性回归套S型马甲(lo

ZhShy 1万+

MATLAB支持向量机SVM代码实现

本栏目(Machine learning)包括单参数的线性回归、多参数的线性回归、Octave Tutorial、Logistic Regression、Regularization、神经网络、机器学习系统设计、SVM(Support Vector Machines 支持向量机)、聚类、降维、异常检测、大规模机器学习等章节。所有内容均来自Standford公开课machine learning

wenyusuran的专栏 4万+

支持向量机(SVM)算法

1. 背景: 最早是由 Vladimir N. Vapnik 和 Alexey Ya. Chervonenkis 在1963年提出 目前的版本(soft margin)是由Corinna Cortes 和 Vapnik在1993年提出,并在1995年发表 深度学习(2012)出现之前,SVM被认为机器学习中近十几年来最成功,表现最好的算法 2 . 机器...

foochane 361

第4章支持向量机12

第4章 支持向量机已知正例点x1 = (1,2)T,x2 = (2,3)T,x3 = (3,3)T,负例点x4 = (2,1)T,x5 = (3,2)T,试求最

COLMAP性能优化实战:如何用GPU加速和并行计算让重建速度提升300%

本文详细介绍了如何通过GPU加速、并行计算和参数调优显著提升COLMAP的三维重建效率。从硬件资源分配到计算流程优化,再到大型数据集的分块处理策略,全面解析了将重建速度提升300%以上的实用技巧,特别适合处理无人机航拍和室内扫描等大规模三维重建项目。

weixin_29098391的博客 202

支持向量机(support vector machine, SVM)的分类(matlab实现)

需要说明的是,若测试集样本对应的类别标签test_label未知,为了符合函数svmpredict调用格式的要求,随机填写即可,在这种情况下,accuracy便没有具体的意义了,只需关注预测的类别标签predict_label即可。从表中可以清晰地看到,线性核函数和Sigmoid核函数对应的正确率较低,而RBF核函数和多项式核函数对应的训练集预测正确率相当,但从模型的泛化能力考虑,即同时衡量测试集的预测正确率,则RBF核函数对应的模型性能最佳。因此,如前文所述,一般采用默认设置的RBF核函数进行建模。

配电网和matlab的博客 1万+

海康Camera MVS Linux SDK二次开发封装ROS packge过程记录(c++)

https://www.hikrobotics.com/machinevision/service/download?module=0

weixin_41965898的博客 2万+

SVM支持向量机详解

支持向量机(support vector machines, SVM)是二分类算法,所谓二分类即把具有多个特性(属性)的数据分为两类,目前主流机器学习算法中,神经网络等其他机器学习模型已经能很好完成二分类、多分类,学习和研究SVM,理解SVM背后丰富算法知识,对以后研究其他算法大有裨益;在实现SVM过程中,会综合利用之前介绍的一维搜索、KKT条件、惩罚函数等相关知识。本篇首先通过详解SVM原理,后介绍如何利用python从零实现SVM算法。 为便于理解,假设样本有两个属性,可以把属性值分别对应到二...

m2xgo的博客 2万+

Quartus安装Altera USB-Blaster安装驱动程序出现问题(代码39)的解决办法

Quartus安装Altera USB-Blaster安装驱动程序出现问题(代码39)的解决办法

MCU_HOT的博客 1万+

PaddleOCR实战:给图片‘加个框’,轻松搞定小图和长图文字识别不准的难题

本文探讨了PaddleOCR在处理小图和长图时识别精度下降的问题,并提出通过图像边框预处理技术显著提升OCR识别效果。详细介绍了使用OpenCV实现智能边框添加的方法,包括核心原理、工程实践中的关键细节以及性能优化策略,帮助开发者轻松解决非常规尺寸图像的文本检测难题。

weixin_29313547的博客 186

【机器学习算法】支持向量机(support Vector Machine,SVM)

支持向量机SVM概述,核函数特征转换处理非线性问题,多分类SVM问题

qq1021091799qq的博客 3176

使用mindie:2.0.RC2-800I-A2-py311-openeuler24.03-lts制作一个通用的模型推理性能测试的镜像

本文详细介绍了在NPU环境下进行模型推理性能测试的完整流程。首先配置了测试所需的环境和设备信息,包括Python 3.10.9和3.11.6版本、测试脚本和镜像文件。然后分步骤说明了镜像制作过程:创建特权容器、安装Python 3.10.9、配置VLLM环境,并详细描述了测试容器的启动方法。最后提供了镜像打包和使用指南,包括如何加载镜像、启动容器、运行测试脚本(以DeepSeek-32B模型为例)以及更换测试模型的步骤。整个过程涉及环境变量配置、权限设置和服务启动等关键操作。

m0_50105717的博客 1015

支持向量机(Support Vector Machine,SVM)

支持向量机(Support Vector Machine,简称SVM)是一种监督学习模型,主要用于分类和回归分析。SVM的基本思想是,使得两类样本之间的间隔最大化。这个间隔被定义为支持,而支持向量就是那些恰好。

... 1212

MDF和DHF、DMR、DHR三者差异?注册与备案文件?医疗器械产品技术要求编写指导原则

定义:设计历史文档(DHF ) 指的是描述某医疗器械成品设计过程的有关记录。内容:DHF包括设计开发活动的所有记录。从最初的策划、客户需求、设计输入,设计输出、设计验证、设计确认、所有的设计评审,设计转换,以及设计变更相关的所有记录。均属于DHF的一部分。要求:各制造商应为每个类型的器械建立并保持设计历史文件。设计历史文件应包含或引用必要的记录,以证实设计符合经批准的设计计划和法规的要求。

学海无涯的专栏 9109

Open Dynamics Engine(ODE)物理引擎基础教程(I)——特点介绍

下一教程 Open Dynamics Engine(ODE)物理引擎基础教程(II)——相关概念 (在这一教程中将学习刚体、关节、碰撞的概念在ODE中的特点) 本文结构引言介绍特点使用ODE总结 引言 本文翻译自ODE官方教程英文版,有些地方增加了自己的理解。这一节介绍ODE的相关概念。 基础教程英文原版链接【http://ode.org/wiki/index.php?title=Manua...

腿足机器人领域 1676

支持向量机SVM及python实现

支持向量机 SVM是一种二分类模型。它的基本模型是定义在特征空间上的间隔最大的线性分类器,间隔最大使它有别于感知机;核技巧使他成为实质上的非线性分类器。SVM是求解凸二次规划的问题最优化问题。 SVM可分为: 线性可分支持向量机:数据线性可分,通过硬间隔最大化,学习一个线性分类器。 线性支持向量机:数据近似线性可分,通过软间隔最大化,学习一个分类器。 非线性支持向量机:数据线性不可分,通过使用核技巧及软间隔最大化。 技术: SMO 核函数 序列最小最优化 输入空间为欧氏空间或这是离散集合、.

qq_43683133的博客 5396

优快云专栏限时活动!福利公告必读!

本人优快云付费专栏周排名27名专业博主,每周文章平均阅读量约7w以上!

FJN110的博客 3151

svm支持向量机

支持向量机(Support Vector Machine, SVM) 本身是一个二元分类算法,是对感知器算法模型的一种扩展,在的 SVM 算法支持线性分类和非线性分类的分类应用svm是作为感知机扩展的一种二元分类算法,不仅可以支持线性可分数据分类,还能处理非线性数据,通过寻找最合适超平面,并使离超平面最近的点最远来完成分类.svm有两种主要求解方式一种是通过最小化损失函数,另一种是通过寻找支持向量.线性可分支持向量机。

zwx999999999的博客 2083

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

支持向量机SVM原理解析

支持向量机(SVM) 可以找到这样一个超平面,使得所有相同类别的样本位于超平面一侧。如图示,可能存在无穷多个超平面。虽然他们的训练误差都等于0,但不能保证这些超平面在测...

轩逸云的博客 8525

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

上一篇: MP3格式转WAV格式
下一篇: svm.SVC API
NongfuSpring-wu
博客等级 码龄9年 19粉丝 77原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值