llama.cpp部署Gemma4-26B,并给Claude使用的经验

Gemma 4本地部署实战:E2B模型+GGUF+LLaMA.cpp终端推理指南 轻量级大语言模型(LLM)正从云端走向终端,核心诉求是低资源占用、高可控性与数据隐私保障。Gemma 4系列通过Effective参数设计(如E2B/E4B)、指令微调(-it)和GGUF量化格式,在保持推理质量的同时显著降低显存与内存需求。其本质是面向消费级硬件(如GTX 1660 Ti、8GB RAM)的工程化适配,而非单纯参数竞赛。技术价值体现在本地离线运行、零API依赖、细粒度GPU卸载(-ngl)及跨平台便携性。典型应用场景包括办公文档处理、代码辅助、会议速记与边缘端AI助手构建。本文聚焦Gemm 阅读详情

我使用GLM的Coding套餐,经常还是把额度用满。在这个暴躁的AI时代,没有模型可用,感觉空空的,是不是得了大模型病。所以想部署一个本地大模型给自己用。
Gemma4最近出来,我也用Ollama跑起来了,感觉效率还没有发挥到极致。所以想通过llama.cpp部署Gemma4-26B,网上说在12G显卡上能跑Q4量化版本。

结论

llama.cpp跑Gemma4-26B Q4版本能跑,GPU能发挥100%,这点比Ollama要强。但是连接Claude Code有点问题,会导致Claude持续分配内存,直到把所有内存都占用完。

环境及前置条件

我用的Windows11,显卡是RTX5070 TI 12GB显存,笔记本电脑。
配置好CUDA,安装Anaconda等。可以参考之前的文章。

安装llama.cpp

llama.cpp的安装方式很多,我这里选择最简单的,直接安装预编译好的版本。

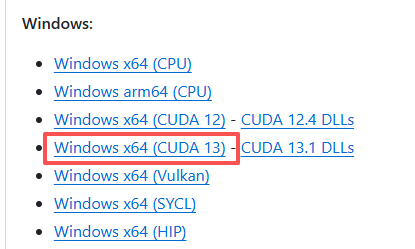
  • 到llama.cpp的官方github下载windows的安装包, https://github.com/ggml-org/llama.cpp/releases ,我用的是llama-b8833-bin-win-cuda-13.1-x64.zip。另外一个CUDA 13.1 DLLs可以不用管,他是运行时库文件包,给愿意折腾的人用的。
  • 将llama-b8833-bin-win-cuda-13.1-x64.zip解压到D:\llama
  • 将D:\llama加入到Windows环境变量
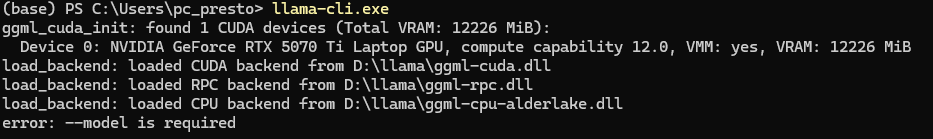
  • 在命令行窗口测试一下:随便找个目录测试一下llama-cli.exe,如果显示了error: --model is required(如下图),就说明设置正常。

图:选择预编译包
请添加图片描述

图:测试llama.cpp
请添加图片描述

准备大模型文件

准备执行的是Gemma4-26B模型,它有很多量化版本。这里也用一个比较省事、但不一定省心的方案。
在huggingface的网站找到Gemma4-26B的模型,地址是: https://hf-mirror.com/unsloth/gemma-4-26B-A4B-it-GGUF/tree/main 。
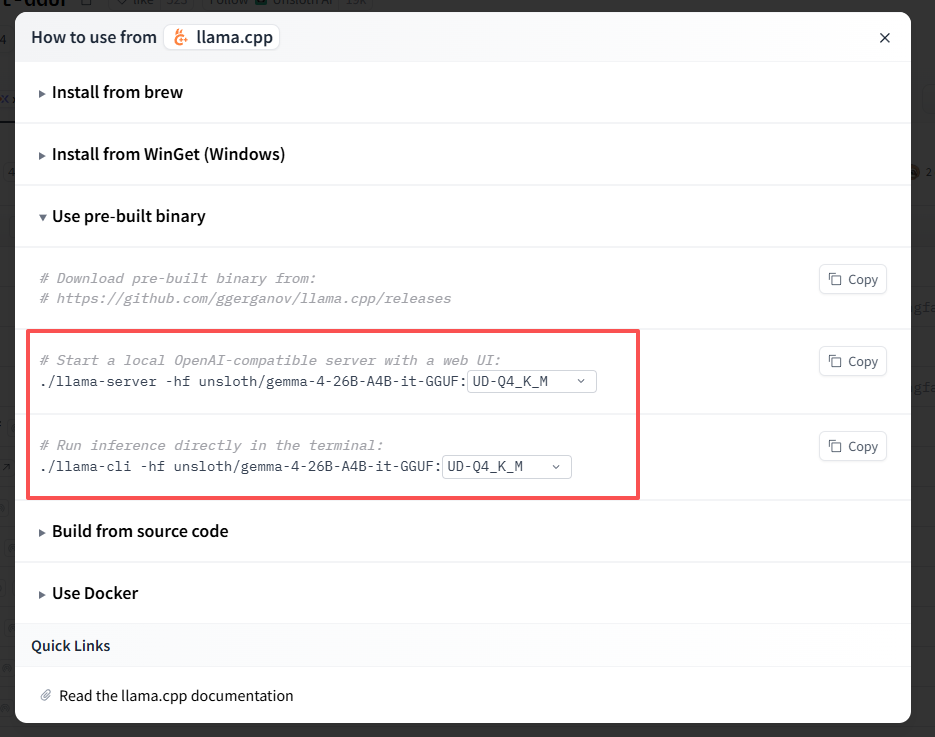
在右上角有个按钮Use this model,点击llama.cpp,出现下面的窗口,可以复制你要的命令,我复制的是./llama-server -hf unsloth/gemma-4-26B-A4B-it-GGUF:UD-Q4_K_M。
特别注意: 这行命令会把模型下载到 C盘。这不是我想要的。所以一定要改地址:llama-cli -hf 下载的模型缓存位置优先由 LLAMA_CACHE 环境变量控制。如果没有设置 LLAMA_CACHE,则会继续检查 Hugging Face 相关缓存变量,例如 HF_HUB_CACHE、HUGGINGFACE_HUB_CACHE 和 HF_HOME。
请添加图片描述

下载模型失败解决方案

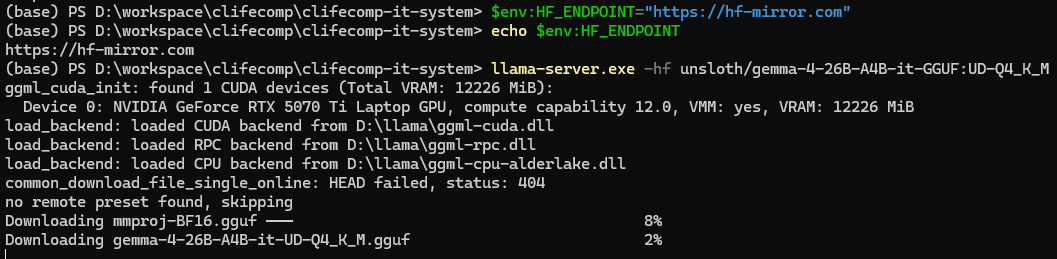
我执行上面的命令,会出现下面的错误,根本原因是无法直接访问huggingface的网站。而我之前是通过hf-mirror.com访问。

get_repo_commit: error: HTTPLIB failed: Could not establish connection
get_repo_files: failed to resolve commit for unsloth/gemma-4-26B-A4B-it-GGUF
error: failed to download model from Hugging Face

解决方案:$env:HF_ENDPOINT="https://hf-mirror.com",设置环境变量,然后就可以下载了。
请添加图片描述

调整启动命令

之前的llama-server 命令是hf给的,是默认的。这次为了能跟Claude Code对接,我将参数调整一下,重点是端口、上下文大小:ctx大小为128k

llama-server -hf unsloth/gemma-4-26B-A4B-it-GGUF:UD-Q4_K_M --host 0.0.0.0 --port 17691 --ctx-size 131072 --temp 1.0 --top-p 0.95 --top-k 64 --repeat-penalty 1.0 -ctk q8_0 -ctv q8_0 --flash-attn on --batch-size 1024 --ubatch-size 512 --threads 10 --threads-batch 12 --no-mmap --mlock --parallel 1 --no-warmup --jinja

我用E4B模型的启动命令,默认是带视觉识别:

llama-server -hf unsloth/gemma-4-E4B-it-GGUF:Q8_0 --host 0.0.0.0 --port 17691 --ctx-size 131072 --temp 1.0 --top-p 0.95 --top-k 64 --repeat-penalty 1.0 -ctk q8_0 -ctv q8_0 --flash-attn on --batch-size 1024 --ubatch-size 512 --threads 10 --threads-batch 12 --no-mmap --mlock --parallel 1 --no-warmup --jinja

为了追求最高的性能,可以将视觉去掉,只支持文本。关键是通过-m gguf的地址 指定模型文件,具体的地址可以在LLAMA_CACHE 找到。启动命令是:

llama-server -m E:\hgcache\models--unsloth--gemma-4-E4B-it-GGUF\snapshots\ce152932ac27bc40bc9c727386760424d50bb456\gemma-4-E4B-it-Q8_0.gguf  --host 0.0.0.0 --port 17691 --ctx-size 131072 --temp 1.0 --top-p 0.95 --top-k 64 --repeat-penalty 1.0 -ctk q8_0 -ctv q8_0 --flash-attn on --batch-size 1024 --ubatch-size 512 --threads 10 --threads-batch 12 --no-mmap --mlock --parallel 1 --no-warmup --jinja

Claude Code连接llama.cpp的大模型

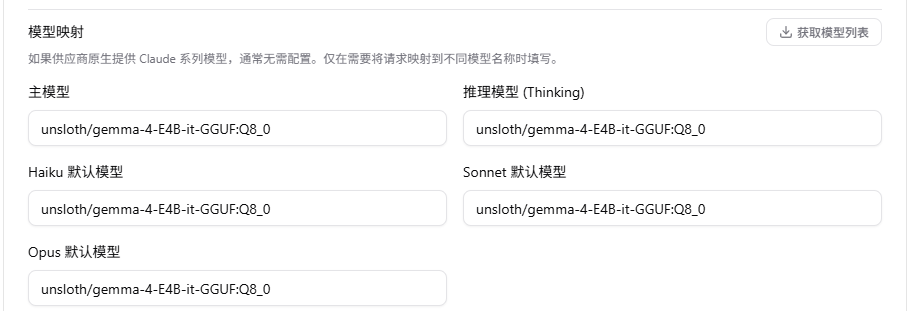
建议使用 CCSwitch
设置如下,模型名称unsloth/gemma-4-E4B-it-GGUF:Q8_0:
在这里插入图片描述

Claude Code内存溢出

启动Claude连接本地llama.cpp模型,只是简单问一句你是什么大模型?,Claude就会一直增加内存占用,要很久大概10几分钟才会有反馈。不知道是哪里配置错误。
我改成E4B模型,还是有同样的问题存在。一会就占了10G内存,把内存都撑爆了。

和Ollama对比

我用Ollama跑Gemma4 26B模型,对话还是基本能够一秒回复几个字。GPU占用不高。
用llama.cpp,很明显的对比是GPU能跑满100%,但是对话一直很慢。

显存是否够用,结论是不够

llama.cpp 在加载模型时会输出显存/内存需求信息,例如:
ggml_init_cgraph(): allocating memory: 5120 MB

还可以:

  • 使用 --verbose 或 --log-level debug 启动,查看加载阶段的内存分配日志
  • 根据模型大小、量化等级(如 Q4_0、Q5_K_M)和上下文长度(--ctx-size)预估显存需求
  • 适当降低 --n-gpu-layers 或 --ctx-size 来减少显存占用

我启动成功之后,将日志给OpenClaw分析,结果如下:

🎮 显存占用 (GPU - RTX 5070 Ti Laptop 12GB)

总计:约 9938 MiB (9.7 GB)

项目大小
模型权重 (31层)7716.76 MiB
KV 缓存 (非滑动窗口)1360.00 MiB
KV 缓存 (滑动窗口)159.38 MiB
计算缓冲区702.55 MiB
剩余可用1087 MiB

💾 内存占用 (RAM)

模型相关:约 9103 MiB (8.9 GB)

项目大小
CPU 模型缓冲区9103.04 MiB
CPU 计算缓冲区271.30 MiB
CLIP 视觉编码器1139.46 MiB
提示词缓存最高 8192 MiB (动态)

📊 关键发现

  1. 显存压力较大:由于 131K 上下文和 Q4_K_M 量化,模型无法完全放入 GPU,有 20 层溢出到 CPU
  2. KV 缓存占显存大头:131K 上下文需要约 1.5GB 的 KV 缓存
  3. 总系统内存需求:约 18-20GB (模型缓冲区 + 视觉编码器 + 提示词缓存)

优化建议: 如果不需要 131K 超长上下文,可以降到 64K 或 32K,能显著减少 KV 缓存占用的显存。

参考:

在12GB显存部署Gemma4 26b a4b:
https://carteakey.dev/blog/running-gemma-4-26b-a4b-locally/#1-build-mainline-llama-cpp
https://github.com/carteakey/l3ms


本地AI实战:Claude Code+llama.cpp+Qwen 3.6零API部署方案 大语言模型本地化部署正成为中小团队应对高成本、强合规与低延迟需求的核心路径。其本质是将推理引擎、交互界面与模型能力解耦重构:llama.cpp 提供跨平台轻量推理内核,支持 GGUF 量化与内存级上下文管理;Claude Code 作为可插拔的 IDE 智能调度器,将编码交互升维为本地 AI 操作系统;Qwen 3.6 凭借原生 reasoning_effort 控制与共享权重 embedding 能力,成为中文长文本理解与代码生成的基建型模型。该组合规避了云端 API 的 token 计费、数据出境风险与 阅读详情

相关推荐

Gemma 4 26B本地部署实战:消费级显卡跑通260亿参数大模型

大语言模型本地化部署正从‘能否运行’迈向‘如何高效可控运行’的新阶段。其核心原理在于模型量化、显存精算与推理引擎协同优化,技术价值体现在低延迟响应、数据零上传、成本可预测及调试全链路可见。典型应用场景包括AI原生应用开发、教育实训、私有知识库问答与边缘智能终端。本文聚焦Gemma 4 26B这一260亿参数开源模型,结合llama.cpp量化部署与LM Studio可视化调优,实证验证其在RTX 3060等消费级显卡上的稳定推理能力,并深入解析GGUF格式选择、CUDA架构适配、KV缓存优化等关键实践路径。

weixin_30619101的博客 399

ClaudeCode使用llamacpp部署的huggingface gguf模型

本文主要说明如何使用llamacpp部署的huggingface gguf模型,以及如何使用ClaudeCode调用llamacpp的模型

haimin0371的专栏 2282

本地部署Gemma-4-26B替代Claude Code实现7秒代码补全

大型语言模型(LLM)的本地化推理正成为开发者提升编程效率的关键路径。其核心原理在于绕过云端API调用链路,直接在终端GPU上完成token生成与思维链展开,从而规避网络延迟、服务熔断与地域限制等系统性瓶颈。技术价值体现在响应实时性跃升(从40秒级降至亚秒级)、数据隐私可控及离线可用性增强。典型应用场景包括IDE内嵌AI编程助手、企业私有代码库智能补全,以及弱网/高安全要求环境下的开发支持。本文聚焦GGUF格式MoE模型Gemma-4-26B在LM Studio与Claude Code UI中的本地化集成实

weixin_33331559的博客 320

【硬核干货】Windows环境下llama.cpp部署 Gemma-4-26B 全流程指南:从环境搭建到 API 调用

《Gemma-4模型128K上下文推理部署指南》针对消费级硬件(如RTX2080Ti)提供了完整解决方案。通过llama.cpp结合GGUF量化技术,实现高效推理的关键步骤包括:1)环境准备(11GB显存GPU+32GB内存);2)获取GGUF格式模型及mmproj多模态组件;3)使用特定参数配置:包括128K上下文窗口(--ctx-size 131072)、21层GPU卸载(--n-gpu-layers 21)、8-bit缓存量化(--cache-type-kq8_0)等优化手段。部署后可通过8088端口

xiaosuanguo的博客 1294

本地化Claude Code:用Gemma-4-26B+LM Studio实现5倍代码补全提速

大语言模型本地化部署是提升AI编程效率的关键路径,其核心在于绕过云端API依赖,将推理负载迁移至本地GPU。MoE架构(如Gemma-4-26B)通过稀疏激活显著降低显存占用与计算延迟,结合GGUF量化格式和Llama.cpp生态,可在消费级显卡(如RTX 4090)上实现低延迟、高吞吐的稳定运行。LM Studio作为轻量级图形化载体,提供了对GGUF模型的开箱即用支持,而Claude Code作为前端UI,则可通过通信层改造(替换Anthropic SDK为OpenAI兼容客户端)无缝对接本地API服务

weixin_30709061的博客 405

Gemma 4 26B MoE本地部署实战:Apple Silicon上的生产级AI

大语言模型(LLM)的本地化运行正从概念走向工程现实——其核心在于模型架构、硬件协同与推理引擎的深度适配。MoE(混合专家)并非参数堆砌,而是通过稀疏激活在消费级设备上平衡能力与开销;Apple Silicon的统一内存与Metal加速则成为低延迟、高吞吐本地推理的关键底座。技术价值体现在隐私可控、零API成本、离线可用,广泛适用于代码生成、文档处理、RAG知识库等高频开发场景。本文聚焦Gemma 4 26B MoE在M系列芯片上的完整落地路径,涵盖Ollama部署、256K上下文调优、MIT协议合规实践及

android_mylove的专栏 437

llama.cpp 部署 Gemma4-26B 并给 Claude 使用的经验:从量化到显存调优

llama.cpp 部署 Gemma4-26B 的 UD-Q4_K_M 量化版,12GB 显存可跑但需调优。本文记录从量化档位选择、显存实测到 Claude 接入的完整流程,含 KV 缓存量化与上下文调参技巧。想复用 Claude 客户端又不想被额度卡死,可搭配 TaoToken 官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 灵活切换本地与云端模型。

CyanWave34的博客 201

Claude Code与本地大模型部署实践指南

大语言模型(LLM)本地化部署是当前AI工程领域的重要趋势,其核心原理是通过模型量化与硬件加速技术在本地环境运行AI模型。从技术实现来看,主要采用GGUF格式量化和CUDA加速来平衡性能与资源消耗,其中Unsloth Studio和llama.cpp成为最流行的两种部署方案。这种技术组合特别适合需要数据隐私保护的企业开发场景,也适用于网络受限的特殊环境。在实际部署中,开发者可以在配备24GB显存的消费级显卡上运行Gemma、Qwen等优秀开源模型,虽然响应速度可能比云端服务慢2-3倍,但能确保数据完全自主可

weixin_30765505的博客 298

llama.cpp 部署 Gemma4-26B 量化模型,给 Claude 使用的经验

用 llama.cpp 部署 Gemma4-26B 的 UD-Q4_K_M 量化版,12GB 显存即可运行;先设 HF_ENDPOINT 与 LLAMA_CACHE 再启动 llama-server,并通过 TaoToken 统一通道完成协议适配,让 Claude Code 稳定调用本地模型。官网:https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_35756130的博客 6

Gemma 4开源AI模型:Apache 2.0协议下的端侧多模态实践指南

开源大模型正从‘可看’走向‘敢用’,核心在于法律确定性与工程可用性的双重突破。Apache 2.0协议赋予开发者商用、闭源衍生、离线部署等完整控制权,彻底解决合规风险;而端侧AI的落地关键,在于小模型(如2B/4B级)通过架构优化(PLE、MoE)实现高参数效率,在手机、树莓派、Jetson等边缘设备上达成实时推理。结合原生多模态支持(图文+音频输入)与结构化输出能力,Gemma 4成为构建本地化AI编程助手、工业质检系统、智能机器人等场景的技术基座——它不追求参数规模,而专注在真实硬件约束下交付稳定、可控

weixin_30352191的博客 404

Mac mini M4本地部署Gemma 4 E4B实现低成本AI养虾

AI养虾指利用大模型驱动自动化代理(Agent)完成网页监控、OCR识别、表单填写等重复性线上任务。其技术核心在于轻量级本地大模型与系统级工具链的协同——既需模型具备多模态理解与推理链能力,又依赖高效硬件适配与低开销运行机制。Gemma 4系列中,E4B凭借FP16+8-bit混合量化、动态稀疏激活及原生Metal加速,在Apple Silicon平台实现推理性能与内存占用的黄金平衡;配合OpenClaw等Agent框架,可稳定支撑中低频生产级任务。该方案不追求参数规模,而聚焦真实场景下的错误率控制、响应确

weixin_30664615的博客 345

为什么26B大模型能跑出4B的速度?gemma-4-26B-A4B-it-qat-GGUF的MoE架构深度解析

gemma-4-26B-A4B-it-qat-GGUF 是 Google Gemma 4 系列中 26B MoE 大模型的量化感知训练(QAT)GGUF 版本。它总参数高达 25.2B,但每个 token 只激活约 3.8B 参数,推理速度几乎追平 4B 级小模型,同时保持了接近全精度(bfloat16)的模型质量,是本地部署高性价比大模型的热门选择。 ## 一、26B 的身板,4B 的开销:名

gitblog_00126的博客 390

Gemma 4本地部署实战:Ubuntu+Vulkan在旧服务器上运行12B大模型

大型语言模型(LLM)的本地化推理正从GPU专属走向异构计算普及化。其核心原理在于将模型权重量化为GGUF格式,并通过llama.cpp等轻量引擎,将计算任务卸载至支持Vulkan的消费级显卡。这一技术路径显著降低硬件门槛,赋予CPU+中端独显组合实际推理能力,尤其适配Gemma系列等开源模型。在数据安全、成本控制与离线可用性驱动下,越来越多开发者选择Ubuntu系统作为首选平台——因其对AMD开源驱动和Vulkan 1.3支持成熟稳定。本文聚焦Gemma 4在老旧Xeon服务器上的全链路落地,涵盖Vulk

chuozhi7142的博客 357

CodeX 使用Gemma 4本地模型安装与实践

Gemma 4 是 Google DeepMind 于 2026年4月2日正式发布的第四代开放权重大语言模型系列。官方将其定位为“逐字节衡量下能力最强的开放模型”(Byte for byte, the most capable open models)。该系列模型与Google闭源旗舰模型Gemini 3共享同一条技术生产线,基于相同的研究成果与架构构建。这意味着开源社区获得了与Google内部顶级闭源模型处于同一技术世代的推理能力。核心技术亮点:高级推理能力。

AngelCryToo的专栏 639

本地部署Gemma4+HermesAgent指南

《本地运行Gemma4大模型简明指南》摘要: 本文提供Gemma4大模型本地部署全流程,推荐使用Ollama+HermesAgent方案。硬件要求根据模型版本不同需16-64GB内存,支持Windows/macOS/Linux系统。核心步骤包括:1)安装Ollama并拉取Gemma4模型(E4B/26BMoE/31B可选);2)配置HermesAgent对接本地模型;3)通过交互式命令实现多工具调用。特别说明新版Ollama≥0.21支持一键启动集成,同时提供WebUI访问、多模态支持和自进化技能等进阶功能

wjianwei666的专栏 1055

AES-GCM加密认证模式:原理、优势与实战应用

在数据安全领域,加密与认证是保障信息机密性和完整性的两大基石。加密确保数据内容不被窃取,而认证则验证数据来源的真实性和传输过程中是否被篡改。传统的加密后认证方案如AES-CBC+HMAC需要串行处理,性能开销较大。GCM(伽罗瓦/计数器模式)作为一种认证加密(AEAD)方案,巧妙地将AES-CTR加密与基于伽罗瓦域的GHASH认证并行结合,实现了单次数据遍历即可同时完成加密和认证,大幅提升了处理效率。其核心价值在于高性能、支持附加认证数据(AAD)以及标准化程度高,广泛应用于TLS协议、无线网络安全和云存储

weixin_28622215的博客 322

从E2B到31B:Gemma 4 QAT家族全景图,看gemma-4-31B-it-qat-GGUF如何在5种规格中定位

如果你正在寻找一款能本地跑的高性能大模型,`gemma-4-31B-it-qat-GGUF` 正是 Google Gemma 4 家族中 31B 旗舰的 **QAT(量化感知训练)GGUF 版本**。本文带你从最小的 E2B 走到最强的 31B,一张表看懂 Gemma 4 QAT 家族的 5 种规格,并讲清楚这个仓库里每个文件的用途,帮你在本地部署大模型时做出最合适的选择。 ## 一、Gemma

gitblog_00601的博客 279

001-基础入门-Web演示源码&资源&工具箱等

小迪安全2023笔记

wushangyu32335的博客 4269

本地跑 Gemma 4 替代 Claude Code?M4 Max 实测告诉你行不通,附 TaoToken 配置骨架

M4 Max 128GB 实测 Gemma 4 26B A4B 接 Claude Code 行不通:系统提示词 29K Token 直接撑爆 32K 上下文,生成速度仅 14 tok/s。本文附 LM Studio 加载参数、Claude Code 配置骨架与报错排查清单,并给出 TaoToken 统一接入方案,用网关做 Key 管理与模型调度,本地轻量对话与云端重型 Agent 各取所长。官网:https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_35752122的博客 16

高效数据迁移:ICCAP到ADS的数据导入与导出实战指南

本文提供了从ICCAP到ADS进行高效、准确数据迁移的实战指南。针对射频与微波电路设计中的关键挑战,详细阐述了迁移前的战略规划、ICCAP数据的精细化导出(包括脚本化批处理)、ADS数据的多种导入方法(如Data Items、DML模型库及编程化API),并强调了数据完整性与准确性验证的重要性,确保模型参数和仿真结果在平台间可靠传递。

weixin_29291185的博客 135

手把手教你ensp仿真搭建校园网(含防火墙及无线网络)系列(三)校园无线网络AC+AP配置

本系列博客将带你从零开始,使用 华为 eNSP(Enterprise Network Simulation Platform) 仿真搭建一个完整的校园网络,涵盖 核心层、汇聚层、接入层、防火墙安全策略、无线AC+AP组网 等实战场景。无论你是网络初学者还是希望深化实战经验的工程师,都能通过本教程掌握企业级网络的规划、配置与排错技巧。

echo的博客 1368

谷歌深夜甩出“王炸”!Gemma 4 12B封神:无编码器多模态,16GB轻薄本就能跑,性能直逼26B(附本地部署方案)

Apache 2.0协议全开源,游戏本秒变AI服务器。从三体碰撞动画到Claude级对话,本地AI狂欢已开场。小伙伴们,全球AI圈彻底炸了——Google DeepMind毫无预兆地甩出Gemma 4 12B,一款能在16GB轻薄本上全离线运行的多模态大模型,没有编码器,却能直接看懂图像、听懂音频、读懂文字,性能直逼26B级巨兽。当别人还在为千亿算力烧掉千万美元时,谷歌反手把“平民级本地AI”塞进你的笔记本。这,就是让开发者集体尖叫的封神之作。

2403_88996352的博客 206

挂载(Mount)是什么意思

挂载 = 把一个存储设备或文件系统“接入”到现有的目录树,使其内容能够被访问。

天赐好车的博客 290
上一篇: Claude Code + Spec-kit,组织四个 AI Agent 学会自己协作
下一篇: llama.cpp部署QWEN3.5-9B和Gemma4-e4b,用Claude Code对比测试
tinygone
博客等级 码龄13年 190粉丝 42原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值