OpenClaw之Memory配置成本地模式,Ubuntu+CUDA+cuDNN+llama.cpp

Qwen本地部署实战:llama.cpp+vLLM双引擎离线推理方案 大语言模型本地化部署是保障数据安全、降低API成本与提升响应确定性的关键技术路径。其核心在于推理引擎选型、模型量化适配与服务层治理能力的协同优化。基于llama.cpp的确定性控制与vLLM的高并发调度能力,Qwen系列模型(如Qwen2/Qwen3)可在消费级GPU、ARM设备及昇腾AI芯片上实现低延迟、可量化的离线推理。尤其在工业质检、边缘ASR、私有知识库等需多模态集成与强SLA保障的场景中,chat_template精准注入、Q4_K_M量化策略及OpenAI兼容API成为落地关键。本文聚焦Qwen 阅读详情
AI摘要

本文详细记录在Ubuntu 24.04系统下将OpenClaw的Memory功能切换为本地模式的技术路径:包括修改openclaw.json配置、安装CUDA与cuDNN、编译支持GPU加速的llama.cpp、集成node-llama-cpp,以及解决sqlite-vec不可用等问题。重点聚焦于摆脱对OpenAI/Gemini等远程API依赖,实现纯本地大模型驱动的记忆检索能力。

承接上文:Windows11基于WSL2首次运行Openclaw,并对接飞书应用,我已经在电脑上安装了OpenClaw,接下来解决Memory问题。走了很多弯路,下面主要讲我总结的正确的安装过程。
总结来说:针对Memory不生效的问题,又不想用OpenAI或Gemini,或者只想单纯的节省token,可以按照如下的方式,设置为local模式:

  • 修改openclaw.json配置
  • 安装CUDA和cuDNN
  • 编译llama.cpp,使用cuda
  • 安装node-llama-cpp
  • 验证

背景:Memory不生效的问题

执行openclaw doctor命令,有如下提示

◇  Memory search 
Memory search is enabled but no embedding provider is configured. 
Semantic recall will not work without an embedding provider.               Fix (pick one):     
  - Set OPENAI_API_KEY or GEMINI_API_KEY in your environment
  - Add credentials: openclaw auth add --provider openai
  - For local embeddings: configure agents.defaults.memorySearch.provider and local model
    path
  - To disable: openclaw config set agents.defaults.memorySearch.enabled false
  Verify: openclaw memory status --deep

这是因为“长期记忆检索”(memory_search)的 provider 只支持 openai | gemini | local,其中 openai/gemini 都需要单独的 API Key(或 remote.apiKey)。
这一块网上的资料很少,且部分缺少上下文。我就决定自己来配置使用本地(local)模式的Memory。

OpenClaw的Memory配置

参考官网上的Memory介绍,我做了如下修改。
1、修改openclaw.json:如下,在~/.openclaw/openclaw.json中,增加/修改如下内容


  "agents": {
    "defaults": {
      "model": {
        "primary": "zai/glm-5"
      },
      "models": {
        "zai/glm-5": {
          "alias": "GLM"
        }
      },
      "workspace": "/home/band/.openclaw/workspace",
      "compaction": {
        "mode": "safeguard",
        "reserveTokensFloor": 20000,
        "memoryFlush": {
          "enabled": true,
          "softThresholdTokens": 4000,
          "systemPrompt": "Session nearing compaction. Store durable memories now.",
          "prompt": "Write any lasting notes to memory/YYYY-MM-DD.md; reply with NO_REPLY if nothing to store."
        }
      },
      "maxConcurrent": 4,
      "subagents": {
        "maxConcurrent": 8
      },
      "memorySearch": {
        "provider": "local",
        "local": {
          "modelPath": "hf:ggml-org/embeddinggemma-300M-GGUF/embeddinggemma-300M-Q8_0.gguf"
        },
        "fallback": "none",
        "sources": [
          "memory",
          "sessions"
        ],
        "experimental": {
          "sessionMemory": true
        },
        "store": {
          "vector": {
            "enabled": true,
            "extensionPath": "~/.npm-global/lib/node_modules/sqlite-vec/node_modules/sqlite-vec-linux-x64/vec0.so"
          }
        }
      }
    }
  }

注意:

  • modelPath采用官方建议的模型,注意是模型名称,不是本地的目录,我就是在这卡了很久。
  • extensionPath后文有讲到,修改为本地的目录

Ubuntu24.04安装CUDA和cuDNN

按照官网的教程安装,地址:https://developer.nvidia.com/cuda-downloads

mkdir /opt/nvidia
cd /opt/nvidia
wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2404/x86_64/cuda-ubuntu2404.pinsudo mv cuda-ubuntu2404.pin /etc/apt/preferences.d/cuda-repository-pin-600wget https://developer.download.nvidia.com/compute/cuda/13.1.1/local_installers/cuda-repo-ubuntu2404-13-1-local_13.1.1-590.48.01-1_amd64.debsudo dpkg -i cuda-repo-ubuntu2404-13-1-local_13.1.1-590.48.01-1_amd64.debsudo cp /var/cuda-repo-ubuntu2404-13-1-local/cuda-*-keyring.gpg /usr/share/keyrings/sudo apt-get updatesudo apt-get -y install cuda-toolkit-13-1

安装后,还需要设置环境变量

echo 'export PATH=/usr/local/cuda-13.1/bin${PATH:+:${PATH}}' | sudo tee -a /etc/profile.d/cuda.sh
echo 'export LD_LIBRARY_PATH=/usr/local/cuda-13.1/lib64${LD_LIBRARY_PATH:+:${LD_LIBRARY_PATH}}' | sudo tee -a /etc/profile.d/cuda.sh
source /etc/profile.d/cuda.sh

验证:nvcc --version,提示如下表明已经cuda toolkit安装成功。
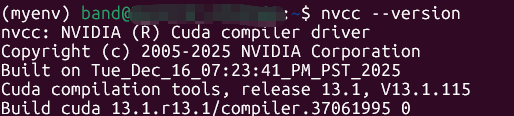
请添加图片描述
安装cuDNN

wget https://developer.download.nvidia.com/compute/cudnn/9.19.0/local_installers/cudnn-local-repo-ubuntu2404-9.19.0_1.0-1_amd64.deb
sudo dpkg -i cudnn-local-repo-ubuntu2404-9.19.0_1.0-1_amd64.deb
sudo cp /var/cudnn-local-repo-ubuntu2404-9.19.0/cudnn-*-keyring.gpg /usr/share/keyrings/
sudo apt-get update
sudo apt-get -y install cudnn

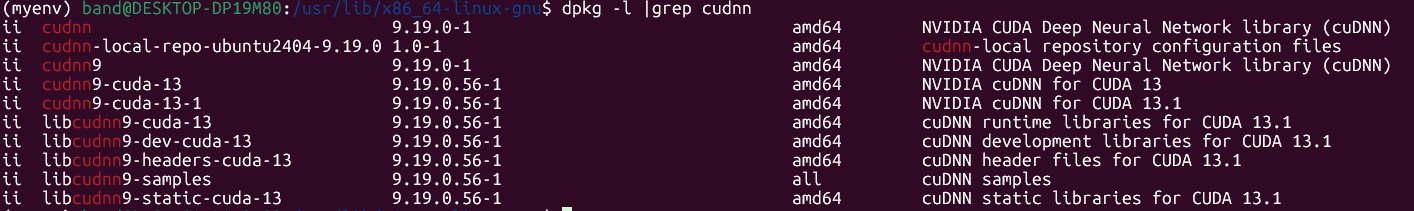
使用如下命令查看安装的目录

# 注意大小写
dpkg -L libcudnn9-cuda-13
dpkg -l |grep cudnn
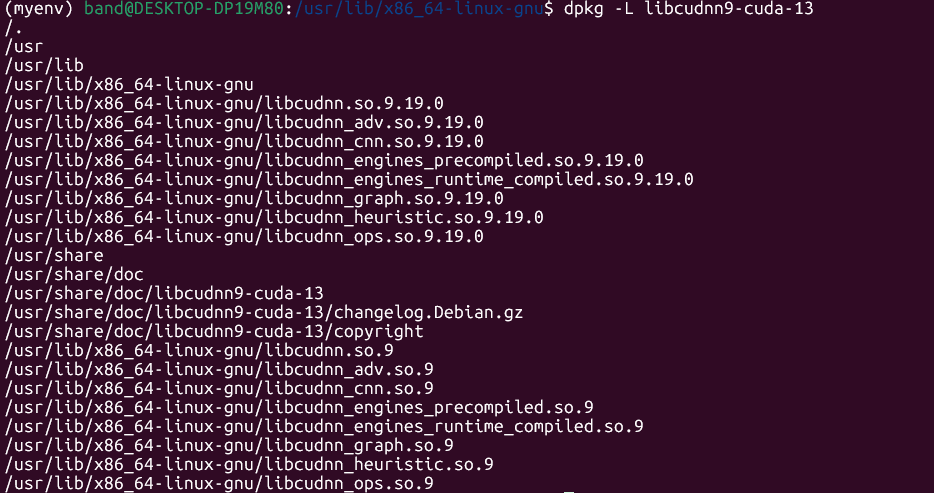
请添加图片描述
请添加图片描述
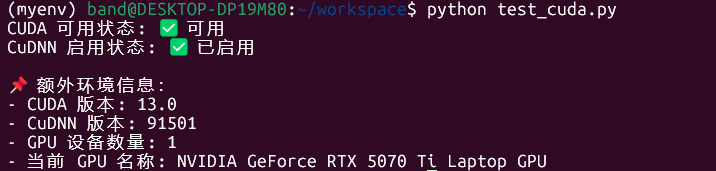
验证,与前文类似,先安装Anaconda,再安装pytorch,所有工作完成后。执行如下命令:python test_cuda.py
请添加图片描述

编译llama.cpp

node-llama-cpp 会尝试构建 CUDA / Vulkan / CPU 三种版本,最终 fallback 到 CPU 版成功。为了避免用CPU版本,我先安装调试好CUDA。我估计这一步可以采用官网的指引,Install llama.cpp using brew, nix or winget。
https://github.com/ggml-org/llama.cpp/blob/master/docs/build.md

git clone https://github.com/ggml-org/llama.cpp.git
# 前提,要设置好环境变量,DLLAMA_OPENSSL是必要的,后面会有提示
cd llama.cpp
cmake -B build -DGGML_CUDA=ON -DLLAMA_OPENSSL=ON
cmake --build build --config Release

验证llama.cpp是否已经安装好

验证方案1:

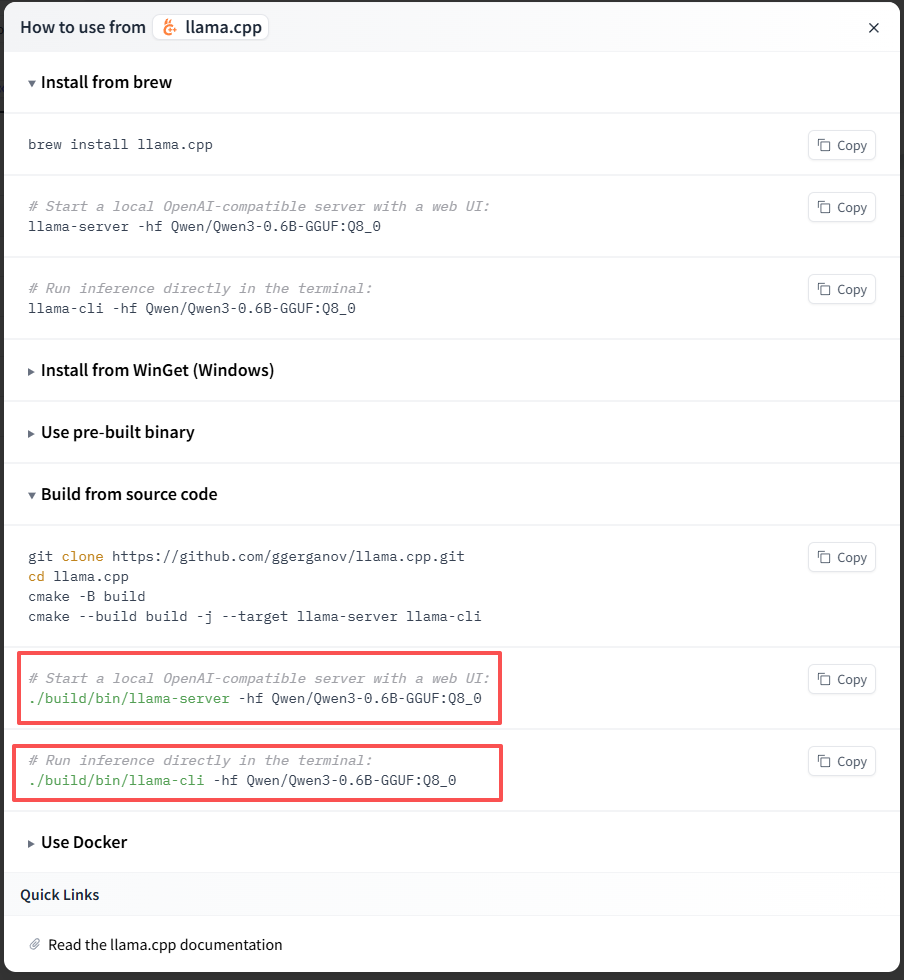
访问: https://huggingface.co/Qwen/Qwen3-0.6B-GGUF/tree/main ,点击Use this model,选择llama.cpp,出现下面的窗口
请添加图片描述
因为我是再WSL种运行,就选择cli方案:

# Run inference directly in the terminal:
./build/bin/llama-cli -hf Qwen/Qwen3-0.6B-GGUF:Q8_0

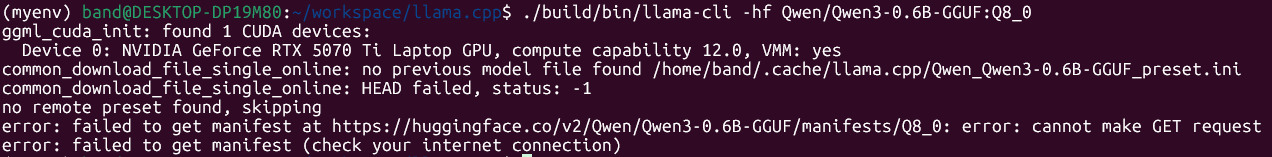
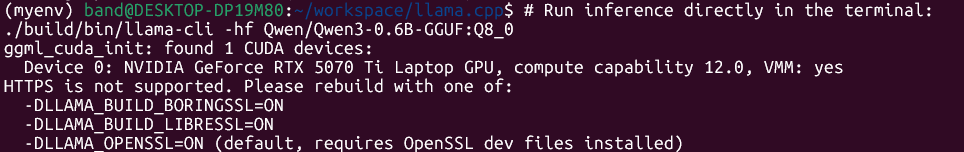
如果出现下面的错误,加上-DLLAMA_OPENSSL=ON参数,重新编译llama.cpp。
请添加图片描述
解决之后又有新的报错。暂时先到这里,没有继续验证,TODO
请添加图片描述

验证方案2:下载并运行Llama-2 7B模型

# 安装并初始化git-lfs(GIt Large File Storage)
$ sudo apt install git-lfs
$ git lfs install

这个方案我没有做完。

安装node-llama-cpp

npm install -g node-llama-cpp
# 此处官网文档和网上的资料都给了我误导
node-llama-cpp --version
# 3.16.1

验证Memory

openclaw gateway restart
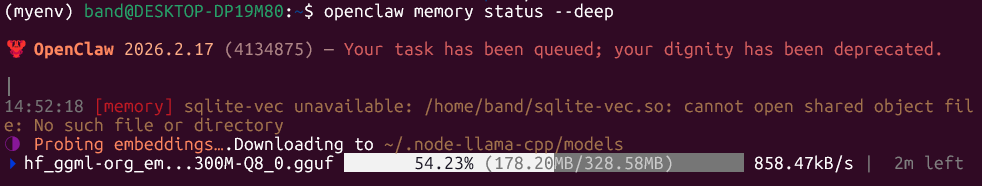
openclaw memory status --deep

正在下载模型到~/.node-llama-cpp/models,说明已经起作用了。
请添加图片描述

sqlite-vec unavailable

在openclaw doctor或openclaw memory status --deep,还有个错误。

[memory] sqlite-vec unavailable: /home/band/sqlite-vec.so: cannot open shared object file: No such file or directory

循着网上的信息,找到正主:https://github.com/asg017/sqlite-vec,安装教程在:https://alexgarcia.xyz/sqlite-vec/installation.html,编译教程:https://alexgarcia.xyz/sqlite-vec/compiling.html

# 缺少什么安装什么
sudo apt-get update 
sudo apt-get install unzip
sudo apt install -y libsqlite3-dev
git clone https://github.com/asg017/sqlite-vec 
cd sqlite-vec 
./scripts/vendor.sh 
make loadable

按照官网的编译教程还是有误,就没继续。

我用了一个取巧的办法,

# 先安装,安装的目录在~/.npm-global/lib/node_modules/sqlite-vec/node_modules/sqlite-vec-linux-x64/vec0.so。
# 如果不知道在哪,可以先用whereis node-llama-cpp/pnpm,找到~/.npm-global/bin/,lib在同一个目录
npm install -g sqlite-vec

修改如下配置,重启gateway,再执行openclaw memory status --deep,问题修复

"extensionPath": "~/.npm-global/lib/node_modules/sqlite-vec/node_modules/sqlite-vec-linux-x64/vec0.so"

踩过的坑

安装node-llama-cpp的一些提示

openclaw的文档提示如下:

### [本地嵌入自动下载]

- 默认本地嵌入模型:`hf:ggml-org/embeddinggemma-300M-GGUF/embeddinggemma-300M-Q8_0.gguf`(约 0.6 GB)。
- 当 `memorySearch.provider = "local"` 时,`node-llama-cpp` 解析 `modelPath`;如果 GGUF 缺失,它会自动下载到缓存(或 `local.modelCacheDir`,如果已设置),然后加载它。下载在重试时会续传。
- 原生构建要求:运行 `pnpm approve-builds`,选择 `node-llama-cpp`,然后运行 `pnpm rebuild node-llama-cpp`。
- 回退:如果本地设置失败且 `memorySearch.fallback = "openai"`,我们自动切换到远程嵌入(`openai/text-embedding-3-small`,除非被覆盖)并记录原因。

运行openclaw doctor,提示如下

Memory search provider is set to "local" but no local model file was found. 

  Fix (pick one): 
  - Install node-llama-cpp and set a local model path in config
  - Switch to a remote provider: openclaw config set agents.defaults.memorySearch.provider
    openai
  Verify: openclaw memory status --deep

看起来必须要安装node-llama-cpp。于是继续搜寻资料。

cd ~/.openclaw/extensions
npm install node-llama-cpp
# 此时node-llama-cpp安装到~/.openclaw/extensions/node_modules,没有起作用。
pnpm approve-builds
# 提示没有需要编译的:There are no packages awaiting approval
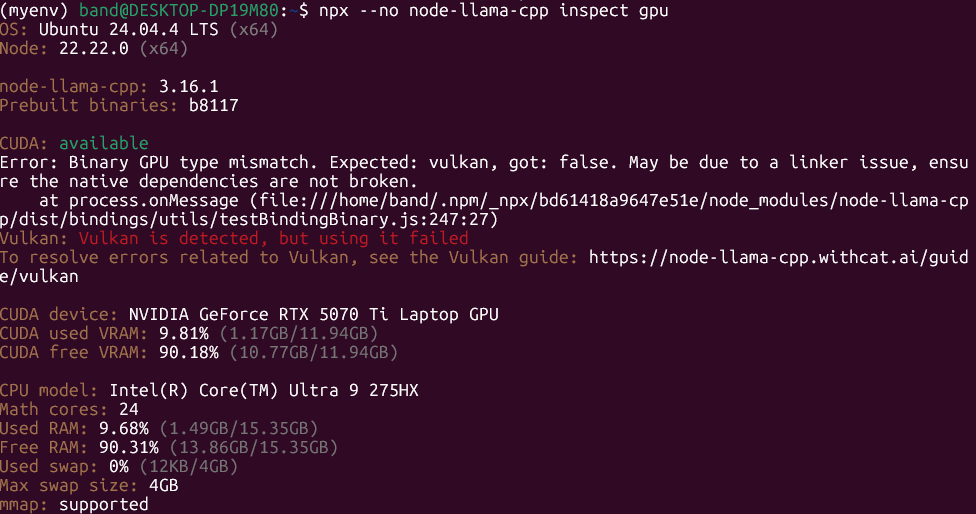
npx --no node-llama-cpp inspect gpu
# 提示报错

安装node-llama-cpp的前置条件

OpenClaw 依赖 node-llama-cpp,网上说要原生编译安装。需要从源码编译 llama.cpp(大型 C++ AI 库)。所以要先编译llama.cpp,还依赖CUDA和cuDNN。所以正确的安装顺序是:

  • 安装CUDA
  • 安装cuDNN
  • 编译llama.cpp
  • 原生编译安装node-llama-cpp
# https://github.com/withcatai/node-llama-cpp.git
sudo apt-get update
sudo apt-get install build-essential cmake git libstdc++6 libgomp1

npx node-llama-cpp source download
npx node-llama-cpp source build

当我尝试执行npx node-llama-cpp source download,一直报错。
此时我再尝试执行npx --no node-llama-cpp inspect gpu,能正确执行,但是报错如下。让我很意外,怀疑是因为我把llama.cpp已经编译成功的缘故。

Vulkan: Vulkan is detected, but using it failed
To resolve errors related to Vulkan, see the Vulkan guide: https://node-llama-cpp.withcat.ai/guide/vulkan
请添加图片描述

Using node-llama-cpp With Vulkan

这个问题是在处理node-llama-cpp时遇到的,目前看没有影响,后面也没处理。

关键词:openclaw, Memory_search, node-llama-cpp, 本地模式,cuda等

OpenClaw腾讯云一键部署实战:AI工作流轻量编排指南 AI服务编排是指将大模型、工具调用、数据处理等能力按业务逻辑串联成可复用工作流的技术范式。其核心原理在于解耦模型推理、技能注册与API暴露,通过声明式配置实现低代码集成。该技术显著降低AI能力工程化门槛,提升POC验证效率与生产环境可维护性。典型应用场景包括智能客服中台搭建、私有AI知识网关构建、以及中小团队快速落地OCR/意图识别等垂直能力。本文聚焦OpenClaw这一面向腾讯云环境优化的轻量级CLI编排框架,深入解析其在Ubuntu 22.04系统下的Python环境隔离、ImageMagick路径适配 阅读详情

相关推荐

Windows本地部署OpenClaw:WSL2+Docker+LM Studio全栈方案

本地智能体(Agent)开发正从云端回归终端,其核心诉求是隐私可控、低延迟响应与模型热切换能力。OpenClaw作为轻量级开源Agent框架,本身不内置推理引擎,依赖外部LLM服务提供语言理解与工具调用能力;而GGUF格式已成为当前主流量化模型封装标准,具备跨平台兼容性与内存效率优势。在Windows生态中,直接部署常面临PowerShell权限混乱、Python环境冲突及GPU支持缺失等工程瓶颈。WSL2提供完整Linux内核能力,Docker实现运行时隔离与环境可复现,LM Studio则以开箱即用的G

weixin_34037515的博客 417

OpenClaw 安装文档

摘要:针对阿里云ECS服务器(1.8GB内存)编译llama.cpp时内存不足的问题,本文提供了一种本地编译后上传服务器的解决方案。具体步骤包括:1)在本地Mac通过npm安装OpenClaw并打包;2)上传至阿里云服务器解压安装;3)配置环境变量和启动服务。最后通过SSH端口转发实现本地访问WebUI(http://localhost:18789),使用预设令牌(openclaw2026)进行认证。该方法有效规避了服务器内存不足导致的编译失败问题。(150字)

感谢你的关注~~~~ღ( ´・ᴗ・` ) 2703

OpenClaw 2026:Windows 11原生AI一键部署工具链

AI本地化部署正从Linux服务器下沉至Windows桌面端,其核心挑战在于系统兼容性、安全策略冲突与GPU运行时环境构建。OpenClaw作为专为Windows 11深度定制的AI工作流集成套件,通过内核级适配(如CET/Shadow Stack兼容)、进程沙箱化Python环境、WSL2桥接优化及Windows Defender启发式绕过等技术,实现模型加载、推理服务与WebUI的30分钟闭环。它不依赖Docker或Linux基础设施工具链,而是以‘一键部署’为表、‘全栈式Windows AI基建协议’

dianxi0949的博客 458

[特殊字符]️ Windows 下 OpenClaw 从 0 到 1 完整部署避坑指南

`git clone ssh://git@github.com... Permission denied` | git 默认使用 SSH 协议,无权限 | 执行 `git config --global url."https://github.com/".insteadOf ssh://git@github.com/`,强制用 HTTPS 克隆 | ---- `--omit=optional`:跳过问题依赖 `node-llama-cpp`(避免预编译二进制包下载失败)

weixin_41954142的博客 2282

DeepSeek V4 Flash × OpenClaw:轻量Agent架构实战指南

大模型轻量化不是参数缩水,而是面向智能体(Agent)工作负载的系统性重构。DeepSeek V4 Flash 以动态窗口注意力、功能分区多头机制与原生FlashAttention-2为核心,显著降低KV Cache内存占用与推理延迟,契合机器人代理框架OpenClaw对低显存、亚秒级响应、技能热更新的工程刚需。其Q4_K_M量化权重、纯CPU可运行能力及LoRA热插拔支持,使本地化部署从‘高成本租用’转向‘可持续养育’,广泛适用于ROS2机器人、AGV调度、边缘AIoT等实时控制场景。

weixin_34032621的博客 315

Qwen3.5-27B+LM Studio+OpenClaw私有AI部署实战指南

大语言模型(LLM)本地化部署是企业构建可控AI能力的基础环节,其核心在于平衡推理质量、硬件成本与数据安全。Qwen3.5-27B作为高性价比开源大模型,凭借32K上下文支持与4bit量化后14GB显存占用,在消费级GPU上实现专业级文档理解;LM Studio以预编译二进制形态绕过CUDA版本冲突、PyTorch依赖等典型部署障碍,提供开箱即用的OpenAI兼容API服务;OpenClaw则作为轻量级Agent框架,将模型调用抽象为配置驱动,支撑金融合规审查、工业日志分析、设计稿语义解析等多场景任务编排。

dianxiangong2403的博客 465

openclaw怎么调用记忆的

OpenClaw 的记忆以工作区中的 Markdown 文件为唯一事实来源,配合可选的向量/混合索引实现语义搜索;系统会在会话接近压缩时自动触发“记忆刷新”提醒模型持久化重要信息,并提供 CLI 工具用于手动索引与搜索12。

brepnet uvnet 2578

Claude Code本地化开发:Mac上离线运行Claude 3.5的VS Code深度集成方案

本地大模型编程正从云端API调用转向终端原生推理——这不仅是部署方式的改变,更是开发范式的重构。其核心原理在于将量化模型(如GGUF格式)与编辑器深度耦合,通过LSP协议实时获取AST、文件上下文和项目配置,实现可调试、可干预、零上传的代码生成。技术价值体现在低延迟响应(Metal加速下22 token/s)、敏感逻辑不出域、以及上下文感知能力跃升;典型应用场景覆盖Django/TypeScript工程重构、Git暂存区AI审查、Notebook驱动的数据分析等。Claude Code正是这一趋势的实践标杆

weixin_33709590的博客 340

OpenClaw - 02 语义记忆系统的高阶配置与分层实践

本文介绍了如何为OpenClaw配置高效的记忆系统(Memory System),实现AI助手的长期记忆功能。文章首先明确了记忆系统的三大验收标准:语义理解能力、引擎就绪状态和精准历史召回。随后详细解析了配置文件的正确层级结构,解释了为何使用"openai"作为provider却可以连接SiliconFlow服务,并推荐使用BAAI/bge-m3作为Embedding模型。作者建议将记忆范围限定在memory目录,并提出了"分层记忆体系"的最佳实践,包括索引层、项目层

小工匠 4556

OpenClaw+Qwen3.5:动态KV缓存与Token重要性评估实现长文本无焦虑推理

大语言模型推理中的KV Cache管理是制约长上下文应用的核心瓶颈,其显存开销、访问延迟与量化精度三者长期难以兼顾。OpenClaw提出将计算图变为运行时可调度对象,通过Token重要性评估(TIA)驱动分层KV缓存(热/温/冷区),结合Qwen3.5重构的位置编码与分块KV机制,在不修改模型结构前提下实现语义感知的动态内存调度。该技术显著降低128K级长文本推理的显存峰值与OOM风险,提升RAG、教育助教、法律分析等场景的语义连贯性与响应稳定性,使Token从刚性资源转变为弹性计算维度。

weixin_34411563的博客 440

Windows本地部署AI智能体:RTX 3060+Ollama+Qwen3.5实操指南

AI智能体(Agent)是大语言模型走向实用化的关键形态,其核心在于模型调用工具、自主规划与任务执行的能力。技术原理上依赖于工具调用(Tool Calling)机制、轻量级推理运行时与中文优化的大模型协同工作。该方案的技术价值在于突破Windows生态下本地AI工程化的多重限制——规避Linux依赖、绕过Docker与CUDA编译、兼容老旧硬件并保障稳定性。典型应用场景包括自动化办公(邮件/天气查询)、本地数据处理(视频转GIF)及中小团队AI原型验证。本文聚焦RTX 3060 12G这一高性价比显卡平台,

chunchan1381的博客 455

OpenClaw之Memory配置成本地模式:Ubuntu+CUDA+cuDNN+llama.cpp 全链路落地与 TaoToken 统一 Key 接入

在 Ubuntu 上为 OpenClaw Memory 配置本地模式,需打通 CUDA、cuDNN、llama.cpp 与 node-llama-cpp 全链路,让 embedding 走本地 GPU。本文按环境校验、编译、配置、验证、排障顺序给出可复制命令,并说明如何用 TaoToken 统一 Key 接入远端对话模型,官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 。

weixin_35755434的博客 29

openclaw架构分析(三) -------------- memory实现分析

从实现角度看,OpenClaw 并没有把“长/短期记忆”拆成完全不同的系统,而是通过同一个 MemoryIndexManager + 配置/源的区分长期记忆(Long-term Memory)sources中的"memory",对应工作区中的代码、文档、笔记等;存储:SQLite 索引文件(默认在 state 目录同步:以文件监听与周期同步为主,不太频繁;检索:embedding + FTS 混合,结合 MMR/时间衰减。短期记忆(Short-term / Session Memory)

happyAnger6的专栏 998

腾讯云轻量服务器部署OpenClaw AI智能体框架全流程指南

AI智能体框架作为连接大语言模型与业务系统的中间层,通过模块化设计实现任务编排与工具调用,其核心原理在于将自然语言指令解析为可执行的工作流。这一技术为构建企业级AI助手提供了工程化基础,在数据安全要求严格的金融、医疗等行业具有重要应用价值。私有化部署能够确保敏感数据不出域,同时支持深度定制化集成。本文以开源框架OpenClaw为例,结合腾讯云轻量应用服务器环境,详细解析从系统初始化、依赖编译到服务化部署的完整实践路径,涵盖Pyenv虚拟环境管理、GPU加速编译优化、Nginx反向代理配置等关键环节,为开发者

weixin_30824599的博客 342

C#实战:通过ZPL指令与斑马打印机交互及状态监控全解析

本文全面解析了在C#中通过ZPL指令与斑马打印机进行交互及状态监控的实战方法。文章详细介绍了TCP/IP网络打印和Windows Raw打印两种核心连接方式,并深入讲解了ZPL指令的构建。重点阐述了通过SGD命令和斑马官方SDK实现实时打印状态监控的策略,为工业自动化场景下的可靠打印提供了完整解决方案。

weixin_29294395的博客 117

Python 格点数据插值到站点 最邻近插值 双线性插值

python 气象数据格点数据插值到站点,最邻近插值法,双线性插值法

好记性不如烂笔头 8461

OpenClaw云原生部署指南:在阿里无影上构建可调试AI工作流

AI工作流编排是大模型落地的关键环节,其核心在于解耦模型、向量库与业务逻辑,实现可复现、可调试的端到端流水线。OpenClaw作为轻量级开源框架,聚焦于本地LLM协同调度,支持RAG、代码执行、多模态串联等典型场景。它不替代训练或推理引擎,而是通过YAML声明式定义DAG流程,屏蔽CUDA驱动冲突、环境依赖混乱、容器权限异常等工程痛点。依托阿里无影云电脑提供的标准化Ubuntu+预装CUDA+GPU直通环境,开发者得以跳过传统部署中的驱动适配、镜像构建与资源争抢问题,直接进入AI应用原型验证阶段。本文即围绕

www.itmmd.com 379

Anomalib实战:5分钟搞定图像异常检测模型训练(附完整代码)

本文提供了一份基于Anomalib框架的图像异常检测快速实战指南。文章详细介绍了从环境搭建、数据准备到模型训练与推理的完整流程,重点推荐了训练速度快、效果稳定的PatchCore模型,并附带了可运行的完整代码,旨在帮助开发者快速上手工业质检等实际应用。

weixin_29039773的博客 426

从本地到云端:AI应用迁移实战与避坑指南

在人工智能应用开发领域,模型部署与云端服务化是项目从原型走向生产的关键环节。其核心原理在于将训练好的模型与业务逻辑封装,通过容器化或虚拟化技术,在云服务器上构建稳定、可扩展的服务环境。这一过程的技术价值在于能够突破本地算力限制,实现高可用、弹性伸缩的7x24小时服务,并支持团队协作与远程访问。典型的应用场景包括智能对话系统、文档自动化处理以及知识库问答等AI应用的线上部署。本文以一次真实的OpenClaw框架迁移为例,聚焦于解决从Mac本地环境迁移至AWS EC2 GPU实例时遇到的环境依赖冲突、CUDA驱

weixin_30654583的博客 358

FileZilla Server 1.2.0 TLS证书过期问题

FileZilla Server TLS证书过期后重新生成

Wigle的备忘录 7530

Puchem化合物数据批量抓取采集_宝典_教程_Python爬虫

本文共计6500字,导出到PDF达42页(含代码)。从0教你如何抓取Pubchem化合物数据。 1、 Pubchem介绍 ​ Pubchem是美国国立卫生研究院(NIH)的开放式化学数据库,自2004年推出以来,pubchem已成为科学家、学生和公众的重要化学信息资源。其专门针对化学结构搜索,是网络药理学研究经常用到的数据库之一,不仅使用方便而且免费。 ​ PubChem主要包含小分子,但也包含较大的分子,例如核苷酸,碳水化合物,脂质,肽和化学修饰的大分子。收集有关化学结构,标识符,化学和物理性..

qq_34843422的博客 6075

OpenClaw本地与云端部署全攻略:从硬件选型到Docker容器化实战

大语言模型(LLM)作为当前人工智能领域的核心技术,通过其强大的自然语言理解和生成能力,正在重塑人机交互方式。其工作原理基于Transformer架构的海量参数训练,能够捕捉复杂的语言模式和知识关联。这一技术的核心价值在于将非结构化的语言指令转化为可执行的任务流程,极大地提升了自动化水平和效率。在实际应用中,LLM常被集成到智能体框架中,用于构建能够理解复杂指令、调用多模型协同工作的AI系统。本地部署这类框架时,硬件选型是关键,需重点评估CPU核心数、内存容量(特别是针对模型参数的内存估算)以及GPU显存。

weixin_34059951的博客 398

机器人环境仿真软件:Webots_(9).路径规划与导航算法仿真实现

通过仿真,我们可以验证路径规划算法的有效性和鲁棒性,同时优化机器人在不同环境中的导航性能。动态窗口法是一种局部路径规划算法,通过在机器人当前速度空间中选择一个最优的速度窗口,使机器人在动态环境中安全地移动。算法的代价函数通常包括两个部分:从起始点到当前节点的实际代价(g-cost)和从当前节点到目标节点的估计代价(h-cost)。在World Editor中,选择“Insert”菜单,添加“Robot”对象,如“E-puck”或“Thymio”。Dijkstra算法的实现与A*算法类似,但不使用启发函数。

kkchenjj的博客 2007

阿里云ECS秒级部署OpenClaw+Qwen3-Max实战指南

大模型Agent部署本质是环境可控性与服务可交付性的工程问题。OpenClaw作为轻量级Agent调度框架,不训练模型而专注编排,其落地成败高度依赖底层运行时稳定性;Qwen3-Max作为闭源旗舰模型,需通过百炼平台API调用,对网络认证、GPU加速和依赖兼容提出严苛要求。传统本地部署常因显卡驱动缺失、CUDA版本错配、HTTPS双向认证失败等问题陷入‘调试黑洞’,而阿里云容器化方案通过预构建ACR镜像、自动Docker安装、A10 GPU实例深度适配,将不可控变量前置收敛,实现从实例创建到API响应的分钟

weixin_34401479的博客 447

C#每日面试题-属性和字段的区别

在C#面试中,“属性(Property)和字段(Field)的区别”是基础且高频的考点。很多初学者会把两者混为一谈,甚至觉得“属性就是加了get/set的字段”,但这种理解只停留在表面。面试考察的核心,是对“封装思想”的理解,以及两者在语法特性、底层实现、实际应用中的本质差异。今天我们从“基础认知→核心差异→底层原理→实际应用→面试避坑”五个层面,把这个知识点讲透,既保证新手能看懂,又能满足面试的深度要求。

Amon的专栏 780

Windows 11 安装 OpenClaw(龙虾):不用WSL、不用虚拟机、启动、使用、停止、卸载

本文详解 Windows 11 原生安装 OpenClaw(龙虾)全流程,无需 WSL 或虚拟机。涵盖环境配置、安全警示、模型接入(如通义千问)及技能初始化。提供启动、文件自动化操作、停止与卸载的完整指南,并附常见认证过期解决方案。助您快速部署本地 AI 智能体,实现电脑操作自动化,提升工作效率。

寒水馨 · 轻量级技术文档 · hanshuixin.org 904
上一篇: Windows11基于WSL2首次运行Openclaw,并对接飞书应用
下一篇: Windows原生安装更新OpenClaw2026.2.21版本后feishu插件问题
tinygone
博客等级 码龄13年 190粉丝 42原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值