HashMap 相关面试题及其解答

【硬核】HashMap最全面试题(附答案) 文章目录hashmap基础hashmap的nodehashmap的容量hashmap的负载因子hashmap的hash()算法HashMap里面的hash()返回值hashmap的数组+链表/树问题hashmap为什么引入链表为什么jdk1.8会引入红黑树呢hashmap为什么一开始不就使用红黑树?HashMap的底层数组取值的时候,为什么不用`取模`,而是&数组的长度为什么是2的次幂如果指定数组的长度不为 2次幂,就破坏了数组的长度是2次幂的这个规则吗?hashmap里面的源码HashMap的pu 阅读详情

Q:HashMap 的数据结构?
A:哈希表结构(链表散列:数组+链表)实现,结合数组和链表的优点。当链表长度超过 8 时,链表转换为红黑树。
transient Node[] table;


Q:HashMap 的工作原理?
A:HashMap 底层是 hash 数组和单向链表实现,数组中的每个元素都是链表,由 Node 内部类(实现 Map.Entry 接口)实现,HashMap 通过 put & get 方法存储和获取。

存储对象时,将 K/V 键值传给 put() 方法:①、调用 hash(K) 方法计算 K 的 hash 值,然后结合数组长度,计算得数组下标;②、调整数组大小(当容器中的元素个数大于 capacity * loadfactor 时,容器会进行扩容resize 为 2n);
③、i.如果 K 的 hash 值在 HashMap 中不存在,则执行插入,若存在,则发生碰撞;
ii.如果 K 的 hash 值在 HashMap 中存在,且它们两者 equals 返回 true,则更新键值对;
iii. 如果 K 的 hash 值在 HashMap 中存在,且它们两者 equals 返回 false,则插入链表的尾部或者红黑树中。

(JDK 1.7 之前使用头插法、JDK 1.8 使用尾插法)
(注意:当碰撞导致链表大于 TREEIFY_THRESHOLD = 8 时,就把链表转换成红黑树)

获取对象时,将 K 传给 get() 方法:①、调用 hash(K) 方法(计算 K 的 hash 值)从而获取该键值所在链表的数组下标;②、顺序遍历链表,equals()方法查找相同 Node 链表中 K 值对应的 V 值。

hashCode 是定位的,存储位置;equals是定性的,比较两者是否相等


Q:当两个对象的 hashCode 相同会发生什么?
A:因为 hashCode 相同,不一定就是相等的(equals方法比较),所以两个对象所在数组的下标相同,“碰撞”就此发生。又因为 HashMap 使用链表存储对象,这个 Node 会存储到链表中。


Q:你知道 hash 的实现吗?为什么要这样实现?
A:JDK 1.8 中,是通过 hashCode() 的高 16 位异或低 16 位实现的:(h = k.hashCode()) ^ (h >>> 16),主要是从速度,功效和质量来考虑的,减少系统的开销,也不会造成因为高位没有参与下标的计算,从而引起的碰撞。


Q:HashMap 的 table 的容量如何确定?loadFactor 是什么? 该容量如何变化?这种变化会带来什么问题?
A:①、table 数组大小是由 capacity 这个参数确定的,默认是16,也可以构造时传入,最大限制是1<<30;
②、loadFactor 是装载因子,主要目的是用来确认table 数组是否需要动态扩展,默认值是0.75,比如table 数组大小为 16,装载因子为 0.75 时,threshold 就是12,当 table 的实际大小超过 12 时,table就需要动态扩容;
③、扩容时,调用 resize() 方法,将 table 长度变为原来的两倍(注意是 table 长度,而不是 threshold)
④、如果数据很大的情况下,扩展时将会带来性能的损失,在性能要求很高的地方,这种损失很可能很致命。


Q:HashMap 的遍历方式及其性能对比
A:主要四种方式:
NO.1:for-each map.keySet() – 只需要K值的时候,推荐使用

for (String key : map.keySet()) {
     map.get(key);
}

NO.2:for-each map.entrySet() – 当需要V值的时候,推荐使用

for (Map.Entry<String, String> entry : map.entrySet()) {
    entry.getKey();
    entry.getValue();
}

NO.3:for-each map.entrySet() + 临时变量

Set<Map.Entry<String, String>> entrySet = map.entrySet();
    for (Map.Entry<String, String> entry : entrySet) {
        entry.getKey();
        entry.getValue();
}

NO.4:for-each map.entrySet().iterator()

Iterator<Map.Entry<String, String>> iterator = map.entrySet().iterator();
    while (iterator.hasNext()) {
        Map.Entry<String, String> entry = iterator.next();
        entry.getKey();
        entry.getValue();
}

Q:HashMap,LinkedHashMap,TreeMap 有什么区别?
A:HashMap 参考其他问题;
LinkedHashMap 保存了记录的插入顺序,在用 Iterator 遍历时,先取到的记录肯定是先插入的;遍历比 HashMap 慢;
TreeMap 实现 SortMap 接口,能够把它保存的记录根据键排序(默认按键值升序排序,也可以指定排序的比较器)


Q:HashMap & TreeMap & LinkedHashMap 使用场景?
A:一般情况下,使用最多的是 HashMap。
HashMap:在 Map 中插入、删除和定位元素时;
TreeMap:在需要按自然顺序或自定义顺序遍历键的情况下;
LinkedHashMap:在需要输出的顺序和输入的顺序相同的情况下。


Q:HashMap 和 HashTable 有什么区别?
A:①、HashMap 是线程不安全的,HashTable 是线程安全的;
②、由于线程安全,所以 HashTable 的效率比不上 HashMap;
③、HashMap最多只允许一条记录的键为null,允许多条记录的值为null,而 HashTable 不允许;
④、HashMap 默认初始化数组的大小为16,HashTable 为 11,前者扩容时,扩大两倍,后者扩大两倍+1;
⑤、HashMap 需要重新计算 hash 值,而 HashTable 直接使用对象的 hashCode


Q:Java 中的另一个线程安全的与 HashMap 极其类似的类是什么?同样是线程安全,它与 HashTable 在线程同步上有什么不同?
A:ConcurrentHashMap 类(是 Java并发包 java.util.concurrent 中提供的一个线程安全且高效的 HashMap 实现)。
HashTable 是使用 synchronize 关键字加锁的原理(就是对对象加锁);
而针对 ConcurrentHashMap,在 JDK 1.7 中采用 分段锁的方式;JDK 1.8 中直接采用了CAS(无锁算法)+ synchronized。

另外,HashMap 的键值对允许有null,但是ConCurrentHashMap 都不允许。


Q:HashMap & ConcurrentHashMap 的区别?

A:除了加锁,原理上无太大区别。

另外,HashMap 的键值对允许有null,但是ConCurrentHashMap 都不允许。


Q:为什么 ConcurrentHashMap 比 HashTable 效率要高?

A:HashTable 使用一把锁(锁住整个链表结构)处理并发问题,多个线程竞争一把锁,容易阻塞;

ConcurrentHashMap
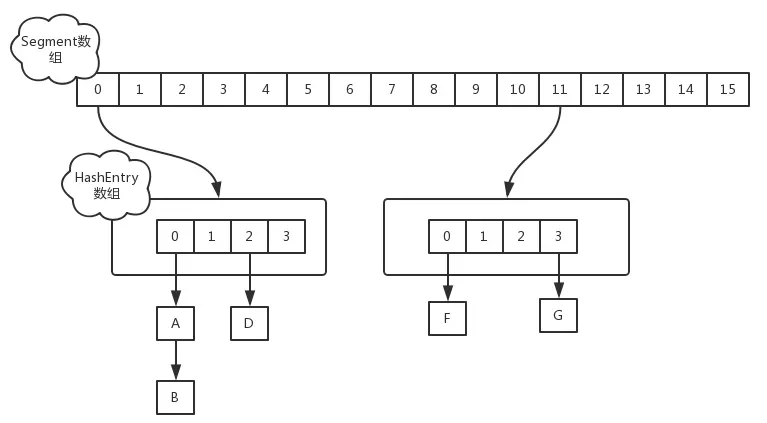
JDK 1.7 中使用分段锁(ReentrantLock + Segment + HashEntry),相当于把一个 HashMap 分成多个段,每段分配一把锁,这样支持多线程访问。锁粒度:基于 Segment,包含多个 HashEntry。
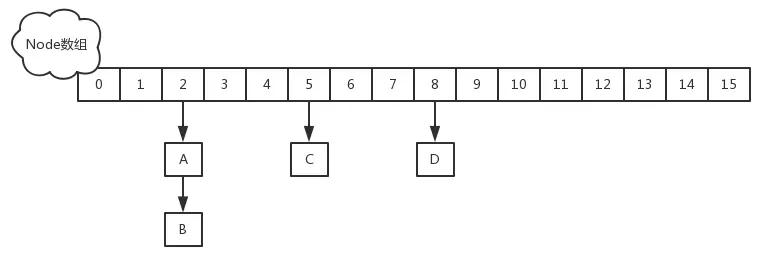
JDK 1.8 中使用 CAS + synchronized + Node + 红黑树。锁粒度:Node(首结点)(实现 Map.Entry)。锁粒度降低了。


Q:针对 ConcurrentHashMap 锁机制具体分析(JDK 1.7 VS JDK 1.8)?
JDK 1.7 中,采用分段锁的机制,实现并发的更新操作,底层采用数组+链表的存储结构,包括两个核心静态内部类 Segment 和 HashEntry。
①、Segment 继承 ReentrantLock(重入锁) 用来充当锁的角色,每个 Segment 对象守护每个散列映射表的若干个桶;
②、HashEntry 用来封装映射表的键-值对;
③、每个桶是由若干个 HashEntry 对象链接起来的链表。
JDK 1.8 中,采用Node + CAS + Synchronized来保证并发安全。取消类 Segment,直接用 table 数组存储键值对;当 HashEntry 对象组成的链表长度超过 TREEIFY_THRESHOLD 时,链表转换为红黑树,提升性能。底层变更为数组 + 链表 + 红黑树。

Q:ConcurrentHashMap 简单介绍?
A:
①、重要的常量:
private transient volatile int sizeCtl;
当为负数时,-1 表示正在初始化,-N 表示 N - 1 个线程正在进行扩容;
当为 0 时,表示 table 还没有初始化;
当为其他正数时,表示初始化或者下一次进行扩容的大小。

②、数据结构:
Node 是存储结构的基本单元,继承 HashMap 中的 Entry,用于存储数据;
TreeNode 继承 Node,但是数据结构换成了二叉树结构,是红黑树的存储结构,用于红黑树中存储数据;
TreeBin 是封装 TreeNode 的容器,提供转换红黑树的一些条件和锁的控制。

③、存储对象时(put() 方法):
1.如果没有初始化,就调用 initTable() 方法来进行初始化;
2.如果没有 hash 冲突就直接 CAS 无锁插入;
3.如果需要扩容,就先进行扩容;
4.如果存在 hash 冲突,就加锁来保证线程安全,两种情况:一种是链表形式就直接遍历到尾端插入,一种是红黑树就按照红黑树结构插入;
5.如果该链表的数量大于阀值 8,就要先转换成红黑树的结构,break 再一次进入循环
6.如果添加成功就调用 addCount() 方法统计 size,并且检查是否需要扩容。

④、扩容方法 transfer():默认容量为 16,扩容时,容量变为原来的两倍。
helpTransfer():调用多个工作线程一起帮助进行扩容,这样的效率就会更高。

⑤、获取对象时(get()方法):
1.计算 hash 值,定位到该 table 索引位置,如果是首结点符合就返回;
2.如果遇到扩容时,会调用标记正在扩容结点 ForwardingNode.find()方法,查找该结点,匹配就返回;
3.以上都不符合的话,就往下遍历结点,匹配就返回,否则最后就返回 null。


Q:ConcurrentHashMap 的并发度是什么?
A:程序运行时能够同时更新 ConccurentHashMap 且不产生锁竞争的最大线程数。默认为 16,且可以在构造函数中设置。当用户设置并发度时,ConcurrentHashMap 会使用大于等于该值的最小2幂指数作为实际并发度(假如用户设置并发度为17,实际并发度则为32)

HashMap知识点整理 HashMap详解: 1、底层实现概述 hashmap底层是使用数组+链表+红黑树实现的,初始容量为16,默认的负载因子0.75,每次扩容为原来的两倍。 2、 什么是哈希表?什么是哈希冲突?hashMap的原理? 哈希表是基于数组的一种存储方式.它主要由哈希函数和数组构成。 当要存储一个数据的时候,首先用一个函数计算数据的地址,然后再将数据存进指定地址位置的数组里面。这个函数就是哈希函数,而这个数组就是哈希表。 哈希表的优势在于:相比于简单的数组以及链表,它能够根据元素本身在第一时间,也就是时间复杂度为 阅读详情

相关推荐

热门HashMap面试题,解答思路与实践案例详解

HashMap的底层数据结构是一种高效的散列结构,通过数组、链表和红黑树的结合使用,以及动态扩容机制,实现了快速的数据存取和高效的空间利用。

用文字记录下每一个瞬间的感动和每一次思考的火花 11万+

史上最全Hashmap面试总结,51道附带答案,持续更新中...

点击上方关注 “终端研发部”设为“星标”,和你一起掌握更多数据库知识我历经两个工作日晚上总结了50道关于hashmap的面试题,我相信,下面将会是Hashmap最全的面试总结!HashMap的底层数据结构?  HashMap底层实现数据结构为数组+链表的形式,JDK8及其以后的版本中使用了数组+链表+红黑树实现,解决了链表太长导致的查询速度变慢的问题。   简单来说,Ha...

这个时代,作为程序员可能要学习小程序 2万+

HashMap的几个常考的[ 面试问题 ]和[ 回答思路,底层分析 ]

哈希桶的几个常考的面试问题、回答思路 、底层分析

CYK_byte的博客 904

关于HashMap的面试问题

目录 文章目录目录关于HashMap的面试问题1、HashMap的底层实现2、HashMap的数组的元素类型3、为什么要使用数组?4、为什么数组还需要链表?或问如何解决hash或[index]冲突问题?5、HashMap的数组的初始化长度6、HashMap的映射关系的存储索引index如何计算7、为什么要使用hashCode()? 空间换时间8、hash()函数的作用是什么9、HashMap的数组...

爱码者的博客 1037

stm32F103定时器使用方法

文章目录1、STM32的Timer简介2、普通定时器TIM2-TIM52.1 时钟来源2.2 计数器模式2.3 编程步骤3、程序源代码4、总结 1、STM32的Timer简介 STM32中一共有11个定时器,其中2个高级控制定时器,4个普通定时器和2个基本定时器,以及2个看门狗定时器和1个系统嘀嗒定时器。其中系统嘀嗒定时器是前文中所描述的SysTick,看门狗定时器以后再详细研究。今天主要是研究剩下的8个定时器。 其中TIM1和TIM8是能够产生3对PWM互补输出的高级登时其,常用于三相电机的驱动,时钟

weixin_43582209的博客 4515

超简单的视频换脸,效果相当不错!完全白嫖的技术,来自ComfyUI 官方客户端一键搞定!手把手教会你如何下载安装部署,而且教你如何使用。

如果你电脑上没有安装Visual Studio的C++桌面开发组件,还有Windows应用SDK C++模板,那么你需要自行去下载安装下【安装后默认界面会自动识别系统语言,当然如果你是中文繁体用户,那么你可以在 ComfyUI 的管理器里下载。】并把它放入根目录-models-insightface文件夹内 , 同时下载视频换脸工作流 【分享手把手教你视频换脸,本地部署,轻轻松松当上“电影主角”】,否则insightface无法被正常载入。) 这是换脸必备的工具 ,安装后重启;

TianLeung的博客 2850

Java 集合(List、Set、Map)

Collection Collection方法 注意contains(All),remove(All)这种,比较的是内容而不是地址(前提是你这个类重写了equals方法) equals:判断当前集合和形参元素是否相同(相同则返回True) retain:差集 toArray:集合转数组 Arrays.asLIst(待转换数组):数组转集合 List<String> list = Arrays.asList(new String[]{"ha", "hei", "ho"}); Syst...

qq_39579087的博客 283

从查表法到实时计算:SimpleFOC库中正弦函数优化的技术演进

本文深入探讨了SimpleFOC库v2.0.1版本中正弦函数优化技术的演进,从传统查表法到实时计算的创新实践。通过定点数优化、对称性利用和分段线性插值等关键技术,实现了在嵌入式电机控制中的高效三角函数计算,显著提升性能和资源利用率。

weixin_28273593的博客 452

hashMap 相关面试题

HashMap 作者:TinyDolphin 链接:https://www.jianshu.com/p/75adf47958a7 来源:简书 简书著作权归作者所有,任何形式的转载都请联系作者获得授权并注明出处。 hashmap 的主要参数都有哪些 桶容量 即数组长度:默认值16 1<<4。即在不提供有参构造器的时候,声明的桶容量 极限容量 hashmap 能承受的最大桶容量...

时光·漫步的博客 631

先进封装技术的一些优缺点探讨

半导体封装技术是半导体制造过程中的关键环节,它不仅保护了芯片免受物理损伤,还提供了电气连接和散热功能。随着技术的发展,出现了多种先进的封装技术,每种技术都有其特定的应用场景和优缺点。

阿拉伯梳子的专栏 2168

S7-1500与WinCC GroupDisplay组显示的高效配置指南

本文详细介绍了S7-1500 PLC与WinCC GroupDisplay组显示功能的高效配置方法,涵盖报警状态配置、WinCC端组显示控件设置及常见问题排查。通过实战案例和优化建议,帮助工程师快速掌握工业自动化项目中报警信息可视化的关键技术,提升生产线监控效率。

weixin_29292535的博客 440

受益匪浅!Java面试吃透这一篇就没有拿不到的offer

前言 Spring框架自2002年诞生以来一直备受开发者青睐,它包括SpringMVC、SpringBoot、Spring Cloud、Spring Cloud Dataflow等解决方案。有人亲切的称之为:Spring 全家桶。 很多研发人员把spring看作心目中最好的java项目,没有之一。所以这是重点也是难点,工作中必须会,面试时肯定考。那么,花费10分钟,由阿里一线架构师,带你梳理Spring框架相关知识。 微服务架构(Microservice Architecture)是一种架构概念,旨在通过将

m0_56830725的博客 109

rk3588上适配wifi模组aic8800

记录一下在rk3588上调试aic8800,调试分为Debian11以及Android12两个平台,这里主要是讲过程以及修改的过程,以补丁的形式来提供解决方法。在Debian11下主要通过配置设备树、编译驱动并自动加载固件完成调试,详细介绍了设备树修改、驱动编译脚本调整和驱动加载流程。

m0_60805802的博客 1002

2022金三银四面试总结-Java高级篇

Java面试总结 1.你用过哪些集合类? 大公司最喜欢问的Java集合类面试题 40个Java集合面试问题和答案 java.util.Collections 是一个包装类。它包含有各种有关集合操作的静态多态方法。 java.util.Collection 是一个集合接口。它提供了对集合对象进行基本操作的通用接口方法。 Collection ├List │├LinkedList │├ArrayList │└Vector │ └Stack └Set Map ├Hashtable

aa119101的博客 360

Orange3实战教程:文本挖掘---标注语料库地图

Oreange3,文本挖掘,标注语料库地图用于在二维投影中可视化、聚类文档,并用关键词进行标注。

err2008的专栏 817

多模态大模型:技术原理与实战 全球多模态大模型介绍

关键词:多模态大模型、深度学习、计算机视觉、自然语言处理、跨模态学习、迁移学习、人工智能随着人工智能技术的飞速发展,多模态大模型已经成为了当前AI领域最热门的研究方向之一。多模态大模型能够同时处理和理解多种类型的数据,如文本、图像、音频和视频等,这为AI系统在复杂场景下的应用提供了更加强大和灵活的能力。本文将深入探讨多模态大模型的技术原理,介绍其实战应用,并对全球主要的多模态大模型进行全面的介绍和比较。

AI天才研究院 4265

java基础-集合框架collection

一、集合与数组的对比 对多个对象进行存储操作 1、集合框架的概述 (1)集合、数组都是对多个数据进行存储操作的结果,简称java容器 说明:此时的存储,主要指的是内存层面的存储,不涉及到持久化的存储(.txt,.jpg,.avi,数据库等) (2)数组在存储多个数据方面的特点: a、数组一旦初始化后,其长度就确定了 b、定义数组需要指明数组的元素类型,一旦定义好之后,数组的元素类型也就是确定的,我们也就只能操作指定类型的数据了.eg:string[] arr,int[] arr1;(o

xuruhua的博客 280

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

Java 集合Map相关面试题

二叉树,顾名思义,每个节点最多有两个“叉”,也就是两个子节点,分别是左子节点和右子节点。不过,二叉树并不要求每个节点都有两个子节点,有的节点只有左子节点,有的节点只有右子节点。二叉树每个节点的左子树和右子树也分别满足二叉树的定义。Java中有两个方式实现二叉树:数组存储,链式存储。

个人博客,记录了本人学习的各种有趣的技术。 1695

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

HashMap详细解析,高频面试题解答,源码阅读

HashMap 详解 下面我首先抛出以下问题,让我们带着这些问题开始解析 HashMap: JDK8 中 HashMap 有哪些改动? JDK8 为什么要使用红黑树? 为什么重写对象的 Equals 方法,要重写 HashCode方法,跟 HashMap有关系吗? HashMap 是线程安全的吗? 遇到过 ConcurrentModificationException 异常吗?为什么会出现,如何...

码狐 605

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

HashMap底层实现原理及面试问题

①HashMap的工作原理 HashMap基于hashing原理,我们通过put()和get()方法储存和获取对象。当我们将键值对传递给put()方法时,它调用键对象的hashCode()方法来计算hashcode,让后找到bucket位置来储存值对象。当获取对象时,通过键对象的equals()方法找到正确的键值对,然后返回值对象。HashMap使用链表来解决碰撞问题,当发生碰撞了,对象将会储存...

疯一样的女子 27万+

HashMap相关面试题

这一段时间学习HashMap原理再根据相关资料提出的一些问题,进行的解答 推荐一篇文章:https://crossoverjie.top/2018/07/23/java-senior/ConcurrentHashMap/   JDK8中的HashMap有哪些改动? JDK7中的底层实现是数组+链表,JDK8中使用的是数组+链表+红黑树 JDK7中扩容时可能出现死锁,JDK8中通过算法优化...

yanguang1994的博客 1090

HashMap、HashTable及ConcurrentHashMap区别及相关面试题

HashMap、HashTable及ConcurrentHashMap区别及工作原理前言一、HashMap、HashTable及ConcurrentHashMap的区别二、HashMap的工作原理三、相关面试题四、结构图五、尊重原创 前言 第一次写博客,水平有限可能有理解不到位或理解错的地方。欢迎各位大神参与讨论或指正。 Map在工作中的使用频率较高,HashMap相关的问题在面试中也经常被问到...

weixin_43723151的博客 1475

Java面试宝典:HashMap底层原理

HashMap 基于数组+链表/红黑树实现,通过哈希函数(扰动高位优化分布)计算键的索引位置,用链表解决哈希冲突(Java 8 后链表超8转红黑树优化查询效率),动态扩容时容量翻倍并重哈希(负载因子默认0.75),非线程安全(多线程推荐 ConcurrentHashMap)。其设计核心是空间换时间,通过高效哈希计算、冲突管理和扩容策略实现 O(1) 平均操作复杂度,需注意键对象的 hashCode() 和 equals() 正确实现以保障性能。

笃行其道的博客 2181

Day27 手撕HashMap底层原理

1.手撕HashMap底层原理shCode() + 位运算​ JDK1.8 – 将key的hash值(int-32)分为高16位和低16位,两者进行异或的位运算,比之前更简洁区别2 - 插入链表的法则:​ JDK1.7 – 头插法​ JDK1.8 – 尾插法区别3 - 数据结构:​ JDK1.7 – 一维数组 + 单向链表​ JDK1.8 – 一维数组 + 单向链表 + 红黑树(目的:加上红黑树提高查询效率)JDK1.8版本的HashMap数据结构是如何切换的?

weixin_69595694的博客 1753
上一篇: 快速排序及其优化
下一篇: Servlet 相关问题及其解答
TinyDolphin
博客等级 码龄10年 36粉丝 163原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值