隐马尔科夫模型

【机器学习基础】HMM隐马尔可夫模型 目录 一 马尔可夫链 二 隐马尔可夫模型 2.1两个很重要的假设 2.2三类问题 三 参考文献 隐马尔可夫模型(Hidden Markov Model,HMM)是统计模型,它用来描述一个含有隐含未知参数的马尔可夫过程。其难点是从可观察的参数中确定该过程的隐含参数,然后利用这些参数来作进一步的分析,例如模式识别。 HMM模型解决的问题... 阅读详情

1.隐马尔科夫模型介绍

        隐马尔可夫模型是关于时序的概率模型,描述有一个隐藏的马尔科夫链随机生成不可观测的随机序列,在有各个状态生成一个观测而产生观测序列的过程。
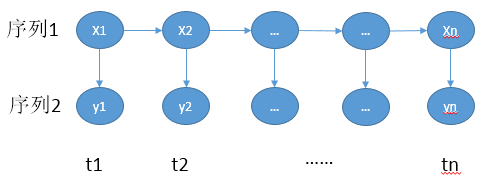
                               

                                                                                     图1

        隐马尔可夫模型可以简单的表示为图1所示的模型。序列1是随机生成的不可观测的隐序列,也成为状态序列;中在每一个t时刻,隐序列的每个状态xn可以生成对应的状态yn,所有的yn组成了序列2,是我们可以实际观测到的序列,称为观测序列。

        设Q是所有可能的状态序列,V是所有可能的观测序列,表示形式如下:


        N就表示所有的状态数,M就表示所有的观测数。

        序列1可以表示为:I=(i1,i2,⋯,iT),表示为长度为T的状态序列;序列2可以表示为,表示为状态序列对应的观测序列。

        对于时序的概念,肯定要有从一个时刻到下一时刻的改变,也就是状态转移;马尔可夫模型中只有隐状态的转移,状态集合为Q,一共有N个状态,所以可以将所有的状态转移情况表示为一个N×N的矩阵形式:


其中


        表示t时刻状态为qi,到t+1(下一时刻),状态为qj的概率。

        每一时刻的状态都会生成一个观测值,所以观测值是通过状态来确定的,而观测值之间没有必然的联系,那么我们就需要给出各个状态生成各个观测值的概率,状态有N个,观测值有M个,所有我们可以表示为一个N×M的矩阵:


        bj(k)表示一个概率,表示状态qj生成观测值vk的概率。

        整个序列我们需要一个开始的状态,就医t1时刻的Q集合中所有状态出现的概率:


        到这里我们可以总结一下:通过初始的状态向量π和状态转移矩阵A,可以生成状态序列,也就是可以确定隐藏的马尔科夫链,又通过状态生成观测值的概率矩阵B生成对应的观测序列。所以我们可以确定隐马尔科夫模型的三要素:


        λ表示隐马尔科夫模型的参数。

        隐马尔科夫模型是建立在两个基本假设之上的,就像贝叶斯模型是建立在条件相互独立之上的:

  1. 齐次马尔可夫性假设,即假设隐藏的马尔可夫链在任意时刻t的状态值依赖于前一时刻的状态,与其他时刻的状态以及观测无关,也与时刻t无关。
  2. 观测独立性假设,即假设任意时刻的观测只依赖于该时刻的马尔可夫链的状态,与其他观测及状态无关

       隐马尔可夫模型可以用于标注,这时状态对应着标记,标注问题是给定观测的序列预测其对应的标记序列。

       隐马尔可夫模型有三个主要的问题:

  1. 概率计算:给定模型λ=(A,B,π)和观测序列O=(o1,o2,…,oT),计算次观测序列出现的概率。
  2. 学习问题:已知观测序列O=(o1,o2,…,oT),估计参数模型λ=(A,B,π),使得在该模型下观测序列概率P(O|λ)最大,即用极大似然估计的方法估计参数。
  3. 预测问题:也称解码(decoding)问题。已知模型λ=(A,B,π)和观测序列O=(o1,o2,…,oT),求对给定观测序列条件概率P(I|O)最大的状态序列I=( i1,i2,…,iT))。即给定观测序列,求最有可能的对应的状态序列。

2.概率计算算法

        首先我们计算直接计算的方法。这个思路很简单,我们列出所有可能的状态序列,也就是NT种组合,然后对每种可能计算其观测概率,然后将所有得到的观测概率相加就是最终的概率。

        其中每一种状态序列的概率为:


        表示为一系列的状态概率相乘的形式,然后我们看对应状态序列下其对应的观测序列的概率


        然后两者同时出现的概率为:


        式1只是一个状态序列对应的概率公式,我们把所有的P(O,I|λ)加起来就是我们最终得到的概率。

        明显直接计算的方法是计算量很大的,后面介绍的前向-后向算法就相对计算量少了好多。

        首先介绍前向算法:

        在已知的观测序列中,每个时刻的观测值都是确定的,假设时刻s的观测值是os,那么此时我们可以通过观测概率得到时刻s所有状态is转化为os的概率;那么此时的状态是怎么来的呢,就是通过上一个时刻s-1转化过来的。我们知道状态转移矩阵是一个N×N的方阵,那么就是说所有状态都可以转化为某个状态,某个状态也可以转化为其他的所有状态(尽管某些转化只是概率是0罢了),所以时刻s的某一状态是有s-1时刻的所有状态概率决定的(求和),而对于s时刻,我们需要求所有状态的概率,以便为求s+1时刻的所有状态做准备。所以说这是一个地推的过程,递推过程如下:


        注意式2中,带t和t+1下标的是alpha,带ji下标的是状态转移矩阵中的状态转移概率a。看方括号中的内容,我们算的是状态i的概率,他用到的是上一时刻所有的状态的概率,所以我们需要在每一步的时候求出所有的状态的概率即 ,N是状态的个数;后面要乘以观测概率,因为如果不乘的话,就单单是状态转移的概率,这是个递推的过程,所以我们需要在每一步上乘以观测概率。最终我们可以得到T时刻所有的状态的概率。


        式3表示T时刻所有状态的概率之和,就是最终的概率。

        其实后向算法是将前向算法倒着算,下面直接给出算法步骤:


        比较难理解的是第2步,如下图所示


                                           图1

        第2步中等式左边的是图1中左边的βt(i),等式右边的表示左右的βt+1(j)的和。所以对于每个时刻,参考前向算法,我们要计算每一时刻的βt1~βtN,知道计算到t=1时刻,然后就是步骤3相加得出最终的概率。

3.学习算法

学习算法可以分为监督学习算法和非监督学习算法(Baum-Welch)算法。监督学习方法比较容易理解,因为他直接是用频率之比代替概率,而Baum-Welch算法是用到了E-M算法,就相对比较抽象了。

先看监督学习算法。假设已给训练数据包含S个长度相同的观测序列和对应的状态序列{(O1,I1), (O2,I2),…, (Os,Is)},那么可以利用极大似然估计法来估计隐马尔可夫模型的擦护。方法如下:

        (1)转移概率aij的估计

设样本中时刻t处于状态i时刻t+1转移到状态j的频数为Aij,那么状态转移概率aij的估计是:


       (2)观测概率bj(k)的估计

        设样本中状态j应观测为k的频数是Bjk,那么状态为j观测为k的概率b j(k)的估计是


         (3)初始状态概率πi的估计为s个样本中初始转台为qi的频率

        这里用频率代替概率了,所以还是比较容易理解的。

        Baum-Welch算法是用到了E-M算法,我也没深入了解,所以想深入了解的可以自己查阅资料,或者看李航《统计学习方法》中的推理步骤。我只给出一个我自己的大概的了解:我们要选取初始值(E-M算法也是要有初始值的),然后通过每个参数的表达式,计算出新的值,得到一个中间的模型参数,然后再用这个中间的模型参数继续迭代计算,直到满足为止,下面给出迭代公式:


4.预测算法

预测算法就是给我们模型参数和观测序列,让我们预测最优可能出现的状态序列。有两种算法:近似算法和维特比算法。

近似算法的想法是,在每个时刻t选择在该时刻最有可能出现的状态it,从而得到一个状态序列I=(i1, i2, …,it),将它作为预测的结果。当前概率的计算方式如下:


怎么理解式3。αt(i)是前向概率,βt(i)是后向概率,为什么两者相乘呢?我的理解是,当前的状态是和前后状态都有关系的,因为要从前一个状态转移到当前状态,当前状态也是要转化为下一状态,在给定的观测序列下,当前状态的前后状态都是对其有限制的,所以要考虑其前向和后向概率。我们要计算当前时刻的最大概率,那就计算出所有状态的概率,然后挑出最大的那个即可:


从而得到状态序列I=(i1, i2, …,it)。

近似算法的优点就是计算简单,其缺点是不能保证预测的序列状态整体是最有可能的状态序列,因为预测的状态序列可能有实际不发生的部分。事实上,上述方法得到的状态序列中有可能存在转移概率是0的相邻状态,即对某些i,j,aij=0时。尽管如此,近似算法仍然是有用的。

近似算法是从时间点来考虑的,而维特比算法是从整个路径层面来考虑的。

维特比算法是根据动态规划求概率最大的路径,如果最优路径在时刻t通过结点it,那么这一路径从结点it到终点iT的所有可能中必须是最优的,所谓的最优也就是到达终点的概率最大的。依据这一原理,我们只需要从时刻t=1开始,递推地计算在时刻t状态为i的各条部分路径的最大概率,纸质得到时刻t=T状态为i的各条路径的最大概率。时刻t=T的最大概率即为最优路径的概率P,最优路径的中街店iT也同事得到。只有为了找出最优路径各个节点,从中街店iT开始,由后向前逐步求得i(T-1),…,i1,得到最优路径I=(i1, i2, …,it)。

我们用:表示定义在时刻t状态为i的所有单个路径中概率最大值,其递推公式如下:


定义概率最大的路径第t-1个结点的取值为:


下面是算法的过程:


        怎么理解这个算法呢?我们知道每一时刻,我们都要对所有状态计算一个生成该状态的对应的概率,这个状态是可能有上一时刻所有状态中任意一个状态转移过来的,我们在计算过程中需要做的就是:记录时刻t中,上一时刻所有状态转移到当前时刻状态为i中的最大概率最大的那个状态,及其对应的那个最大概率,作为当前状态i的概率。假设t-1有三个状态1,2,3,他们对应的概率是0.2,0.3,0.1,我们要求的是t时刻他们都转化为1的概率,他们转化为1的概率分别为0.2,0.1,0.5,所以

        1->1:P=0.2×0.2=0.04

        2->1:P=0.3×0.1=0.03

        3->1:P=0.1×0.5=0.05

        所以我们要记录,表示t时刻状态1的概率为0.05,我的上一状态是3。这样依次计算,直到T时刻,得到生成对应状态的最大概率,及其对应的上一时刻。由于上一时刻我们计算了所有状态的相对最大概率,及其上上时刻的对应状态,依次类推,就可以倒退得到整个路径上的状态了,就是我们的预测状态。

隐马尔科夫模型一(概念理解) 前言 由于前一段时间在看CTC论文,里面用到了HMM中的前向后向算法,推公式的时候·一脸懵逼,所以又来学习HMM的思想,所以写篇博客做个笔记。本部分博客分为两篇,第一篇主要介绍一些基本的概念和思想,第二篇介绍理论的推导。博客的内容主要是基于<<统计学习方法>>以及其他的一些博客 模型概念 隐马尔可夫模型:隐马尔科夫模型是关于时序的概念模型,描述了由一个隐藏的马尔科... 阅读详情

相关推荐

隐马尔科夫模型(HMM)择时应用的量化策略

HMM模型隐马尔科夫模型(HMM)择时应用的量化策略。 仅为研究学习使用, 不作为任何投资策略建议。文章内容从各处整理汇总而成, 感谢各位大神分享。  具体策略代码均调试通过。一、从大奖章讲起Renaissance & Medallion(文艺复兴科技和大奖章)量化圈都非常熟悉了。Simons一群物理学家和数学家碰撞在一起,1989年到2008年的yearly return达到35.6%。...

学习机器学习 1万+

【统计学习方法-李航-笔记总结】十、隐马尔可夫模型

本文是李航老师《统计学习方法》第十章的笔记,欢迎大佬巨佬们交流。 主要参考博客: https://www.cnblogs.com/YongSun/p/4767667.html https://www.cnblogs.com/naonaoling/p/5701634.html https://www.cnblogs.com/fxjwind/p/3949993.html 主要内容: 1. ...

zl3090的博客 2211

隐马尔科夫模型总结

1.概念 状态序列: 隐藏的马尔科夫链随机生成的状态序列,称为状态序列(state sequence) 观测序列 每个状态生成一个观测,而由此产生的观测的随机序列,称为观测序列(obeservation sequence) 马尔科夫模型: 马尔科夫模型是关于时序的概率模型,描述由一个隐藏的马尔科夫链随机生成不可观测的状态随机序列,再由各个状态生成一个观测而产生观测随机序列的过程。 2 形式定义

文行知的专栏 4119

隐马尔可夫模型(hidden Markov model,HMM)

----读李航《统计学习方法》总结 1、定义 定义:隐马尔可夫模型是关于时序的概念模型,描述由一个隐藏的马尔可夫链随机生成不可观测的【状态随机序列】,再由状态随机序列生成一个观测从而产生【观测随机序列】的过程。 需要了解的概念: 隐马尔可夫模型由初始概率分布、状态转移分布以及观测概率分布确定。 所有可能的状态的集合 , N是可能的状态数 所有可能的观测的集合 , M是可能的观测数 长度为T的状态序列 , 对应的观测序列 状态转移概率...

南来 963

机器学习算法(十七):隐马尔科夫模型(HMM)

隐马尔科夫模型一(概念理解):https://blog.csdn.net/gzj_1101/article/details/79955340 有趣的隐马尔科夫模型:https://baijiahao.baidu.com/s?id=1601390969712055408&wfr=spider&for=pc ...

weixin_39910711的博客 7024

隐马尔科夫模型(HHM)原理详解

文章目录一、马尔科夫链二、隐马尔科夫模型原理三个基本问题三、概率计算1. 前向算法2. 后向算法3. 常用的概率计算三、实际应用四、模型训练(学习)1. 监督学习2. Baum-Welch算法五、模型预测维特比(Viterbi)算法 隐马尔科夫模型(Hidden Markov Model,HHM)是一种有向图模型,属于生成式模型,考虑联合概率分布。 HHM有两组变量,第一组是状态变量I={i1,i...

sgyuanshi的博客 1万+

隐马尔科夫模型基础

隐马尔科夫模型基础

joey_hu0922的博客 9109

隐马尔科夫模型练习

import numpy DTYPE='float32' #学习问题 def forward(a,b,o): num_states_hidden=a.shape[0] alpha=numpy.ones((num_states_hidden,1),dtype=DTYPE) tem_alpha=numpy.zeros((num_states_hidden,1),dtype

万德1010的博客 1727

隐马尔可夫模型(HMM)

基于上一篇所讲到的马尔可夫模型,现在难度加大了,我们观测不出天气的状态,只能通过海藻的状态来推断出天气的状态。海藻的状态有四种,分别是Dry(干燥的)、Dryish(稍干的)、Damp(潮湿的)、Soggy(湿漉漉的)。海藻的状态是可观测的,那它就是观测状态,天气信息看不到就是隐藏状态。注:观测状态和隐藏状态并不是一 一对应的。

weixin_47786612的博客 5282

时序模型:隐马尔科夫模型(HMM)

隐马尔科夫模型的定义 隐马尔科夫模型(hidden Markov model,HMM)描述由一个隐藏的马尔科夫链随机生成不可观测的状态随机序列,再由各个状态生成一个观测从而产生观测随机序列的过程。隐藏的马尔科夫链随机生成的状态的序列,称作状态序列(state sequence);每个状态生成一个观测而产生的观测的随机序列,称为观测序列(observation sequence)。序列的每一个位置又可以看作是一个时刻。 隐马尔科夫模型成立的两个基本假设 隐马尔科夫模型解决的三个基本问题 观测序列出现概率计算

xunyishuai5020的博客 2710

使用隐马尔科夫模型(HMM)进行语音识别

         在实验室待了一段时间了,在实验室的报告及小组会议中,深刻的体会到了HMM算法 ,SVM等的重要性.         这几天翻译了一篇使用隐马尔科夫模型(HMM)进行语音识别的论文的部分.           这篇论文是通过google的学术搜索搜到的,通过在互联网上的查找,发现这篇论文引用率很高。(排在google的第一位),并且没发现对其的汉语翻译。或许这篇是对该文的第

caohao2008的专栏 3万+

基于隐马尔科夫模型的道路匹配

随着导航定位、移动互联网等技术的快速发展,手机、车载定位装置等设备都可以进行地理空间数据采集。这些不同类型的地理空间数据往往能反映出某种规律。以时空轨迹为例,这些新形式的泛在地理空间数据,能够反映个体行为的时空特征,同时大量同类群体的共同模式也可以反映群体特征。其中,车载定位装置能够实时获取当前车辆的位置信息,成为时空轨迹大数据的重要数据来源。 地图匹配是时空轨迹数据处理分析中的关键技术,能够解决将轨迹数据匹配到道路网络的问题,从而基于轨迹点还原真实轨迹。如何能够快速、有效地实现地图匹配,成为轨迹数据分析的

SuperMap技术控 5208

电机驱动技术中关于磁阻转矩生成的理解

正交在物理学和数学中指的是两个方向或两个向量之间的夹角为90°(直角)。在图中,当气隙磁场的轴线与转子轴线的夹角为90°时,我们称它们为正交。转子磁极的方向。通常由转子的磁极中心指向另一极的连线表示。转子轴线用图示中的d 轴表示。通过对定子、转子、气隙磁场、磁力线的理解,我们可以清晰地分析不同角度下电磁转矩的方向。这种分析不仅有助于电机的理论学习,还能为实际设计提供重要参考。掌握这些基础知识后,可以更好地理解电机工作原理及优化其性能。

weixin_48327795的博客 2074

隐马尔科夫模型(HMM)

HMM算法学习笔记

weixin_45234741的博客 2821

无人机核心部件解析:从机架到飞控的全面指南

本文全面解析无人机的核心部件,从机架材质选择到飞控系统调参,提供专业指南。重点介绍碳纤维机架、无刷电机搭配、锂聚合物电池管理及飞控传感器配置,帮助读者掌握无人机组装与优化的关键技术,适用于航拍、测绘、农业植保等多种应用场景。

weixin_30872499的博客 466

【EB-02】TC397 Tresos 最小工程配置

主要设置McalLibPublishedInformation 参数,会根据ResourceM配置的芯片自动加载。可以看到再工程目录中生成了output文件夹,里面由这些模块生成的头文件,编译脚本和epc文件。如果选择生成swcd,可以生成xxx_Bswmd.arxml给别的工具使用。如果没有Error和Problems就可以点击生成代码。点击工程校验看看工程是否由错误。

libuping2023的博客 324

HMM隐马尔科夫模型及股票预测

1 马尔科夫链 隐马尔科夫模型是自然语言处理中很重要的一种算法。在此之前,我们首先给大家介绍马尔科夫链。马尔科夫链,因安德烈·马尔科夫得名,是指数学中具有马尔科夫性质的离散事件的随机过程。在给定当前知识或信息的情况下,过去对于预测未来是无关的。每个状态的转移只依赖于之前的N个状态,这个过程被称为1个n阶的模型。其中n是影响转移状态的数目。最简单的马尔科夫过程就是一阶过程,每一个状态的转移只依赖于其之前的哪一个状态。用数学的表达式表示就是如下所示: 假设天气服从马尔科夫链: 转移矩阵 那么,从今天开始,

HUXINY的博客 8279

YOLO系列算法改进 | C3k2改进篇 | 融合MambaOut轻量化门控架构 | 纯卷积实现超越Mamba性能的同时兼顾极致轻量化与边缘部署效率 | CVPR 2025

YOLO系列算法改进 | C3k2改进篇 | 融合MambaOut轻量化门控架构 | 纯卷积实现超越Mamba性能的同时兼顾极致轻量化与边缘部署效率 | CVPR 2025 (以YOLOv26最新目标检测模型为基础,利用C3k2_MambaOut创新模块进行改进)

2502_91881744的博客 224

隐马尔科夫模型前向后向算法

本文是自己学习隐马尔科夫模型的一个总结,为了自己以后方便查阅,也算作是李航老师的《统计学习方法》的一个总结,若有疑问,欢迎讨论。推荐阅读知乎上Yang Eninala写的《如何用简单易懂的例子解释隐马尔可夫模型?》,写的非常好。我会联系两者,来作为自己的一篇学习笔记。隐马尔可夫模型: 隐马尔可夫模型是关于时序的概率模型,描述由一个隐藏的马尔可夫链随机生成不可观测的状态随机序列,再由各个状态生成一个

Abner 5054

五步教你用GPT-5画出国自然技术路线图!轻松节省80%画图时间(附AI提示词)

七哥给大家推荐的高校都在用的AI平台——高级学术版专业应用平台,集成了ChatGPT、Claude、Gemini、Grok等Al大模型的PLUS版本平台,包括 ChatGPT-5、4o、o3、4.1、4.5、Gemini 2.5 Pro、Claude 3.7、Claude 4、DeepSeek 满血版、Grok 3 、Grok 4等原生线路,还有国际主流的GPTs学术应用,可以辅助大家高效完成科研和学术写作任务,当然撰写硕博论文,课题、职称论文、国社科、国自然基金本子也是手拿把掐。

智能AI让学术科研更容易 1495

宽压 DC⇌DC 也能“随心所欲”——全桥 LLC 混合控制硬核拆解

硬件派 vs. 软件派:多电平是“器件堆砌”,混合控制是“算法魔改”。预算紧 → 先搞软件。仿真别嫌烦:PLECS 把两条曲线扫透,切换点、死区、φ 都调到波形平滑再上板。温升留 20 ℃ 余量:车规≥125 ℃,实验室测 105 ℃ 就算危险,别玩极限。

weixin_43199439的博客 926

初学者也能看懂的隐马尔科夫模型介绍

点击上方“小白学视觉”,选择加"星标"或“置顶”重磅干货,第一时间送达隐马尔科夫模型是(hidden Markov model,HMM)是可用于标注问题的统计学习模型,描述由隐藏的马尔科夫链随机生成观测序列的过程。隐马尔可夫模型(hidden Markov model,HMM)是时间序列的概率模型,常用于词性标注,语音识别,文本分析等领域。HMM是基于马尔科夫链进行标注的...

小白学视觉 2844

22、硬件工程师笔试面试——电机(2025版本)

例如,B级绝缘的电机可以承受的最高温度为130℃,而H级绝缘的电机可以承受高达180℃的温度。同时,也要考虑电机的成本和控制系统的复杂性。电机的选择取决于其应用的具体要求,包括所需的功率、速度、扭矩、效率、成本和工作环境等。根据电动机保护配置原则,为电机配置适当的保护,如过负荷保护、缺相保护、逆相保护、接地漏电保护、堵转保护、相不平衡保护、短路保护、过电压保护、低电压保护、过热保护等。根据安培环路定理,电流和磁场的相互作用会在电机的转子上产生力,这些力作用于转子上,使其绕轴旋转,从而产生转矩。

XU157303764的博客 3537

隐马尔科夫模型HMM

学习问题: 1. 什么是马尔科夫过程 2. 什么是隐马尔科夫模型 3. 原理是什么什么是马尔科夫过程马尔科夫过程是一系列的事件链,已知目前的状态下“现在”,未来的情况不依赖与过去发生的事件。这种事件链,就是一个马尔科夫过程。 就比如一笔投资,一旦投入未来的投资收益只与现在的投资状态,和未来的收益可能性有关,而与过去的投资收益没有关系,所以投资也是一个马尔科夫过程。什么是隐马尔科夫模型隐马尔科

qq_20741305的博客 346

Python 爬虫实战:微信搜一搜内容深度爬取(含搜索结果解析与企业级架构设计)

在信息爆炸的时代,微信搜一搜已成为海量信息获取的重要入口。无论是个人知识探索,还是企业舆情监控,掌握微信搜一搜内容的深度爬取能力具有巨大价值。本文将从基础原理到企业级实现,全面解析微信搜一搜爬虫的开发过程。

yansideyucsdn的博客 2455

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

上一篇: 提升树算法,梯度提升(GBDT)
下一篇: Spark中RDD,DataFrame,DataSet简单介绍
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值