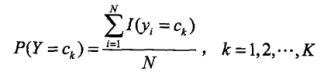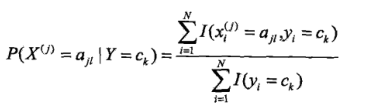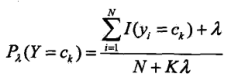朴素贝叶斯法

朴素贝叶斯算法 朴素贝叶斯优缺点:优点:在数据较少的情况下仍然有效,可以处理多类别问题缺点:对于输入数据的准备方式较为敏感,由于朴素贝叶斯的“特征条件独立”特点,所以会带来一些准确率上的损失。 阅读详情
  1. 概述

    朴素贝叶斯法是基于贝叶斯定理与特征条件独立假设的分类方法。对于给定的训练数据集,首先基于特征条件独立假设学习输入/输出的联合概率分布;然后基于此模型,对于给定的输入x,利用贝叶斯定理求出后验概率最大的输出y。、

上面的一段话是李航《统计学习方法》中的一段话,中间涉及到了一些基本概念,是贝叶斯方法的前提。

条件独立假设:这是贝叶斯方法的前提条件,

条件概率公式:

P(B|A) = P(AB)/P(A),这个是条件概率公式,P(AB)是联合概率。

贝叶斯公式:

P(A|B) = (P(B|A)P(A))/P(B)

    贝叶斯公式是通过条件概率推导过来的。上面的条件概率也可以写成P(A|B) = P(AB)/P(B),从这里我们可以看出,条件A和B是相对的,这里假设A是我们要的分类的结果,B是条件,联合两个条件概率,我们得到上面的贝叶斯公式:在B的情况下,结果是分类A的概率,在这种情况下,我们成P(A)为先验概率,P(A|B)称为后验概率;所以贝叶斯公式就是我们熟悉的由先验概率求后验概率的公式;贝叶斯公式中分子是P(B|A)p(A),结合上面的条件概率公式,可知分子是联合概率,所以我们要通过先验概率和条件概率先求出联合概率,然后在求其后验概率;而P(A)和P(B|A)都是我们可以通过样本得出来的。贝叶斯的学习过程,也就是通过样本数据计算P(A)和P(B|A)的过程。

    这个分母是什么,简单的看就是:是条件B的概率,在贝叶斯公式中,我们就是要通过条件B来求A,即对应的分类,所以这个结果是变量,B相对是不变的;更通俗的说是在条件B下计算各种分类的概率,所以这个时候对于所有分类,分母是不变的;用公式解释如下,即全概率公式:

,将其带入上面的贝叶斯公式得到更详细的贝叶斯公式:

,即在条件B下,分类结果是Ai的概率。

  1. 模型

上面介绍的是贝叶斯方法的基本理论知识,下面就是将其推广到实用的层面。

我们前面也说了贝叶斯方法是建立在条件独立假设之上的,我们这里用X表示条件,Y表示结果(我觉得将X理解为自变量,Y理解为因变量),对于条件X可能是有多个属性组成的,而这些个条件都是相互独立的;即如果判断一个水果是苹果还是梨,我们可以通过颜色和形状判断,那么这个颜色和形状是相互对立互不影响的。所以具体的,条件独立性假设公式为:
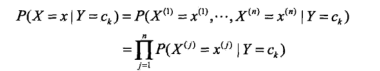
将上面的贝叶斯公式换成自变量X和因变量Y,

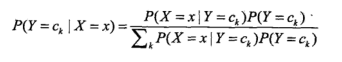
然后再讲独立性假设公式带入贝叶斯公式:
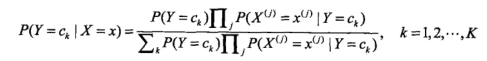
这个就是我们最终得到的计算公式。通过概述中,我们可以知道,对于所有的分类分母都是相同的,所以我么只计算分子部分就可以了。所以最终的分类器如下

arg表示取概率最大的那个分类。

  1. 极大似然估计、学习分类算法

这里的估计是用频率代替概率,所以先验概率P(Y=),的极大似然估计是:

分子是所有分类为ck的数量,N是所有样本的数量。


在多特征的样本里,每个x有多个特征(形状和颜色),而每个特征又有多个取值(如颜色:红色、白色、灰色,青色。。。。)。设第j个特征可能取值的集合为{,,…,,},条件概率P(=|Y=)的极大似然估计是:

分子是分类结果是ck的总数,分子式分类结果是ck中特征值是的个数。

学习分类算法的过程就是计算所有特征的所有取值的条件概率,以及所有的先验概率,最后对于需要分类的样本(给定的测试数据),计算:
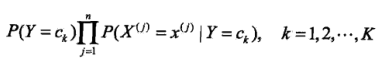
比较结果最大的那个分类,就是我们估计的测试样本的分类。

  1. 贝叶斯估计

贝叶斯方法存在一个缺陷:如果如果某个分类下,某个特征的某个取值,对应的样本数量是0,那么它对应的条件概率就是0,那么最后进行分类的时候,概率就成了0,这样明显是不合适的,就会使分类出现偏差,所以为了解决这个偏差,采用贝叶斯估计,具体条件概率的贝叶斯估计是:
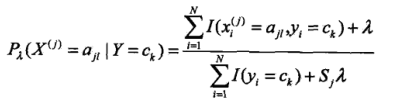
我们可以看到是在贝叶斯方法的条件概率的分子分母上都加上了常数项,其中λ>=0,当λ时0的时候,就回归成了我们前面说的极大似然估计了。取λ=1,成为拉普拉斯平滑(拉普拉斯修正)。

所以,对于所有的条件概率都有:
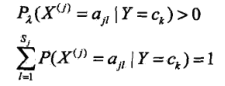
其中的是每个特征中,特征值的个数。

同理先验概率的贝叶斯估计如下:

K是分类种类数,N是样本总数。


最后,这里只是结合李航的《统计学习方法》,自己做了一些总结和自己的理解,只是做了理论的推导,具体还要结合实际应用才能更加深入一步了解啊。不过贝叶斯方法应该最多还是用在文本分类。

基于Transformer的CFD代理模型:AeroTransformer原理、实现与优化 计算流体动力学(CFD)仿真是航空航天、汽车工程等领域的关键技术,但其高计算成本限制了设计优化效率。代理模型通过机器学习方法学习输入参数与流场输出间的映射关系,能实现秒级预测,大幅加速仿真流程。Transformer架构凭借其全局注意力机制,能有效建模流场中的长程物理关联,克服了传统卷积神经网络在捕捉全局依赖上的局限。通过预训练与微调策略,模型能先在大规模多样化数据集上学习通用流体规律,再针对特定任务快速适配,显著提升了小样本下的泛化能力与工程实用价值。AeroTransformer项目正是这一技术路线的典 阅读详情

相关推荐

DNF单机版搭建全攻略:从零开始到局域网联机(含常见问题解决)

本文提供详细的DNF单机版搭建指南,从环境配置到局域网联机设置,涵盖服务端安装、数据库配置及常见问题解决方案。适合新手和有经验的玩家,帮助快速搭建专属游戏服务器,重温经典游戏体验。

weixin_30832143的博客 846

机器学习算法总结之朴素贝叶斯法

写在前面 贝叶斯分类是一类分类算法的总称,这类算法均以贝叶斯定理为基础,故统称为贝叶斯分类。而朴素朴素贝叶斯分类是贝叶斯分类中最简单,也是常见的一种分类方法。它是基于贝叶斯定理和特征条件独立假设分类方法。对于给定训练集,首先基于特征条件独立性的假设,学习输入/输出联合概率(计算出先验概率和条件概率,然后求出联合概率)。然后基于此模型,给定输入x,利用贝叶斯概率定理求出最大的后验概率作为输出y。朴...

Kaiyuan_sjtu的博客 4150

SAP财务模块必看:BAPI_ACC_DOCUMENT_POST扩展字段全攻略(含FIBF配置)

本文详细解析了SAP财务模块中如何利用BAPI_ACC_DOCUMENT_POST的EXTENSION1参数扩展自定义字段。文章从需求分析入手,对比了传统增强与BTE(业务交易事件)两种技术路径,并重点提供了基于FIBF配置的完整实战指南,包括数据结构理解、函数模块开发及配置步骤,帮助ABAP开发者和财务顾问高效、可维护地实现如WBS元素、税务代码等字段的灵活传递。

weixin_29290963的博客 395

机器学习算法(7)—— 朴素贝叶斯算法

朴素贝叶斯是一种分类算法,经常被用于文本分类,它的输出结果是某个样本属于某个类别的概率。(1)优点朴素贝叶斯模型发源于古典数学理论,有稳定的分类效率对缺失数据不太敏感,算法也比较简单,常用于文本分类分类准确度高,速度快(2)缺点由于使用了样本属性独立性的假设,所以如果特征属性有关联时其效果不好需要计算先验概率,而先验概率很多时候取决于假设,假设的模型可以有很多种,因此在某些时候会由于假设的先验模型的原因导致预测效果不佳;

hu_wei123的博客 9582

格(Lattice)基础(一)

有关格的基础概念,和相关的格难题

Amire0x的小乐园 5698

Ollama安装教程

Ollama 是一个开源的大语言模型(LLM)部署工具,专为在本地机器部署和运行大模型而设计,通过简单的命令就可以在本地快速运行大模型(如DeepSeek、Llama、Gemma、QWQ等)。非常适合开发者、研究人员以及对数据安全和隐私有较高要求的企业和用户

学习AI应用开发,分享AI干货、获取最新AI咨询 3847

【朴素贝叶斯】深入浅出讲解朴素贝叶斯算法(公式、原理)

朴素贝叶斯(Naive Bayes)是一种简单经典的分类算法,它的经典应用案例为人所熟知:文本分类(如垃圾邮件过滤)。条件概率:记事件A发生的概率为P(A),事件B发生的概率为P(B),则在B事件发生的前提下,A事件发生的概率即为条件概率,记为P(A|B)。

程序星空实验室 5万+

ROS+Gazebo仿真入门:用TurtleBot3模拟扫地机器人全流程

本文详细介绍了如何利用ROS和Gazebo仿真平台,以TurtleBot3 Waffle Pi模型为核心,从零搭建并运行一个虚拟扫地机器人的全流程。内容涵盖仿真环境搭建、世界与机器人模型解析,并重点演示了SLAM建图、自适应蒙特卡罗定位以及全局与局部路径规划等核心算法实战,为机器人算法开发与验证提供了高效、低成本的解决方案。

sre5engineer的博客 1087

统计学习方法第四章——朴素贝叶斯法

基本方法7.2.1 基础版实现7.2.2 数值计算方法(进阶版)

zhuzaiyebol的博客 577

OceanSim: 基于Isaac Sim GPU 加速水下机器人感知仿真框架

OceanSim 采用先进的基于物理的渲染技术,对水下视觉和声学传感器进行精确建模。与其他模拟引擎相比,OceanSim 的渲染速度要快得多。作为 NVIDIA Issac Sim 的扩展,OceanSim 采用了多功能设计。通过融入快速发展的 NVIDIA Omniverse 生态系统,我们的模拟器自然而然地在机器人学习和水下机器人技术之间架起了一座桥梁,从而促进了水下应用中体现型人工智能技术的开发和部署。OceanSim 将以开放源码的方式提供,使研究界能够以合作的模式作出贡献。

机器人控制与仿真应用 2049

基于STM32L4XX 、HAL库的SGM452B数字温度传感器驱动应用C语言程序设计

SGM452B_RESOLUTION_12BIT = SGM452B_CONFIG_R1 | SGM452B_CONFIG_R0 /* 12位分辨率,精度0.0625°C,转换时间200ms */SGM452B_RESOLUTION_11BIT = SGM452B_CONFIG_R1, /* 11位分辨率,精度0.125°C,转换时间100ms */SGM452B_RESOLUTION_10BIT = SGM452B_CONFIG_R0, /* 10位分辨率,精度0.25°C,转换时间50ms */

PP_Cottage的博客 327

4 朴素贝叶斯法

文章目录4.1 朴素贝叶斯法的学习与分类4.1.1 基本方法 朴素贝叶斯法是基于贝叶斯定理与特征条件独立假设的分类 方法 对给定的训练数据集,先基于特征条件独立假设学习输入输出的联合 概率分布; 然后基于此模型, 对给定输入xxx,用贝叶斯定理求出后验概率最大的输出yyy. 朴素贝叶斯法实现简单,学习与预测的效率都很高,是一种常用的方法   本章朴素贝叶斯法, 包括朴素贝叶斯法的学习...

fgh123的博客 503

微信删除的聊天记录怎么恢复(2024年最新攻略合集)

随着微信对我们生活中方方面面的渗透,微信已然从一款简单的社交软件过渡成为现时代的一种生活方式,而微信中的聊天记录就是我们和朋友之间历程的最好证明。对此,今天我们来聊聊微信删除的聊天记录怎么恢复的问题。

m0_70960708的博客 944

【机器学习】朴素贝叶斯法

本文介绍了朴素贝叶斯分类方法,包括其理论基础、参数估计和Python实现。朴素贝叶斯基于贝叶斯定理和特征条件独立假设,通过极大似然估计或贝叶斯估计(拉普拉斯平滑)计算先验概率和条件概率,输出后验概率最大的类别。文章详细推导了两种参数估计方法,并通过实例展示了从训练到预测的完整过程。最后提供了Python代码实现,包含概率计算、分类预测和可视化功能,对比了极大似然估计与贝叶斯估计的结果。该方法实现简单、效率高,但条件独立性假设可能影响分类准确率。

2401_84149564的博客 1541

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

朴素贝叶斯法详解

文章目录朴素贝叶斯法的学习和分类基本方法后验概率最大化的道理朴素贝叶斯法的参数估计极大似然估计贝叶斯估计补充知识 本笔记主要思路和内容源自《统计学习方法》,笔者采取了更易于理解的方式进行解读 朴素贝叶斯法的学习和分类 基本方法 假设输入是一个n维向量的集合,输出是一个类标记y,y的集合有K个元素。定义n维随机向量X代表输入特征,定义随机变量Y代表标签。 对于如下训练数据集: T={(x1,y1),...

nstarLDS的博客 866

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

bayes什么意思_什么是朴素贝叶斯法?

1) 朴素贝叶斯法(naive Bayes)基于什么理论?朴素贝叶斯法是基于贝叶斯定理与特征条件独立假设的分类方法。2) 朴素贝叶斯法的过程是怎样的?对于给定的训练数据集,首先基于特征条件独立假设学习输入、输出的联合概率分布;然后基于此模型,对给定的输入 ,利用贝叶斯定理求出后验概率最大的输出 。3) 朴素贝叶斯法的学习和预测效果怎么样?朴素贝叶斯法实现很简单,学习欲预测的效率都很高,是一种常用...

weixin_39578899的博客 267

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

机器学习 | 朴素贝叶斯法知识总结

机器学习 | 朴素贝叶斯法理论知识 贝叶斯决策论是概率框架下实施决策的基本方法。对分类任务来说,在所有相关概率都已知的理想情况下,贝叶斯决策论考虑如何基于这些概率和误判损失来选择最优的类别标记。朴素贝叶斯法是基于贝叶斯原理与特征条件独立假设的分类方法。即:加上条件独立假设的贝叶斯方法就是朴素贝叶斯方法(Naive Bayes)。 首先基于特征条件独立假设学习输入/输出的联合概率分布;然后基于此模型,对给定的输入x,利用贝叶斯定理求出后验概率最大的输出y。 朴素贝叶斯法实现简单,学习与预测的效率都很高,是

pandaww的博客 1万+

机器学习——朴素贝叶斯法运用

朴素贝叶斯法是一种基于贝叶斯定理的简单概率分类方法,它假设特征之间。它适用于,尤其是在文本分类中表现良好。其核心思想是通过考虑各个特征的概率来预测分类(即对于给出的待分类样本,计算该样本在每个类别下出现的概率,最大的就被认为是该分类样本所属于的类别。

2301_80841566的博客 1316
上一篇: knn算法
下一篇: 决策树(一):分类决策树
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值