


为什么非CoWoS不可?
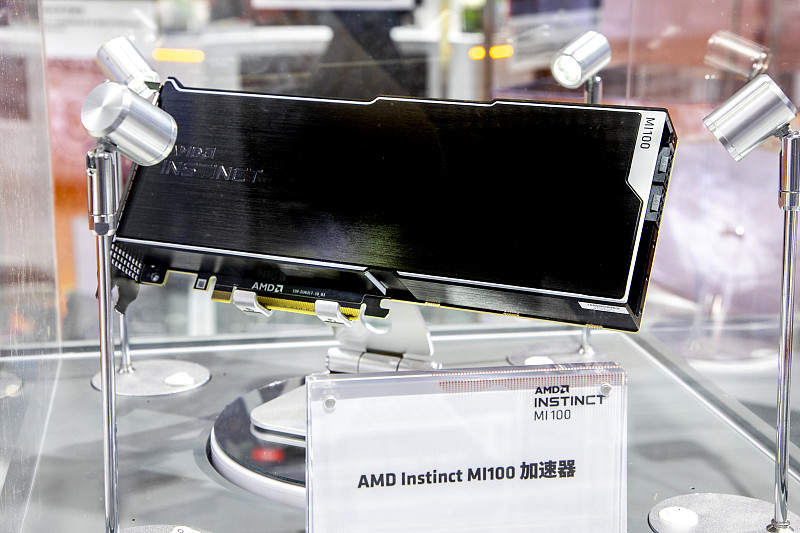
如果说过去十年半导体行业的主旋律是“摩尔定律”,那么当下最响亮的关键词一定是先进封装。随着大模型参数从百亿级狂飙至万亿级,单纯依靠工艺微缩提升算力的路径正在逼近物理极限。一颗AI芯片要同时装下海量计算单元与高带宽内存,传统2D封装早已力不从心。于是,HBM+CoWoS的黄金组合,几乎成了所有高端AI芯片厂商的必选项。从英伟达的Blackwell架构GPU,到AMD的MI系列加速器,再到云厂商自研的训练芯片——谁能拿到足够的CoWoS产能,谁才能在AI算力竞赛中真正站稳脚跟。一场围绕台积电CoWoS封装产能的“卡位战”,在全球芯片巨头之间悄然打响。CoWoS(Chip - on - Wafer - on - Substrate)是台积电研发的2.5D先进封装技术。简单来说,它不再把芯片和内存直接焊在基板上,而是通过高密度的TSV(硅通孔)和微凸点,将GPU/ASIC等计算芯片与HBM内存芯片并排放置在一片中介层(Interposer)上,通过中介层内部密集的微细线路实现芯片间的高速互联,最后整体封装到基板上。传统PCB电路板的线宽太粗,信号传输距离和速度都受限。一颗GPU往往需要同时连接多颗HBM,带宽需求高达每秒数TB,唯有硅中介层的超细线路才能负荷如此庞大的传输量。2011年,台积电正式推出CoWoS,历经多轮迭代,目前已形成CoWoS - S(整片硅中介层)、CoWoS - R(RDL中介层)和CoWoS - L(局部硅桥+有机基板)三类方案。其中CoWoS - L是当前主流方案——以“局部硅桥”替代超大单片硅中介层,在降低翘曲与成本的同时,支持更大的封装面积和更多的HBM堆叠。这套架构的核心优势非常明显:带宽提升:HBM与GPU通过硅中介层直接互联,带宽可达传统DDR的数十倍,彻底解决AI训练中的“内存墙”问题;功耗更低:信号传输距离大幅缩短,数据搬运功耗显著下降;集成度更高:多颗Chiplet小芯片+多颗HBM可以在同一个封装内协同,突破单颗芯片的面积限制。可以说,没有CoWoS,或许就没有今天动辄数千亿参数的大模型训练芯片。
谁在抢CoWoS?
根据摩根士丹利对供应链的调研预测,2026年全球关键客户CoWoS晶圆总需求约为138.4万片,到2027年将飙升至268.2万片,两年近乎翻倍。这场产能争夺战的参与者,早已从单一的GPU厂商蔓延至整个AI算力产业链。
英伟达:仍是主角,但份额正在稀释
英伟达(NVIDIA)仍是绝对主角。2026年英伟达对CoWoS的产能需求是780千片,2027年跃升至1200千片,稳居第一。从Hopper到Blackwell以及最新的Rubin架构,每一代GPU都深度绑定台积电CoWoS - L工艺。同时,CoWoS - R主要用于英伟达的Vera CPU生产,预计出货量达575万颗,强劲的预订量表明Vera CPU出货量将近乎翻倍,对CoWoS - R产能需求也达100千片以上;CoWoS - S则用于Quantum和Spectrum交换机芯片。整体来看,英伟达一家就包走了台积电过半的CoWoS产能。但英伟达在整体需求中的占比将从2026年的约56%下降至2027年的约45%——绝对值在涨,但份额占比正在被稀释。这意味着,CoWoS市场格局正在从英伟达“一家独大”走向多强并立。
AMD:2027年最大黑马,增量直追英伟达
如果说英伟达是存量王者,AMD就是最凶猛的追赶者。AMD在2026年的CoWoS产能仅130千片,2027年暴增至530千片,400千片的增量几乎与英伟达(442k)持平;主要驱动力来自AMD MI系列AI服务器芯片放量,以及3D V - Cache和Chiplet架构的大规模采用,让AMD对CoWoS的需求在一年内翻了三倍还多(增长307%)。据悉,AMD在2027年重点产品为MI455,年底少量生产MI500(Arcadia);针对AMD的Venice CPU领域,AMD主要依靠ASE/SPIL、Amkor等非台积电的CoWoS工艺,产能从5万片激增至27万片,预计对应675万颗CPU产量,主要受Agentic AI需求驱动。被AMD收购的Xilinx的10k片需求原地不动,这大概能说明增长全部来自AMD自有产品线的爆发,FPGA产品线对CoWoS的需求似乎已饱和,或技术路线转向其他封装方式。
博通网络芯片稳健增长
2026年,博通的产能需求是300千片,是CoWoS的第二大需求方;2027年预计将增长至484千片(同比增长61%),被AMD反超位列第三。与前两者不同,博通的主力产品并非GPU,而是高端网络交换芯片。AI集群对800G、1.6T交换机的需求激增,推动博通的Tomahawk系列芯片全面转向CoWoS先进封装。此外,博通也在协助谷歌TPU v7(Ironwood)和v8i(SunFish),以及谷歌TPU v7(Ironwood)和v8i(SunFish)芯片的设计和代工业务,占用CoWoS产能。
联发科异军突起
联发科从40千片飙至180千片,增长350%。联发科的爆发是这张榜单上最意外的看点,这家传统的手机芯片巨头正大举进军AI加速器市场,云端和边缘的ASIC芯片开始大规模采用CoWoS,增速在所有头部客户中位列第一。有供应商透露,联发科的ASIC业务主要是源于谷歌TPU v8t(ZebraFish),预计对应360万颗出货量。
AWS:云厂商自研芯片稳步上量
AWS两条自研芯片产品线(Annapurna和Alchip)合计需求从88千片增至126千片,反映出Trainium训练芯片与Inferentia推理芯片的持续迭代,代表着云厂商摆脱对单一GPU供应商依赖的决心,只是增速相对头部厂商更为温和。
Marvell与GUC:定制ASIC暗流涌动
Marvell从17千片增长到64千片、GUC从14千片增至60千片,分别增长276%和329%。这两家的激增折射出一个趋势:定制化AI ASIC市场正在爆发。Marvell的DPU与AI网络芯片、创意电子(GUC)的ASIC设计服务业务,都在大量消耗CoWoS产能。越来越多的互联网公司选择自研AI芯片,而它们都需要通过设计服务厂来对接台积电的封装产能。
Cisco:传统赛道增长停滞
思科体量和增幅较小,需求仅从5千片增至6千片,反映出传统网络设备与中低端FPGA对高端CoWoS的拉动有限。这部分市场正在逐步被AI相关需求所挤压。整体来看,CoWoS的需求结构正在发生深刻变化:AI GPU阵营是基本盘:英伟达+AMD+博通占据了绝大部分产能;ASIC与网络芯片是新增量:联发科、Marvell、GUC受益AI交换机、高速互连芯片需求,封装需求翻倍增长,增速远超行业平均;云厂商自研芯片是长期变量:虽然当前体量不算太大,但云端自研大模型芯片持续扩产,同时也代表着算力供应链去中心化的方向;传统FPGA/网络设备:Xilinx、Cisco需求停滞,传统业务对高端CoWoS拉动有限。从行业总量视角来看,全球头部关键客户对CoWoS的产能需求从2026年的合计约138.4万片,增至2027年合计约268.2万片,整体增长约94%。两年间全球CoWoS晶圆需求近乎翻倍,印证了摩根士丹利对先进封装赛道高增长的判断。当所有玩家都在往同一条赛道上挤的时候,产能紧缺的问题自然浮出水面。
产能瓶颈:台积电跑得够快,但还不够
早已意识到CoWoS战略价值的台积电,已经在拼命扩产。据数据统计,2022年CoWoS月产能仅约1万片,2025年已逼近7万片。随着台积电及其合作伙伴积极扩产,台积电的CoWoS月产能到2026年有望达到创纪录的12万至14万片晶圆,2027年进一步增至17万片/月(部分规划显示2027年底产能将达20万片/月),扩产主要集中在台南和嘉义,扩产规模将大幅超过此前水平。台积电在扩产CoWoS的同时,正积极推进行业领先的CoPoS(Chip on Panel on Substrate)面板级封装技术,试点生产线预计2026年6月完成调试,最早2028 - 2029年实现大规模量产,以应对大尺寸芯片的封装需求。台积电之外,其它阵营也在积极扩产:预计到2027年底,非台积电阵营(ASE/SPIL、Amkor等)的CoWoS产能将扩张至每月8万片(80kwpm)。其中ASE/SPIL从2026年底的30kwpm增至50kwpm,Amkor从20kwpm增至30kwpm,均侧重于CoWoS - L和CoWoS - R。能看到,行业供应结构开始从台积电单点主导,转向晶圆代工与封测厂并行扩容。UBS预计,CoWoS行业月产能预计将从2026年底16万片增至2027年底的25万片,一年增幅约56%。这轮扩产背后,Rubin、AMD Venice、Google TPU和Amazon Trainium正在同时增加封装需求。与此同时,在未来5年内,台积电CoWoS将持续以每年放大尺寸的节奏发展,以整合更多的逻辑和HBM。2026年已生产全球最大的5.5倍光罩尺寸CoWoS,良率超过98%,后续整合20个HBM的14倍光罩尺寸CoWoS将于2028年量产,以及可整合24个HBM、大于14倍光罩尺寸的版本,则于2029年就绪。供应链透露,不仅CoWoS需求强劲,台积电的SoIC及CoPoS进度也很快,让设备供应链订单期望能见度直接到了2030年。例如台积电的SoIC产能也在持续扩产,此前预估2027年月产能约由1万片拉升至2万片,最新则传出上调至至5万片,英伟达包下大量产能。然而,新增产能很快就会面对更大的订单池。据UBS测算,CoWoS产能总需求将从2026年的130.7万片增至2027年的247.5万片(上文摩根士丹利预测为268.2万片),一年增长约89%,明显快于同期行业月产能增幅。据供应链透露,目前CoWoS供需缺口约20%,预计到2026年底才能收窄至约10%。另有机构测算,2027年产能缺口可能扩大至约70万片,超过30%。有供应链厂商指出,即使CoWoS月产能上调至20万+片,也难以满足所有客户订单需求,加上仍存在扩产、垄断与美国本土制造等风险。很多客户已从先前几乎独供的台积电,将日月光、矽品科技、Amkor等列为外溢订单对象,建立先进封装第二供应路径。另一方面,扩产速度跟不上需求也存在其它原因:一方面工艺门槛高,CoWoS涉及大尺寸硅中介层、TSV通孔、微凸点键合等多项精密工艺,良率爬坡需要时间;另一方面,设备供应链长,先进封装所需的键合机、检测设备交期长达一年以上,不是有钱就能立刻扩产;同时,CoWoS与HBM大多时候是绑定关系,SK海力士、三星的HBM产能跟不上,CoWoS产能再大也无法出货。这就导致了一个尴尬的局面:台积电CoWoS产能在2024 - 2026年持续处于满产状态,订单能见度甚至已经排到了2027年。在这种情况下,各大芯片厂商为了锁定产能,不得不提前一年以上与台积电谈判,甚至出现了“抢产能”优先级的行业潜规则。还有一点需要关注的是,在CoWoS封装需求上升的同时,前端先进制程也在变紧。UBS指出,云端AI产品占台积电N3需求的比例将从2026年的35%升至2027年的72%,两年平均产能利用率分别约108%和109%。Rubin、Vera CPU、Google TPU与Trainium都要先获得N3晶圆,随后才能进入CoWoS环节。在这个过程中,客户结构也在快速变化。英伟达占台积电N3产能的比例预计从2026年的10%升至2027年的30%,Broadcom从10%升至16%;同期Apple占比从38%降至14%。虽然消费电子仍有需求,但云端AI正明显提高对先进制程和后端封装的双重占用。因此,CoWoS供给能否跟上,取决于这些环节是否都能按同一节奏爬坡。2027年底25万片的行业月产能目标,需要先进制程晶圆供给、OSAT全流程良率、键合与量测设备交付同步兑现,也要等Rubin、Venice和TPU按计划放量。需求来自更多客户后,CoWoS摆脱了对单一GPU周期的依赖,却增加了产品组合和排期复杂度。近期业界有声音传出,台积至今仍未确立设备商的订单分配,供应商如坐针毡,担心形成降价抢单氛围,同时设备下单至生产出货时程,至少7 - 9个月,业内担心可能难以如期交付设备。此外,比产能更棘手的问题是技术与成本瓶颈。据悉,CoWoS依赖的硅中介层面临成本高、尺寸受限、易翘曲三大难题。12英寸硅中介层单片成本逾百美元,占整体封装成本一半以上。尤其是随着AI芯片越做越大——NVIDIA B200的封装面积已达单片硅中介层承载极限的3到4倍——硅中介层的尺寸瓶颈已难以回避。下一代Rubin GPU尺寸更大,目前只能靠“局部硅桥+有机基板”的方式应急。
英特尔、三星“磨刀霍霍”
CoWoS产能吃紧,也给了竞争对手机会。CoWoS并非2.5D封装的唯一答案,竞争对手们正在加速布局自己的替代方案。尤其是在先进制程领域鏖战多年的英特尔和三星,在先进封装这块巨额的市场蛋糕与产能缺口面前,磨刀霍霍。
英特尔的EMIB与Foveros
英特尔拥有自己的2.5D/3D封装技术矩阵。其中,EMIB(嵌入式多芯片互连桥接)技术正积极抢占市场。与CoWoS不同,EMIB通过局部嵌入式硅桥替代全尺寸中介层,实现芯粒间局部高速互连,良率更高,成本大幅降低。对比CoWoS,EMIB硅用量仅其1/3 - 1/5,单颗成本低30% - 50%;EMIB - M已支撑6倍光罩尺寸,预计2026 - 2027年达8 - 12倍;热膨胀失配风险低,翘曲问题少,良率已突破90%。EMIB工艺也在不断演进迭代:EMIB(一代):基础硅桥,面向CPU+GPU/HBM一般异构集成;EMIB - M(Matrix):多桥阵列。当前6倍光罩,2026 - 2027年目标8 - 12倍,瞄准超大规模多芯粒AI芯片;EMIB - T(Through - Silicon - Via):硅桥引入TSV实现垂直供电。电源与信号从封装底面直达芯片,抑制DC/AC噪声串扰,契合AI加速器与数据中心芯片对带宽和功耗的严苛要求。后段良率已爬至90%以上;EMIB+玻璃基板:2026年初首发,78×77mm巨型封装(2倍标准光罩),“10 - 2 - 10”堆叠(800μm厚玻璃芯+上下各10层RDL = 20层电路),定位HPC与AI服务器。在市场进展方面,2026年英特尔EMIB - T封装已拿下Google下一代TPU的订单;英伟达下一代GPU Feynman也计划导入EMIB;Meta也计划在2028年的CPU中采用;SK海力士正与英特尔合作测试EMIB,以降低对CoWoS的依赖。近日,英特尔宣布任命李锡熙为Intel Foundry执行副总裁,负责先进封装、系统集成、后端技术开发和后端制造,并直接向CEO陈立武汇报。这一任命的核心意义在于,Intel正在把先进封装提升为Foundry业务的重要增长点。AI加速器通常需要把逻辑芯片、HBM、I/O芯片和其他Chiplet集成到同一封装中,封装平台能力直接影响客户是否愿意采用Intel Foundry。Intel将后端封装独立强化,有助于其在18A、14A和后续制程之外,提供更完整的系统级制造方案。对全球格局而言,Intel并不只是希望在前道制程上追赶台积电,也在试图通过EMIB、Foveros、EMIB - T和混合键合等后端技术,吸引AI ASIC、HPC和云服务客户。先进封装可能成为Intel重新进入高端客户供应链的切入口。有业内人士表示,EMIB正从CoWoS替代选项跃迁为AI大芯片时代的封装第二极,其“硅桥+玻璃基板”的双线演进正在制约CoWoS的溢价空间。Foveros则是Intel真正的3D堆叠技术,可实现逻辑芯片叠逻辑芯片。随着英特尔IDM 2.0战略推进,其封装业务也开始对外接单,直接对标台积电CoWoS和SoIC。
三星的I - Cube
三星的竞争优势在于其能够提供从HBM制造、逻辑制程代工到先进封装的完整“交钥匙”方案。三星的SAINT(Samsung Advanced Interconnect Technology)家族涵盖了I - Cube(2.5D)和X - Cube(3D)技术,背靠自身HBM内存产能优势,三星正在全力争取AI芯片客户的封装订单,试图形成“内存+封装”的一体化竞争力。I - Cube利用硅中介层集成逻辑芯片与HBM,目前已能支持多达8个HBM堆栈的集成。针对下一代HBM4,三星正积极推进混合键合技术,以取代传统的微凸点堆叠,旨在提升热耗散能力并缩减封装高度。三星计划到2026年将其HBM月产能大幅提升至25万片,以期在高性能AI加速器市场夺回主导权。不过有行业人士表示:“采用三星2.5D封装平台的客户,要么出货量很小,要么只是几个月的短期项目。在先进封装决定芯片性能的时代,三星亟需加强这一领域的竞争力。”对此,三星正将2.5D封装的技术路线从传统的晶圆级封装(WLP)转向面板级封装(PLP)。PLP使用方形大尺寸面板,面积利用率高,生产效率优于圆形晶圆。随着AI芯片尺寸不断增大,PLP的适用性将进一步提升。三星正在推进将Cube技术从WLP改为PLP,并着手开发面向超大芯片的“系统级面板(SoP)”,目前开发尺寸为415mm×510mm。
行业玩家的多元路线
此外,ASE(日月光)、Amkor(安靠)等封测巨头也在发展类似的2.5D封装方案,虽然在最尖端性能上与CoWoS尚有差距,但在成本与产能灵活性上具备优势,正在蚕食中高端市场。
日月光
日月光推出的VIPack™平台旨在支持从扇出型芯片封装(FOCoS)到共封装光学(CPO)的全方位异质集成需求。为了应对AI爆发带来的产能短缺,日月光计划在2025年投入超过60亿美元的资本支出,重点在高雄及中科厂区扩充类CoWoS产能。日月光还展示了先进的硅光子技术,通过将光学引擎直接集成在封装基板上,大幅提升了AI数据中心内部的数据传输效率。
安靠
安靠作为全球第二大OSAT,其战略重心在于与先进制程代工厂的紧密绑定。安靠与台积电签署了谅解备忘录,将在其亚利桑那州新厂为台积电提供封装与测试支持,从而缩短晶圆跨太平洋运输的周转时间。安靠在高性能计算领域的研发重点包括RDL中介层技术和桥接技术(如Connect - S),目前已有多家计算与网络客户进入资格认证阶段,预计2026年实现大规模量产。此外,安靠在高密度扇出(HDFO)领域具有显著优势,能够为下一代智能手机和车载ADAS系统提供轻薄且高效的互连方案。这些路线并非完全竞争和互相互斥,而是针对性的服务于不同应用。高端AI GPU更重视带宽、良率和成熟度;定制AI ASIC可能更重视成本、供货弹性和多供应商策略;消费电子和边缘AI产品则更重视尺寸、成本和批量制造能力。可以预见,未来的先进封装市场不会是台积电一家独大,而将呈现多技术路线、多供应商并存的格局。
中国先进封装如何破局
当先进封装被攥在少数几家厂商手中时,国内半导体产业自然也无法置身事外。CoWoS的产能紧缺与技术壁垒,恰恰折射出中国在先进封装领域加速突破的紧迫性。好消息是,国内正在全力追赶,且在先进封装赛道并非从零起步。长电科技、通富微电、华天科技等封测巨头均已布局2.5D/3D封装、Chiplet等技术路线,部分产品已进入量产阶段。例如,长电科技2026年6月宣布投资78亿元在上海临港建设高端先进封装工厂,聚焦2.5D/3D堆叠、HBM3e、Chiplet与CPO四大方向。此外,盛合晶微、甬矽电子、晶方科技等本土企业,也正在通过各具特色的先进封装能力,提升本土供应链价值。大基金三期已将先进封装列入重点支持方向。与台积电CoWoS相比,中国厂商在最高端AI GPU封装中或许仍存在HBM协同、良率控制和客户生态差距,但在国产AI芯片和特色应用中具备更强的本地客户贴近度。更重要的是,Chiplet架构的普及为国内产业提供了一个“换道超车”的窗口。当芯片不再追求单颗极致大,而是通过多颗小芯片拼接实现高性能,封装的价值占比将持续提升——这恰恰是国内封测产业积累深厚的领域。
写在最后
CoWoS的争夺战,远未结束。台积电在扩产,英特尔、三星、日月光在追赶,国内在奋力突围。谁能在先进封装这场竞赛中笑到最后,将深刻影响未来十年的AI芯片格局。而对于国内产业来说,这既是挑战,也是不容错过的历史机遇。
 414


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


