


AI在生物学领域的困境
顶级AI编码发展迅速,但在生物学领域却屡屡失败。并非模型不够智能,而是科学数据库是为人类操作设计的。近日,Anthropic发布了一篇题为《为生物学智能体铺路(Paving the way for agents in biology)》的科学博客,其中一组数据令人震惊。研究者让Claude、GPT、Biomni、Edison Analysis等当前最强的科研智能体,从NCBI Virus数据库中准确数出符合条件的病毒序列数量,结果没有一个能稳定答对。同一道题、同一个模型、同一段提示词,问三次答案能相差几十倍。例如Claude Sonnet 4检索一条埃博拉病毒序列,三次返回的结果分别为106条、15条、5条,而正确答案是266条。
智能体在科学领域的短板
智能体在科学领域的真正短板并非推理,而是缺乏稳定、可复现、机器能操作的取数方式。无专用检索层时,各家系统的平均准确率从16.9%到91.3%不等,即使新模型有所进步,残留错误仍很致命,因为这类任务的及格线是100%。少一条记录可能导致诊断试剂覆盖范围判断错误,或疫情起点推算偏差。Anthropic比喻,用智能体跑生物数据库就像开车穿越为马车设计的老城,街道布局不适合汽车;而软件世界则是为车而建的新城,有完善的系统。所以代码智能体发展迅速,生物智能体却停滞不前。
NCBI Virus的问题
NCBI Virus本质上是网页门户,其检索交互为人类设计,机器难以复用。大量过滤逻辑写在网页层,未开放干净的程序接口。智能体只能调用底层原始API,而这些API与网页过滤语义不同。例如网页上“采样地在非洲”“含表面糖蛋白”等条件,网页会处理隐性步骤,原始API则不会,智能体只能自己猜测并重新拼接逻辑,这导致Sonnet 4同题三答结果差异大。
数错序列的严重后果
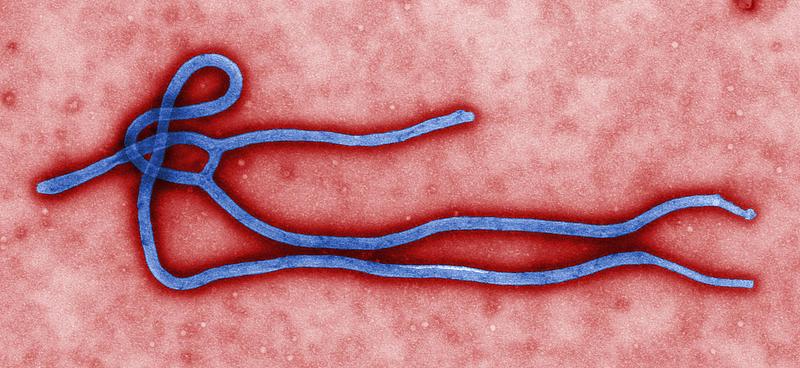
2026年5月,刚果(金)爆发邦地布焦型埃博拉疫情。研究者需将新基因组与NCBI Virus里的历史埃博拉基因组比对,第一步要手动操作网页复现复杂过滤条件。用Sonnet 4拉数据推算“最近共同祖先时间(TMRCA)”,结果三套数据两套残缺,一套将起源时间从2014年拉回到1922年,另一套漏掉几内亚序列,将起源时间挪到2014年4月。抗体疗法分析中,Sonnet 4三次跑出不同突变图景。失败模式为拉大结果集时漏数、过滤条件用错超数,流感A、HIV - 1等病毒偏差最大,过滤条件超过三四个并行时性能崩溃。
gget virus的解决方案
Anthropic和NCBI的研究者合作开发了gget virus,它是一个确定性检索层,将NCBI Virus网页界面的过滤行为转化为可复现的程序化系统。技术上,它统筹底层系统,自动判断过滤方式,处理批量取数,输出人和机器都能读懂的格式并附带详细日志,对高频查询压缩数据传输量超98%。接入gget virus后,所有被测系统准确率超90%,GPT - 5.5达到99.7%,运行稳定性提升,模型间差距大幅缩小。GPT - 5.5曾在无提示情况下自行使用gget virus并答对题目。
从模型到地基的转变
类似的问题出现在所有“为人类、而非为智能体设计”的环境中。Karpathy曾吐槽AI时代软件上线时在浏览器操作繁琐,生物学家对此可能深有同感。gget virus并非个例,ToolUniverse、Robin、Biomni等生物医学智能体也在搭建“上下文引擎”。虽然未来智能体可能具备穿越混乱取数流程的能力,但Anthropic认为不应让其每次都从头开始。这场竞赛表面是模型比拼,实则是数据基础设施的较量。模型曲线仍在上升,但真正的胜负手可能在于数据基础设施。
 33


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


