


1. 日薪120元,全民数采潮来了
具身智能行业今年最重要的关键词是数据,这个词不仅出现在学术期刊论文、科技公司PPT中,还出现在湖北某市零工招聘信息及陕西某村镇小规模培训中。所谓数据,指人类世界中真实发生的一切信息,如叠衣服、浇花、做饭等,每个具备行动能力的普通人都是机器人的老师。模型迭代、算法进步,看似前沿的科技已扩散为全民可参与的大型实验,角色众多且变化迅速。
河北人张月是一名全职妈妈,通过兼职群得到具身数据采集工作,居家每小时30元。她需参加半天培训,内容包括下载采集软件、学习使用夹爪、按要求拍摄视频。采集软件发布各类任务,张月每天领取任务,寻找合适场景,打开App一边录像一边用夹爪做家务,每天拍摄不少于8小时,每段视频不少于2分钟,拍摄完成后批量上传,一天收入约120元。
湖北人阿信记得,2025年11月兼职群开始零星出现具身智能数采招聘信息,2026年3月招聘信息井喷,有不同工作形式和薪资。3月起,数采商通过人力外包公司在全国各地大规模招聘众包数采员,数据采集对普通人来说门槛低且有新鲜感,低线城市120元日薪不错。有人因村里参与者少、夹爪数量不够等问题无法参与采集,也有人呼吁给退休妈妈参与机会。
一家人力外包公司HR美美表示,公司规划两期数采项目,一期以家居场景为主,二期“世界交互”以户外公共场合日常行为为主。录制要求打开声音,录入环境音,至少每3分钟和环境交互一次,尽量避免长时间拍摄他人。北京一家肯德基店员用夹爪擦桌子采集数据,海外数采也热闹,Micro1、Scale AI等公司全球招募零工录制家务视频,DoorDash推出Tasks应用让送餐员顺带录制。一场全民数采潮拉开帷幕。
2. 数据!数据!数据!
全民数据采集源于具身智能行业的数据饥渴。智元机器人合伙人、觅蜂科技董事长兼CEO姚卯青称,大需求方对数据是“有多少要多少,什么时候有马上要”的状态,具身智能大脑公司、本体厂商、多模态大模型与世界模型公司都需要数据,目前市场可采购数据集几十万小时,高质量数据严重供不应求。
主流观点认为,训练泛化能力的具身大模型至少需1000万小时数据,达到智能涌现需100亿小时数据。自动驾驶经历了数据从无到有、从少到多的过程,具身智能的数据积累才刚刚起步。数据堂首席运营官何鸿凌表示,具身智能与自动驾驶训练方式类似,但难点在于具身智能不能像自动驾驶那样先卖产品再积累数据。
何鸿凌了解到的数据需求情况是家庭场景占80%,商超占10%,工厂占10%。行业认可的具身智能数据分三层:底层是互联网视频及仿真合成数据;中间层是无本体数据,由数采员使用穿戴式设备执行特定任务动作获得;最顶层是真机数据,由工作人员遥控操作机器人获得。2026年3月开始,无本体的具身智能数据采集全面爆发。
蚂蚁数科天玑实验室副主任朱凯表示,具身智能训练数据多样性有优先级序:任务多样性 > 操作物品多样性 > 场景多样性。通用具身模型对训练数据的配比朝“90% ego+10% 真机”演变,部分团队探索“99% ego+1% 真机”的极端配比,这意味着ego数据的规模化供给能力决定GPT - 3时刻到来的快慢。
3. 采集设备的“战国时代”
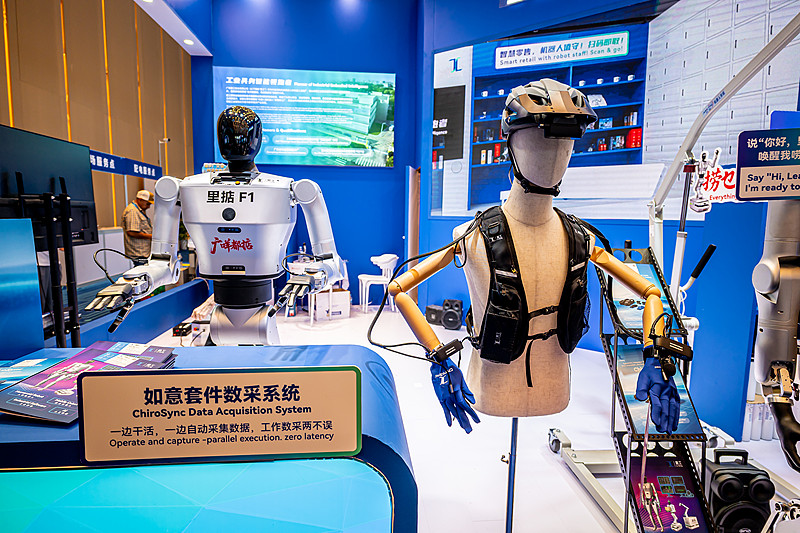
过去两年,机器人数采设备历经三次迭代:从“真机遥操”到UMI,再到“第一人称人类视频(Ego Centric)”,每次迭代都朝着成本更低、门槛更低、采集更方便的方向,让参与者从专业人员向普通大众扩散。
UMI路线从2025年底开始,海外具身智能厂商通过UMI数采训练出一些模型,国内外厂商跟进,出现各种UMI设备。2026年3月,鹿明机器人发布FastUMI无本体数采产品体系,鹿明数据采集分两步走,2026年与政府/产业方合作建设数采工厂实现100万小时数据产能,2027年以众包激励形式实现1000万小时数据产能。
4月,智元机器人孵化的具身智能数据公司觅蜂科技推出MEgo系列无本体数据采集硬件,目标是2026年数据采集规模达千万小时,2030年前向百亿小时级数据产能迈进。
2026年3月英伟达GTC大会上,英伟达EgoScale框架问世,开启了采集效率更高、成本更低的新方向——Ego - Centric,参与者只需一部手机及固定手机的头环或胸前支架。具身智能数据采集工作从固定人员、固定场所变为不固定人员、不固定场所,众包形式更经济。
4月,京东云自研可穿戴式超高清采集终端JoyEgoCam,发动员工和外部人员在多种场景下“即戴即采”,目标是两年采集超1000万小时无本体视频数据。蚂蚁数科天玑实验室团队研发第一人称视频采集框架AoE,通过手机和低价颈挂式支架采集数据。4月,纵横物理推出数采AI眼镜Across,用户录制视频可获虚拟金币提现,5月又推出售价899的AI眼镜。
数采设备迭代快,有些设备还没量产就落伍。数据堂在2025年下半年涉足具身智能数据采集业务,3月前用夹爪,3 - 4月很多任务直接用手操作。设备能否成为主流取决于技术和商业价值,数据采集厂商投入可能短时间被替代,决策需谨慎。
4. 毛利100%的生意
数据采集端成本持续压缩,但工作并不轻松。阿信在家按要求拍视频,镜头要持续稳定拍摄手部动作,无效原因多样,每天拍摄8小时有效时长往往不到2小时,报酬也在贬值,3月初众包价格(有效时长)为50元/小时,近期低至20 - 22元/小时。
设备层面,夹爪被淘汰,拍摄设备适配范围扩大,4月底只需50元左右挂脖支架和采集软件即可参与采集。采集成本降低,需求热度不减,数据采集有利可图,数采厂商总成本约100元/小时,对外售价200元,毛利高达100%。纵横物理提出在真人采集数据基础上用算法生成式扩增。
众包虽成本低,但问题多。何鸿凌表示,众包数据质量难保证,存在动作不流畅、任务理解错误等问题,且培训成本高、人员流失难控制。还存在人员配合度与隐私冲突问题。数据堂采取雇佣有经验采集员到各地租赁空置房间采集的方式,觅蜂以加盟方式,先做样板再复制。4月,三家公司推出具身智能数据交易平台。
5. 技术转向:VLA还是世界模型?
从一线数采员角度看,数采要求不断放宽。早期要求动作精准,4月开始很多任务用手机拍摄,不再苛求折痕位置,更在意不同场景下的反复操作。
过去主流具身大脑模型使用VLA,采集员需模仿机器人精度;2025年下半年开始,世界模型(WAM)崛起,主张机器人先学物理世界因果规律,再用少量真机数据微调。世界模型对采集数据要求不同,需要大量、多样、真实的日常操作场景。数采员工具和采集方式的变化,背后是VLA与WAM两条路线的此消彼长。
真正驱动众包热潮转向的,除算法路线更迭,还有资本与竞争的合流。年初具身大脑赛道热钱涌入,世界模型提供新故事,全球数采竞赛也倒逼行业加速。但实际落地中,没有公司死守纯VLA或纯世界模型,行业玩家比拼的是谁能在最短时间内用最低成本跑通数据闭环,让模型稳定干活。这是2026年的真实图景,所有人都在等具身智能的“ChatGPT时刻”降临。未来具身智能数据采集会走向何方?
 420


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


