


谷歌大会拉开帷幕,迈入Gemini智能体时代
今天,谷歌Cloud Next2026大会正式拉开帷幕,CEO劈柴发文宣告,已正式跨入Gemini智能体时代。谷歌内部75%新代码全由AI写,且谷歌大会真正的「重头戏」是祭出了第八代TPU。
第八代TPU登场,性能狂飙3倍
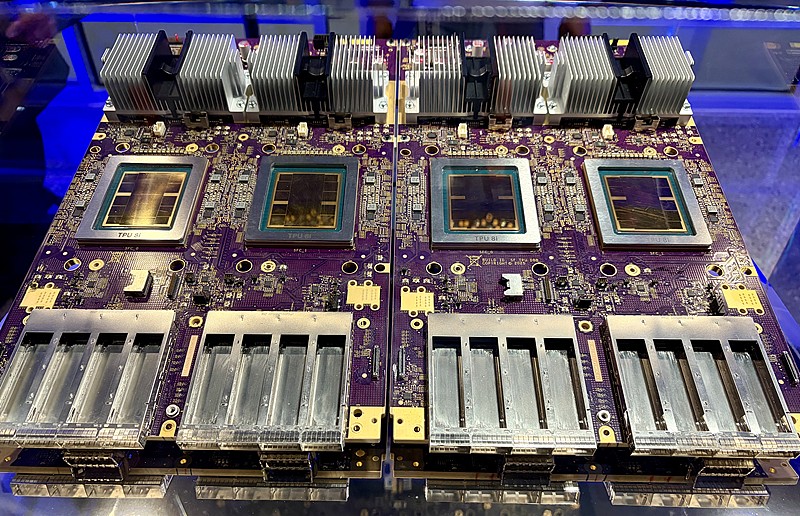
第八代TPU是面向Agent时代的「两款芯片」,也是谷歌十年磨一剑的成果。此次谷歌首次将TPU一分为二,TPU 8t专攻训练,TPU 8i专攻推理,训练+推理双线出击,直指英伟达腹地。网友还做了英伟达GPU和谷歌TPU对战的全貌局势图。
TPU 8t在吞吐量和扩展性上进行了「堆料」,可将LLM开发时间从数月缩短至数周,每个Pod的计算性能几乎是上一代Ironwood的3倍。单个TPU 8t Superpod可扩展至9600个芯片,提供高达121 ExaFlops的算力,还能实现「百万级」TPU集群的近线性扩展,且「有效算力时间」优化至97%以上。
TPU 8i专为处理多个专业Agent之间复杂、协作和迭代的工作而设计,可在单个Pod中连接1,152个TPU,实现巨大的吞吐量和低延迟。通过四项关键创新,消除了多Agent「排队等待」效应,采用分层Boardfly拓扑结构,突破「内存墙」限制,配备288GB高带宽内存和3倍于前代的片上SRAM,性价比提升了高达80%。此外,第八代TPU全面整合Axion Arm CPU,实现了每瓦特性能翻倍。
75%谷歌新代码,全是AI写的
谷歌内部75%的新代码现在由AI生成,工程师审核通过,去年秋天这个数字还是50%,半年时间暴涨了25%。谷歌内部开始搞全自主的Agent工作流,一个复杂代码迁移项目,Agent+工程师协作完成的速度是一年前纯人工的6倍。Gemini Mac版应用的初始版本是用谷歌内部的Agentic开发平台Antigravity搭建的,从idea到原生Swift原型只用了几天。
谷歌内部还出现了能用Claude的人和不能用Claude的人阶层分化,谷歌DeepMind给部分员工「开绿灯」允许使用Claude编程,引发内部恐慌,不少工程师坦言Gemini在编程表现上逊色于Claude。而此时谷歌正加码推进全员AI化,并将AI工具的日常应用与KPI深度挂钩。
Workspace接入AI脑,解放打工人
谷歌正式发布了Workspace Intelligence,这是一个横跨Gmail、Docs、Sheets、Slides、Drive、Chat全线产品的AI「超级大脑」。
Ask Gemini in Chat让人眼前一亮,谷歌把Google Chat重新定义为「工作的统一命令行」,在Chat里说出目标,Gemini在后台跨应用调度,把成品丢回聊天窗口。每天早上打开Chat,AI会给一份每日简报,还能帮忙找会议时间、生成文档和PPT、定位任意文件。
Workspace Intelligence在「办公全家桶」表现出色。Sheets仅用自然语言描述需求,就能从邮件、聊天、文件甚至网页里抓取数据,端到端完成复杂电子表格的构建;Docs不仅能写文章,还能处理文档评论、生成配图;Slides能一次性生成完整、可编辑的PPT,把「做PPT」的痛苦指数砍掉了90%。此外,Gmail迎来「AI收件箱」,自动提炼邮件重点;「Drive Projects」让知识库成为活水,终结「找文件」的噩梦。
每分钟160亿Token,企业级「龙虾」平台来了
Cloud Next大会上,谷歌公开了一系列数据和企业级重磅新品。Gemini Enterprise的势头在疯狂拉升,Q1付费月活环比增长40%,API每分钟处理的token量从上季度的100亿飙升到160亿。
谷歌还宣布了Gemini Enterprise Agent Platform,这是Vertex AI的重大进化,提供了一套完整的构建、扩展、治理与优化方案,集成了全球200+顶尖AI,还引入了Memory Bank,让Agent拥有持久的长效记忆。
如今,硅谷「御三家」谷歌、OpenAI、Anthropic正展开一场全栈式的巅峰对决,谷歌选择了全栈自研、垂直整合的路,这一局才刚刚开始。
 525


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


