


title:
date: 2024-09-03 09:38:54
tags:
cover: https://picbed0521.oss-cn-shanghai.aliyuncs.com/blogpic/ACVA_COVER.png

原文见我的网站: www.supdriver.top
背景分析
航空公司现状
行业内竞争
民航的竞争除了三大航空公司之间的竞争外,还将加入新崛起的各类小型航空公司、民营航空公司,甚至国外航空巨头。航空产品生产过剩,产品同质化特征愈加明显,于是航空公司从价格、服务间的竞争逐渐转向对客户的竞争

行业外竞争
随着高铁、动车等铁路运输的兴建,航空公司受到巨大冲击

如上图所示,经过2010到2015年的发展,铁路运输对航空运输的冲击越发明显
航空公司数据特征说明
- 目前航空公司已经积累了大量的会员档案信息和其乘坐航班记录
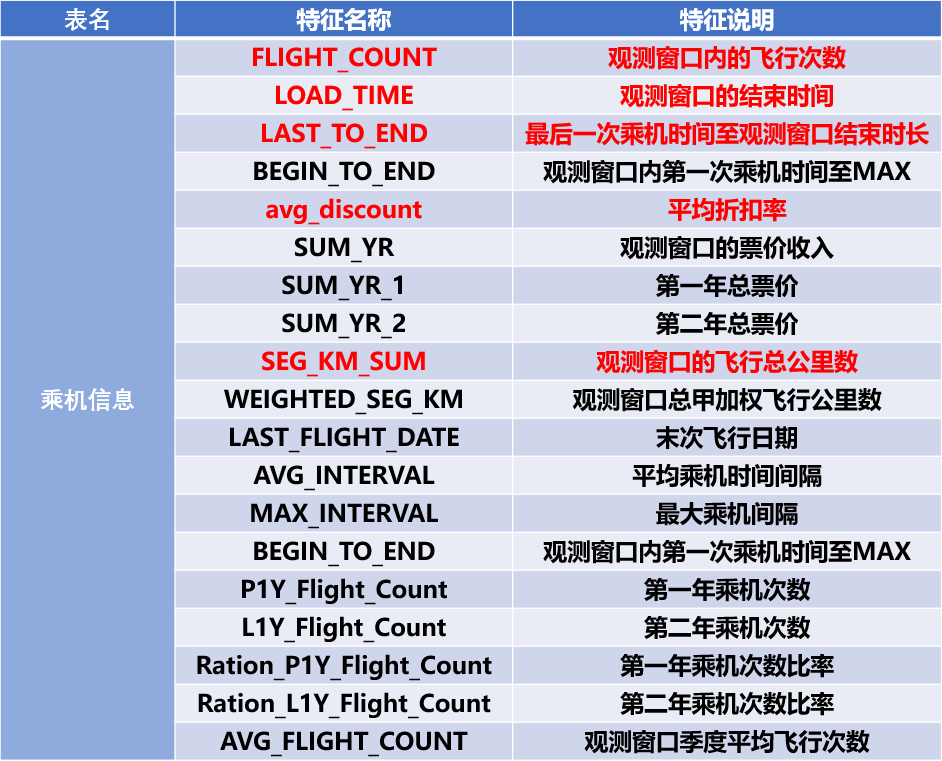
- 就本项目已获取的数据,以2014-03-31为结束时间,选取宽度为两年的时间段作为分析观测窗口,抽取观测窗口内有乘机记录的所有客户的详细数据形成的历史数据,44个特征,总共62988条记录。
数据特征记录说明如下表所示:


结合数据的项目目标
结合目前航空公司的数据情况,可以实现以下目标
- 借助航空公司客户数据,对客户进行分类
- 对不同的客户类别
进行特征分析,比较不同类别客户的客户价值 - 对不同价值的客户类别提供
个性化服务,制定相应的营销策略
了解客户价值分析
客户营销战略倡导者Jay & Adam Curry 从国外数百家公司进行了客户营销实施的经验中提炼了如下经验
- 公司收入的
80%来自顶端的20%客户 20%的客户其利润率100%90%以上的收入来自现有客户- 大部分的营销预算经常被用在非现有客户上
5%至30%的客户在客户金字塔中具有升级潜力- 客户金字塔中客户升级
2%,意味着营销收入增加10%,利润增加50%
也许这些经验并不完全准确,但是它解释了新时代客户分化的趋势,也说明了对客户价值分析的迫切性和必要性
项目流程图

代码实现业务功能
系统架构
文件结构
这里主要用三个文件夹,分别储存代码,原始数据,临时文件
codes代码文件夹data_raw原始数据文件夹tmp临时文件文件夹
代码结构
本业务系统采用一个main.py执行主要业务逻辑,封装多个模块和类实现具体业务,以达到主要业务逻辑清晰,代码封装性强,易于维护和复用的优点
主要的代码文件有:
- main.py 执行主要逻辑
- log.py 提供日志器
- data_cleaner 实现清洗数据
- LEDNX.py 构建和提取五大特征
- radar_char.py 绘制结果雷达图
实现一个简单的日志器
一般日志器有日志等级,日志时间,和日志内容三大部分,不过本次业务与时间关联性不大,就只打印两个部分
log.py
###### 实现日志系统 ########

# 定义日志等级
LOG_INFO = "Info"
LOG_ERROR = "Error"
LOG_WANING = "Warning"
LOG_FATAL = "Fatal"

class Log:
    def __init__(self):
        return

    def __call__(self,level,*msgs): # 重载()运算符
        print("[", level, "]",end='')
        for msg in msgs:
            print(msg)
        # 本项目与时间关系不大,日志系统不打印时间
这里使用了__call__对()操作符的重载,和*mgs达到了传递任意数量参数的语法特性
这样以后打印日志可以方便地把对象当函数用
程序入口 & 从数据源提取数据
我们将main.py作为项目的程序入口
main.py
######### 主程序入口 #############
import numpy as np
import pandas as pd
from sklearn.cluster import KMeans
import time

from log import *
from data_clean import *
from LRFMC import *

if __name__ == '__main__':

    log = Log()  # 实例化一个日志器
    data_cleaner = DataCleaner() #实例化数据清洗器
    LRFMCobj = LRFMC()  # 实例化模型处理器
这里的数据源为.csv文件,所以我们要用到pandas模块读取文件到表格中
这里代码不多,就直接写在main.py里了
    # ...上略...
    #data_cleaner = DataCleaner() #实例化数据清洗器

    # 从数据源获取数据
    airline_data = pd.read_csv("../data_raw/air_data.csv",
        encoding="gb18030")  # 导入航空数据
    log(LOG_INFO,'原始数据的形状为:', airline_data.shape)
预处理航空公司数据
航空公司客户原始数据存在少量的缺失值和异常值,需要清洗后才能用于分析。
缺失值处理
通过对数据观察发现原始数据中存在票价为空值,票价最小值为0,折扣率最小值为0,总飞行公里数大于0的记录。票价为空值的数据可能是客户不存在乘机记录造成。
处理方法:丢弃票价为空的记录
具体实现: 考虑到与票价有关的特征有SUM_YR_1和SUM_YR_2两条,逻辑上两条特征数据都为0才算缺失值,所以分别提取两条对应的布尔值列表,并用逻辑与合并,用于数据表格的切片
我们先定义好成员函数,最后封装到DataCleaner类中
data_cleaner.py
    def notNull(self,airline_data):  # 缺失值处理:去除票价为空的记录
        exp1 = airline_data["SUM_YR_1"].notnull()
        exp2 = airline_data["SUM_YR_2"].notnull()
        exp = exp1 & exp2  # 按位逻辑与,获取所需的布尔值列表
        # airline_notnull = airline_data.loc[exp, :]  # exp提供布尔值竖列表, ':'默认无参时,切片所有行,完成去除操作
        airline_notnull = airline_data[exp] #  这是上一句的简化写法(使用更多的缺省参数

        return airline_notnull
异常值
其他的数据可能是客户乘坐0折机票或者积分兑换造成。由于原始数据量大,这类数据所占比例较小,对于问题影响不大,因此对其进行丢弃处理。
处理方法:丢弃票价为0,平均折扣率为0,总飞行公里数大于0的记录。
具体处理:采用index1和index2先保留总票价不为0的记录,然后用index3筛选出总里程SEG_KM_SUM``>0且平均折扣率avg_discount``!=0的记录,使用布尔值列表(index1 | index2) & index3进行筛选,保留所需数据
    def notOutlier(self,airline_data):
        index1 = airline_data["SUM_YR_1"].notnull()
        index2 = airline_data["SUM_YR_2"] != 0  # 效果和上一句的notnull()一样,都是生成bool array
        index3 = (airline_data["SEG_KM_SUM"] > 0) & \
                 (airline_data["avg_discount"] != 0)  # 折扣且总里程不为0的机票
        airline = airline_data[(index1 | index2) & index3]  # 丢弃票价为0,或折扣率为0,且总里程>0的异常值
        return airline
封装DataCleaner类
将用于清理数据的函数整合到一个类中,方便维护,添加或修改新的清理规则也很可以很方便地找到DataCleaner类,在里面集中维护s
data_cleaner.py
class DataCleaner:
    def __init__(self):
        return
    def notNull(self,airline_data):  # 缺失值处理:去除票价为空的记录
        exp1 = airline_data["SUM_YR_1"].notnull()
        exp2 = airline_data["SUM_YR_2"].notnull()
        exp = exp1 & exp2  # 按位逻辑与,获取所需的布尔值列表
        #airline_notnull = airline_data.loc[exp, :]  # exp提供布尔值竖列表, ':'默认无参时,切片所有行,完成去除操作
        airline_notnull = airline_data[exp] #  这是上一句的简化写法(使用更多的缺省参数
        return airline_notnull

    def notOutlier(self,airline_data):
        index1 = airline_data["SUM_YR_1"].notnull()
        index2 = airline_data["SUM_YR_2"] != 0  # 效果和上一句的notnull()一样,都是生成bool array
        index3 = (airline_data["SEG_KM_SUM"] > 0) & \
                 (airline_data["avg_discount"] != 0)  # 折扣且总里程不为0的机票
        airline = airline_data[(index1 | index2) & index3]  # 丢弃票价为0,或折扣率为0,且总里程>0的异常值
        return airline
RFM到LFRMC模型的介绍
RFM模型介绍
本项目的目标是客户价值分析,即通过航空公司客户数据识别不同价值的客户,识别客户价值应用最广泛的模型是RFM模型。
- R(
Recency)指的是最近一次消费时间与截止时间的间隔。通常情况下,最近一次消费时间与截止时间的间隔越短,对即时提供的商品或是服务也最有可能感兴趣。- F(
Frequency)指顾客在某段时间内所消费的次数。可以说消费频率越高的顾客,也是满意度越高的顾客,其忠诚度也就越高,顾客价值也就越大。- M(
Monetary)指顾客在某段时间内所消费的金额。消费金额越大的顾客,他们的消费能力自然也就越大,这就是所谓“20%的顾客贡献了80%的销售额”的二八法则。
RFM模型结果解读
RFM模型包括三个特征,使用三维坐标系进行展示,如图所示。X轴表示Recency,Y轴表示Frequency,Z轴表示Monetary,每个轴一般会分成5级表示程度,1为最小,5为最大
如图,不同的区域有有不同的营销策略

传统RFM模型在航空行业的缺陷
在RFM模型中,消费金额表示在一段时间内,客户购买该企业产品金额的总和,由于航空票价受到运输距离,舱位等级等多种因素影响,同样消费金额的不同旅客对航空公司的价值是不同的,因此这个特征并不适合用于航空公司的客户价值分析。

航空客户价值分析的LRFMC模型
为了弥补传统RFM模型在实际应用中的缺陷,本次项目使用了适用于航空客户价值分析的LRFMC模型
本项目选择客户在一定时间内累积的飞行里程M和客户在一定时间内乘坐舱位所对应的折扣系数的平均值C两个特征代替消费金额。此外,航空公司会员入会时间的长短在一定程度上能够影响客户价值,所以在模型中增加客户关系长度L,作为区分客户的另一特征。

构建航空客户价值分析的关键特征
这里依然使用模块封装和类封装,在LRFMC.py中封装LRFMC类来完成模型相关的数据处理
选取关键特征 和 构建L特征
我们首先选取上图相关特征的列到airline_selection中,用于构建L特征和后面选取后四列与L列合并
LRFMC.py
######## 构建 LRFMC模型 ########
import pandas as pd
from log import *

class LRFMC:
    def __init__(self):
        self.log = Log()
        return
    def getFeatures(self,airline):
        # 选取需求特征
        airline_selection = airline[["FFP_DATE","LOAD_TIME",
                                     "FLIGHT_COUNT","LAST_TO_END",
                                     "avg_discount","SEG_KM_SUM"]]
        # 构建L特征
        L = pd.to_datetime(airline_selection["LOAD_TIME"]) \
            - pd.to_datetime(airline_selection["FFP_DATE"])
        self.log(LOG_DEBUG,"\n",L[:5])  #测试前五行
        # 转成月份
        L = L.astype("str").str.split().str[0]
        L = L.astype("int")/30

        #合并特征
        airline_features = pd.concat([L,
                airline_selection.iloc[:,2:]],axis = 1)  #axis=1使函数按列合并,[:,2:]舍弃了原本的前两列
        airline_features =airline_features.rename(columns={0:"L"}) # 重命名没有名字的列
        self.log(LOG_DEBUG,"\n",airline_features.head())  #缺省参数为5,打印前五行
        return airline_features
标准化
完成五个特征的构建以后,对每个特征数据分布情况进行分析,其数据的取值范围如下表所示。从表中数据可以发现,五个特征的取值范围数据差异较大,为了消除数量级数据带来的影响,需要对数据做标准化处理。

这里使用 sklearn模块中的 StandardScaler类来自动标准化数据,然后我们将标准化后的数据再转成pandas表格,最后储存到临时文件airline_scale.xlsx中
LRFMC.py
    def storeStandData(self,airline_features):
        data = StandardScaler().fit_transform(airline_features)
        SDF = pd.DataFrame(data);  #获取 standardDataFrame(SDF)
        SDF = SDF.rename(columns={0:"L",1:"F",2:"R",3:"C",4:"M"})
        self.log(LOG_INFO,"标准化后的前五行的LRFMC五个特征为\n",SDF.head())
        SDF.to_excel("../tmp/airline_scale.xlsx")  ##储存值tmp文件夹
前五行标准化前后的结果如下


了解和使用K-Means聚类算法
即使经过了一系列预处理和模型建模,我们手上的数据依然还是比较原始,只有经过分类过的数据才更有分析价值,而自然数据一般都难以直接分类,需要用聚类算法进行分类,这里就用到了K-Means聚类算法
基本概念
K-Means聚类算法是一种基于质心的划分方法,输入聚类个数k,以及包含n个数据对象的数据库,输出满足误差平方和最小标准的k个聚类。算法步骤如下:
- 从n个样本数据中随机选取k个对象作为初始的聚类中心。
- 分别计算每个样本到各个聚类质心的距离,将样本分配到距离最近的那个聚类中心类别中。
- 所有样本分配完成后,重新计算k个聚类的中心。
- 与前一次计算得到的k个聚类中心比较,如果聚类中心发生变化,转(2),否则转(5)。
- 当质心不发生变化时停止并输出聚类结果。

数据类型
K-Means聚类算法是在数值类型数据的基础上进行研究,然而数据分析的样本复杂多样,因此要求不仅能够对特征为数值类型的数据进行分析,还要适应数据类型的变化,对不同特征做不同变换,以满足算法的要求。
获取KMeans对象
sklearn的cluster模块提供了KMeans函数构建K-Means聚类模型
翻阅其源代码(下图),可以看到KMeans是一个类,且构造函数有大量缺省参数,因此实例化KMeans对象时,只需提供无缺省的参数,和调整关键缺省参数即可


这里我们只显式传参n_clusters和random_state,其中后一个参数用时间戳
因为本身KMeans就封装地很好,这部分代码就写在main.py的主逻辑中
main.py
    ## 对象实例化
    k = 5 ## 确定聚类中心数,这里我们预期聚类5类客户
    kmeans_model = KMeans(n_clusters=k,random_state=int(time.time()))  # 实例化对象
    kmeans_model = kmeans_model.fit(airline_scale)  # 用准备好的数据训练模型
    centers = kmeans_model.cluster_centers_
    log(LOG_INFO,"五个聚类中心为\n",centers)

    ## 统计不同类别样本的数目
    r1 = pd.Series(kmeans_model.labels_).value_counts()
    log(LOG_INFO,"最终每个类别的数目为\n",r1)
最后聚类的结果类似下表

至此数据的分析,建模和聚类已经完成,数据处理部分告一段落,接下来是可视化处理
可视化雷达图
这里使用matplotlib.pyplot模块作图,numpy二次处理数据,封装代码到RadarDrawer类中并用__call__重载()操作符
值得注意的是:
- 因为这里使用了雷达图,所以绘制图形时使用
极坐标会更方便 - 因为这里使用了中文文字,而默认字体不支持中文,会报错,所以要提前设置中文字体
radar_chart.py
import matplotlib.pyplot as plt
import numpy as np

class RadarDrawer():
    def __init__(self):
        return

    def __call__(self, kmeans_moudel, n_clusters):
        # 设置支持中文的字体
        plt.rc("font",family="Microsoft YaHei")
        # 标签
        labels = np.array([u'ZL',u'ZR',u'ZF',u'ZM',u'ZC'])

        plot_data = kmeans_moudel.cluster_centers_
        # 指定颜色
        color = ['b','g','r','c','y']
        # 计算雷达图的角度
        angles = np.linspace(0,2*np.pi,n_clusters,endpoint=False)

        # 闭合(首尾列相同) 并用np把pandas的DataFrame转成原生数组
        plot_data = np.concatenate((plot_data,plot_data[:,[0]]),axis = 1)
        angles_org = angles
        angles = np.concatenate((angles,[angles[0]]))

        fig = plt.figure(figsize=(6,6),dpi = 160)
        #polar参数
        ax = fig.add_subplot(111, polar=True)  # 设置坐标为极坐标
        # 画若干个五边形
        floor = np.floor(plot_data.min())   # 大于最小值的最大整数
        ceil = np.ceil(plot_data.max())     # 小于最小值的最小整数
        n = len(labels)
        for i in np.arange(floor,ceil+0.5, 0.5):
            ax.plot(angles,[i] *(n+1),'-.',lw=0.5,color='black')
        # 话不同客户群的分割线
        for i in range(len(plot_data)):
            ax.plot(angles,plot_data[i],color = color[i],
                    label='客户群'+str(i+1),linewidth=2, linestyle='-.')
        ax.set_rgrids(np.arange(0,2.5, 0.5))  # 画出每层的权重
        ax.set_thetagrids(angles_org* 180/np.pi,labels)  # 设置显示的角度为度数制
        plt.legend(loc='lower right',bbox_to_anchor=(1.1, -0.1))  #设置图例位置在画布外
        #plt.legend()

        #ax.set_theta_zero_location('N')         # 设置极坐标的起点(即0°)在正北方向
        ax.spines['polar'].set_visible(False)   # 不显示极坐标最外面的圈
        ax.grid(False)                          # 不显示默认分割线
        plt.savefig("../tmp/ACVA_img.png")      # 储存图像的临时文件
        plt.show()
重新组织main.py
至此所有的功能已经实现,并封装到了各个模块和类中,所以我们再重新组织一次main.py,并最终定档其中的代码
main.py
######### 主程序入口 #############
import pandas as pd
from sklearn.cluster import KMeans
import time

from log import *
from data_clean import *
from LRFMC import *
from radar_chart import  *

if __name__ == '__main__':

    log = Log()  # 实例化一个日志器
    data_cleaner = DataCleaner() #实例化数据清洗器
    LRFMCobj = LRFMC() # 实例化模型处理器

    # 从数据源获取数据
    airline_data = pd.read_csv("../data_raw/air_data.csv",
        encoding="gb18030")  # 导入航空数据
    log(LOG_INFO,'原始数据的形状为:', airline_data.shape)

    #数据预处理
    ## 缺失值处理:去除票价为空的记录
    airline_notnull = data_cleaner.notNull(airline_data)
    log(LOG_INFO,'删除缺失记录后数据的形状为:', airline_notnull.shape)

    ## 异常值处理: 只保留票价非零的,或者平均折扣率不为0且总飞行公里数大于0的记录。
    airline = data_cleaner.notOutlier(airline_notnull)
    log(LOG_INFO,'删除异常记录后数据的形状为:', airline.shape)

    # 构建LRFMC五大特征
    airline_features = LRFMCobj.getFeatures(airline)
    LRFMCobj.storeStandData(airline_features)

    # 获取KMeans对象
    ## 准备数据
    airline_scale = pd.read_excel("../tmp/airline_scale.xlsx")
    airline_scale = airline_scale.iloc[:,1:]  # 切掉第一列的作为行数标志的数字

    ## 对象实例化
    k = 5 ## 确定聚类中心数,这里我们预期聚类5类客户
    kmeans_model = KMeans(n_clusters=k,random_state=int(time.time()))  # 实例化对象
    kmeans_model = kmeans_model.fit(airline_scale)  # 用准备好的数据训练模型
    centers = kmeans_model.cluster_centers_
    log(LOG_INFO,"五个聚类中心为\n",centers)

    ## 统计不同类别样本的数目
    r1 = pd.Series(kmeans_model.labels_).value_counts()
    log(LOG_INFO,"最终每个类别的数目为\n",r1)

    # 作出图样
    RadarDrawer()(kmeans_model,n_clusters=k)
    log(LOG_INFO,"完成作图")
可以看到,经过一系列封装,main.py只有寥寥50多行,确已经体现了主要的 业务逻辑
分析聚类结果

基于特征描述,本项目定义五个等级的客户类别:重要保持客户,重要发展客户,重要挽留客户,一般客户,低价值客户
模型应用
根据对各个客户群进行特征分析,采取下面的一些营销手段和策略,为航空公司的价值客户群管理提供参考
会员的升级与保级:航空公司可以在对会员升级或保级进行评价的时间点之前,对那些接近但尚未达到要求的较高消费客户进行适当提醒甚至采取一些促销活动,刺激他们通过消费达到相应标准。这样既可以获得收益,同时也提高了客户的满意度,增加了公司的精英会员。首次兑换:采取的措施是从数据库中提取出接近但尚未达到首次兑换标准的会员,对他们进行提醒或促销,使他们通过消费达到标准。一旦实现了首次兑换,客户在本公司进行再次消费兑换就比在其他公司进行兑换要容易许多,在一定程度上等于提高了转移的成本。交叉销售:通过发行联名卡等与非航空类企业的合作,使客户在其他企业的消费过程中获得本公司的积分,增强与公司的联系,提高他们的忠诚度。
小结
本项目结合航空公司客户价值分析的案例,重点介绍了数据分析算法中K-Means聚类算法在客户价值分析中的应用。针对RFM客户价值分析模型的不足,使用K-Means算法构建了航空客户价值分析LRFMC模型,详细描述了数据分析的整个过程。
 335


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


