AI入门学习-Python 最主流的机器学习库Scikit-learn

【Python篇】Scikit-Learn 【Python篇】从零到精通:全面分析Scikit-Learn在机器学习中的绝妙应用第一章:Scikit-Learn基础入门 (Scikit-Learn Fundamentals)1.1 什么是Scikit-Learn? (What is Scikit-Learn?)Scikit-Learn是一个基于Python语言的免费机器学习库。它的名字来源于“SciPy Toolkit”,意指它是建立在SciPy(Scientific Python)库之上的一个工具集,专注于机器学习算法的实现。Scikit-Lear 阅读详情

一、Scikit-learn 核心定位

是什么:Python 最主流的机器学习库,涵盖从数据预处理到模型评估的全流程。
为什么测试工程师必学:

  • ✅ 80% 的测试机器学习问题可用它解决

  • ✅ 无需深厚数学基础,API 设计极简

  • ✅ 与 Pandas/Numpy 无缝集成,完美处理测试数据


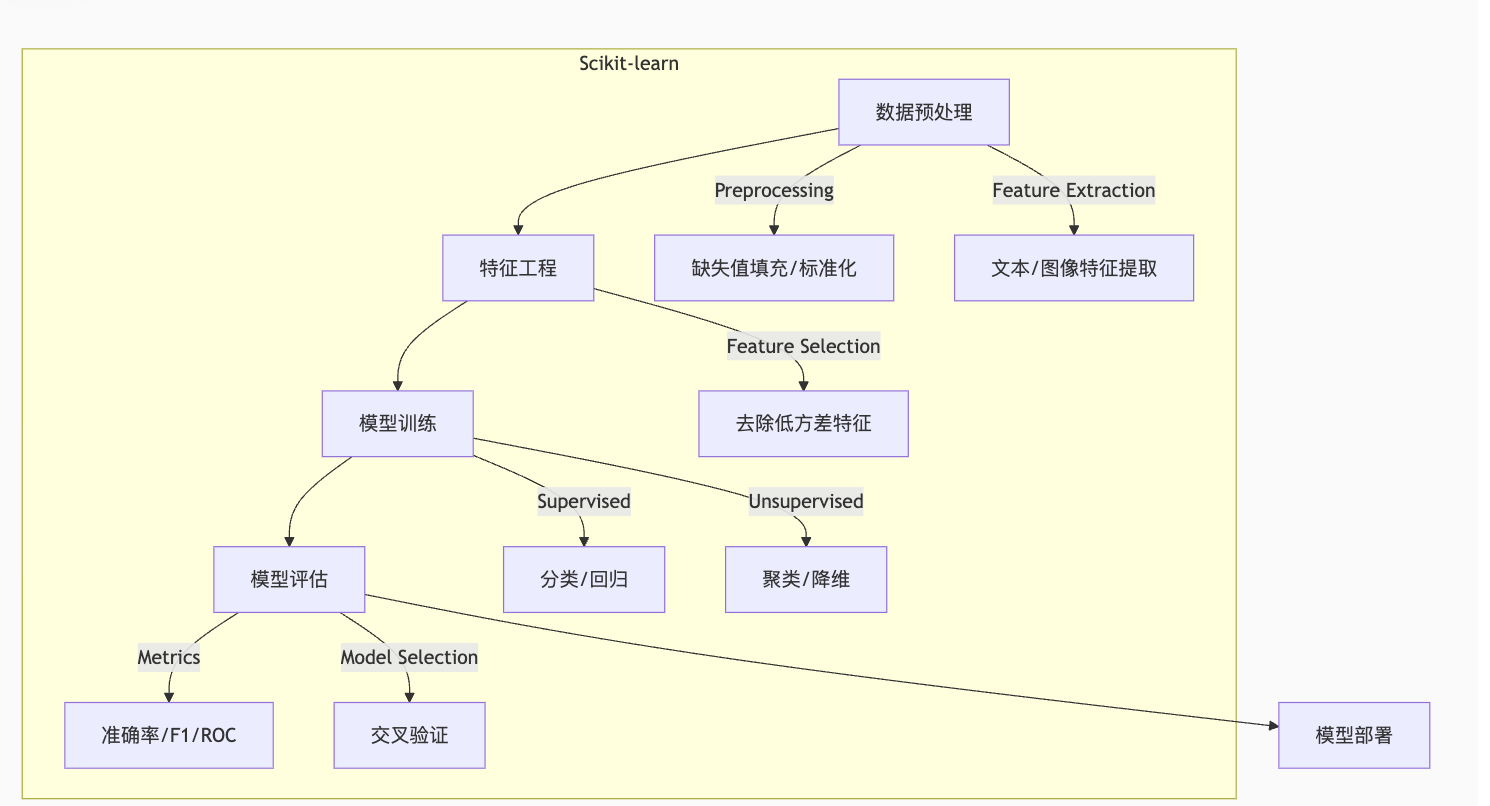
二、Scikit-learn 核心模块图解

三、测试工程师必掌握的 6 大核心功能

1. 数据预处理:清洗混乱的测试数据

测试痛点:测试日志缺失值、环境配置数值差异大

python

from sklearn.impute import SimpleImputer
from sklearn.preprocessing import MinMaxScaler

# 处理测试执行时间的缺失值(用中位数填充)
imputer = SimpleImputer(strategy='median')
test_data['execution_time'] = imputer.fit_transform(test_data[['execution_time']])

# 将环境配置参数归一化(如内存:4GB/16GB → 0.25/1.0)
scaler = MinMaxScaler()
test_data[['cpu_cores', 'memory_gb']] = scaler.fit_transform(test_data[['cpu_cores', 'memory_gb']])
2. 文本特征提取:分析缺陷报告

测试场景:自动分类缺陷报告(崩溃/性能/UI)

python

from sklearn.feature_extraction.text import TfidfVectorizer

# 将缺陷描述转为数值特征
bug_descriptions = ["UI按钮点击无响应", "API响应超时5s", "APP启动时崩溃"]
vectorizer = TfidfVectorizer(max_features=1000)  # 提取最重要的1000个词
X_text = vectorizer.fit_transform(bug_descriptions)

# 输出:<3x1000 sparse matrix> 可用于训练分类模型
3. 分类模型:预测测试用例失败概率

测试场景:优先执行高失败风险的测试用例

python

from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split

# 特征:测试用例复杂度 + 历史失败率 + 关联代码变更次数
X = test_cases[['complexity', 'historical_fail_rate', 'code_changes']]
y = test_cases['failed']  # 标签:0=通过, 1=失败

# 拆分数据集(测试集永远隔离!)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 训练随机森林
model = RandomForestClassifier(n_estimators=100)
model.fit(X_train, y_train)

# 预测新测试用例失败概率
new_case = [[5, 0.3, 8]]  # 复杂度=5, 失败率=30%, 变更次数=8
fail_prob = model.predict_proba(new_case)[0][1]  # 输出:0.87 (87%概率失败)
4. 聚类分析:自动归档相似缺陷报告

测试场景:减少重复缺陷报告处理时间

python

from sklearn.cluster import KMeans
from sklearn.feature_extraction.text import TfidfVectorizer

# 1. 提取文本特征
vectorizer = TfidfVectorizer(stop_words='english')
X = vectorizer.fit_transform(bug_reports['description'])

# 2. 聚类相似缺陷(假设分5类)
kmeans = KMeans(n_clusters=5, random_state=42)
clusters = kmeans.fit_predict(X)

# 3. 结果分析
bug_reports['cluster'] = clusters
print(bug_reports.groupby('cluster')['description'].count())  # 查看每类缺陷数量
5. 回归模型:预测测试执行时间

测试场景:优化测试资源调度

python

from sklearn.linear_model import Ridge
from sklearn.metrics import mean_absolute_error

# 特征:测试步骤数 + 涉及服务数 + 数据量大小
X = tests[['step_count', 'services_involved', 'data_size_mb']]
y = tests['execution_time_sec']

# 训练回归模型
model = Ridge(alpha=1.0)
model.fit(X_train, y_train)

# 评估模型
y_pred = model.predict(X_test)
mae = mean_absolute_error(y_test, y_pred)  # 平均绝对误差:12.3秒
6. 模型评估:验证测试效果

测试工程师必须掌握的评估技术:

python

from sklearn.metrics import classification_report, confusion_matrix

# 分类模型评估
y_pred = model.predict(X_test)
print(classification_report(y_test, y_pred))
print("混淆矩阵:\n", confusion_matrix(y_test, y_pred))

# 输出示例:
              precision  recall  f1-score   support
           0       0.92      0.95      0.93       120  # 通过类
           1       0.88      0.82      0.85        60  # 失败类
    accuracy                           0.91       180

四、Scikit-learn 在测试中的典型应用场景

测试领域问题类型推荐算法应用效果
缺陷优先级分类文本分类SGDClassifier (TF-IDF)自动区分 P0/P1/P2 缺陷
测试失败根因分析多分类问题RandomForest识别失败原因:环境/数据/代码缺陷
性能瓶颈预测回归分析GradientBoostingRegressor提前发现接口响应时间劣化
测试用例去冗余聚类DBSCAN合并高度相似的测试用例
视觉测试差异检测图像特征 + 分类PCA + SVM识别UI细微差异

 五、实操举例说明


# 场景:自动分类缺陷报告


from sklearn.cluster import KMeans
from sklearn.feature_extraction.text import TfidfVectorizer
import pandas as pd

# 1. 提取文本特征
vectorizer = TfidfVectorizer(stop_words='english')
bug_reports = {
    'description': ['登录页无响应', '无法提交表单', '密码重置失败', '登录超时', '验证码不显示','按钮无法点击','按钮点击无反应','字符取值错误'],
    'cluster': []
}
X = vectorizer.fit_transform(bug_reports['description'])

# 2. 聚类相似缺陷(假设分5类)
kmeans = KMeans(n_clusters=5, random_state=42)
clusters = kmeans.fit_predict(X)

# 3. 结果分析
bug_reports['cluster'] = clusters
df = pd.DataFrame(bug_reports)

# 按聚类分组后,打印每个聚类的具体描述
for cluster_id, group in df.groupby('cluster'):
    print(f"聚类 {cluster_id} 包含的缺陷:")
    for desc in group['description']:
        print(f"- {desc}")
    print("---")
  • vectorizer = TfidfVectorizer(stop_words='english')
    • 作用是创建一个TF-IDF 文本特征提取器,用于将文本数据转换为数值特征向量。
    • TfidfVectorizer:这是 scikit-learn 库中用于实现 TF-IDF算法的工具类,它能把人类可读的文本翻译成机器学习算法能理解的数字向量,同时还会自动忽略无意义的常用词,让翻译结果更精准。

      • TF(词频):衡量一个词在某篇文档中出现的频率,出现次数越多,权重越高。
      • IDF(逆文档频率):衡量一个词在所有文档中的普遍重要性,在越少文档中出现的词(越独特),权重越高。
        两者结合可以将文本转换为能体现词语重要性的数值向量。
    • stop_words='english':这是一个参数设置,表示在处理文本时会自动过滤掉英文停用词(如 "the"、"and"、"is" 等)。
      这些词在英文中出现频率极高,但通常不携带实际语义,过滤后可以减少噪音,让特征更聚焦于有意义的词汇。

  • vectorizer.fit_transform(bug_reports['description'])

    • 将文本数据转换为机器学习算法可处理的数值特征矩阵,是文本特征提取的核心步骤。它完成了两个关键操作:

      • 拟合(fit):让 vectorizer(TF-IDF 提取器)“学习” 文本数据的特征,包括:

        • 分析所有文本中的词汇,构建一个词汇表(比如将 “登录”“响应”“表单” 等词映射为唯一的索引)。
        • 计算每个词的 IDF(逆文档频率)值,评估其在整个文本集合中的重要性。
      • 转换(transform):将原始文本数据转换为 TF-IDF 数值矩阵:

        • 矩阵 X 的每一行对应一个文本(如一条缺陷报告)。
        • 每一列对应词汇表中的一个词。
        • 矩阵中的数值是该词在对应文本中的 TF-IDF 分数(综合了词频和重要性的权重)。
  • KMeans
    • 是一种经典的无监督聚类算法,全称为 K - 均值聚类(K-Means Clustering)。它的核心作用是:将一堆没有标签的数据,自动划分成 K 个不同的组别(聚类),使得同一组内的数据相似度高,不同组的数据相似度低。
  • kmeans = KMeans(n_clusters=5, random_state=42)
    • random_state=42 是为了保证代码运行结果的可重复性而设置的参数。相当于给随机过程设定了一个 “种子值”(这里的种子是 42)。无论你运行多少次代码,只要 random_state 保持不变,算法中涉及的随机操作都会产生相同的结果。
    • 以 KMeans 为例,它在初始阶段会随机选择 K 个聚类中心,这个随机选择会影响最终的聚类结果 —— 即使是同一组数据,不同的初始中心可能会得到略有差异的聚类结果。
    • 为什么是42 ?这是编程领域的一个 “梗”(源自《银河系搭车客指南》中 “生命、宇宙及一切的终极答案是 42”)。实际使用中,你可以换成任何整数(如 0、100 等),只要保持固定,就能保证结果可重复。
  • clusters = kmeans.fit_predict(X)
    • 对特征矩阵 X 执行 KMeans 聚类,并返回每个样本所属的聚类标签。
  • df = pd.DataFrame(bug_reports)
    • 将字典格式的 bug_reports 转换为 pandas 数据框(DataFrame),方便进行数据处理和分析。
Scikit-learn (`sklearn`) 教程 除了使用提供的标准模型外,你还可以通过继承和自定义自己的估计器。# 创建并使用自定义分类器。 阅读详情

相关推荐

【大虾送书第二期】《Python机器学习:基于PyTorch和Scikit-Learn 》

Python深度学习“四大名著”之一全新PyTorch版!PyTorch核心维护者Dmytro Dzhulgakov亲笔作序推荐!从初学者角度,带你全面了解现代机器学习技术并从零开始动手实践

大虾好吃吗 3685

深入Scikit-learn:掌握Python最强大的机器学习库

Scikit-learn是一个开源的Python机器学习库,它建立在NumPy、SciPy和Matplotlib之上,提供了大量的机器学习算法和工具,适用于各种机器学习任务,如分类、回归、聚类、降维等。Scikit-learn的设计遵循简洁、一致的API接口,使得用户可以轻松地从数据预处理到模型评估的整个机器学习流程中进行操作。它还提供了丰富的文档和示例,帮助用户快速上手和解决问题。Scikit-learn允许用户自定义扩展,以满足特定需求。可以通过继承和(或)来创建自定义模型。# 使用自定义分类器。

实践是检验真理的唯一标准 1万+

Python 学习之旅,持续学习和扩展(九)学习 scikit-learn 进行机器学习入门

的诞生,旨在让机器学习变得更加简单易用。它基于numpyscipy和matplotlib等库构建,提供了丰富且高效的机器学习算法和工具。无论是预测明天的天气,还是分析客户的购买行为,都能发挥重要作用。例如,在电商领域,它可以通过分析用户的浏览历史和购买记录,实现个性化推荐;在医疗领域,能够辅助医生根据患者的症状和检查结果进行疾病诊断。

happycell188的博客 1796

Scikit-Learn快速入门

Scikit-learn 是一个强大的 Python 库,广泛用于数据挖掘和机器学习任务。它提供了丰富的算法和工具,支持分类、回归、聚类、降维等常见机器学习任务。通过简洁的一致性 API,用户可以轻松实现数据预处理、模型训练、评估和优化等流程。Scikit-learn 还支持多种模型评估方法、数据集生成工具,并可与其他科学计算库(如 NumPy 和 pandas)无缝结合,是机器学习入门和快速原型开发的理想选择。

u012121721的博客 5438

Python与机器学习库Scikit-learn实战

对于初学者而言,建议先从经典的案例入手,例如著名的鸢尾花数据集(Iris dataset),它包含150个样本,每个样本有4个特征:萼片长度、萼片宽度、花瓣长度、花瓣宽度,以及一个类别标签,共有三个类别。通过上述示例,我们可以看到Scikit-learn的强大之处,它不仅简化了机器学习的过程,还让开发者能够专注于解决问题本身,而不是繁琐的技术细节。例如,可以从Kaggle下载一些公开的数据集,比如房价预测数据集,这样的数据集通常包含了更多的特征和更复杂的关系,可以更好地锻炼我们的技能。

master_chenchen的博客 1388

开源机器学习工具scikit-learn入门

开源机器学习工具scikit-learn入门。

xuanyuansen的专栏 6万+

Python机器学习库scikit-learn实践

Python机器学习库scikit-learn实践zouxy09@qq.comhttp://blog.youkuaiyun.com/zouxy09 一、概述       机器学习算法在近几年大数据点燃的热火熏陶下已经变得被人所“熟知”,就算不懂得其中各算法理论,叫你喊上一两个著名算法的名字,你也能昂首挺胸脱口而出。当然了,算法之林虽大,但能者还是有限,能适应某些环境并取得较好效果的算法会脱颖而出,而表现平平者

zouxy09的专栏 10万+

什么是机械学习?及Scikit-learn机械学习库

1、什么是机器学习 机器学习是人工智能的一个分支; 机器学习是实现人工智能的一个途径(即以机器学习为手段解决人工智能中的问题); 机器学习算法是一类从数据中自动分析获得规律(模型),并利用规律对未知数据进行预测的算法。 2、为什么需要机器学习 21世纪机器学习又一次被人们关注,而这些关注的背后是因为整个环境的改变,我们的数据量越来越多,硬件越来越强悍; 急需要解放人的生产力,自动去寻找数据的...

tigerlib的博客 7231

机器学习库Scikit-learn

本文目录3.1 背景知识3.2 Scikit-learn概述3.3 Scikit-learn主要用法3.3.1 基本建模流程3.3.2 数据预处理3.3.3 监督学习算法3.3.4 无监督学习算法3.3.5 评价指标3.3.6 交叉验证及超参数调优3.4 Scikit-learn总结参考文献Scikit-learn是基于NumPy、SciPy和Matplotlib的开源Python机器学习包,它封...

fengdu78的博客 8633

Scikitlearn算法简介及其特点

作者:禅与计算机程序设计艺术 1.简介 Scikit-learn (读音 /səkɪ'leɪni/(英语),[德语: scikit learn] )是一个基于Python的开源机器学习库,它实现了许多分类、回归、聚类等常用机器学习算法。本文将介绍scikit-learn中最基础、最常用的算法——

AI天才研究院 8179

AI机器学习实战 | 使用 Python 和 scikit-learn 库进行情感分析

上述代码完成了一个简单的情感分析任务。根据具体需求和数据集,您可能需要调整预处理步骤、特征提取方法和支持向量机参数。此外,还可以尝试使用其他机器学习算法,如神经网络、决策树、随机森林等,以提高模型性能。以上代码只是一个简单的机器学习项目示例,实际应用中可能需要根据具体任务和数据类型进行调整。此外,根据实际需求,您可能还需要学习更多的机器学习算法和高级技巧,如神经网络、深度学习、集成学习等。情感分析是自然语言处理领域的一个热门课题,AI 和机器学习技术在情感分析中有着广泛的应用。

AI时代光年 7901

用Python进行机器学习:Scikit-learn的入门与实践

随着机器学习在各个领域的广泛应用,Python成为了一个备受欢迎的机器学习工具之一。在众多机器学习库中,Scikit-learn因其简单易用、功能强大而备受青睐。本文将介绍Scikit-learn的基本概念,以及如何在Python中使用它进行机器学习的实践。

一键难忘的博客 4446

手把手教你用三菱PLC控制JET伺服原点:从硬件接线到GXWORKS3程序调试

本文详细介绍了如何使用三菱PLC控制JET伺服系统实现原点回归功能,涵盖硬件接线、参数配置到GX Works3程序调试的全流程。通过实战指南,帮助工程师快速掌握伺服控制技术,提升工业自动化项目的实施效率。

weixin_30642561的博客 536

【升华】人工智能python重要库scikit-learn学习

鸢尾花数据(iris)数据集一共有150行数据,每行包含5个变量,其中4个特征变量,1个目标分类变量。共有150个样本,目标变量为“花的类别”其都属于鸢尾属下的三个亚属,分别是变色鸢尾(Iris-versicolor)、山鸢尾(Iris-setosa)和维吉尼亚鸢尾(Iris-virginica)。包含的三种鸢尾花的四个特征,分别是花萼长度(sepal length)、花萼宽度(sepal width)、花瓣长度(petal length)、花瓣宽度(petal width)。

JAVA领域优质创作者,基于分片网络查询方法专利发明者。 1972

了解随机振动疲劳分析中 Ansys nCode DesignLife 的平均应力校正

通过选择静态环境,我们可以将其结果视为疲劳计算的平均应力,如图 3 所示,因此从静态偏移载荷工况中提取的平均应力用于转移预测雨流计数中所有循环的平均值。您可以通过观看下面的教学视频获得宝贵的见解,该视频将指导您完成利用 Ansys nCode DesignLife 分析平均应力对随机振动载荷下结构的影响的过程。它基于 R 比率或平均应力水平。另一方面,平均应力校正可以帮助消除平均应力的负面影响,提高结果的保真度。Ansys nCode 提供先进的平均应力校正技术,使工程师能够考虑平均应力对疲劳寿命的影响。

jkh920184196的博客 1520

STM32电机库(ST-MC-Workbench)实战指南——三电阻电流采样电路参数配置详解

本文详细解析了STM32电机库(ST-MC-Workbench)中三电阻电流采样电路的参数配置方法,涵盖电阻选型、放大增益计算、滤波时间优化等关键步骤。通过实战案例和调试技巧,帮助工程师快速掌握电流采样技术,提升电机控制系统的精度与稳定性。特别针对ST-MC-Workbench界面参数设置提供了详细指导。

weixin_29186249的博客 509

AI人工智能(3):Python 入门机器学习

Python 是机器学习中最常用的编程语言之一,因其易于学习、强大的库支持和社区生态系统。接下来,我将逐步说明如何通过 Python 入门机器学习,并介绍需要的一些常用库。首先,确保你已经安装了 Python,你可以访问Python 官方网站下载和安装最新版本。如果你还不熟悉 Python,可以先看之前的python入门教程。- 例如,NumPy、Pandas 和 Scikit-learn。- 数据是机器学习的核心。你需要加载数据并进行必要的预处理(例如数据清洗、缺失值填补等)。

游王子og的博客 1571

SpringBoot 系列教程(十二):给大家推荐20个SpringBoot开源项目,私活必备

基于 SpringBoot2.x + Shiro 实现了用户管理、个人微信、支付宝支付,内置扫码支付、后台回调、订单查询、限流等一系列功能

Thinkingcao的专栏 2840

Python机器学习库scikit-learn

概述scikit-learn 是机器学习领域非常热门的一个开源库,基于Python 语言写成。可以免费使用。 而且使用非常的简单,文档感人,非常值得去学习。下面是一张scikit-learn的图谱:我们可以看到,机器学习分为四大块,分别是 classification (分类), clustering (聚类), regression (回归), dimensionality reduction (

yqtao的博客 8932

25、BDS-3卫星信号性能与PPP-B2b增强消息完整性分析

本文对BDS-3卫星信号性能及PPP-B2b增强消息的完整性进行了系统分析。评估了MEO、IGSO和GEO卫星的轨道与时钟精度,得出BDS-3总体SISRE为0.25 m,系统完整性可覆盖99.999%的误差。分析表明SIS中断主要由时钟调整和轨道机动引起,个别卫星存在因境外监测受限导致的非计划中断。通过自研解码软件对PPP-B2b增强消息进行采集与解析,实验结果显示BDS-3和GPS的平均历元完整性率均高于98.55%,其中卫星掩码和时钟校正消息的完整性率超过99.8%。研究还发现IGSO卫星相比MEO卫

quiet的专栏 145

LVGL 组件对齐方式说明

本文说明 LVGL(以 v8 为例)中常用的 lv_align_t对齐选项的含义与用法,对应界面设计工具里下拉列表中的以及等命名。

摸鱼专家 133

【Python学习】人工智能-机器学习工具包Scikit-learn

通过本文,你应该已经学会了如何使用 Scikit-learn 进行数据预处理、模型训练、评估和调优。Scikit-learn 提供了丰富的工具和方法,使得机器学习变得更加简单和高效。希望本文对你有所帮助,祝你在机器学习的道路上取得更大的进步!

墨夶的博客 1282

GitLab CI/CD .gitlab-ci.yml 关键词(十一):发布版本 release

本篇文章介绍使用GitLab CI/CD 发布一个版本,对外发布。并填写一些发布的信息。

知无涯 4723

大数据机器学习深入Scikit-learn:掌握Python最强大的机器学习库

Scikit-learn是一个强大且易用的Python库,它为我们提供了一整套的机器学习工具,可以用于解决从数据预处理,到模型训练,再到模型评估和参数调优的全流程任务。Scikit-learn的广泛应用,不仅仅因为它的功能强大,更因为它的设计理念——统一的API,使得我们可以快速地切换不同的模型和算法,而不需要对代码进行大的修改。这种灵活性和易用性,使得Scikit-learn成为了Python机器学习库的首选。

专注 AI、大数据、Python、爬虫、数据分析可视化、机器学习、推荐算法、知识图谱、大模型应用与全栈系统开发,长期沉淀真实项目案例、源码解析、系统设计、部署经验与工程化实践,分享可运行、可复用、可落地的技术方案。 2403

[系统安全] 三十二.恶意代码检测(2)常用技术详解及总结

前文从产业界和学术界分别详细讲解恶意代码攻击溯源的相关知识,在学术界方面,用类似于综述来介绍攻击追踪溯源的不同方法;在产业界方面,主要参考李东宏老师从企业恶意样本分析的角度介绍溯源工作。这篇文章将详细总结恶意代码检测技术,包括恶意代码检测的对象和策略、特征值检测技术、校验和检测技术、启发式扫描技术、虚拟机检测技术和主动防御技术。希望这篇文章对您有所帮助,如果文章中存在错误、理解不到位或侵权的地方,还请告知作者与海涵。且看且珍惜,加油~

杨秀璋的专栏 1万+

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Python scikit-learn 机器学习算法实践

继上一篇, 我们接下来介绍人工智能常用的机器学习库。在数据分析和预测建模领域,Scikit-learn 是一个功能强大且易于使用的 Python 机器学习库。本文将通过几个示例,介绍如何使用 Scikit-learn 进行监督学习(分类和回归)以及无监督学习(聚类和降维)。

SiArch的博客 1703

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

上一篇: AI入门学习-特征工程
下一篇: web前端调试
sssammmm
博客等级 码龄9年 369粉丝 42原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值