将SVM用于多类分类

支持向量机SVM代码详解——多分类/降维可视化/参数优化【python】 主要介绍数学建模以及大数据比赛中常用的SVM支持向量机模型算法,并使用python实现实例二分类、多分类、可视化以及参数优化。 阅读详情

从 SVM的那几张图可以看出来,SVM是一种典型的两类分类器,即它只回答属于正类还是负类的问题。而现实中要解决的问题,往往是多类的问题(少部分例外,例如垃圾邮件过滤,就只需要确定“是”还是“不是”垃圾邮件),比如文本分类,比如数字识别。如何由两类分类器得到多类分类器,就是一个值得研究的问题。

还以文本分类为例,现成的方法有很多,其中一种一劳永逸的方法,就是真的一次性考虑所有样本,并求解一个多目标函数的优化问题,一次性得到多个分类面,就像下图这样:
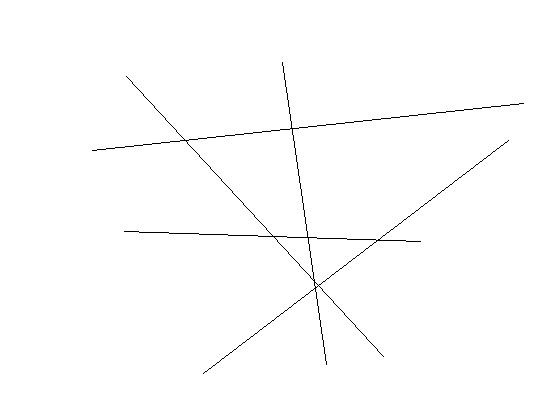
clip_image001

多个超平面把空间划分为多个区域,每个区域对应一个类别,给一篇文章,看它落在哪个区域就知道了它的分类。

看起来很美对不对?只可惜这种算法还基本停留在纸面上,因为一次性求解的方法计算量实在太大,大到无法实用的地步。

稍稍退一步,我们就会想到所谓“一类对其余”的方法,就是每次仍然解一个两类分类的问题。比如我们有5个类别,第一次就把类别1的样本定为正样本,其余2,3,4,5的样本合起来定为负样本,这样得到一个两类分类器,它能够指出一篇文章是还是不是第1类的;第二次我们把类别2 的样本定为正样本,把1,3,4,5的样本合起来定为负样本,得到一个分类器,如此下去,我们可以得到5个这样的两类分类器(总是和类别的数目一致)。到了有文章需要分类的时候,我们就拿着这篇文章挨个分类器的问:是属于你的么?是属于你的么?哪个分类器点头说是了,文章的类别就确定了。这种方法的好处是每个优化问题的规模比较小,而且分类的时候速度很快(只需要调用5个分类器就知道了结果)。但有时也会出现两种很尴尬的情况,例如拿一篇文章问了一圈,每一个分类器都说它是属于它那一类的,或者每一个分类器都说它不是它那一类的,前者叫分类重叠现象,后者叫不可分类现象。分类重叠倒还好办,随便选一个结果都不至于太离谱,或者看看这篇文章到各个超平面的距离,哪个远就判给哪个。不可分类现象就着实难办了,只能把它分给第6个类别了……更要命的是,本来各个类别的样本数目是差不多的,但“其余”的那一类样本数总是要数倍于正类(因为它是除正类以外其他类别的样本之和嘛),这就人为的造成了上一节所说的“数据集偏斜”问题。

因此我们还得再退一步,还是解两类分类问题,还是每次选一个类的样本作正类样本,而负类样本则变成只选一个类(称为“一对一单挑”的方法,哦,不对,没有单挑,就是“一对一”的方法,呵呵),这就避免了偏斜。因此过程就是算出这样一些分类器,第一个只回答“是第1类还是第2类”,第二个只回答“是第1类还是第3类”,第三个只回答“是第1类还是第4类”,如此下去,你也可以马上得出,这样的分类器应该有5 X 4/2=10个(通式是,如果有k个类别,则总的两类分类器数目为k(k-1)/2)。虽然分类器的数目多了,但是在训练阶段(也就是算出这些分类器的分类平面时)所用的总时间却比“一类对其余”方法少很多,在真正用来分类的时候,把一篇文章扔给所有分类器,第一个分类器会投票说它是“1”或者“2”,第二个会说它是“1”或者“3”,让每一个都投上自己的一票,最后统计票数,如果类别“1”得票最多,就判这篇文章属于第1类。这种方法显然也会有分类重叠的现象,但不会有不可分类现象,因为总不可能所有类别的票数都是0。看起来够好么?其实不然,想想分类一篇文章,我们调用了多少个分类器?10个,这还是类别数为5的时候,类别数如果是1000,要调用的分类器数目会上升至约500,000个(类别数的平方量级)。这如何是好?

看来我们必须再退一步,在分类的时候下功夫,我们还是像一对一方法那样来训练,只是在对一篇文章进行分类之前,我们先按照下面图的样子来组织分类器(如你所见,这是一个有向无环图,因此这种方法也叫做DAG SVM)

clip_image002

这样在分类时,我们就可以先问分类器“1对5”(意思是它能够回答“是第1类还是第5类”),如果它回答5,我们就往左走,再问“2对5”这个分类器,如果它还说是“5”,我们就继续往左走,这样一直问下去,就可以得到分类结果。好处在哪?我们其实只调用了4个分类器(如果类别数是k,则只调用k-1个),分类速度飞快,且没有分类重叠和不可分类现象!缺点在哪?假如最一开始的分类器回答错误(明明是类别1的文章,它说成了5),那么后面的分类器是无论如何也无法纠正它的错误的(因为后面的分类器压根没有出现“1”这个类别标签),其实对下面每一层的分类器都存在这种错误向下累积的现象。。

不过不要被DAG方法的错误累积吓倒,错误累积在一对其余和一对一方法中也都存在,DAG方法好于它们的地方就在于,累积的上限,不管是大是小,总是有定论的,有理论证明。而一对其余和一对一方法中,尽管每一个两类分类器的泛化误差限是知道的,但是合起来做多类分类的时候,误差上界是多少,没人知道,这意味着准确率低到0也是有可能的,这多让人郁闷。

而且现在DAG方法根节点的选取(也就是如何选第一个参与分类的分类器),也有一些方法可以改善整体效果,我们总希望根节点少犯错误为好,因此参与第一次分类的两个类别,最好是差别特别特别大,大到以至于不太可能把他们分错;或者我们就总取在两类分类中正确率最高的那个分类器作根节点,或者我们让两类分类器在分类的时候,不光输出类别的标签,还输出一个类似“置信度”的东东,当它对自己的结果不太自信的时候,我们就不光按照它的输出走,把它旁边的那条路也走一走,等等。

大Tips:SVM的计算复杂度

使用SVM进行分类的时候,实际上是训练和分类两个完全不同的过程,因而讨论复杂度就不能一概而论,我们这里所说的主要是训练阶段的复杂度,即解那个二次规划问题的复杂度。对这个问题的解,基本上要划分为两大块,解析解和数值解。

解析解就是理论上的解,它的形式是表达式,因此它是精确的,一个问题只要有解(无解的问题还跟着掺和什么呀,哈哈),那它的解析解是一定存在的。当然存在是一回事,能够解出来,或者可以在可以承受的时间范围内解出来,就是另一回事了。对SVM来说,求得解析解的时间复杂度最坏可以达到O(Nsv3),其中Nsv是支持向量的个数,而虽然没有固定的比例,但支持向量的个数多少也和训练集的大小有关。

数值解就是可以使用的解,是一个一个的数,往往都是近似解。求数值解的过程非常像穷举法,从一个数开始,试一试它当解效果怎样,不满足一定条件(叫做停机条件,就是满足这个以后就认为解足够精确了,不需要继续算下去了)就试下一个,当然下一个数不是乱选的,也有一定章法可循。有的算法,每次只尝试一个数,有的就尝试多个,而且找下一个数字(或下一组数)的方法也各不相同,停机条件也各不相同,最终得到的解精度也各不相同,可见对求数值解的复杂度的讨论不能脱开具体的算法。

一个具体的算法,Bunch-Kaufman训练算法,典型的时间复杂度在O(Nsv3+LNsv2+dLNsv)和O(dL2)之间,其中Nsv是支持向量的个数,L是训练集样本的个数,d是每个样本的维数(原始的维数,没有经过向高维空间映射之前的维数)。复杂度会有变化,是因为它不光跟输入问题的规模有关(不光和样本的数量,维数有关),也和问题最终的解有关(即支持向量有关),如果支持向量比较少,过程会快很多,如果支持向量很多,接近于样本的数量,就会产生O(dL2)这个十分糟糕的结果(给10,000个样本,每个样本1000维,基本就不用算了,算不出来,呵呵,而这种输入规模对文本分类来说太正常了)。

这样再回头看就会明白为什么一对一方法尽管要训练的两类分类器数量多,但总时间实际上比一对其余方法要少了,因为一对其余方法每次训练都考虑了所有样本(只是每次把不同的部分划分为正类或者负类而已),自然慢上很多。


【机器学习算法面试】(三)从感知机到支持向量机&支持向量机的多分类方法 前言本篇文章是个人对于从感知机到支持向量机的整个过程的思考和推理:❝感知机--->缺陷--->加入约束/优化策略(为什么可行)--->支持向量机❞不涉及支持向量机的学习过... 阅读详情

相关推荐

opencv中的SVM图像分类(二)

原创作品 转载请注明出http://blog.youkuaiyun.com/always2015/article/details/47107129

去实验室,奔跑吧 4万+

SVM实现多分类

SVM本身是一个二值分类器。SVM算法最初是为二值分类问题设计的,当处理多类问题时,就需要构造合适的多类分类器。目前,构造SVM多类分类器的方法主要有两类:直接法 和 间接法。 1. 直接法 直接在目标函数上进行修改,将多个分类面的参数求解合并到一个最优化问题中,通过求解该最优化问题“一次性”实现多类分类。这种方法看似简单,但其计算复杂度比较高,实现起来比较困难,只适合用于小型问题中。 2. 间接...

SmileLing的专栏 1万+

Rockchip rv1126平台在gstreamer1中添加OpenCv实现视频流负片的效果

rv1126 gstreamer opencv negetive effect

Aisy_D的专栏 1463

机器学习——SVM多分类问题

根据百度百科的解释,超平面是n维欧式空间中余维度等于一的线性子空间,也就是必须是(n-1)维度。这是平面中的直线、空间中的平面之推广(n大于3才被称为“超平面”),是纯粹的数学概念,不是现实的物理概念。因为是子空间,所以超平面一定经过原点。n 维空间中的超平面是由方程:定义的子集,其中是不全为零的常数。超平面是为了分割分类用的,超平面将空间划分为三部分,超平面本身,超平面上部,超平面下部。

qq_53142796的博客 5974

Prokka实战:10分钟搞定细菌基因组注释(附详细参数解析)

本文深入解析Prokka细菌基因组注释工具的核心参数与实战策略。通过拆解其集成化工作流程,详细解读物种分类、功能注释、输出控制等关键参数,并提供快速初筛、高质量发表、质粒注释及批量处理四种典型场景的高效参数组合方案,帮助用户精准掌控注释过程,将原始序列转化为有价值的生物学见解。

weixin_29271053的博客 442

Python对接海康威视机器视觉工业相机

工业相机只允许单条连接,也就是说MVS如果连接了相机,python代码就无法获取数据,此时必须。相机工具类(读者直接复制)HKCamera_class.py。博主这里出现了一个警告:获取不到相机参数。四、使用Pycharm打开Python代码示例文件夹。三、找到MVS示例代码(代码在MVS的安装位置)二、解压并安装MVS客户端。一、下载MVS客户端。安装一下opencv。

Good Luck 2万+

java+svm多分类器_SVM入门(十)将SVM用于多类分类 - Jasper's Java Jacal - BlogJava

从SVM的那几张图可以看出来,SVM是一种典型的两类分类器,即它只回答属于正类还是负类的问题。而现实中要解决的问题,往往是多类的问题(少部分例外,例如垃圾邮件过滤,就只需要确定“是”还是“不是”垃圾邮件),比如文本分类,比如数字识别。如何由两类分类器得到多类分类器,就是一个值得研究的问题。还以文本分类为例,现成的方法有很多,其中一种一劳永逸的方法,就是真的一次性考虑所有样本,并求解一个多目标函数的...

weixin_42604188的博客 337

MATLAB闪退别慌!5分钟搞定Windows系统预设文件修复(附详细截图)

本文针对MATLAB在Windows系统下频繁闪退的问题,提供了快速有效的解决方案。核心在于修复或重置损坏的MATLAB预设文件,通过图文并茂的五步法,指导用户定位AppData目录、重命名预设文件夹,从而让MATLAB自动生成全新配置以解决闪退。文章还涵盖了问题诊断、设置备份及进阶排查方法,帮助用户彻底根除启动故障。

weixin_29234423的博客 925

SVM入门(十)将SVM用于多类分类

从 SVM的那几张图可以看出来,SVM是一种典型的两类分类器,即它只回答属于正类还是负类的问题。而现实中要解决的问题,往往是多类的问题(少部分例外,例如垃圾邮件过滤,就只需要确定“是”还是“不是”垃圾邮件),比如文本分类,比如数字识别。如何由两类分类器得到多类分类器,就是一个值得研究的问题。 还以文本分类为例,现成的方法有很多,其中一种一劳永逸的方法,就是真的一次性考虑所有样本,并求解一个

超越梦想的专栏 872

YOLOv11改进 | Neck篇 | 双向特征金字塔网络BiFPN助力YOLOv11有效涨点

本文给大家带来的改进机制是BiFPN双向特征金字塔网络,其是一种特征融合层的结构,也就是我们本文改进YOLOv11模型中的Neck部分,它的主要思想是通过多层级的特征金字塔和双向信息传递来提高精度。本文给大家带来的结构可以让大家自行调节网络结构大小,同时能够达到一定的轻量化效果,为什么发BiFPN呢因为它算是YOLO系列改进中的常青树了,大家可以借鉴它的双向特征思想来创新自己的Neck结构本文的BiFPN通过yaml文件配置可以让大家自行调配其结构。

Snu77的博客 9095

QCC305x-QCC304x系列开发教程之应用程序子系统详解 嵌入式

本文对QCC305x-QCC304x系列芯片的应用程序子系统进行了详细解析,并给出了一个LED闪烁的示例代码。嵌入式系统的开发既需要理论知识的支持,也需要实践经验的积累,希望本文能够为读者在QCC305x-QCC304x系列芯片的开发中提供一些有益的指导。QCC305x-QCC304x系列芯片提供了丰富的外设接口,包括UART、SPI、I2C等,开发者可以根据需求选择适合的接口进行数据传输和控制。QCC305x-QCC304x系列芯片的应用程序子系统是整个嵌入式系统的核心部分,负责管理和执行各种应用程序。

CodeMaven的博客 224

SVM入门(九)将SVM用于多类分类

从 SVM的那几张图可以看出来,SVM是一种典型的两类分类器,即它只回答属于正类还是负类的问题。而现实中要解决的问题,往往是多类的问题(少部分例外,例如垃圾邮件过滤,就只需要确定“是”还是“不是”垃圾邮件),比如文本分类,比如数字识别。如何由两类分类器得到多类分类器,就是一个值得研究的问题。 还以文本分类为例,现成的方法有很多,其中一种一劳永逸的方法,就是真的一次性考虑所有样本,并求解一个多目

Wayne's Road to Rome! 7276

OpenHarmony深度定制:从系统到模块的全景剖析与自定义模块实战

目标:在中新增一个算法库,让产品可直接调用。关闭不用的 20+ 系统部件,ROM 缩小 50 %;为自家芯片新增专用驱动模块,快速点亮开发板;内将核心算法库以部件形式集成,实现商业闭源。万物互联时代,差异化才是护城河。

m0_67505153的博客 1031

[转载]SVM入门(十)将SVM用于多类分类

从 SVM的那几张图可以看出来,SVM是一种典型的两类分类器,即它只回答属于正类还是负类的问题。而现实中要解决的问题,往往是多类的问题(少部分例外,例如垃圾邮件过滤,就只需要确定“是”还是“不是”垃圾邮件),比如文本分类,比如数字识别。如何由两类分类器得到多类分类器,就是一个值得研究的问题。  还以文本分类为例,现成的方法有很多,其中一种一劳永逸的方法,就是真的一次性考虑所有样本,并求解一个多目标函数的优化问题,一次性得到多个分类面,就像下图这样:  多个超平面把空间划分为多个区域,每个区域对应一个类别,给

ayw_hehe的专栏 1579

Windows 10 本地硬盘变成了可弹出磁盘

今天新装了系统, 电脑是一个SSD+HHD, 没想到装好之后右下角显示可安全删除设备, 两个硬盘在那里. 这还得了. 查了一下午, 大致知道了是什么问题. Standard SATA AHCI controller使用高性能的硬盘模式就会把硬盘看作是一个可热插拔的存储器, 所以自然就会显示可弹出. 如果你的BIOS支持关闭HotSwap或者HotPlug, 那么直接关闭就可以了. 或者你直接在BIOS里把磁盘模式改为IDE, 不过这样就发挥不好你SSD的高性能了. 还有一种解决方法, 就是手动让系统把这两个

落日之城 4万+

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

SVM入门(十)SVM用于多类分类

从 SVM的那几张图可以看出来,SVM是一种典型的两类分类器,即它只回答属于正类还是负类的问题。而现实中要解决的问题,往往是多类的问题(少部分例外,例如垃圾邮件过滤,就只需要确定“是”还是“不是”垃圾邮件),比如文本分类,比如数字识别。如何由两类分类器得到多类分类器,就是一个值得研究的问题。 还以文本分类为例,现成的方法有很多,其中一种一劳永逸的方法,就是真的一次性考虑所有样本,并求解一个多

Jet_yingjia的专栏 894

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

上一篇: 系统启动时提示 ntldr is missing
下一篇: 使用单元测试 Boost.test
stund
博客等级 码龄18年 28粉丝 15原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值