原文:使用jsoup抓取指定网站地址的class的html内容
源代码下载地址:http://www.zuidaima.com/share/1550463671536640.htm
一个使用jsoup爬取内容的实例
获取zuidaima首页的分享列表:

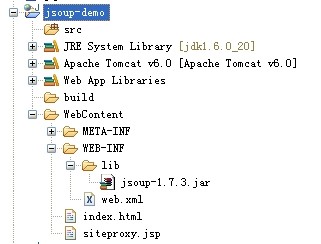
项目截图


 墨衍会员
·
AI 创作全网分发
墨衍智能分发
本文由作者通过墨衍一键同步至各平台
1分发平台
1.5k累计阅读
1.5k平均单平台
已同步平台
优快云
微信公众号
微博
知乎
掘金
百家号
博客园
抖音
小红书
你的文章也可以这样分发
墨衍会员 ¥399起/年,写一次发全网
我也要
原文:使用jsoup抓取指定网站地址的class的html内容
源代码下载地址:http://www.zuidaima.com/share/1550463671536640.htm
一个使用jsoup爬取内容的实例
获取zuidaima首页的分享列表:
项目截图
抓网技术 获取网站上想要的东西
抓网技术简单的实现 以抓取58网上的信息为例 由于网站的实时变更 可能需要更改相应的class标签
html页面解析技术之Jsoup的基本使用
Jsoup是一款Java的HTML解析器,可直接解析某个URL地址、HTML文本内容。它提供了一套非常省力的API,可通过DOM,CSS以及类似于jQuery的操作方法来取出和操作数据。
Lucene4.8+IKAnalyzer+SpringMVC4+Jsoup+Quartz示例
学习用非常不错,可以抓取网易头条,加入Lucene的检索。直接导入eclipse+Tomcat就可以使用。
Jsoup 查询时根据标签class属性和id属性查找
1、根据id查询 select.(div[id=xxx]) 2、根据class查询 select.(div[class=xxx])
从理论到实践:使用Sigrity SystemSI完成DDR4信号完整性仿真全流程解析
本文详细解析了使用Sigrity SystemSI完成DDR4信号完整性仿真的全流程,从核心挑战到实战操作。文章深入探讨了DDR4信号完整性问题,介绍了SystemSI工具链的演进与分工,并提供了从前期准备到高级技巧的详细指南,帮助工程师有效解决DDR4设计中的信号完整性问题。
lenovo联想拯救者Legion Y9000P 2022款2023款2024款笔记本电脑(82RF,82WK,82WQ,83DE,83DF)原装出厂Windows11预装OEM系统镜像下载
联想原装出厂系统自带所有驱动、出厂主题壁纸、系统属性联机支持标志、系统属性专属LOGO标志、Office办公软件、联想电脑管家、联想浏览器、联想软件商店、legionzone控制中心等预装程序。链接:https://pan.baidu.com/s/1YBji_oh7xOkq-NxnS8Mm8g?链接:https://pan.baidu.com/s/1S7_enXmuoja1a9ASvUT5Fg?拯救者Legion Y9000P IRX9H 2024款【83DE】原厂Win11系统包。
【jsoup】jsoup选择具有多个class的标签
如果 html 标签的class 只要一个,可以通过 Document doc = Jsoup .connect(("http://www.xxxxxx.com)) .timeout(limitTime).get(); doc.getElementsByClass("xxx"...
二手分析仪器改造实战:如何用PMT搭建荧光检测电路(附完整电路图)
本文详细介绍了如何利用二手分析仪器中的光电倍增管(PMT)核心部件,进行荧光检测电路的实战改造。内容涵盖从PMT工作原理理解、高压供电电路设计、低噪声前置放大(跨阻放大器)到信号调理的完整流程,并提供了关键电路图与调试排错指南,旨在帮助电子爱好者与工程师低成本构建稳定、高灵敏度的专业检测系统。
使用 jsoup实现网页抓取
简介: jsoup 是一款 Java 的 HTML 解析器,可直接解析某个 URL 地址、HTML 文本内容。它提供了一套非常省力的 API,可通过 DOM,CSS 以及类似于 jQuery 的操作方法来取出和操作数据。本文主要介绍如何使用 jsoup 来进行常用的 HTML 解析。 准备工作: 下载jsoup.jar包:https://jsoup.org/download代码: Do...
uniapp [全端兼容] - 实现连接蓝牙电子秤+监听数据转换并实时返回示例代码,uniApp实现BLE蓝牙连接多个电子秤设备、蓝牙通讯协议对接详细教程(全平台兼容H5、微信小程序、苹果安卓App)
uniapp连接蓝牙电子秤,uniapp如何连接电子秤蓝牙,蓝牙称重,实现监听数据转换并实时返回,多蓝牙,uni-app电子秤16进制蓝牙通讯协议对接,uniapp微信小程序蓝牙获取电子秤的值,uniapp蓝牙称重电子秤,蓝牙电子秤硬件,APP端连接蓝牙秤获取重量实时显示在页面上蓝牙秤,插件组件,蓝牙连接失败,uniapp安卓苹果ios连接蓝牙电子秤没反应,uniapp微信小程序 蓝牙低功耗连接发送数据监听接收,uni-app小程序蓝牙连接、读写数据全过程,uniapp连接蓝牙体脂秤,蓝牙搜索不到怎么办,如
Python 爬虫教程:抓取交通流量和道路信息
Scrapy是一个强大的爬虫框架,适用于大规模的爬虫任务。它提供了高效的数据抓取和存储功能,支持数据清洗和解析操作。Scrapy特别适合用于抓取开放的API接口和数据流。
小程序扫码解析网页:Jsoup服务端架构与HTML内容提取实践
在Web开发与数据抓取领域,HTML解析是一项基础且关键的技术,它允许开发者从网页中提取结构化信息。其核心原理是通过解析HTML文档对象模型(DOM),利用选择器精准定位并抽取目标元素。这项技术的价值在于能够实现内容的自动化获取与重组,广泛应用于数据聚合、内容分析和信息展示等场景。本文聚焦于一个典型的工程实践:如何构建一个稳健的微信小程序扫码解析服务。通过集成Jsoup这一强大的HTML解析库,服务端能够高效地抓取并清洗目标网页内容,解决小程序直接渲染外部网页的体验问题。文中深入探讨了应对网络异常、反爬策略
Pyhon在振动信号处理中的高级应用(一):振动信号特征(时域、频域)提取
文章目录一、概述二、算法原理2.1 时域统计特征三、python代码实现 一、概述 二、算法原理 这里我们借鉴西安交通大学机械学院雷教授的论文《Fault diagnosis of rotating machinery based on multiple ANFIS combination with GAs》相关研究成果。雷教授在论文中共列举了4类共24种振动信号的时域和频域特征。 2.1 时域统计特征 p1=∑n=1Nx(n)NP2=∑n=1N(x(n)−p1)2N−1p3=(∑n=1N∣x(n)∣N
Java Jsoup爬虫入门
一、了解Jsoup Jsoup是一款Java的HTML解析器,主要用来对HTML解析。 二、JSoup的Mavven依赖 <dependency> <groupId>org.jsoup</groupId> <artifactId>jsoup</artifactId> <version>1.14.1</version> </dependency> 三、Jsoup框架中的常用方法 ①conne
R语言广义加型模型(GAM)的运用例子及实现教程
一旦拟合了广义加型模型,我们可以查看模型摘要和诊断,以评估模型的质量和拟合情况。# 查看模型摘要响应变量:mpg(汽车的燃油效率)拟合函数:mpg ~ s(hp) + s(wt)
知识图谱中的 Ontology(本体论)
1980年,本体论(Ontology)哲学概念“本体”被引入到人工智能领域用来刻画知识。本体概念模型、明确、形式化、共享。本体是实体存在形式的描述,往往表示为一组概念定义和概念之间的层级关系,本体框架形式树状结构,通常被用来为知识图谱定义schema。如人、公司、车等都可以在具体场景下称为本体。Ontology是(特定领域)信息组织的一种形式,是领域知识规范的抽象和描述,是表达、共享、重用知识的方法。Ontology。
利用Jsoup爬取一组图片
package mySource; import java.io.FileNotFoundException; import java.io.FileOutputStream; import java.io.IOException; import java.io.InputStream; import java.io.OutputStream; import java.net.
LinePhone3.2.7(android端最新版本) sip客户端
SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/
java爬虫jsoup_Java爬虫框架Jsoup学习记录
Jsoup的作用当你想获得某网页的内容,可以使用此框架做个爬虫程序,爬某图片网站的图片(先获得图片地址,之后再借助其他工具下载图片)或者是小说网站的小说内容我使用Jsoup写出的一款小说下载器,小说下载器Jsoup导入1. 使用gradle导入compile 'org.jsoup:jsoup:1.11.1'2. 第三方包导入Jsoup使用1. 获得Document本地html文件或者使用javaI...
蓝牙模块HM-10手册
蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。
复分析 阿尔福斯(Ahlfors) 第三版答案 英文
答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案
Android开发系列十:使用Jsoup解析HTML页面
Android开发系列十:使用Jsoup解析HTML页面 在写Android程序时,有时需要解析HTML页面,特别是那类通过爬网站抓取数据的应用,比如:天气预报等应用。如果是桌面应用可以使用htmlparser这个强大的工具,但是在Android平台上使用会出现错误;另一种办法是使用正则表达式来抽取数据;再有一个办法是纯字符串查找定位来实现。文本将要介绍的是使用Jsoup这个开源的解析器来实
VB摄像头监控
该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制
小程序扫码与Jsoup网页解析:构建高效内容提取工具
在Web数据抓取与信息提取领域,高效获取结构化内容是一项基础且关键的技术。其核心原理在于模拟浏览器请求获取HTML文档,并通过DOM解析技术精准定位目标元素。这项技术的价值在于能够将海量非结构化的网页信息转化为可用的结构化数据,极大提升了信息处理效率。典型的应用场景包括舆情监控、价格追踪、内容聚合以及辅助工具开发。本文聚焦于一个结合了移动端便捷性与服务端处理能力的实践案例:利用微信小程序实现二维码扫描,并通过集成Jsoup库构建服务端网页解析引擎,实现从扫码到内容提取的完整链路。其中,针对反爬虫策略的应对和
今日份代码:简单的java爬虫实例--Jsoup解析html
目标:高清的图片!!! 导包 导入jsoup.jar包 直接上代码了啊 package pctest; import java.io.FileOutputStream; import java.io.IOException; import java.io.InputStream; import java.net.URL; import org.jsoup.Connection; import...
JSOUP实践:解析和遍历HTML文档
一、jsoup简介 jsoup 是一款Java 的HTML解析器,可直接解析某个URL地址、HTML文本内容。它提供了一套非常省力的API,可通过DOM,CSS以及类似于jQuery的操作方法来取出和操作数据。jsoup的主要功能如下: 1. 从一个URL,文件或字符串中解析HTML; 2. 使用DOM或CSS选择器来查找、取出数
jsoup简单运用
jsoup使用 jsoup 是一款 Java 的HTML 解析器,可直接解析某个URL地址、HTML文本内容。它提供了一套非常省力的API,可通过DOM,CSS以及类似于JQuery的操作方法来取出和操作数据。请参考:http://jsoup.org/ jsoup的主要功能如下: 从一个URL,文件或字符串中解析HT
java爬虫问题二: 使用jsoup爬取数据class选择器中空格多选择怎么解决
问题描述: 在使用jsoup爬取其他网站数据的时候,发现class是带空格的多选择,如果直接使用doc.getElementsByClass(“class的值”),这种方法获取不到想要的数据。 爬取网站页面结构如下: 其中文章列表的div为:<div class="am-cf inner_li inner_li_abtest"></div> 我们可以看到其class的值为:...
Java爬虫,信息抓取的实现
思想很简单:就是通过Java访问的链接,然后拿到html字符串,然后就是解析链接等需要的数据。 技术上使用Jsoup方便页面的解析,当然Jsoup很方便,也很简单,一行代码就能知道怎么用了: 下面介绍整个实现过程: 1、分析需要解析的页面: 网址:http://www1.sxcredit.gov.cn/public/infocomquery.do?method=public...

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言




 2895


 扫一扫


