Flink安装(单机模式、Windows)

Flink 安装部署与快速入门 (一)、Flink 安装部署与快速入门(xxbj) 一、flink概述 1、为什么选用flink? 不仅仅是一个高吞吐、低延迟的计算引擎,同时还提供很多高级的功能。:有状态的计算、支持强一致性语义以及至此基于Event Time的WaterMark对延迟或者乱序的数据进行处理 2、flink组件 物理部署层 本地、独立集群、yarn管理集群上、云上 runtime核心层 该层为上层不同接口提供基础服务;也是flink分布式计算框架的核心实现层支持分布式stream作业的执行、jobgraph到ex 阅读详情
AI摘要

本文介绍了在Windows系统下单机模式安装与运行Apache Flink的详细步骤,包括选择适配Java 8的Flink 1.14.6版本、使用Cygwin执行Shell脚本启动服务,并通过本地UI验证部署成功。适用于大数据处理初学者和开发测试场景。

目录

1、简单介绍Flink

1.1 使用意义

1.2 基本概念

1.2.1 执行机构

 1.2.2 部署模式

2、安装并运行Flink

2.1 下载Flink

下载

2.1 借助Cygwin启动Flink


1、简单介绍Flink

1.1 意义

想要深入学习Flink的可以另外参考其他文献,我对Flink概念了解也不太深,文本只做简单说明(比较抽象)。

对于Flink我把它理解为一款非常优秀的数据处理中间件,它能把数据处理的过程单独提取出来,减轻数据流通过程中其他步骤的压力。

有过大数据量数据库使用经验的同道们应该有体验,当数据量足够大时,简单的查询都会变得很缓慢,更别说在查询语句中加入计算(比如求平均值)。正常情况下,我们计算数据的过程是在程序中,而sql只需要负责拿出数据。但一些特殊情况下,比如使用帆软、grafana等报表工具时,我们经常需要通过sql直接处理数据,如果数据量大到一定程度,数据获取延迟会变得很长,用户体验很差。

而通过Flink,我们可以将数据处理过程单独提取出来,并利用其高性能机制,提前处理好数据,以便后续使用。

以需求“每秒采集一次设备温度,存入某张数采表内(一台设备一个月259w条)。现期望获取某个月内,每日的最大值和最小值”为例,如果是通过sql计算,需要先查询出当月内的259w条数据,再对数据进行日期分组,最后用聚合函数计算处最大值和最小值;而通过Flink,我们可以提前计算上一个月每日最大最小值(批处理) 或 凌晨0点实时计算前一天的最大最小值(流处理),并将其存入专门准备的数据表(一台设备一个月约30条)。259w条变30条,查询效率差距显而易见。

1.2 基本概念

在使用Flink之前,需要简单了解几个概念。

1.2.1 执行机构

 JobManager是任务的管理者,负责协调任务执行(接收、分配、维护任务)

 TaskManager是任务的执行者,执行任务内容

 1.2.2 部署模式

本地模式

  • 所有计算任务运行在同一进程中(在同一个程序),不涉及真正的调度
  • 相当于只有一个JobManager和一个TaskManager
  • 实际就如没有下载安装Flink,只用了在java程序中使用Flink框架工具包,相当于在java虚拟机中模拟flink环境运行。

单机模式

  • 计算任务可以运行在不同进程中,但运行在同一台机器上,接受一个JobManager的调度
  • 只有一个JobManager,但有多个TaskManager
  • 实际就如在且只一台机器上安装部署了Flink,并且把程序上传到Flink中运行。

集群模式

  • 计算任务可以运行在不同机器去上,接受多个JobManager的调度
  • 一个或多个 JobManager 调度多个 TaskManager
  • 实际就如在多台机器上安装部署了Flink,做了集群处理,并且把程序上传到Flink总部接受调度。

本文只说明单机模式

经验尚浅,理解抽象,欢迎纠正。

2、安装并运行Flink

2.1 下载Flink

网上关于Linux系统的部署Flink的文献有很多,windows的比较少,也因此踩了挺多坑这里。

这里分享的是windwos的部署方式,需要linux版的可另行参考。

下载

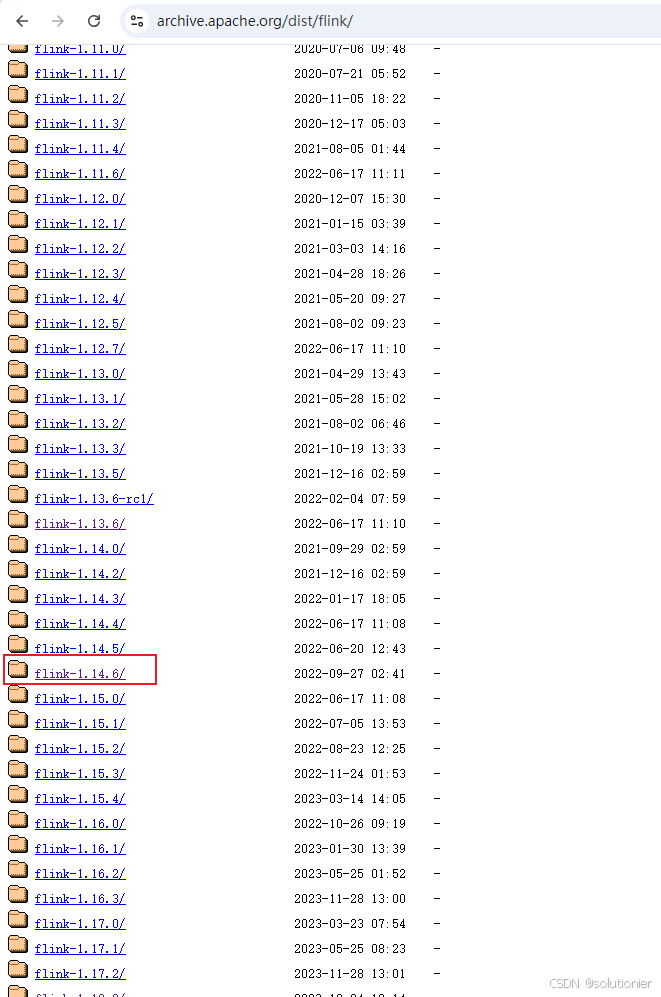
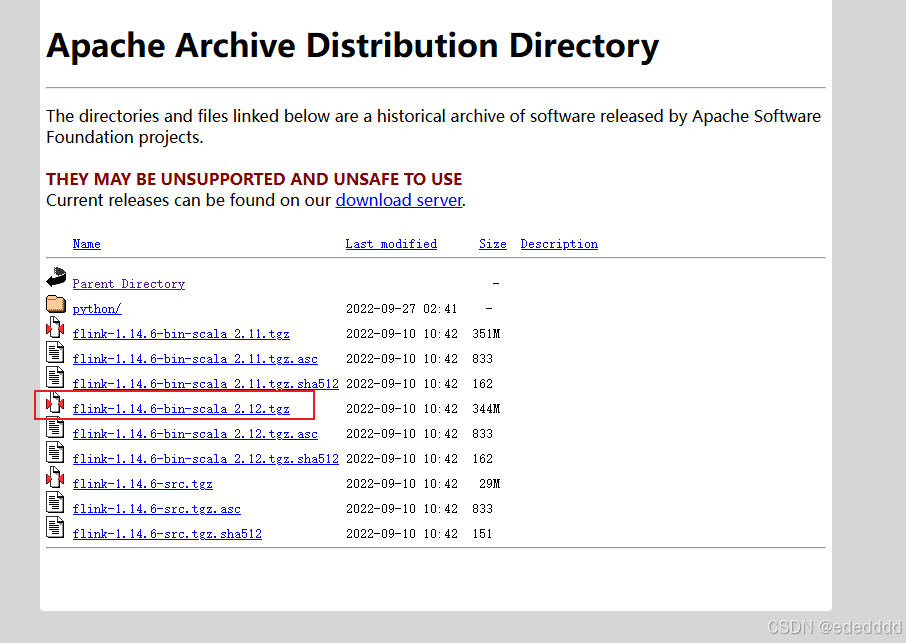
我用的是java8,但Flink 从1.15.0开始就不支持java8了,所以推荐使用java8的同道下载1.14.6版本

镜像(推荐)

Index of /dist/flink

官网

Downloads | Apache Flink

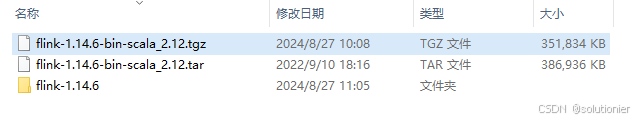
解压文件

这里推荐一款干净的解压软件:

7-Zip

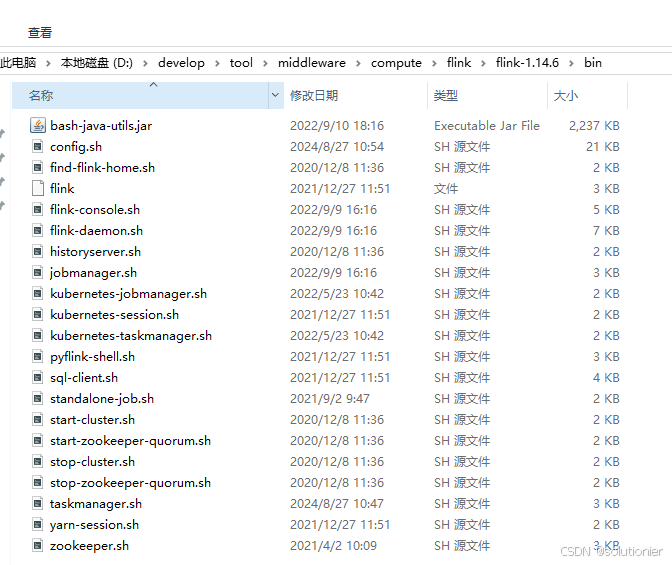
解压后,进入flink-1.14.6下的bin目录(如下图),这里可以看到执行文件都是清一色的shell文件,对windows用户不太友好。

1.9.*版本之前是有bat的,但1.10之后就没了,Flink对Linux的兼容性更好,windwos推荐测试、学习使用。
2.1 借助Cygwin启动Flink

要运行shell,网上也有一些使用自定义bat来间接执行启动文件的,但不太推荐,会出现taskmanager启动不起来等bug。

这里推荐使用Cygwin

Cygwin 是一个为 Windows 系统提供的类 Unix 环境,允许用户在 Windows 上运行类 Unix 应用程序。

官网:Cygwin
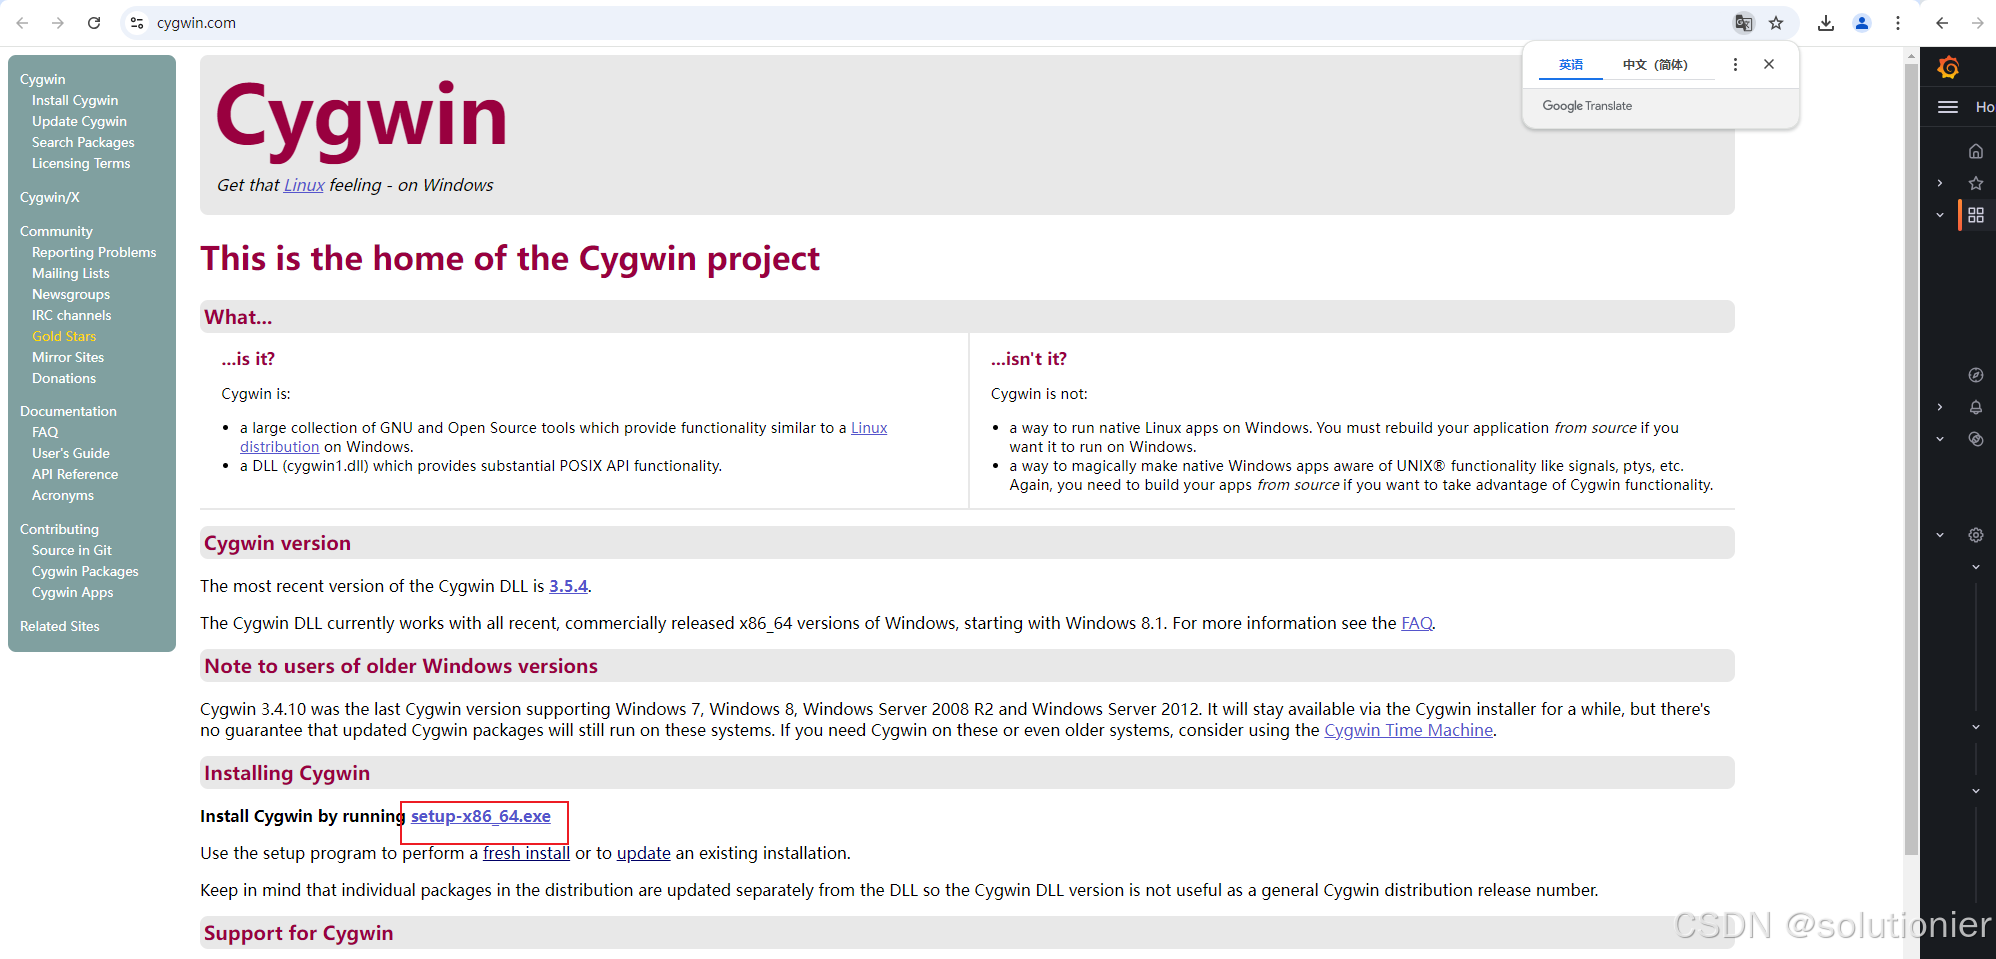
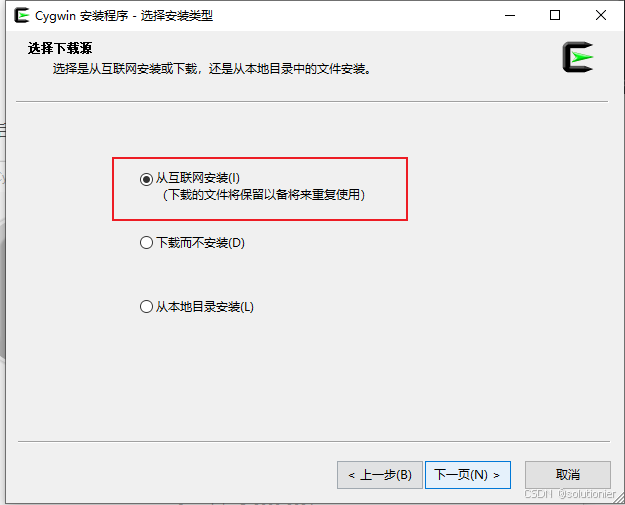
下载后打开
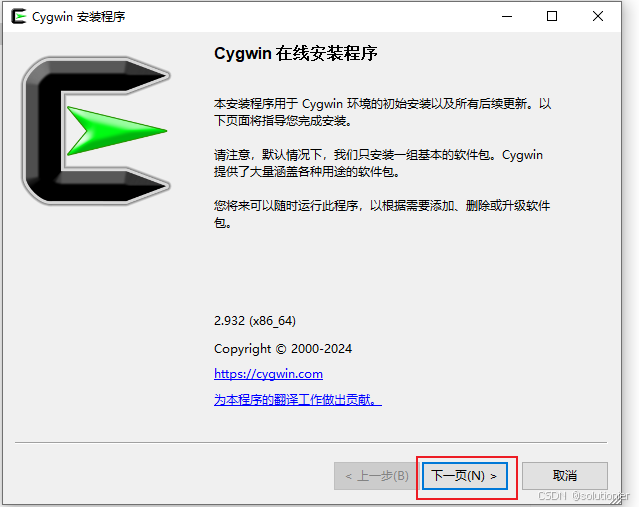
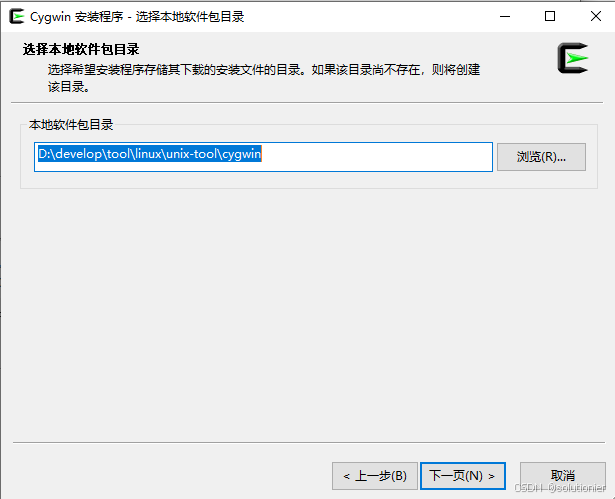
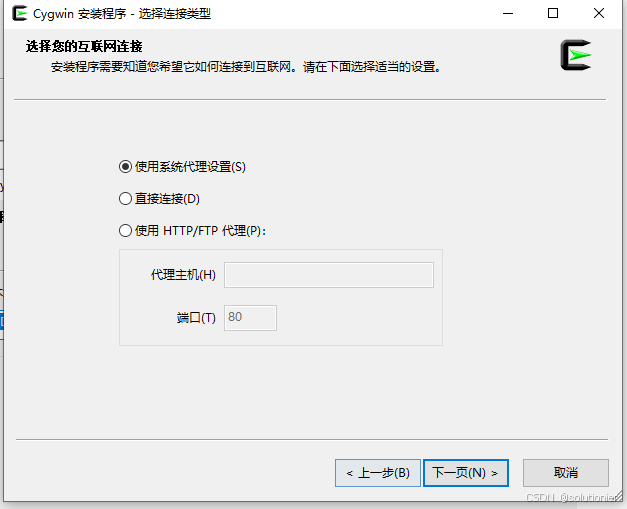
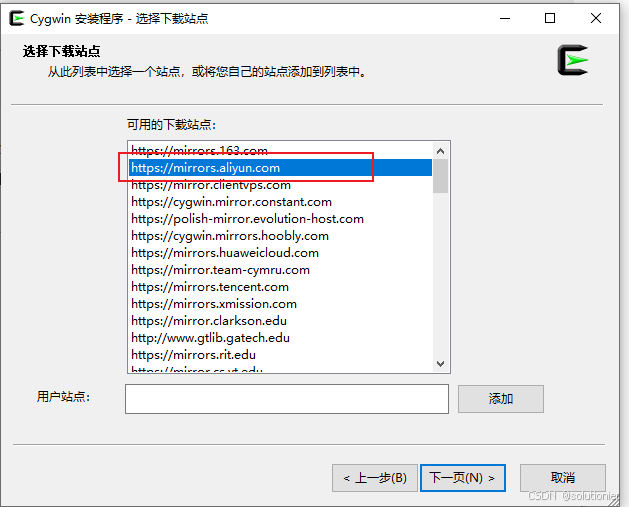
这里推荐使用镜像
只需要安装Bash一条即可,初次安装应该在base词条展开的文件下。选中后点击下一步
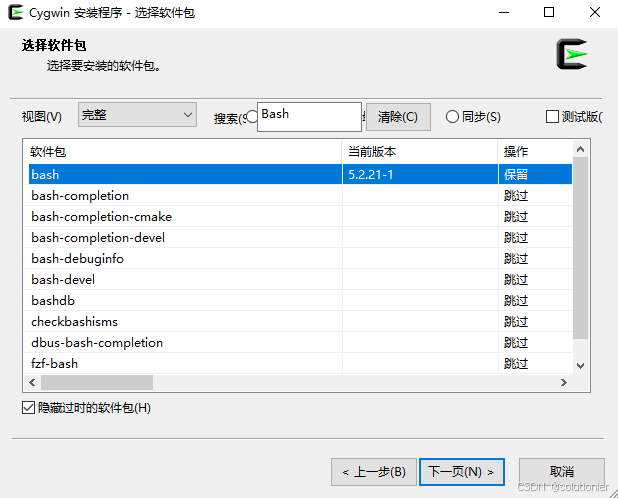
下载完成后点完成即可。

后续cygwin如果需要安装其他拓展包或更新拓展包,按照同样的方式,通过setup包更新安装包。

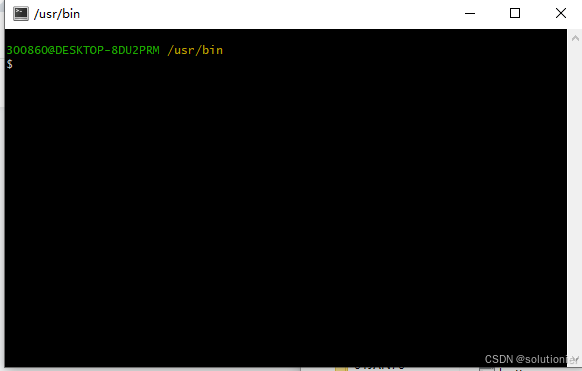
打开cygwin终端

进入bin目录打开mintty.exe或者通过快捷方式打开
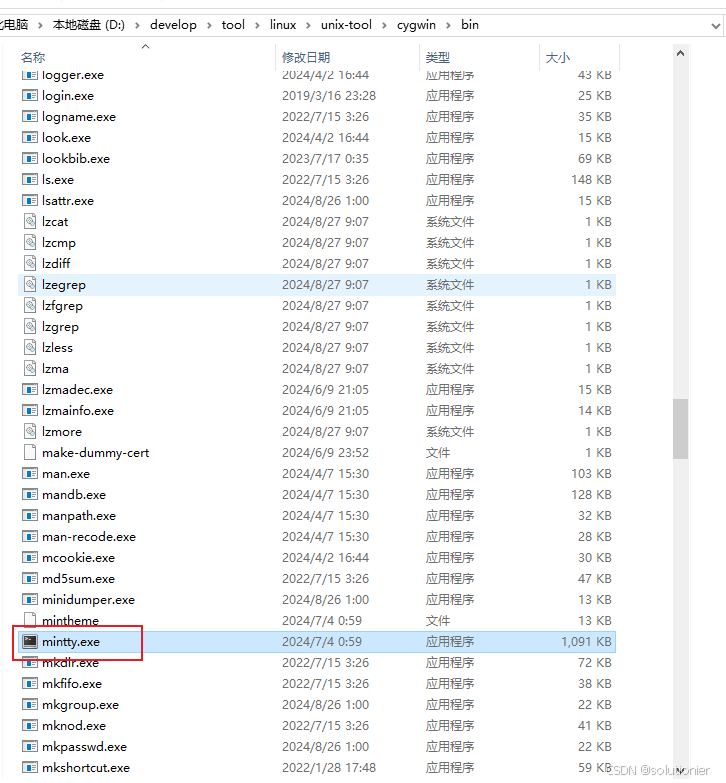
切盘方式:

cd D:

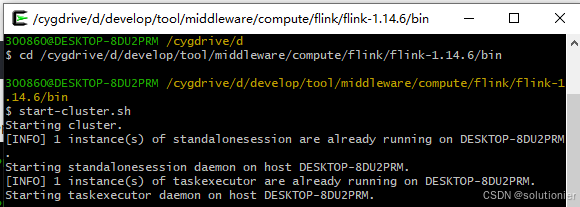
也可直接进入Flink的bin目录 

cd /cygdrive/d/develop/tool/middleware/compute/flink/flink-1.14.6/bin

运行

./start-cluster.sh

要停止就执行

./stop-cluster.sh

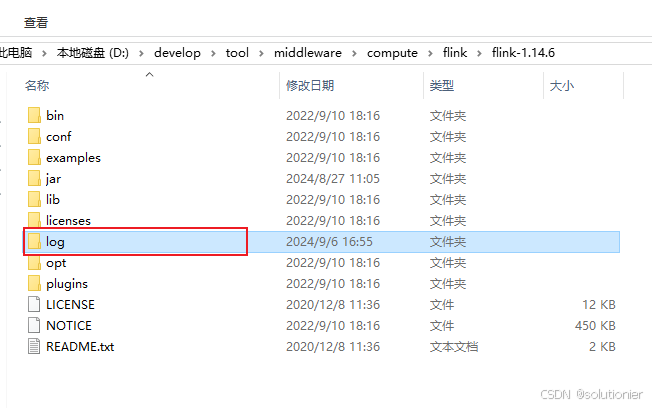
运行失败时,可以进入log目录查看最新日志文件记录的具体原因

启动后,浏览器访问localhost:8081,即可正常访问和使用的Flink UI界面。
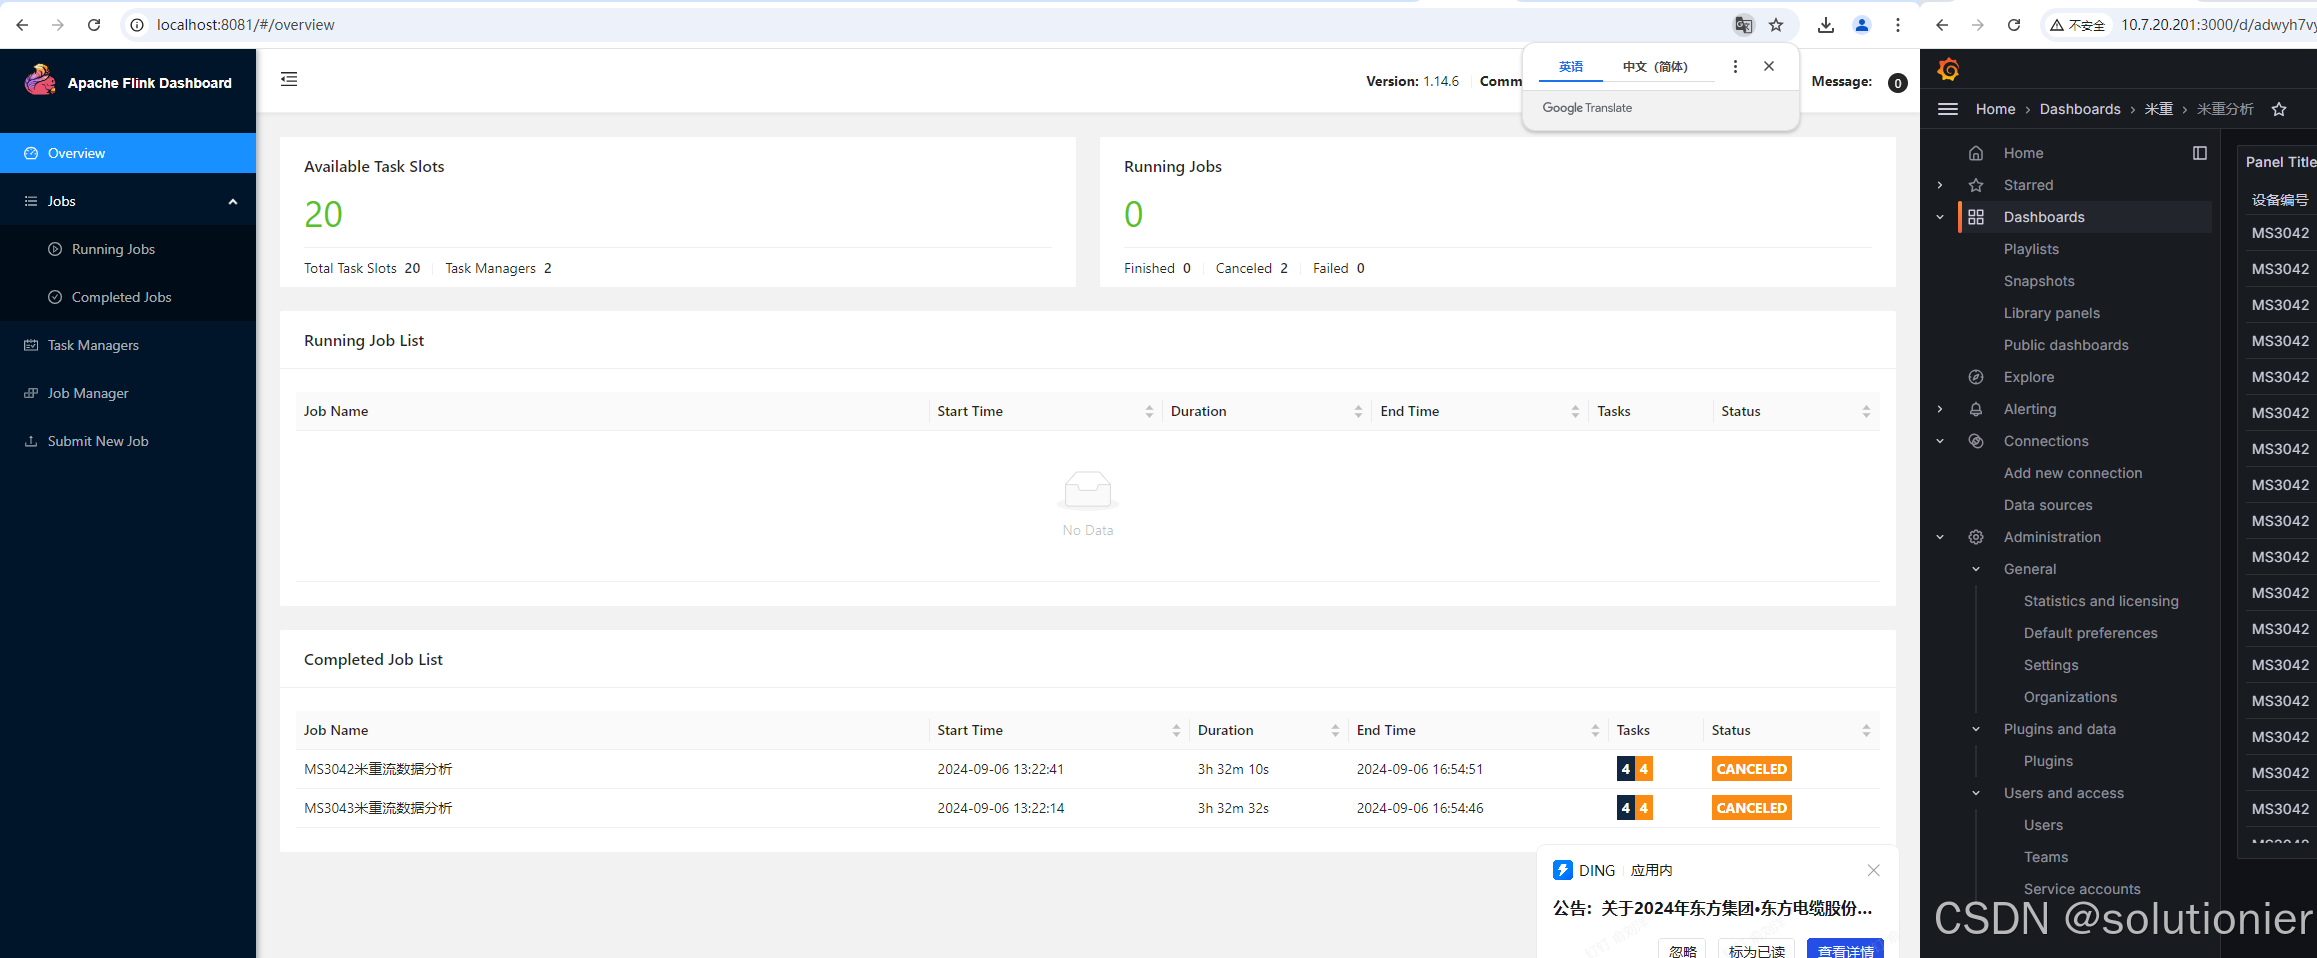
至此,单机Flink搭建完毕,在Flink上执行任务可以参考后面这篇

Flink实战(Java/MongoDB/Mysql)

Windows10环境下Flink-1.18.0快速部署与实战入门 本文详细介绍了在Windows10操作系统上快速部署Apache Flink-1.18.0的完整流程。从环境准备、JDK安装配置,到Flink下载解压、本地集群启动与验证,手把手指导用户完成安装。并通过运行经典的WordCount示例和创建首个自定义流处理Java程序,帮助开发者快速入门Flink的实时数据处理,体验其“流处理优先”架构的魅力。 阅读详情

相关推荐

在 Windows 搭建 flink 运行环境并模拟流数据处理

在大数据场景中,开发者追求高效与灵活,Linux 系统以其稳定性成为众多组件的首选,但在资源有限的情况下,在本机搭建一个 Linux 虚拟机集群却显得过于笨重,启动、运行占资源,需要配置网络,无法和windows共享资源,尤其是对只有 8GB 内存的 Windows 系统用户来说,内存压力显而易见。尽管如此,也挡不住一个学习者的“热情”。本文介绍怎么在 Windows 本地搭建 Flink 环境,注意这是一个伪分布式的测试环境。

明而决之 5094

windows上简单部署flink

Windows上配置Flink

落幕7的博客 5185

Flink(1)-安装单机模式

官网地址https://ci.apache.org/projects/flink/flink-docs-release-1.7/tutorials/local_setup.html 1.下载flink从官网 https://flink.apache.org/downloads.html 2.选择自己的版本 3.进行下载 4.解压缩 5.启动 6.页面访问 http:...

njiang的专栏 6175

Flink安装和演示

Flink安装和演示

qq_45443475的博客 4360

Flink本地模式极简安装与开发环境搭建指南

分布式流处理框架Apache Flink作为实时计算领域的核心技术,其本地模式安装是开发者快速入门的关键步骤。从技术原理看,Flink通过JobManager和TaskManager的协同工作实现流批一体处理,这种架构设计使其在实时ETL、事件驱动应用等场景展现独特优势。本文以Java 11+环境为基础,详细介绍单机集群部署流程,包括安装包获取、配置文件调整、示例程序运行等核心环节,特别针对开发环境中常见的内存配置、端口冲突等问题提供解决方案。通过Web UI监控和CLI工具验证,开发者可以快速掌握Flin

weixin_30274627的博客 502

Windows10下Flink 1.18.0安装避坑指南:从环境变量配置到集群启动全流程

本文详细介绍了在Windows10系统下安装和配置Flink 1.18.0的全流程,包括环境变量设置、集群启动及常见问题解决方案。通过实战案例展示流式WordCount应用,帮助开发者快速掌握Flink在Windows平台的部署与使用技巧,提升大数据处理效率。

weixin_30485379的博客 459

Windows安装Flink

Windows10安装Flink

Wolves_howl的博客 5586

Windows单机部署Flink并实现MySQL实时数据同步实战

流式计算框架Flink支持在单机环境下运行,其核心原理是基于内存的分布式计算引擎,能够处理无界和有界数据流。技术价值在于提供低延迟、高吞吐的实时数据处理能力,应用场景包括实时数据同步、ETL和事件驱动应用。在数据同步领域,通过CDC(变更数据捕获)技术读取MySQL的binlog日志,实现对业务库变更的毫秒级捕获与同步,避免轮询对数据库的压力。本文聚焦于Windows系统下安装Flink,并配置Flink CDC与MySQL实时同步链路,涵盖版本搭配、环境准备、任务编写与调优,帮助开发者在本地快速验证流式同

weixin_30985047的博客 330

Flink安装及配置

Flink安装及配置 搭建单机模式 1.下载Flink,要匹配自己的hadoop版本和Scala版本 2.将Flink上传到虚拟机中解压 tar -zxvf flink-1.7.2-bin-hadoop28-scala_2.11.tgz 3.配置环境变量 vi /etc/profile #Filnk-1.7.2 export FLINK_HOME=/root/apps/flink-...

Tomas_White的博客 2458

Kafak+Flink实现词频统计demo

整个demo流程均在win10操作系统完成,过程中使用的所有组件都以单机模式安装在本地,整个流程可看作flink版本的helloworld。实现基本功能是在kafka生产者输入一串以空格分隔的字符串,最终计算后得到每个字符串的出现频次。 环境准备 zookeeper安装: 使用的v3.4.13版本,官网下载安装包,解压缩,修改conf下的zoo_sample.cfg文件,主要注意如下所示 ...

sz790739116的博客 826

Flink实战:核心机制、状态管理与Kafka写Elasticsearch

在当今大数据技术体系中,流处理已成为支撑实时业务的核心能力。与传统批量计算不同,流处理强调数据到达即处理,能够显著降低计算延迟,满足实时监控、实时数仓等场景需求。而要实现稳定可靠的流式计算,状态管理与故障恢复机制至关重要。Apache Flink通过有状态计算、Checkpoint快照、水位线处理乱序数据等机制,为用户提供高吞吐、低延迟且结果精确的实时计算能力。无论是基于DataStream API的经典链路,还是通过Flink SQL简化开发,或是利用Flink CDC同步数据库变更,Flink都展现出强

cuankuangzhong6373的博客 591

Flink单机模式实战:用Windows10+PHPStudy快速搭建测试环境(附WordCount示例)

本文详细介绍了如何在Windows10系统上,利用PHPStudy内置的JDK快速搭建Flink单机测试环境,避免了复杂的Java环境配置。通过实战步骤指导,包括环境准备、Flink安装、内存优化,并附有WordCount示例,帮助开发者高效进行功能验证和学习测试。

tree的博客 887

【大数据Flink系列】Flink单机模式和集群搭建

【大数据Flink系列】Flink单机模式和集群搭建

weixin_54707168的博客 1474

Windows 上 Flink 实时同步 MySQL 数据:从安装到 CDC 链路跑通

CDC(变更数据捕获)是一种基于数据库日志实时捕获数据变更的技术,其原理是通过解析 MySQL 的 binlog 行级变更事件,将 INSERT、UPDATE、DELETE 操作转化为流式数据。技术价值在于实现低延迟、低侵入的数据同步,避免轮询对源库的压力。典型应用场景包括实时数仓构建、数据迁移、缓存更新等。在 Windows 环境下,使用 Flink 结合 MySQL CDC connector 可以快速搭建本地验证链路,但需注意 binlog 格式配置、connector 版本匹配及 jar 加载等关键

weixin_29057163的博客 232

FFmpeg视频编码的流程详解及参考demo

本文主要讲解FFmpeg的视频编码的具体流程,API使用。最后再以一个非常简单的demo演示将一个yuv数据文件编码为H264的视频文件,也就是YUV编码为H264。

分享音视频技术 4498

避开ego_planner仿真的第一个坑:深度相机、点云与odom话题配置全指南

本文详细解析了ego_planner仿真中深度相机、点云与odom话题配置的关键问题,帮助开发者避开常见陷阱。从数据流架构到具体配置细节,包括深度相机的内外参匹配、点云数据规范要求以及odom话题的验证方法,提供了全面的实战指南和优化建议。

weixin_30335575的博客 492

Flink部署模式全解析:从本地单机到YARN集群实战指南

在流式计算领域,Apache Flink作为核心框架,其部署模式的选择直接影响开发效率和系统稳定性。理解其部署原理,需要从资源调度和集群管理的概念入手。Flink通过不同的部署模式来适应从开发测试到大规模生产的不同场景,其技术价值在于提供了灵活的资源利用和作业管理能力。在应用场景上,本地单机模式适用于快速验证逻辑,Standalone集群适合中小规模独立部署,而YARN模式则能无缝集成Hadoop生态,实现弹性资源调度。本文聚焦于Flink的三种主流部署模式,深入剖析Standalone集群和YARN模式集

weixin_34101784的博客 351

Vivado DDR IP自定义型号避坑指南:如何正确填写CSV参数表(附常见错误排查)

本文详细解析了Vivado DDR IP自定义型号配置中的关键步骤与常见问题,特别针对DDR4内存颗粒的参数提取、CSV参数表填写误区及故障排查提供了实用指南。通过实际案例和调试技巧,帮助工程师避免配置陷阱,提升DDR4系统稳定性和性能。

weixin_29280657的博客 413

Seatunnel单机模式部署与性能优化指南

数据集成工具在现代数据处理流程中扮演着关键角色,其核心原理是通过标准化接口实现异构数据源的高效同步。Apache Seatunnel作为新一代开源解决方案,采用插件化架构设计,支持批流一体处理。在单机部署模式下,开发者无需复杂环境配置即可实现50MB/s级的数据处理能力,特别适合金融行业数据迁移等场景的技术验证。通过合理配置JVM内存参数(如-Xmx10g)和并行度(建议等于CPU核数),配合MySQL、ClickHouse等常用连接器插件,能够快速构建从开发测试到生产部署的全流程数据处理管道。本文详解从环

weixin_33716154的博客 404

在AutoDL的A100云服务器上,用Docker搞定Sapien+RobotWin环境(附完整conda list)

本文详细介绍了在AutoDL的A100云服务器上使用Docker构建Sapien+RobotWin环境的完整指南。通过配置Vulkan渲染管线、精确复现Conda环境以及解决常见问题,帮助研究人员高效搭建稳定的机器人仿真开发环境,特别适合需要高性能GPU加速的复杂仿真任务。

weixin_30689307的博客 430

springboot+shardingsphere+druid 实现基于时间的水平分表

使用shardingsphere基于时间字段的动态水平分片。

weixin_42207940的博客 2626
上一篇: grafana免费连接Oracle/MongoDB——simpod-json-datasource
下一篇: Flink实战(Java/MongoDB/Mysql)
ededddd
博客等级 码龄7年 65粉丝 4原创
评论 18
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值