
Tensorflow2 中模型训练标签顺序和预测结果标签顺序不一致问题解决办法

tensorflow训练时取batch数据的方法 上一篇介绍了如何取随机batch,这一篇介绍的方法是先随机打乱数据,再按顺序一个一个batch的取。 def shuffle_set(train_image, train_label, test_image, test_label): train_row = range(len(train_label)) random.shuffle(train_row) train... 阅读详情

    本篇文章将详细介绍Tensorflow2.x中模型训练标签顺序和预测结果标签顺序不一致问题,这个问题如果考虑不周,或者标签顺序没有控制好的情况下会出现预测结果精度极其不准确的情况。

    训练数据集的结构:数据集有超过10的类别数,这里包含16类数据,每个类别放置到一个文件夹中,文件夹名称按照其类别命名为1,2,3……16。文件夹结构如下图所示:
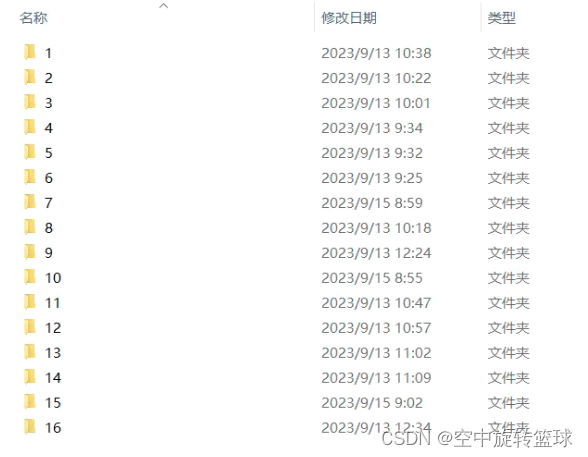
    这组数据在系统中的排序是1,2,3,4,……顺序排序的。

一、Tensorflow2.数据读取的顺序

    使用Tensorflow读取数据,代码如下:

data_all = tf.keras.preprocessing.image_dataset_from_directory(
        data_dir,
        labels='inferred',
        batch_size=batch_size,
        image_size=(img_height, img_width),
        shuffle=False  # 关闭洗牌以保持与文件夹中图像的顺序一致
    )

    按照有的说明,tf.keras.preprocessing.image_dataset_from_directory()函数是按照文件夹中的排序读取的数据,但实际上并不是。我们来查看一下这个函数读取的数据是什么顺序,这里直接使用一下一行代码:

class_names = data_all.class_names
    print("类别标签:", class_names)

    看看输出结果是什么:

类别标签: ['1', '10', '11', '12', '13', '14', '15', '16', '2', '3', '4', '5', '6', '7', '8', '9']

    这里我们可以看到,以上函数读取的数据顺序和文件夹中的顺序并不一致,因此,我们在进行精度评的时候一定要保持这个标签的顺序一致。

二、Tensorflow2.数据预测结果的顺序

    Tensorflow2.训练的模型预测出来的结果是按照0,1,2,……编码顺序编码的,也就是说,训练数据集中第1类预测出来的标签代码实0,第2类是1,第3类是2.

    在这里我们进行评估时,如果是使用以下代码进行训练和评估时,训练集和测试集数据顺序一致,所以不会出现什么问题。

train_ds = tf.keras.preprocessing.image_dataset_from_directory(
    data_dir,
    validation_split=0.7,
    subset='training',
    seed=123,
    image_size=(img_height, img_width),
    batch_size=batch_size)
test_ds = tf.keras.preprocessing.image_dataset_from_directory(
    data_dir,
    validation_split=0.7,
    subset='validation',
    seed=123,
    image_size=(img_height, img_width),
    batch_size=batch_size)

    不过预测出来的标签和我们的类别不一致,这时候我们需要将两者变换为一致,我们可以通过建立一个类别对应关系的字典来进行变换,使预测的标签值变换为实际类别代码如下:

label_dict={'0': 1, '1': 10, '2': 11, '3': 12, '4': 13, '5': 14, '6': 15,
                '7': 16, '8': 2, '9': 3, '10': 4, '11': 5, '12': 6,'13': 7, '14': 8,'15': 9}
    print(label_dict)
    # 将原始标签映射到调整后的标签
    adjusted_labels = [label_dict[str(label)] for label in original_labels]
    df[adjusted_name] = adjusted_labels

通过以上代码,可以将预测的标签值变换为实际类别ID.

三、如何按指定顺序读取数据?

    对于这个问题,我们可以通过修改文件夹名称来控制数据读取的顺序,比如将文件夹名称改为01,02,03,……16.或者按照字母a,b,c,d……的顺序来控制顺序。不过这样对后面评价计算的时候也有不好的影响,评价函数通常是使用数值类别来进行评价计算的,所以用字母的话后面也还需要再进行类别代码的转换。

【项目】TensorFlow 2训练一个简单线性模型 数据读取与预处理:通过 Pandas 加载数据并划分为训练集和测试集。模型构建:使用 TensorFlow 的Sequential模型和全连接层来构建一个简单的线性回归模型。编译与训练:选择合适的损失函数(MSE)和优化器(SGD),并通过训练数据对模型进行训练。评估与预测:通过计算均方误差来评估模型在测试集上的表现。这个简单的例子展示了如何使用 TensorFlow 2 来训练一个线性回归模型。虽然这个例子非常基础,但它涵盖了机器学习模型的主要步骤:数据加载、模型构建、训练和评估。 阅读详情

相关推荐

TensorFlow 2.0 快速入门——保姆级别学会训练模型, test ok

入门就是这么个如法,之后我在继续的研究,入门容易坚持难,看我是否可以成功的坚持下来吧,其实最近的事情还是挺多的,唉,加油吧。

小硕算法工程师 1534

【经典代码】将随机划分后的数据集数据和标签进行重排对应

在Python中,你可以使用NumPy库来实现这一过程。这个代码段首先将标签和对应的数据组合为一个元组列表,然后根据每个元组中的标签(即元组的第一个元素)对这个列表进行排序。排序后,它将标签和数据分离,并将它们转换回NumPy数组格式。这样,和就会按照你想要的方式排序。

weixin_44943389的博客 616

【Codex智慧中医系统】训练文章多分类模型并完成预测

后台文章多分类最容易出问题的环节,不是单个 CNN 模型调用,而是从 MongoDB 抽取、字段清洗、标签生成、训练文件落盘到预测输入之间任一节点不一致。

Mr数据杨 2万+

Halcon深度学习常见问题及解决方法

Halcon深度学习常见问题及解决办法

Douhaoyu的博客 8227

BiLSTM(双向LSTM)实现股票预测(TensorFlow2版)|时间序列预测

BiLSTM(双向长短期记忆网络)是一种深度学习模型,属于循环神经网络(Recurrent Neural Network,RNN)的一种变体。BiLSTM 在处理序列数据时能够同时考虑上下文信息,因此在自然语言处理(Natural Language Processing,NLP)任务中得到广泛应用。

m0_68629936的博客 1662

基于TensorFlow2的线性回归实现

回归分析是一种数学模型。当因变量和自变量为线性关系时,它是一种特殊的线性模型。 最简单的情形是一元线性回归,由大体上有线性关系的一个自变量(x)和一个因变量(y)组成,

需要远程指导仿真实验、代码有问题的,请后台私信或者关注公众号 1357

tensorflow训练模型(一)

准备好用于训练和测试的数据,通常需要将数据进行预处理、划分为训练集和测试集等操作。使用 tf.keras API 定义模型结构,包括选择合适的神经网络结构、搭建神经网络层、定义损失函数等。在定义好模型之后,需要通过编译模型来配置训练过程中的优化算法、损失函数等参数。使用准备好的数据对模型进行训练,并在每一轮训练结束后对模型进行测试,以评估模型的性能。在训练完成后,可以使用 save() 方法将训练好的模型保存到磁盘上。

hello.reader 5820

用WorkBuddy搭建漫剧AI自动化制作流水线全攻略

在内容创作领域,AI智能体正逐渐从单一工具辅助走向全流程自动化调度。其核心原理是将剧本、分镜、绘图、配音、剪辑等环节拆解为可独立执行的任务单元,由总控系统统一协调,从而大幅降低人力与时间成本。这种模式尤其适用于动态漫画(漫剧)这类环节多、专业度要求高的视频形态。传统制作流程中,角色一致性、配音周期和剪辑返工是公认的效率瓶颈,而借助AI智能体工作台,创作者只需输入故事创意,即可驱动多个数字分身协同完成内容生产。本文以WorkBuddy为例,详细展示如何配置模型、安装技能包并串联五段式流水线,将单集制作成本从万

weixin_28224217的博客 257

使用 TensorFlow 的起始步骤

机器学习速成课程会逐步引导您使用 tf.estimator(一种高级TensorFlowAPI)对模型进行编码,以便将学到的原则和技术应用于实践。 机器学习速成课程中的编程练习使用的是可将代码、输出和说明性文字合并到一个协作文档中的数据分析平台。 可使用Colaboratory平台直接在浏览器中运行编程练习(无需设置!)。Colaboratory 支持大多数主流浏览器,并且在 Chrome 和 Firefox 的各个桌面版本上进行了最全面的测试。如果您想下载并离线运行这些练习,请参阅有关设...

stone_tomcate的博客 428

Monocle2在R 4.3环境下的终极避坑指南:从安装到可视化全流程解析

本文提供了在R 4.3环境下安装和运行Monocle2的完整解决方案,重点解决了依赖包兼容性、源码修改及BEAM分析报错等关键问题。文章详细解析了从环境准备、依赖包处理、源码安装验证到从Seurat对象转换、拟时轨迹构建、高级可视化及性能优化的全流程,旨在帮助用户顺利完成单细胞拟时分析。

weixin_29206669的博客 1359

CANoe从入门到精通“保姆级”教程(二)- 堪称全网“最全”系列

CANoe各功能区介绍;

车载控制器AutoSAR软件开发工程师 2万+

TensorFlow 2.0 快速入门——手把手学会训练模型

TensorFlow训练你的第一个人工智能模型!!!有源码,有升级,详解释!!!

WenJGo的博客 1万+

2024届数字IC秋招-华为机试-数字芯片-笔试真题和答案(五)(含2022年和2023年)

此部分包含华为机试真题,方向是数字芯片,内容详细包括设计、验证、后端等,大部分题目给出参考答案。华为机试都是从题库里抽题目,所以这些题目还是很有参考性的,甚至是完全一样,可以搜到的。(题目内容较多,将分开编写几个文章)

qq_42135020的博客 2084

搭建并训练多标签数据集的模型并将结果可视化

#搭建并训练多标签数据集的模型并将结果可视化(tensorflow2) 1.数据集的介绍 该数据为拥有颜色与衣服类别两个标签的衣服识别,对于这样的数据集要求我们的神经网络需要两个输出,一个是类别,另一个是颜色。 文章目录1.数据集的介绍2.数据预处理3.利用tf.data构造模型输入管道4.利用函数式API搭建模型5.训练与结果分析结语 2.数据预处理 我们利用glob库获得所有图片的路径 import matplotlib.pyplot as plt import glob #读取多输出数据集的图片,即

theworld666的博客 3124

帝企鹅优化器(EPO)详解:从基础原理到代码实战

帝企鹅优化器(EPO)是受帝企鹅群体在极寒环境中抱团取暖行为启发,于2018年提出的一种群体智能优化算法。其核心机制是模拟帝企鹅种群通过动态调整位置来维持体温的过程,主要包括确定集群边界、计算温度分布、衡量个体间距离以及更新位置四个步骤,从而在求解复杂优化问题时有效平衡全局探索与局部开发。该算法具有参数少、结构清晰、易于实现等优点,在工程优化、图像处理、机器学习特征选择以及冷链物流车辆路径规划等领域展现出良好的应用潜力。

qq_42212808的博客 141

基于STM32L4XX、HAL库的 TMC2660C-PA 驱动程序设计

/ 默认灵敏度和电流。// 20/31最大电流。

zhusl6688的博客 387

TensorFlow 2 来训练一个线性回归模型

数据读取与预处理:通过 Pandas 加载数据并划分为训练集和测试集。模型构建:使用 TensorFlow 的Sequential模型和全连接层来构建一个简单的线性回归模型。编译与训练:选择合适的损失函数(MSE)和优化器(SGD),并通过训练数据对模型进行训练。评估与预测:通过计算均方误差来评估模型在测试集上的表现。这个简单的例子展示了如何使用 TensorFlow 2 来训练一个线性回归模型。虽然这个例子非常基础,但它涵盖了机器学习模型的主要步骤:数据加载、模型构建、训练和评估。

分享人工智能领域原创文章 1252

高通SDX55平台:5G速率问题排查分析方法

和大家分享一下高通5G平台5G速率问题排查分析方法。

四儿家的小祖宗的博客 5224

如何自定义Android TensorFlow Lite Machine Learning Example:训练和部署自己的TensorFlow Lite模型

想要在Android应用中集成机器学习功能吗?Android TensorFlow Lite Machine Learning Example为你提供了一个完整的示例项目,展示了如何在Android应用中集成TensorFlow Lite进行图像分类。这个开源项目不仅包含了预训练模型的使用,更重要的是,你可以学习如何训练和部署自己的TensorFlow Lite模型,为你的应用添加智能识别功能。

gitblog_00847的博客 666

零件边界线提取处理原理详解

该程序提出了一种高效的点云边界提取方法,通过三阶段处理流程实现零件几何特征的精确提取。首先采用RANSAC算法进行坐标系标准化,包括主平面检测、点云分割和双重旋转对齐。接着使用凹包算法和RANSAC直线拟合提取底面边界。最后通过多方向密度切片分析(Z向100片、X向50片),自动选择高密度切片进行边界提取和直线拟合。算法具有鲁棒性强、处理效率高(支持OpenMP并行计算)和参数可配置等特点,能有效提取零件的几何边界特征,为后续质量检测提供基础。实验结果显示该方法能准确提取零件的多方向边界线。

weixin_45196569的博客 434

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

利用逻辑回归模型解决MNIST手写数字识别问题

1、MNIST手写识别问题 MNIST手写数字识别问题:输入黑白的手写阿拉伯数字,通过机器学习判断输入的是几。可以通过TensorFLow下载MNIST手写数据集,通过import引入MNIST数据集并进行读取,会自动从网上下载所需文件。 %matplotlib inline import tensorflow as tf import tensorflow.examples.tutoria...

theVicTory的博客 5633

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

基于TensorFlow 2与PaddlePaddle 2预测泰坦尼克号旅客生存概率的比较

AI框架经过大浪淘沙之后,目前真正能够完整用于生产、科研、学术的只剩下了谷歌、脸书、百度三家的框架,本文通过一个泰坦尼克号旅客生存概率预测的经典问题来比较分析一下TensorFlow2与Paddle2。 首先给出TensorFlow的程序,代码如下: # -*- coding: utf-8 -*- """ Created on Thu Mar 4 18:36:21 2021 @author: Biao """ import numpy as np import pandas as pd pd.se

BoilingRabbit的博客 589

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

波士顿房价问题——多元线性回归+TensorFlow

波士顿房价问题——多元线性回归、Tensorflow 决定房价的因素有很多,所以采用多元线性回归模型 官方提供的波士顿房价项目数据集 其中, 载入数据 df = pd.read_csv('boston.csv', header=0) 观察数据摘要描述信息 将df转换为np的数组格式,并做归一化 归一化:(特征值-特征最小值)/(特征最大值-特征最小值) 如果缺少归一化步骤,不同特征值的取...

江南小帅瓜的博客 8982

Python-Tensorflow2.3.0-多元线性回归预测(学习笔记)

编译器环境:win10-Anaconda3-python3.6-tensorflow2.3.0 预测数据下载地址:https://download.youkuaiyun.com/download/weixin_41788456/12902246 Tensorflow进行算法设计与训练的核心步骤: 目录 1.准备数据 2.构建模型 3.模型训练 4.模型预测 1.准备数据 多变量线性方程可以表达为 总共:5...

hser-chen的博客 1513

Tensorflow2.0中keras里面Sequential与Model模型

Tensorflow2.0中keras里面Sequential与Model模型 Sequential 序贯模型 序贯模型是函数式模型的简略版,为最简单的线性、从头到尾的结构顺序,不分叉。 Sequential模型的基本组件,一般搭建模型有5个部分: 1、model.add,添加层; 2、model.compile,模型训练的BP模式设置; 3、model.fit,模型训练参数设置 + 训练; 4、...

weixin_39559994的博客 2628

Tensorflow之softmax多分类(顺序编码|独热编码)

对数几率回归解决的是二分类的问题,但对于多个选项的问题,我们可以使用softmax函数它是对数几率回归在N 个可能不同的值上的推广。神经网络的原始输出并不是一个概率值,实质上只是对输入的数值做了加权与非线性处理之后的值而已,那么如何将输出转换为概率分布?这就引入了softmax层。softmax激活要求每个样本必须属于某个类别,且所有可能的样本均被覆盖,softmax各样本分量之和为 1;当只有两个类别时,与对数几率回归(二分类)完全相同。

m0_64578069的博客 2274
上一篇: Python遥感图像处理应用篇040 GDAL 遥感图像滤波分析(Gaussian、Median、Adaptive、Wavelet Transform、Statistical……Canny)
下一篇: Arcgis错误记录 ERROR 999999: Error executing function.Cannot acquire a lock.Cannot acquire a lock.Fail
空中旋转篮球
空中旋转篮球 新星创作者: python技术领域 新星创作者: python技术领域
博客等级 码龄14年 6105粉丝 270原创
评论 8
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

空中旋转篮球

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值