Flink cdc写入kafka数据出现null的问题排查与解决

在java代码中使用kafka(springboot整合kafka) java代码maven项目实现kafka的连接及生产者、消费者的创建,以及消息的发布和订阅 阅读详情

Flink cdc是目前实时同步binlog数据非常方便的工具,今天业务在消费同步的数据发现其中有很多的null数据,经过排查,总结出以下特点:

  1. null数据的出现有一定规律,几乎每个+U(upsert_after)类型的数据前就有一条null数据
  2. 数据在出现null前,同步逻辑做过更改,添加了where语句过滤数据,在此前没有过null数据

首先,我需要确定null数据是什么。查询官方文档可以知道在upsert-kafka中,会把-D(delete)类型数据写成null。
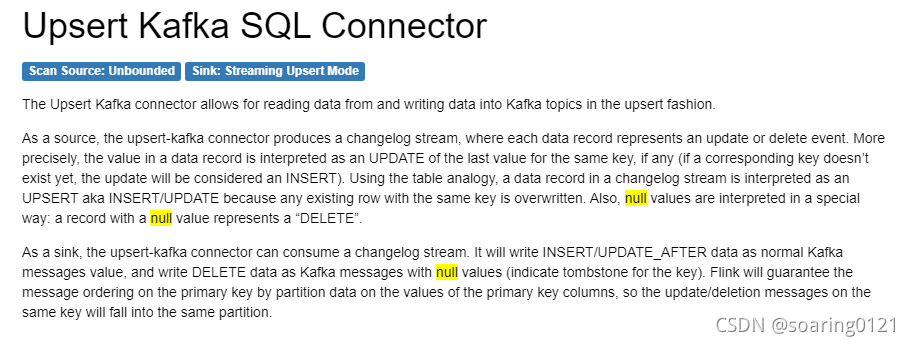

但是我已经通过参数去掉了-D类型数据,并且-D类型不可能这么有规律的出现,因此,这些null数据很大可能是-U类型数据,但是-U类型为什么会变成null呢?通过源码我们可以一探究竟:原来-U写入kafka会被直接设置成-D类型,最终成为一条null的消息体。

static void processLastRowOnChangelog(
            RowData currentRow,
            boolean generateUpdateBefore,
            ValueState<RowData> state,
            Collector<RowData> out) throws Exception {
        RowData preRow = state.value();
        RowKind currentKind = currentRow.getRowKind();
        if (currentKind == RowKind.INSERT || currentKind == RowKind.UPDATE_AFTER) {
            if (preRow == null) {
                // the first row, send INSERT message
                currentRow.setRowKind(RowKind.INSERT);
                out.collect(currentRow);
            } else {
                if (generateUpdateBefore) {
                    preRow.setRowKind(RowKind.UPDATE_BEFORE);
                    out.collect(preRow);
                }
                currentRow.setRowKind(RowKind.UPDATE_AFTER);
                out.collect(currentRow);
            }
            // normalize row kind
            currentRow.setRowKind(RowKind.INSERT);
            // save to state
            state.update(currentRow);
        } else {
            // DELETE or UPDATER_BEFORE
            if (preRow != null) {
                // always set to DELETE because this row has been removed
                // even the the input is UPDATE_BEFORE, there may no UPDATE_AFTER after it.
                preRow.setRowKind(RowKind.DELETE);
                // output the preRow instead of currentRow,
                // because preRow always contains the full content.
                // currentRow may only contain key parts (e.g. Kafka tombstone records).
                out.collect(preRow);
                // clear state as the row has been removed
                state.clear();
            }
            // nothing to do if removing a non-existed row
        }
    }


基于以上可以做一个结论:null数据就是-U(upsert_befor)类型数据,并且是添加where条件后引入的。通过测试也可以验证在没有where条件时,写入kafka的数据并不会出现null。那么为什么同样的-U数据,只会在有where语句时才会出现在kafka中呢。最终通过查看执行计划一切真相大白!
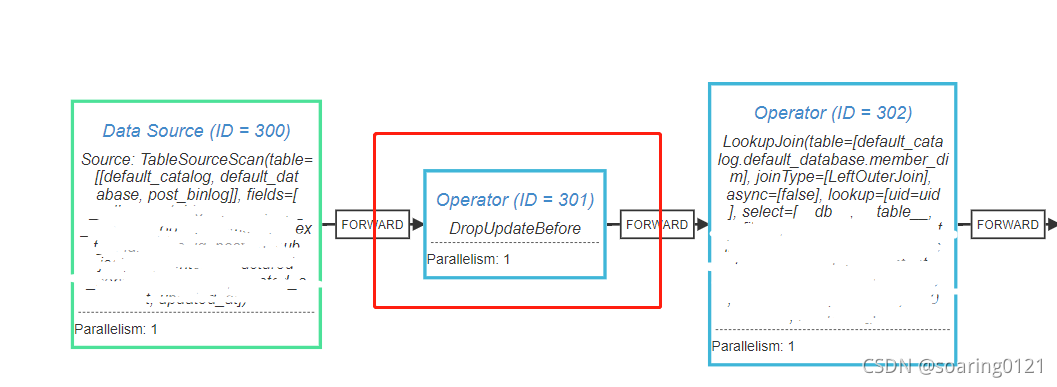
上面的图是不加where语句时flink-cdc的执行计划,和加where语句执行计划的区别就是多了301-DorpUpdateBefore这个算子。原来flink-cdc在upsert-kafka模式下,执行计划在没有where语句时会进行优化,去掉所有的-U数据,这就合理解释了where条件导致的数据差异!

最后,解决kafka中null消息,只需要在flink sql中过滤掉binlog数据类型是-U的数据即可!

从零构建实时数据接入管道:基于Flink与CDC的实战指南 数据接入是构建现代数据架构的基础环节,它负责将分散异构的数据源统一汇聚,为后续的数据处理与分析提供原料。其核心原理在于通过批量或实时方式,将数据从业务系统、日志、物联网设备等源头,稳定、高效地传输到数据中台或数据湖仓。这项技术的价值在于打破数据孤岛,实现数据资产的集中管理与价值释放,是支撑实时分析、智能决策等高级应用的基石。在应用场景上,无论是电商实时推荐、金融风控监控,还是物联网设备状态追踪,都离不开健壮的数据接入能力。本文聚焦于当前业界主流的高效实时接入方案,深入探讨如何结合Apache Kafka、A 阅读详情

相关推荐

基于Flink CDC构建实时数据同步链路,根治搜索延迟8分钟难题

在微服务与数据驱动架构中,数据一致性是核心挑战。传统的数据同步方案,如定时轮询或双写,常因延迟高、可靠性差导致业务数据不一致,影响用户体验与决策。变更数据捕获(CDC)技术通过实时监听数据库日志(如MySQL binlog),将数据变更作为事件流捕获,实现了从被动拉取到主动推送的范式转变。其技术价值在于提供毫秒级延迟、低侵入性的准实时数据流动能力,保障了事务级数据一致性。这一特性使其成为构建实时数仓、缓存更新和搜索索引同步等场景的理想解决方案。本文以Flink CDC为核心,结合Debezium与Elast

aaa1231722的博客 303

Spring集成kafka

producer配置 pom.xml <dependency> <groupId>org.springframework.kafka</groupId> <artifactId>spring-kafka</artifactId> <version>2.1.6.RELEASE</version> </dependency> kafka.properties #==============

qq_22650813的博客 548

基于Flink CDC实现MySQL到Elasticsearch秒级数据同步实战

数据一致性是分布式系统架构中的核心挑战,尤其在微服务与多数据源场景下,数据延迟会导致业务逻辑错误与用户体验下降。其技术原理在于通过变更数据捕获(CDC)机制,实时监听数据库日志变更,将增量数据以事件流形式同步至下游系统。这项技术的核心价值在于以低侵入方式实现端到端的秒级数据一致性,有效支撑实时搜索索引更新、缓存刷新、跨服务数据同步等关键场景。本文聚焦Flink CDC这一主流技术方案,通过热门的Docker Compose快速搭建测试环境,详细演示如何构建从MySQL到Elasticsearch的实时数据管

weixin_34200628的博客 290

kafka消息丢失原因及解决方案

kafka丢失数据原因及解决方案

YoungJ_Zhou的博客 1万+

MySQL CDC 到 BigQuery:binlog 与 Debezium+Kafka 实时同步实战

数据同步是数据仓库建设的基石,传统定时批处理难以满足实时性要求。变更数据捕获(CDC)通过解析数据库日志,实时捕获增删改操作,成为构建实时数据管道的关键技术。binlog 作为 MySQL 的二进制日志,完整记录了所有数据变更,是 CDC 实现的基础。Debezium 结合 Kafka 能够高效订阅 binlog 并将变更事件流式化,为下游提供准实时数据。本文以 MySQL 到 BigQuery 的同步场景为例,对比周期性同步的盲区,详解 binlog 原理、Debezium+Kafka 环境搭建,并给出接

axfcjwkbi259888707的博客 328

基于CDC技术解决分布式系统数据延迟:从MySQL到ES/Redis的实时同步实战

在分布式系统架构中,数据一致性是保障业务可靠性的核心挑战。其原理在于多数据源间的状态同步,传统定时同步方案因固有延迟窗口常导致分钟级不一致。CDC(变更数据捕获)技术通过实时监听数据库日志(如MySQL的binlog),以事件驱动方式实现毫秒级数据流转,技术价值在于构建低延迟、高可靠的数据链路。这一方案在电商、内容平台等对实时性要求高的应用场景中尤为重要,能有效解决搜索与详情页间的数据延迟问题。本文结合Flink CDC等热词,通过实战演示如何构建从MySQL到Elasticsearch和Redis的实时同

weixin_30596343的博客 400

终极Flink CDC实战指南:从零构建企业级实时数据管道

Apache Flink CDC作为新一代实时数据集成平台,正在彻底改变企业数据同步与ETL的工作方式。Flink CDC基于Apache Flink构建,提供端到端的流式数据集成解决方案,支持全库同步、分表合并、schema演进和实时数据转换等高级功能。通过声明式的YAML配置,你可以在几分钟内构建复杂的实时数据管道,而无需编写一行Java代码。 ## 1. 技术架构演进:从传统ETL到现代数

gitblog_00485的博客 843

Flink实时计算核心原理与工程实践:从Kafka到Elasticsearch全链路解析

实时计算是当前大数据处理的重要方向,流处理框架通过逐条处理数据实现毫秒级延迟,颠覆了传统批处理模式。Flink作为领先的流处理引擎,以状态管理、事件时间、水位线和checkpoint机制构建了完整的容错体系,支持Exactly-Once语义,适用于金融风控、实时数仓、用户行为分析等场景。在实际开发中,工程师常面临并行度设置、资源消耗控制、连接器异常排错等挑战。合理配置Flink SQL、合理使用CDC实现数据库变更实时捕获,并结合弹性扩缩容与状态TTL优化,能有效降低资源消耗。针对面试高频问题,理解JobM

cmff98425的博客 412

Flink-CDC 抽取SQLServer问题总结

flink-cdc 抽取数据到kafka 中,使用flink-sql进行开发,相关问题总结

dymkkj的专栏 1631

【Flink】Flink-Kafka序列化反序列化

最简单的是SimpleStringSchema,对字符串进行序列化反序列化,这个Schema中既实现了了序列化,也实现了反序列化 new SimpleStringSchema() union.addSink(new FlinkKafkaProducer011[String]("localhost:9092", "test", new SimpleStringSchema())) val stream3 = env.addSource(new FlinkKafkaConsumer011[String](

一杯咖啡半杯糖的博客 2942

Flink中某个子任务没有数据:解决大数据处理中的问题

可以使用Flink提供的数据源的统计信息,例如数据的键值分布情况,来确定数据是否分布不均匀。然而,有时候我们可能会遇到这样的情况:Flink中的某个子任务没有接收到数据。例如,如果我们将并行度设置为1,那么所有的数据都将由一个子任务处理,其他子任务将不会接收到任何数据。数据分布不均:这可能是最常见的原因之一。如果数据在键空间中的分布不均匀,某些子任务可能会接收到更多的数据,而其他的子任务则接收到很少或没有数据。当发生数据倾斜时,某些子任务可能会处理比其他子任务更多的数据,而其他子任务则几乎没有数据可处理。

NoerrorCode的博客 570

Flink SQL 数据写入MySQL时NOT NULL约束失效的解决方案

本文探讨了Flink SQL写入MySQL时NOT NULL约束失效的问题及其解决方案。通过分析Flink与MySQL类型系统的差异,介绍了关键参数`table.exec.sink.not-null-enforcer`的配置方法,包括代码动态配置、SQL客户端设置和全局配置文件调整。文章还提供了电商订单数据同步的实际案例和进阶技巧,帮助开发者有效处理NULL值问题,确保数据质量和作业稳定性。

weixin_29065791的博客 251

如何更好的理解PFC(功率因数校正)

此电路虽然简单,可以在前期设计的无PFC功能的设备上,简单的增加一个合适的电感(适当的选取L和C的值),从而达到具有PFC的作用,但是这种简单的、低成本的无源PFC输出纹波较大,滤波电容两端的直流电压也较低,电流畸变的校正及功率因数补偿的能力都很差,而且L的绕制及铁芯的质量控制不好,会对图像及伴音产生严重的干扰,只能是对于前期无PFC设备使之能进入市场的临时措施。)在t4~t5期间尽管二极管左边电压在逐步上升,但是由于二极管右边的Uc放电缓慢右边的电压Uc仍旧大于左边,二极管仍旧反偏截止。

U_YAO的博客 948

Apache Doris 集成 Flink:基于 Flink MySQL CDC 与 Doris Connector 的实时数据同步实战

本篇指南以 Apache Doris 仓库中 [samples/doris-demo/flink-demo/docs/instructions.md](https://link.gitcode.com/i/e083fc9c149b77dd13df7018cb96bc1a) 为骨架,完整讲解如何通过 Flink CDC 消费 MySQL binlog,并借助 Flink Doris Connecto

gitblog_00585的博客 482

偷懒必备:3种方法快速移植MFC界面资源(含.rc文件打不开解决方案)

本文针对MFC桌面应用开发,详细介绍了三种快速移植界面资源的实战方法:直接编辑.rc文件、利用Visual Studio“添加现有项”进行可视化挂载,以及双实例拖拽应急方案。文章重点剖析了.rc文件无法打开的常见问题,提供了通过修复rc.exe等关键文件来根治此问题的解决方案,帮助开发者高效复用资源,规避ID冲突等陷阱。

weixin_28358083的博客 271

在Pycharm中配置Pyqt5工具(2023年新版教程)

在Pycharm中配置Pyqt5相关的三个工具:QtDesigner、PyUIC、PYRCC

网络技术和Python 2万+

如何 5 分钟搭好本地 OpenAI 兼容接口:llama.cpp llama-server 本地推理服务完整指南

llama.cpp 是纯 C/C++ 编写的 LLM 推理引擎,llama-server 就是它自带的本地 LLM 推理 HTTP 服务:把一个 GGUF 模型文件交给它,即得到一套 OpenAI 兼容 API、多用户并行解码能力,以及打开浏览器就能用的 Web UI。全程零 Python 运行时依赖,单二进制放到哪台机器上服务就能跑在哪里,这对嵌入式 ARM 设备、老服务器和最小容器镜像尤其友好

gitblog_01030的博客 340

从零开始:使用Mask2Former训练你的专属图像分割数据集

本文详细介绍了如何使用Mask2Former训练自定义图像分割数据集,从环境配置、数据集准备到模型训练与优化。通过实战技巧和问题排查指南,帮助开发者高效完成从零开始的图像分割任务,特别适合需要处理自定义数据集的AI研究人员和工程师。

weixin_30566063的博客 636

Flink CDC:5分钟快速上手实时数据同步的终极指南

在当今数据驱动的世界中,**Flink CDC**作为一款强大的流式数据集成工具,正在彻底改变企业处理实时数据同步的方式。无论你是需要将MySQL的数据实时同步到Kafka,还是希望将Oracle的变更数据捕获到数据湖,Flink CDC都能提供简单高效的解决方案。😊 ## 为什么选择Flink CDC?三大核心优势解析 ### 🚀 极简配置,快速上手 Flink CDC最大的优势在于其*

gitblog_00578的博客 263

Halcon阈值算子 -- 局部阈值之dyn_threshold

Halcon阈值算子 – dyn_threshold HALCON有很多阈值算子,接下来将一一介绍。本文先介绍dyn_threshold。 以下介绍主要参考HALCON帮助文档,并加上自己的体会。如有纰漏,欢迎留言指出 理论介绍 dyn_threshold算子的函数签名如下: dyn_threshold(OrigImage, ThresholdImage : RegionDynThresh : Offset, LightDark : ) 输入参数有: OrigImage:待处理图像 ThresholdIm

m0_47015717的博客 5382

金融行业大数据可视化:实时监控与风险预警系统构建

随着金融业务数字化转型,日均产生的交易数据、市场数据、客户行为数据呈指数级增长(单家银行日交易数据量可达TB级)。数据实时性不足(分钟级延迟难以应对高频交易风险)风险特征挖掘浅层(仅基于规则引擎,漏报率高达30%+)可视化分析能力薄弱(静态报表无法支持动态决策)本文聚焦构建具备毫秒级数据响应智能风险建模交互式可视化决策能力的新一代系统,覆盖数据采集、实时处理、多维可视化、智能预警四大核心模块,适用于银行、证券、保险等金融细分领域。章节核心内容技术亮点核心概念可视化系统架构/数据流模型。

AI天才研究院 1522

markitdown:一条命令把 PDF、PPT、Word 免费转成 Markdown

markitdown 是微软开源(MIT 协议)的 Python 工具,一条命令把 PDF、PPT、Word、Excel 甚至音频图片转成结构化 Markdown。做 RAG 语料管线的人,这就是本机的预处理标配。 ## 🚀 30 秒上手 要求 Python 3.10+,建议虚拟环境隔离依赖。装完跑一条最小转换: ```bash pip install 'markitdown[all]'

gitblog_00068的博客 787

Python爬虫实战:如何通过解析JSON数据抓取抖音视频评论

本文介绍了如何使用Python爬虫抓取抖音视频评论数据。请求头伪造:通过使用随机的User-Agent,模拟真实用户的请求。代理池:使用代理IP来避免被封禁。JSON解析:直接从API接口获取JSON格式的数据,避免了动态加载内容的限制。需要注意的是,抓取网站数据时应遵守网站的爬虫协议,避免过度抓取影响网站性能或违反法律法规。希望本文能够帮助你掌握如何抓取和分析抖音视频评论数据!

2201_76125261的博客 3358

Flink CDC 3.x 快速入门指南:5分钟构建实时数据同步管道

在当今数据驱动的时代,实时数据集成已成为企业数字化转型的关键。Apache Flink CDC 3.x版本作为一款强大的实时数据集成工具,通过声明式配置和零代码方式,让数据同步变得前所未有的简单。本文将为您提供一个完整的快速入门指南,帮助您在5分钟内构建第一个实时数据同步管道。 ## 什么是Flink CDC? Flink CDC是一个基于Apache Flink构建的分布式数据集成工具,专注

gitblog_00519的博客 648

十.镜头知识之畸变问题

对于理想光学系统,在一对共轭的物像平面上,像的放大率是一个常数。但是对于实际的光学系统,当视场较大或很大时,像的放大率就要随视场而异,这样就会使像相对于物体失去相似性。这种使像变形的成像缺陷称为畸变。

AIoT深度探索者 | 嵌入式系统架构师 深耕物联网(IoT)与人工智能(AI)融合技术,聚焦​​边缘计算、图像开发、低功耗通信协议​​,致力于智能硬件,关注我获取最新技术文章信息与海量资源~ 2119

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

TDengine Flink Connector 实战:使用 Sink 与 Table Sink 将 Flink 流批数据写入 TDengine

Apache Flink 是 Apache 软件基金会支持的开源分布式流批一体处理框架,广泛应用于流处理、批处理、复杂事件处理、实时数仓构建等场景,并可通过丰富的连接器对接多种数据源进行读写。本文围绕 [TDengine Flink Connector 官方文档](https://link.gitcode.com/i/dc4b182755a7a5be8e7821a2d7cf142c) 展开,系统讲

gitblog_01097的博客 921

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

上一篇: 解决spark streaming 聚合算子(shuffle)并行度200及缓存buffer不断增大的问题
下一篇: spark作业序列化问题解决方案
soaring0121
博客等级 码龄17年 2941粉丝 28原创
评论 7
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

