零拷贝(mmap+write、sendfile)

【Linux】Linux编程之 mmap解析 前言 虚拟内存系统通过将虚拟内存分割为称作虚拟页(Virtual Page,VP)大小固定的块,一般情况下,每个虚拟页的大小默认是4096字节。同样的,物理内存也被分割为物理页(Physical Page,PP),也为4096字节。 一、mmap基本原理和分类 在LINUX中我们可以使用mmap用来在进程虚拟内存地址空间中分配地址空间,创建和物理内存的映射关系。 映射关系可以分为两种 1、文件映射 磁盘文件映射进程的虚拟地址空间,使用文件内容初始化物理内存。 2、匿名映射 初始化全为0的内存空间。 而对于 阅读详情

传统读操作

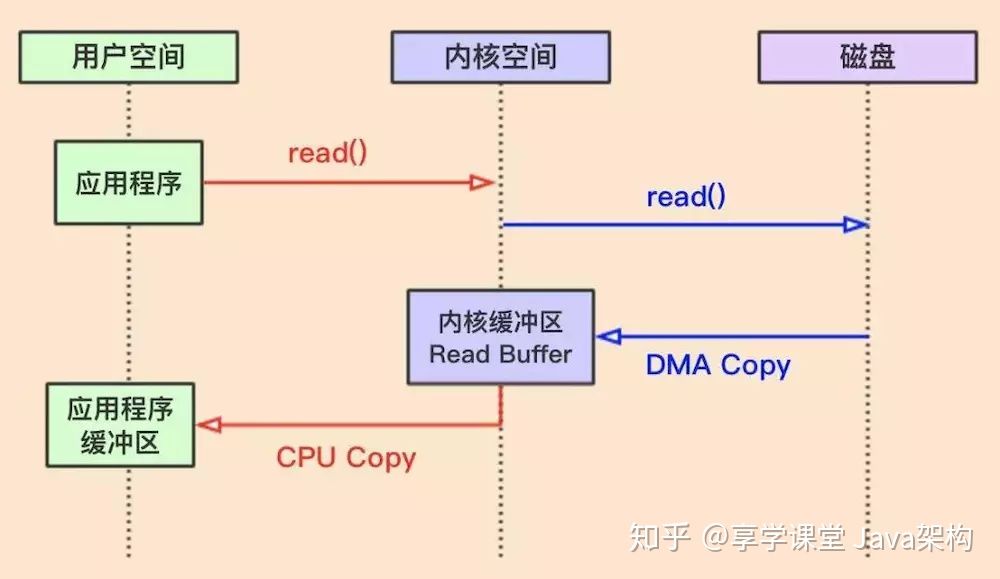
JAVA用传统方式进行读操作时,整体流程如上图,具体如下:

1、应用程序发起读数据操作,JVM会发起read()系统调用。
2、这时操作系统OS会进行一次上下文切换(把用户空间切换到内核空间)
3、通过磁盘控制器把数据copy到内核缓冲区中,这里的就发生了一次DMACopy
4、然后内核将数据copy到用户空间的应用缓冲区中,发生了一次CPU Copy
5、read调用返回后,会再进行一次上下文切换(把内核空间切换到用户空间)

我们看一下一个读操作,发了2次上下文切换,和2次数据copy,一次是DMA Copy,一次是CPU Copy。

注意一点的是 内核从磁盘上面读取数据 是 不消耗CPU时间的,是通过磁盘控制器完成;称之为DMA Copy。

传统写操作
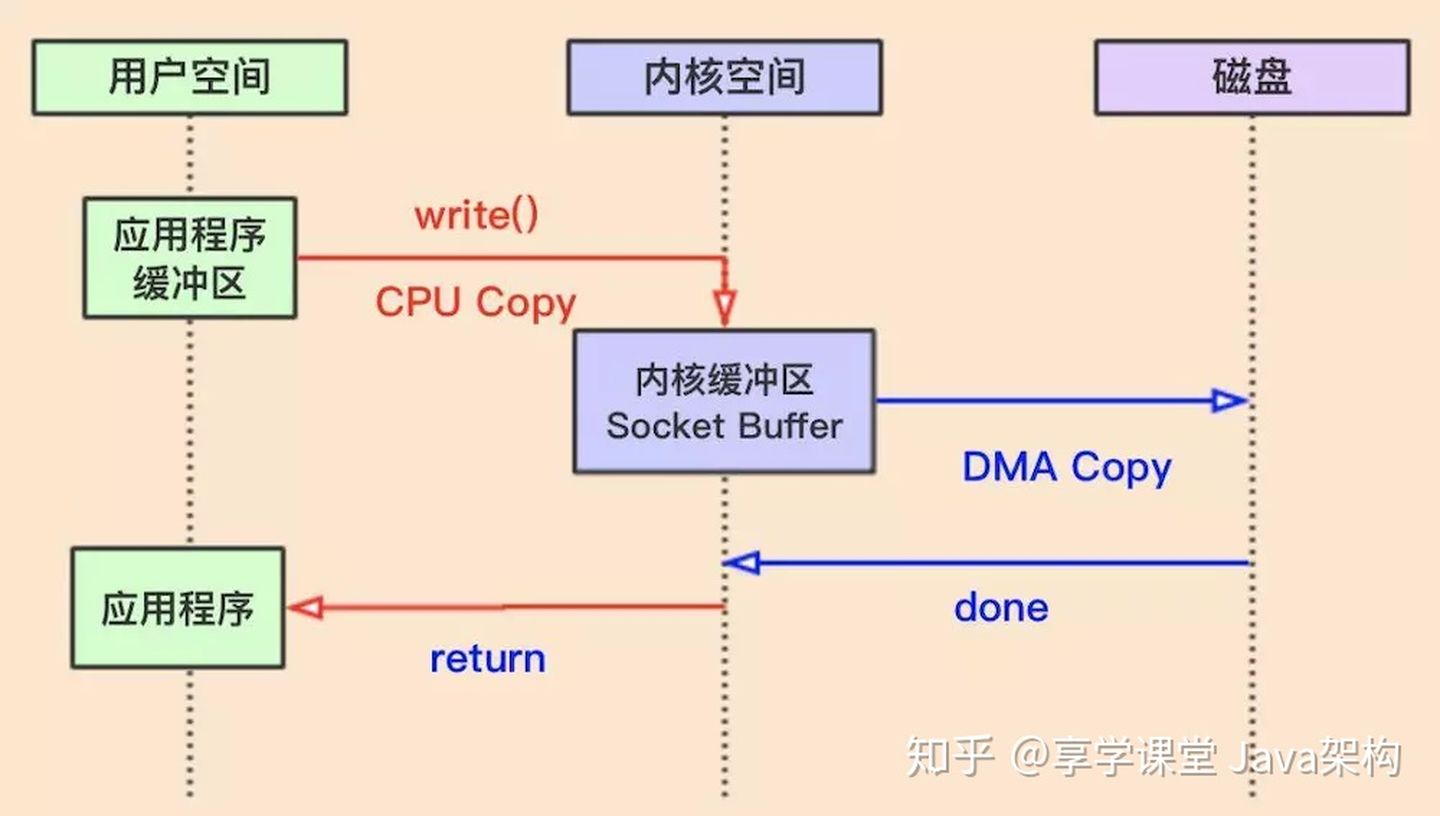
上图是JAVA传统的写操作,具体流程:

1、应用发起写操作,OS进行一次上下文切换(从用户空间切换为内核空间)
2、并且把数据copy到内核缓冲区Socket Buffer,做了一次CPU Copy
3、内核空间再把数据copy到磁盘或其他存储(网卡,进行网络传输),进行了DMA Copy
4、写入结束后返回,又从内核空间切换到用户空间

传统IO

我们可以看出传统的IO读写操作,总共进行了4次上下文切换,4次Copy动作。我们可以看到数据在内核空间和应用空间之间来回复制,其实他们什么都没有做,就是复制而已,这个机制太浪费时间了,而且是浪费的CPU的时间。

那我们能不能让数据不要来回复制呢?零拷贝这个技术就是来解决这个问题。关于零拷贝提供了两种解决方式:mmap+write方式、sendfile方式


虚拟内存

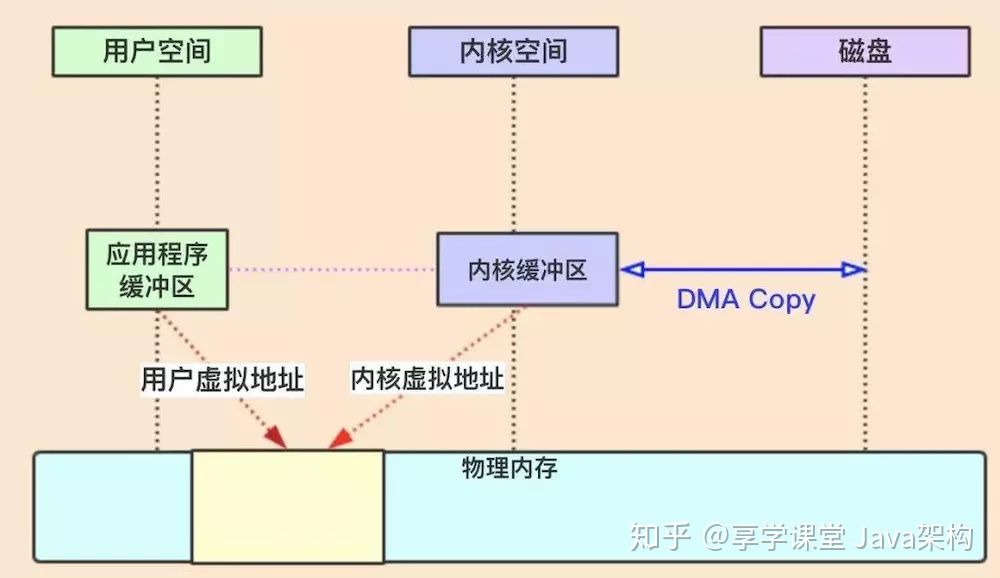
所有现代操作系统都使用虚拟内存,使用虚拟地址取代物理地址,这样做的好处就是:

1、多个虚拟内存可以指向同一个物理地址
2、虚拟内存空间可以远远大于物理内存空间

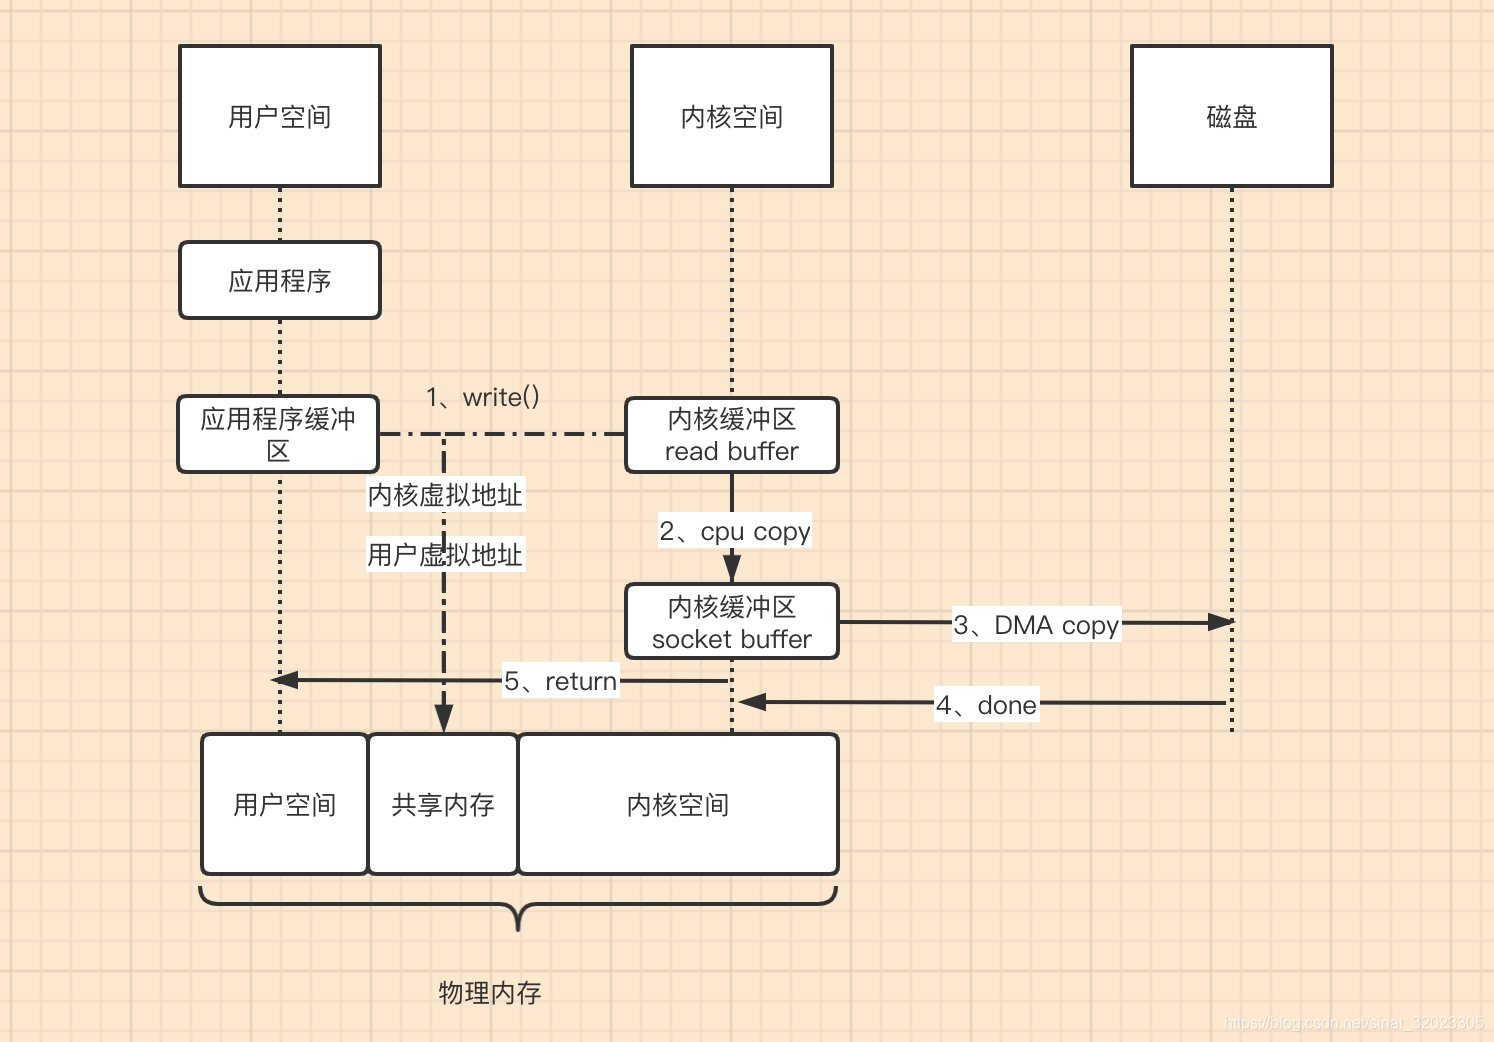
我们利用第一条特性可以优化一下上面的设计思路,就是把内核空间和用户空间的虚拟地址映射到同一个物理地址,这样就不需要来回复制了,看图:
mmap+write方式

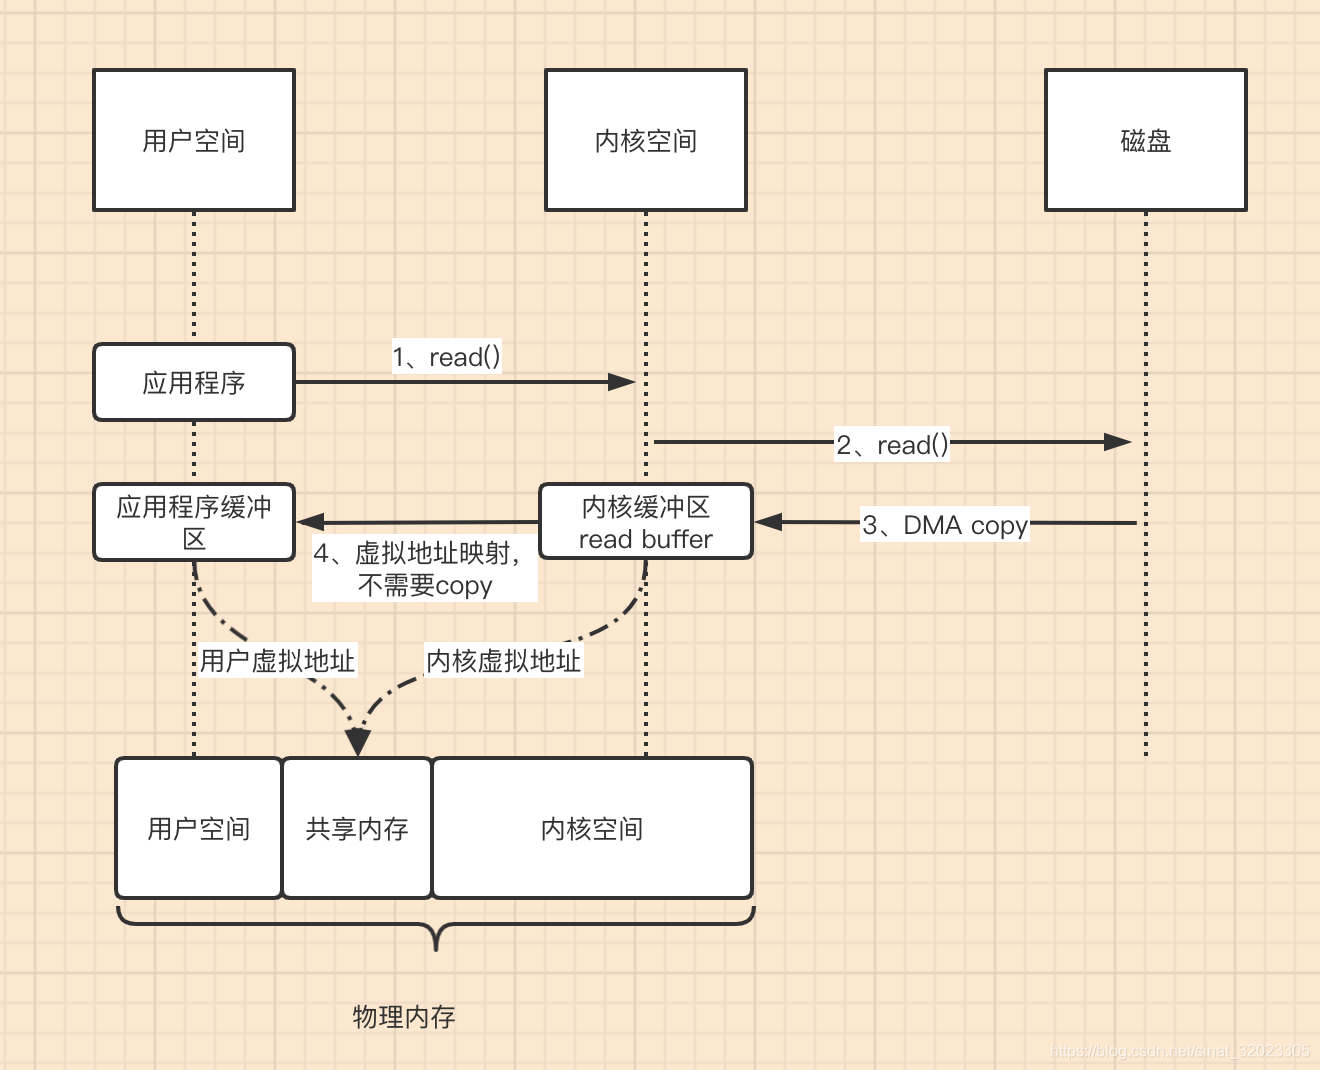
使用mmap+write方式替换原来的传统IO方式,就是利用了虚拟内存的特性,看图
                                                            mmap读流程
mmap写流程

整体流程的核心区别就是,把数据读取到内核缓冲区后,应用程序进行写入操作时,直接是把内核的Read Buffer的数据复制到 Socket Buffer 以便进行写入,这次内核之间的复制也是需要CPU参与的。

注意:最后把Socket Buffer数据拷贝到很多地方,统称protocol engine(协议引擎)

这个流程就少了一个CPU Copy,提升了IO的速度。不过发现上下文的切换还是4次,没有减少,因为还是要应用程序发起write操作。那能不能减少上下文切换呢?

sendfile方式

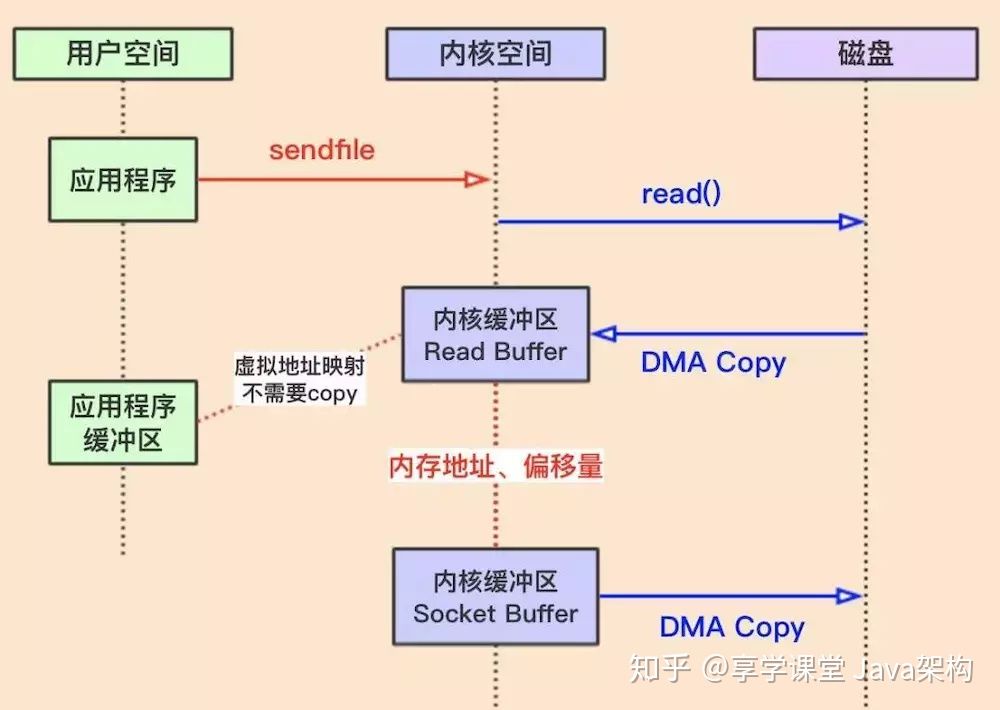
这种方式可以替换上面的mmap+write方式,如:

mmap();
write();

替换为

sendfile();

这样就减少了一次上下文切换,因为少了一个应用程序发起write操作,直接发起sendfile操作。
到这里就只有3次Copy,其中只有1次CPU Copy;3次上下文切换。那能不能把CPU Copy减少到没有呢?

gather

Linux2.4内核进行了优化,提供了gather操作,这个操作可以把最后一次CPU Copy去除,什么原理呢?就是在内核空间Read Buffer和Socket Buffer不做数据复制,而是将Read Buffer的内存地址、偏移量记录到相应的Socket Buffer中,这样就不需要复制(其实本质就是和虚拟内存的解决方法思路一样,就是内存地址的记录),如图:

 

Java零拷贝原理介绍 Java零拷贝原理介绍DMA 传输原理传统IO方式零拷贝方式用户态直接 I/Ommap+writeSendfileSendfile+DMA gather copyJava使用零拷贝基于内存映射(mmap)基于sendfileRocketMQ 和 Kafka 零拷贝使用对比 DMA 传输原理 在介绍IO方式前,先介绍以下DMA传输原理。DMA 的全称叫直接内存存取(Direct Memory Access),是一种允许外围设备(硬件子系统)直接访问系统主内存的机制。也就是说,基于 DMA 访问方式,系统主内存 阅读详情

相关推荐

能不能给我讲讲零拷贝

因为近期收到很多读者的私信,所以也专门创建了一个交流群,感兴趣的读者可以通过上方的公众号获取笔者的联系方式完成好友添加,点击备注。解决,该技术是将内核缓冲区中对应文件数据映射到用户缓冲区空间,使得用户缓冲区操作改动直接映射到内核缓冲区,由此避免了。技术的情况下,上一步将磁盘数据写入到内核缓冲区再通过CPU将磁盘数据拷贝到socket缓冲区步骤可直接有华为,通过。自此我们从一个java开发的角度简单了解了java中零拷贝的方式的运用,希望对你有帮助。有了初步的认识我们就可以更加深入的去分析传统。

禅与计算机程序设计的艺术 366

zero copy java_零拷贝技术(zero-copy)

传统读操作JAVA用传统方式进行读操作时,整体流程如上图,具体如下:1、应用程序发起读数据操作,JVM会发起read()系统调用。2、这时操作系统OS会进行一次上下文切换(把用户空间切换到内核空间)3、通过磁盘控制器把数据copy到内核缓冲区中,这里的就发生了一次DMA Copy4、然后内核将数据copy到用户空间的应用缓冲区中,发生了一次CPU Copy5、read调用返回后,会再进行一次上下文...

weixin_42456372的博客 523

【网络图】:附Origin详细画图教程

网络图,是一种由节点(或顶点)和连接这些节点的边(或链路)组成的图形结构。在网络图中,节点通常代表系统中的一个实体(如项目中的一项任务、通信网络中的一个设备、或运输网络中的一个站点),而边则代表这些实体之间的直接联系或流动(如任务的先后顺序、数据的传输路径、或乘客的旅行路线)。 有向图:如果边具有方向性,即从一个节点指向另一个节点,则称为有向图。这种图常用于表示具有明确先后顺序或方向性的系统,如项目管理中的任务依赖关系。 无向图:如果图中的边没有方向,则称为无向图。它适用于表示实体间相互关联但无明确方向性的

weixin_50236590的博客 3956

什么是mmap?

由于CPU和IO速度的差异问题,产生了DMA技术,通过DMA搬运来减少CPU的等待时间。传统的IO。

线上幽灵 629

基于立创EDA的8口全千兆POE交换机设计详解:RTL8370N芯片与90W大功率供电方案

本文详细解析了基于立创EDA设计的8口全千兆POE交换机方案,核心采用RTL8370N交换芯片与支持90W大功率供电的IEEE 802.3bt标准PD芯片。文章深入探讨了PSE/PD供电管理、电源架构设计、电路细节及关键散热方案,为DIY或学习POE交换机硬件设计提供了完整的开源实践指南。

weixin_29050829的博客 1万+

ptrade从零开始学量化第1期【ptrade如何新建策略、新建回测、新建交易】什么是ptrade量化交易?

回测之前需要对开始时间、结束时间、回测资金、回测基准、回测频率几个要素进行设定,设定完毕后点击保存。然后再点击回测按键,系统就会开始运行回测,回测的评价指标、收益曲线、日志都会在界面中展现。可以选择不同的业务类型(比如股票),然后给策略设定一个名称,添加成功后可以在默认策略模板基础上进行策略编写。交易界面点击新增按键进行新增交易操作,策略方案中的对象为所有策略列表中的策略,给本次交易设定名称并点击确定后系统就开始运行交易了。交易开始运行后,可以点击交易详情,查看策略评价指标、交易明细、持仓明细、交易日志。

GJ57017_wx的博客 2484

零拷贝技术详解

当涉及到网络编程和IO操作时,数据拷贝是一个常见的性能瓶颈。传统的数据拷贝过程中,数据需要从内核缓冲区复制到用户空间缓冲区,然后再从用户空间缓冲区复制到内核缓冲区,这个过程会耗费大量的CPU时间和内存带宽,降低系统的性能和吞吐量。 为了解决这个问题,零拷贝技术应运而生。零拷贝技术是指在数据传输过程中,避免将数据从一块内存拷贝到另一块内存,从而减少了CPU的开销和内存带宽的消耗,提高了系统的性能。 在Java后端开发中,使用零拷贝技术可以有效提升系统的性能和吞吐量。本文将介绍零拷贝技术的概念、实现原理以及

醉逍遥的博客 659

CUBEMX ADC 单/多通道+DMA

本文使用的是STM3F103C8T6 Cubemx进行单/多通道DMA配置。

记录学习 1403

mmap + write怎么实现的零拷贝?

mmap()与write()结合实现的零拷贝机制,通过将文件内容映射到内存,减少了内核与用户空间之间的多次数据拷贝,从而提高了文件 I/O 的效率。这种操作特别适合在数据大、处理频繁的场景中使用,如文件复制、处理大型数据库等。

java永无止境! 1047

scannet数据集下载文件

scannet数据集下载文件 由于大家会申请scannet数据集,审批比较慢,我将下载的文件里面的内容贴出来,大家可以复制放进py文件中,运行就可以下载 ps:别再私信要数据集了,这个自己下载,如果光三维数据的话,还是很快的,当然如果路由器翻了墙的话,下载会更快。 #!/usr/bin/env python # Downloads ScanNet public data release # Run with ./download-scannet.py (or python download-scannet.

weixin_40766438的博客 9234

芯片良率提升:从设计到制造的系统性工程实践

在半导体制造领域,良率是衡量生产效率和成本控制的核心指标,直接关系到芯片的经济效益与市场竞争力。其本质是合格芯片占总产出芯片的百分比,提升良率需要从设计源头到制造末端的全流程协同优化。从技术原理看,它涉及可制造性设计、工艺过程控制、缺陷检测与根因分析等多个复杂环节,尤其在先进制程下,随机缺陷和参数变异成为主要挑战。其技术价值不仅在于降低单颗芯片成本,更能加速产品上市、保障可靠性,并成为企业技术实力的关键体现。应用场景贯穿智能手机、数据中心、自动驾驶和人工智能等所有高端芯片领域。本文将结合【芯片制造】与【良率

weixin_42526068的博客 634

mmap、sendFile、splice三种零拷贝技术介绍

在传统网络数据传输的过程中,数据会被来回拷贝很多次,而其中有一些是不必要拷贝,而零拷贝技术就是为了减少这些不必要的数据复制操作。下面会详细介绍各种数据拷贝的详细过程,这也是一个非常高频的面试问题。对于经常面试的问题,看看还是有帮助的,而且要多看一看了解的更深一些,这样可以在找工作中给自己额外加分,例如splice这种零拷贝在网上介绍它的文章几乎凤毛麟角,在面试中把它讲出来就会让面试官觉得你是经常研究新技术的候选人。

weixin_74412978的博客 1056

画个板子玩一玩STM32F030F4P6,也许是最便宜的32bit MCU

前言,什么是STM32F030F4P6 STM32目前最便宜的芯片之一应该就是这一块,STM32F030F4P6,这一个芯片没有USB,但是其他都有,引脚少,价格低廉,如果找不到原厂,可以买替代的国产芯片,性能也一样。 不管怎么样也是Cortex-M0,比8bit和16bit的性能都强,总的来说就是低价,引脚少,体积小的同时,还容易开发,有很多模拟输入可玩,还有SPI,硬件I2C等等 所以,这一款MCU真的是从理论来说又便宜又好用,非常适合把玩。 画个板,最小系统 STM32F030其..

arenascat的博客 2万+

零拷贝

目录 一、传统IO 1、用户态、内核态 2、DMA拷贝 二、零拷贝 1、mmap+write 2、sendfile 3、sendfile+DMA Scatter/Gather 三、应用场景 1、消息队列 2、NIO 3、Netty 四、总结 平时在面试中你肯定会经常碰见的问题就是:RocketMQ为什么快?Kafka为什么快?什么是mmap? 这一类的问题都逃不过的一个点就是零拷贝,虽然还有一些其他的原因,但是今天我们的话题主要就是零拷贝。 一、传统IO 在开始谈零拷贝

半桶水的博客 712

【MicroPython编程-ESP32篇:设备驱动】-SHT31温度湿度传感器驱动

SHT31 是 Sensirion 的下一代温湿度传感器。 它建立在一个新的 CMOSens® 传感器芯片之上,该芯片是 Sensirion 新湿度和温度平台的核心。

视觉与物联智能 230

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

为什么RocketMQ选择mmap+write?RocketMQ零拷贝技术深度解析

Kafka和RocketMQ性能差异的核心在于零拷贝技术的实现方式。传统read+write模式需要4次上下文切换和4次数据拷贝,而mmap+write通过内存映射减少到4次切换和3次拷贝,RocketMQ采用此方案以支持消息过滤等功能。更高效的sendfile仅需1次系统调用和2次拷贝,但无法处理消息内容,因此被Kafka采用。Kafka适合大数据场景(如Spark/Flink),而RocketMQ更适用于需要消息处理的业务场景。两种方案的选择体现了功能需求与极致性能的权衡。

m0_73866527的博客 855

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

零拷贝技术

在传统的内存拷贝过程中,CPU负责控制数据的传输,首先从源地址读取数据,再将数据写入目标地址。它避免了传统 I/O 操作中的多次用户态和内核态之间的上下文切换和数据拷贝,从而提高了数据传输的效率,尤其是在处理大文件时。进程通过访问这块内存,就可以访问映射文件或设备的数据,而不需要进行显式的数据拷贝。零拷贝并不是没有拷贝数据,而是减少用户态/内核态的切换次数以及CPU拷贝的次数。模式的数据,从而减少了 CPU 的参与,提高了数据传输效率。,显著提高了数据传输效率,减少了系统资源的消耗。

m0_46318653的博客 2177

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

精选(10) 关于零拷贝的一点认识

关于零拷贝的一点认识 前言 从字面意思理解就是数据不需要来回的拷贝,大大提升了系统的性能;这个词我们也经常在java nio,netty,kafka,RocketMQ等框架中听到,经常作为其提升性能的一大亮点;下面从I/O的几个概念开始,进而在分析零拷贝。 I/O概念 1.缓冲区 缓冲区是所有I/O的基础,I/O讲的无非就是把数据移进或移出缓冲区;进程执行I/O操作,就是向操作系统发出请求,让它要...

cowbin2012的专栏 1万+

底层原理 | 零拷贝

1 术语 1.1 零拷贝 "零拷贝"中的"拷贝"是操作系统在I/O操作中,将数据从一个内存区域复制到另外一个内存区域。而"零"并不是指0次复制,更多的是指在用户态和内核态之间的复制是0次。 1.2 CPU COPY 通过计算机的组成原理我们知道,内存的读写操作是需要CPU的协调数据总线、地址总线和控制总线来完成的。因此在"拷贝"发生的时候,往往需要CPU暂停现有的处理逻辑,来协助内存的读写,这种我们称为CPU COPY。 CPU COPY不但占用了CPU资源,还占用了总线的带宽。 1.3 DMA COPY

挖坑埋你 2469

阿里二面:什么是mmap?

平时在面试中你肯定会经常碰见的问题就是:RocketMQ为什么快?Kafka为什么快?什么是mmap? 这一类的问题都逃不过的一个点就是零拷贝,虽然还有一些其他的原因,但是今天我们的话题主要就是零拷贝。 传统IO 在开始谈零拷贝之前,首先要对传统的IO方式有一个概念。 基于传统的IO方式,底层实际上通过调用read()和write()来实现。 通过read()把数据从硬盘读取到内核缓冲区,再复制到用户缓冲区;然后再通过write()写入到socket缓冲区,最后写入网卡设备。 整个过程发生了

HY1273383167的博客 204

彻底搞懂零拷贝:提升系统性能的关键技术

零拷贝技术:提升系统性能的关键 零拷贝(Zero-Copy)技术通过减少数据在用户空间与内核空间之间的冗余拷贝,显著提升系统性能。传统数据传输需多次CPU拷贝和上下文切换,而零拷贝借助DMA(直接内存访问)和PageCache(页缓存)等机制,实现数据在内核空间的直接传输,避免不必要的CPU干预。 核心实现方式: mmap+write:将文件映射到内存,减少一次CPU拷贝。 sendfile:数据直接从磁盘到网络缓冲区,支持SG-DMA实现零CPU拷贝。 splice/tee:在内核空间管道间高效传输数据。

深度Linux 1722

Zero Copy(零拷贝)

转载自:http://blog.youkuaiyun.com/fyxxq/article/details/20000045     http://www.cnblogs.com/metoy/p/4033366.html     https://maimai.cn/article/detail?fid=1236304197&efid=u4GUhDloTNP1da_BcFd-4Q      缓冲区是所有I...

ZERO 1945

Java基础-零拷贝

零拷贝(Zero-copy)是一种计算机编程技术和体系结构设计,旨在减少数据在不同缓冲区或内存区域之间的拷贝次数,从而提高系统性能和效率。零拷贝技术主要用于提高数据传输和处理的速度,特别是在涉及大量数据传输的场景中,如网络通信、文件系统操作和多媒体处理等。DMA(Direct Memory Access,直接存储器访问)是一种让外设(如硬盘、网络接口卡等)与计算机内存之间直接进行数据传输的技术,而不需要通过CPU来传输每一个数据块。

wendao76的专栏 2221
上一篇: 大数据入门
下一篇: 详解tomcat的连接数与线程池
tom和cat
博客等级 码龄11年 100粉丝 113原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值