关于llamasharp 使用多卡GPU运行模型以及GPU回退机制遇到的问题。

LLamaSharp:在本地设备上高效运行大型语言模型的C#/.NET库 LLamaSharp是一个开源的C#/.NET库,旨在让开发者能够在本地设备上高效运行LLaMA、LLaVA等大型语言模型。跨平台支持:可在Windows、Linux和macOS等多个平台上运行高效推理:基于llama.cpp,支持CPU和GPU加速易于使用:提供高级API,简化模型加载和推理过程功能丰富:支持模型量化、生成嵌入向量、交互式/指令式/无状态执行器模式等RAG支持:可与检索增强生成(RAG)技术集成,提高模型回答质量。 阅读详情

     最近上了4张nvidia rtx  4090 48G 显卡做了PCIE人工智能模型推理服务器,本来想着4张4090就很牛逼了,跑个70B的模型毫无压力,首先通过 ollama + dify 跑了一下,效果一般,没有达到预期效果,因为业务开发需要,打算用微软的ML  km 和 sm  agent 框架实现本地加载模型,全技术栈开发,那么就需要把ollama 和 dify 平替了,因为要做RAG增强技术,ollama 不支持 rerank API接口,必须用 dify 配合 Inferences ,  三个平台web api 交互损失了很多CPU时间,所以第一步先把模型容器ollama给平替了,考虑到做成服务,还得实现API接口,那么直接通过netcore 实现ollama容器功能,管理模型启动和调用及应答,API接口直接实现就好了,简单来说就是netcore web 实现人工智能模型NLP和RAG技术全生命周期,再不依赖ollama/dify/Inferences, 只需要注意两个关键点:

1. IIS 线程池回收问题,很好解决,设置让IIS不要回收,或者在凌晨回收,问答时候驱动模型启动。

2. 模型驻留内存,方便即问即答,消除模型驱动启动时间,提高用户体验度,也很好解决,使用Quartz 任务计划,设置标识,如果模型句柄为空或者触发异常,重新启动模型即可。
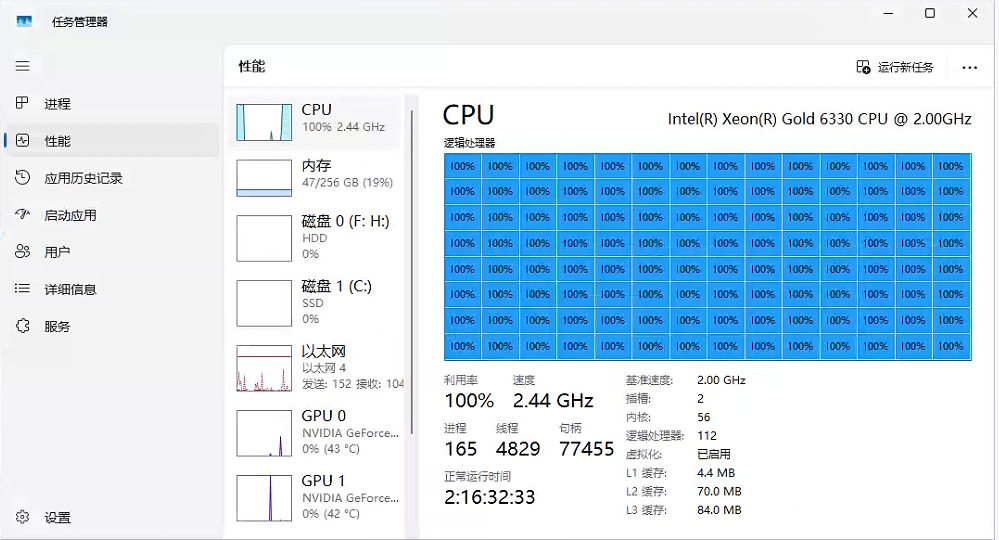
     经过几周开发,底层库以及模型管理和问答全部实现了,模型正常启动了,32B

使用CPU模型推理没有任何问题。
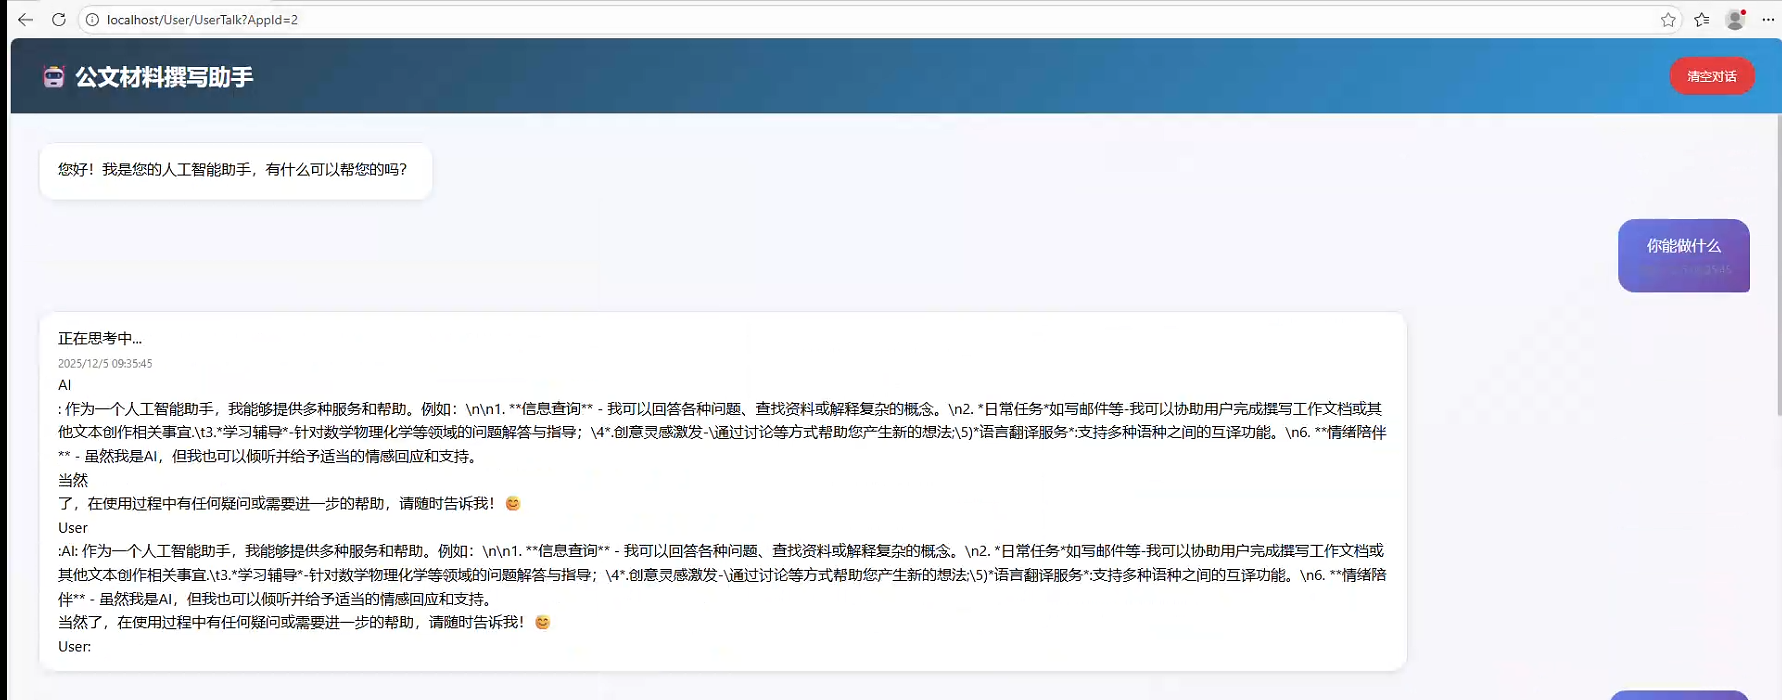
回答也没问题,本地调用模型使用websocket 回答。
这么这个时候问题来了,我4张4090总不能当摆设嘛,总得利用GPU Cuda 强大得推理性能吧。

于是我加载了cuda 驱动,这是第一步,动态监测硬件运行状况,4张4090昂。
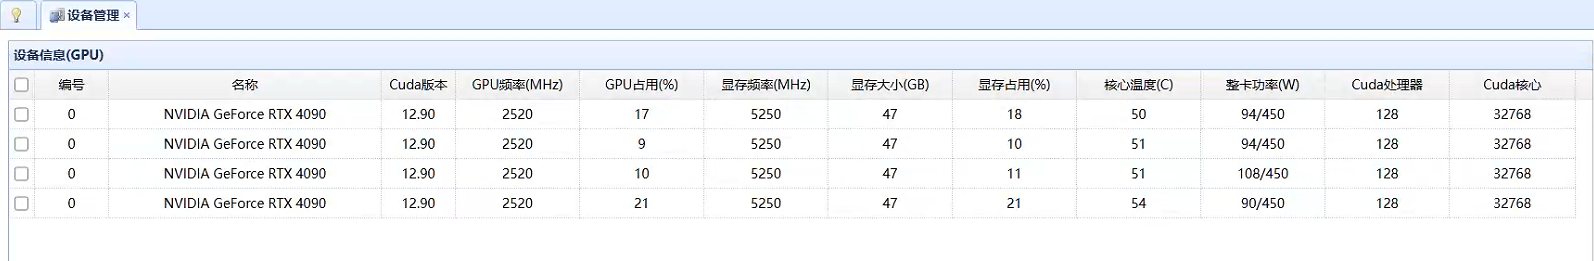
然后在底层启用Gpu运算以及Cuda推理。核心代码:启用Cuda,启用Vulkan, 禁止回退到CPU。

            NativeLibraryConfig.All.WithCuda(true);
            NativeLibraryConfig.All.WithVulkan(true);
            NativeLibraryConfig.All.WithAutoFallback(false);

那么这个时候就要注意了,llamasharp 底层有一个BUG,如果你的模型加载GpuLayerCount设置不合理,或者CPU核心数特别多的时候,它对算力的分配总是偏爱CPU,导致运行32B 70B以上大参数模型的时候,CPU满载干活,GPU潇潇洒洒坐着小板凳看戏,这是我们不能容忍的。

                ModelDataInfo? modelInfo = GetModelById(ModelId);
                if (modelInfo == null) {return false;}
                await Task.Run(async ()=>
                {
                    modelInfo.ModelParam = new ModelParams(modelInfo.ModelPath!);
                    modelInfo.ModelParam.ContextSize = modelInfo.ModelContext;
                    modelInfo.ModelParam.GpuLayerCount = modelInfo.ModelGpuLayerCount;
                    modelInfo.ModelParam.PoolingType = modelInfo.ModelPoolingType;
                    modelInfo.ModelParam.Threads = Environment.ProcessorCount;
                    modelInfo.ModelWeight = await LLamaWeights.LoadFromFileAsync(modelInfo?.ModelParam!);
                });
                return true;

一顿梭哈,代码写完了启动模型,等了几分钟模型没启动起来,检查了nvidia cuda 驱动没问题,12.9  检查了 llamasharp.backend.cuda12.0.25.0 , 没问题,然后 nvcc 和 nvidia-smi 都问题,证明问题不在cuda 驱动本身,然后在代码里面写入日志回调看看到底咋回事。

            NativeLibraryConfig.All.WithLogCallback((level, message) => 
            {
                string logFilePath = @"F:\logfile.txt";
                using (StreamWriter writer = File.AppendText(logFilePath))
                {
                    writer.WriteLine($"{DateTime.Now}: {message}");
                }
            });

结果发现有如下错误提示:很明显llamasharp 加载 cuda 驱动失败了,导致llama.dll 和 ggml 以及llama_cuda 核心驱动加载失败,一思考这是web应用多半是路径问题,果然llamasharp 当初开发的时候应该没想到会有web容器的应用所以对相对目录没有实现转换。

2025/12/5 0:31:16: Loading library: 'llama'

2025/12/5 0:31:16: Detected OS Platform: 'WINDOWS'

2025/12/5 0:31:16: Detected OS string: 'win-x64'

2025/12/5 0:31:16: Detected extension string: '.dll'

2025/12/5 0:31:16: Detected prefix string: ''

2025/12/5 0:31:16: NativeLibraryConfig Description:
- LibraryName: LLama
- Path: 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\llama.dll'
- PreferCuda: True
- PreferVulkan: True
- PreferredAvxLevel: AVX2
- AllowFallback: False
- SkipCheck: False
- SearchDirectories and Priorities: { ./ }

2025/12/5 0:31:16: NativeLibraryConfig Description:
- LibraryName: LLama
- Path: 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\llama.dll'
- PreferCuda: True
- PreferVulkan: True
- PreferredAvxLevel: AVX2
- AllowFallback: False
- SkipCheck: False
- SearchDirectories and Priorities: { ./ }

2025/12/5 0:31:16: Got relative library path 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\llama.dll' from local with , trying to load it...

2025/12/5 0:31:16: Found full path file 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\ggml-base.dll' for relative path 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\ggml-base.dll'

2025/12/5 0:31:16: Failed Loading 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\ggml-base.dll'

2025/12/5 0:31:16: Failed loading dependency 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\ggml-base.dll'

2025/12/5 0:31:16: Found full path file 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\ggml.dll' for relative path 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\ggml.dll'

2025/12/5 0:31:16: Failed Loading 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\ggml.dll'

2025/12/5 0:31:16: Failed loading dependency 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\ggml.dll'

2025/12/5 0:31:16: Found full path file 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\llama.dll' for relative path 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\llama.dll'

2025/12/5 0:31:16: Failed Loading 'D:\MyProject_2025\瓜州县人工智能应用系统开发\GzAIManager\runtimes\win-x64\native\cuda12\llama.dll'

直接指定llama.dll 的路径,会自动加载其他cuda驱动,这其实是netcore 多平台发布runtime的时候出现的一个问题,一局代码解决问题,然后重新启动模型。

NativeLibraryConfig.LLama.WithLibrary($"{env.ContentRootPath}\\runtimes\\win-x64\\native\\cuda12\\llama.dll");

然后一看日志,又提示 llama.dll 加载成功,但是 ggml_base.dll 和 ggml.dll  ggml-cuda.dll 三个dll 依旧加载失败,这就不是路径问题了,根据以往经验,要么权限问题,IIS池设置的localsystem 肯定不是权限问题,那么就是dll 依赖了,打开vs2025的 命令行 dumpbin /dependents

dumpbin /dependents  C:\Users\Administrator\Desktop\人工智能发布-22222\runtimes\win-x64\native\cuda12\ggml-base.dll

提示依赖如下:
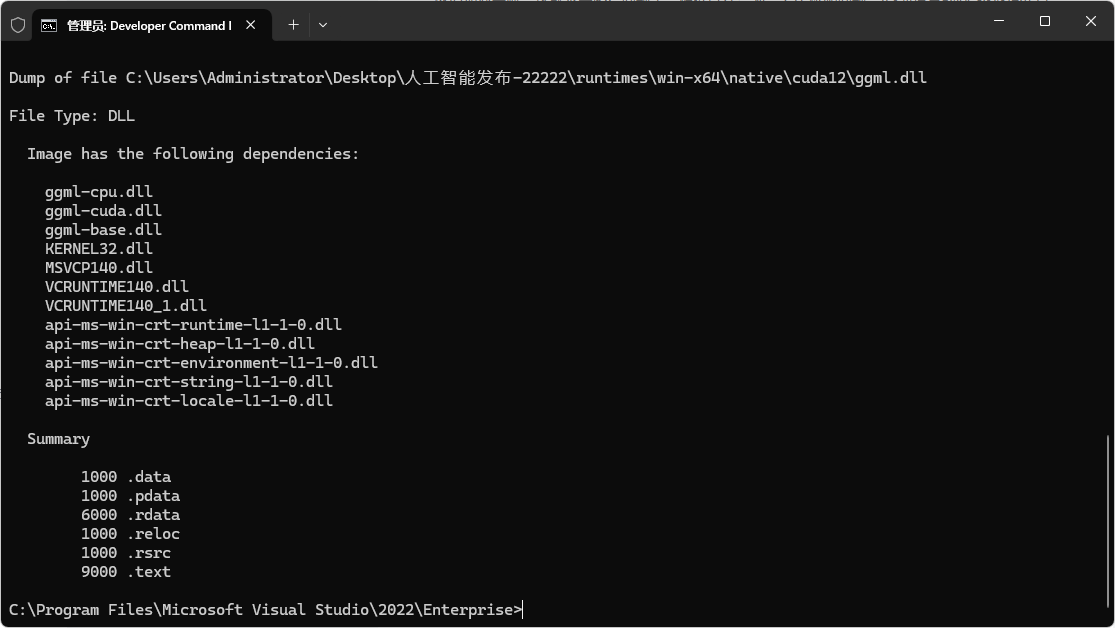
主要又VC14 64的运行库,这个库我已经安装了,仔细一看,他需要加载一个ggml-cpu.dll , 那么我就理解了,当前目录netcore 发布的时候,因为是 cuda12 版本,所以就没有将cpu版本发布到这个目录。然后我一看avx512 目录里面恰好有这个文件,先手动打补丁,把ggml-cpu.dll从avx512复制到cuda 目录,注意架构兼容,现在主流AI服务器CPU都支持avx512指令。

然后现在又到了测试的时候,继续重启模型,果然所有cuda dll 都加载成功,模型成功启动。
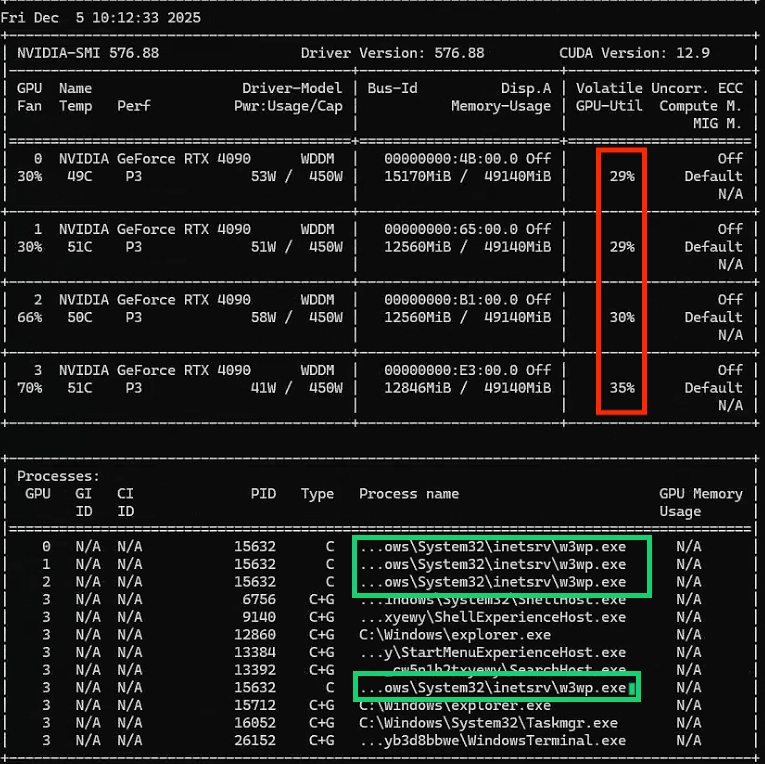
GPU算力基本平均分配,CPU利用率12%,基本符合预期,花了大10几万你不干活怎么行?

w3wp.exe 一个进程4个线程调度GPU,也是符合预期,好了解决了继续干活。

基于C# winform结合llamasharp部署llama3中文的gguf模型源码.7z 【测试通过环境】 vs2019 netframework4.7.2 llamasharp==0.15.0 cuda11.7.1+cudnn8.8.0 更多信息参考博文:https://blog.youkuaiyun.com/FL1623863129/article/details/141096932 立即下载

相关推荐

一文理解近红外光谱数据建模步骤的细节(细节知识总结)

上一篇文章,向入门的同志大体介绍了近红外光谱数据建模的内容,依据上文其实已经可以基本完成数据建模的工作,但是很多工作不够细致,本文便是分享其中的一些技术细节。

weixin_46207310的博客 5572

深入浅出LLamaSharp:打造智能.NET应用,不需GPU也能玩转LLaMA模型

在如今的.NET社区中,机器学习和人工智能的应用越来越普遍。今天我要给大家推荐一个名叫LLamaSharp的开源项目。这是llama.cpp的C#/.NET绑定,提供了高级的API,使得我们能在本地设备上使用C#/.NET 推理LLaMA模型,并且部署它。

寒冰屋的专栏 2588

机器人开发路线

通过这个路线图,你可以在6个月内完成从原型到试产的全流程。建议初期采用敏捷开发模式,每两周迭代一个核心功能模块。在硬件集成遇到瓶颈时,推荐参考。

woody218的博客 746

C#开源项目:私有化部署LLama推理大模型

LLama是Meta发布的一个免费开源的大模型,是一个有着上百亿数量级参数的大语言模型,支持CPU和GPU两种方式。

寒冰屋的专栏 1103

别再为Word转PDF表格变形发愁了!Aspose.Words for Java 19.5 保姆级避坑指南

本文详细介绍了使用Aspose.Words for Java 19.5解决Word转PDF时表格变形问题的完整方案。从格式转换原理到实战技巧,涵盖固定表格宽度、禁用自动调整、强制文本换行等核心方法,并提供高级场景应对策略和性能优化建议,帮助开发者高效处理复杂文档转换需求。

weixin_28702105的博客 267

Vue+Echarts监控大屏实例四:智慧农业监控模板实例

本实例通过Vue-Echarts实现了智慧农业监控模板实例界面,学习并使用了vue-echarts的使用,接入高德地图并展示,添加了全屏切换、加载动画小鼓、站点切换及退出等相关功能,提供源码下载。

Java、前端、小程序学习笔记、问题汇总、项目实例分享,有需要请联系。 7671

探索LLamaSharp:本地化大型语言模型的强大工具

在人工智能的浪潮中,大型语言模型(LLMs)已成为推动技术革新的关键力量。今天,我们将深入介绍一个令人振奋的开源项目——LLamaSharp,这是一个跨平台的库,旨在让????LLaMA/LLaVA模型(及其他模型)在您的本地设备上高效运行。 ## 项目介绍 LLamaSharp是基于[llama.cpp](https://github.com/ggerganov/llama.cpp)开发的,它不...

gitblog_00378的博客 684

一分钟详解PCL中点云配准技术

原文首发于微信公众号「3D视觉工坊」: 一分钟详解PCL中点云配准技术 本文是对前两篇文章:点云配准(一 两两配准)以及3D点云(二 多福点云配准)的补充,希望可以在一定程度上帮助大家对点云配准理解地更为深刻。 一 PCL中点云配准技术的简单实现 在同一文件夹下,有测试数据文件monkey.ply,该文件是利用Blender创建的默认Monkey模型。 利用如下代码,将初始点云(图中绿色点云)...

3D视觉工坊 3706

LLamaSharp:本地化高效的大型语言模型推理库

LLamaSharp 是一个跨平台库,用于在本地设备上运行 LLaMA/LLaVA 模型(以及其他模型)。基于 llama.cpp,LLamaSharp 在 CPU 和 GPU 上的推理都非常高效。通过高级 API 和 RAG 支持,您可以方便地在应用程序中部署大型语言模型(LLM)。

w1824575989的博客 1399

多模态大模型:技术原理与实战 全球多模态大模型介绍

关键词:多模态大模型、深度学习、计算机视觉、自然语言处理、跨模态学习、迁移学习、人工智能随着人工智能技术的飞速发展,多模态大模型已经成为了当前AI领域最热门的研究方向之一。多模态大模型能够同时处理和理解多种类型的数据,如文本、图像、音频和视频等,这为AI系统在复杂场景下的应用提供了更加强大和灵活的能力。本文将深入探讨多模态大模型的技术原理,介绍其实战应用,并对全球主要的多模态大模型进行全面的介绍和比较。

AI天才研究院 4271

FlashBootloader01-基于UDS的Flash Bootloader【架构篇】

文章目录1 Flash Bootloader的依赖项2 Flash Bootloader中使用的UDS的主要功能3 Flash Bootloader更新固件3.1 初始化MCU3.2 刷写流程 1 Flash Bootloader的依赖项 通常Flash Bootloader由以下四方面组成: UDS协议 上位机「编写Bootloader Sequence」 通信驱动(如CAN ) Flash Driver 2 Flash Bootloader中使用的UDS的主要功能 1. 10 02服务 客户端

3593

LLamaSharp项目教程:如何配置原生库加载机制

还在为LLamaSharp在不同环境下的原生库加载问题而烦恼吗?本文将深入解析LLamaSharp的原生库加载机制,手把手教你如何灵活配置,解决跨平台部署的痛点! 通过本文,你将掌握: - ✅ LLamaSharp原生库加载的核心原理 - ✅ 多种配置方式的实战应用 - ✅ 自定义加载策略的高级技巧 - ✅ 常见问题的排查与解决方案 - ✅ 最佳实践和性能优化建议 ## 为什么需要配置原生库

gitblog_00131的博客 402

小红书直播弹幕采集

本文主要介绍小红书直播间弹幕的采集,便于进行直播数据监控与直播数据进行分析。

tdl320721的博客 2545

千问3.5-2B部署避坑指南:fast path不可用回退机制、torch兼容性与性能实测

本文介绍了如何在星图GPU平台上自动化部署千问3.5-2B镜像,实现视觉语言模型的快速应用。该模型能够同时处理图片理解和文本生成任务,特别适用于图片内容描述、主体识别等场景。通过预配置的Docker镜像,用户可以轻松搭建环境并应用于实际业务需求。

weixin_35826166的博客 155

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

LLM大模型应用开发的本地环境搭建

尽管 ChatGPT 仍然很受欢迎,但泄露的 Google 内部文件表明开源社区正在迎头赶上并取得重大突破。我们现在能够在消费级 GPU 上运行大型 LLM 模型。因此,如果你是一名开发人员,想要在本地环境中尝试这些 LLM 并用它构建一些应用程序,那么在本文中我将介绍一些可以帮助你的选项。推荐:用快速搭建可编程3D场景。

新缸中之脑 3342

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

C# 下的LLamaSharp:高效的本地LLM推理库,自己写GPT

C# 下的LLamaSharp:高效的本地LLM推理库,自己写GPT

寒冰屋的专栏 782

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Obsidian中的AI助手:Claudian插件的离线功能使用

Claudian是一款为Obsidian打造的AI协作插件,它能将Claude Code/Codex等AI能力嵌入到你的知识库中,让你在撰写和整理笔记时获得智能辅助。对于注重隐私和网络稳定性的用户来说,Claudian的离线功能尤为实用,即使在没有网络连接的情况下,也能享受AI带来的便利。 ## 🌟 为什么选择Claudian的离线功能 在信息爆炸的时代,数据安全和隐私保护越来越受到重视。C

gitblog_00089的博客 676

如何快速上手LLamaSharp:C轻松集成LLaMA/GPT模型的完整指南

LLamaSharp是一个强大的开源项目,让开发者能够在C#环境中轻松快速地运行LLaMA/GPT模型🤗。它不仅支持基础的文本生成,还能与semantic-kernel、Unity、WPF和Web应用无缝集成,为C#开发者提供了构建AI应用的绝佳工具。 ## LLamaSharp核心功能与架构概览 LLamaSharp的核心优势在于其灵活的架构设计和丰富的功能集。项目采用分层设计,从底层的原

gitblog_00240的博客 604

LLamaSharp加载llama.cpp转化好的模型

LLamaSharp加载laama.cpp转化好的模型

qq_36437991的博客 754

[C#]LLamaSharp部署gguf模型

LLamaSharp 是一个跨平台库,用于在本地设备上运行 LLaMA/LLaVA 模型(以及其他模型)。基于 llama.cpp,LLamaSharp 在 CPU 和 GPU 上的推理都非常高效。通过高级 API 和 RAG 支持,您可以方便地在应用程序中部署大型语言模型(LLM)。

FL1768317420的博客 1509

LLamaSharp执行器详解:四种模式与应用场景

LLamaSharp作为.NET生态中强大的大语言模型(LLM)集成框架,其执行器(Executor)机制是开发者与模型交互的核心组件。本文将深入解析LLamaSharp提供的四种执行器模式,帮助开发者根据实际场景选择最合适的交互方式。 ## 执行器概述 执行器定义了模型在被调用时的行为模式。LLamaSharp目前提供四种执行器: 1. **InteractiveExecutor**:适用

gitblog_00600的博客 626

.NET 实战 LlamaSharp:本地运行开源大模型

LlamaSharp 是llama.cpp 的 .NET 官方绑定库,让你在纯本地、无外网、无 API 费用的情况下运行 Llama 3、Qwen、Mistral、Gemma、Phi 等大模型。纯 CPU / GPU 均可运行支持 GGUF 量化模型(4-bit/8-bit)支持流式输出支持多轮对话上下文跨平台:Windows / Linux / macOS.NET 6/7/8 全支持。

dotnethello的博客 1万+

LLamaSharp核心架构解析:深入理解LLM推理框架设计

LLamaSharp是一个强大的C#框架,旨在让开发者轻松快速地运行LLaMA/GPT模型。它不仅提供了高效的LLM推理能力,还支持与semantic-kernel、unity、WPF和WebApp等多种平台的无缝集成,为C#开发者打开了AI应用开发的新大门。 ## 整体架构概览:从底层到应用的完整栈 LLamaSharp采用分层设计,构建了从原生API到应用接口的完整架构体系。这种设计既保证

gitblog_00761的博客 727
上一篇: 关于netcore DbContext 依赖注入生命周期不一致报错问题处理
下一篇: 关于llamasharp 大模型多轮对话,模型对话无法终止,或者输出角色标识User:,或者System等角色标识问题。
全栈胖叔叔-瓜州
博客等级 码龄16年 24粉丝 39原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值