Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift--论文解析

深度学习-Batch Normalization 学习笔记 深度学习,Batch Normalization 算法学习笔记 阅读详情

1、概述

BN层来源于2015年的论文《Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift》。在训练深度网络的时候,随着训练进行,每一层输入的分布会发生变化,这种现象称为internal covariate shift,这使得网络训练需要更小的学习率,更仔细的初始化,并且使得饱和非线性激活函数(saturating nonlinearities)更加难以使用。

使用了BN之后,可以使用较大的学习率,并且不需要过多的关注参数初始化,BN层也是一种正则化,某些情况下可以替代dropout(dropout也是一种正则化方法,可以缓解过拟合,提高模型泛化性能,但是dropout会减慢收敛速度,而BN层却能大幅提高训练速度)。论文里报告的结果达到了4.9% top-5 validation error (and 4.8% test error),超过了人类水平。

2、算法说明

算法流程如下所示
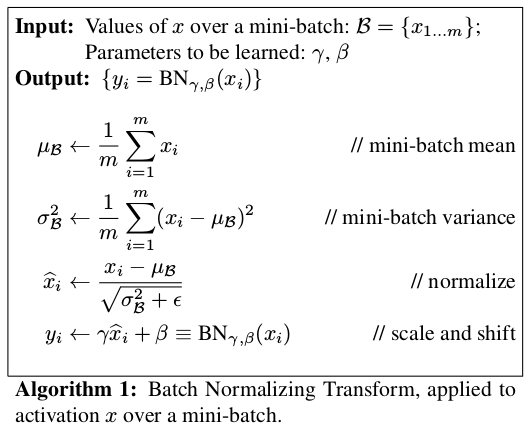
其中\epsilon是为了数值稳定引入的常数,tensorflow中\epsilon默认值为0.001。加入参数\gamma和\beta是为了使得BN层具有identity transform的能力(这一点和ResNet中的思想类似),如果训练过程中使得\gamma=\sqrt{\sigma^2_{\mathcal{B}}+\epsilon}并且\beta=\mu_{\mathcal{B}},那么就相当于y_i=x_i。在有BN层的时候,mini-batch的size要大于1,否则1个样本的情况下减去均值就等于0。

在加入BN层之后,网络整体的训练流程如下所示
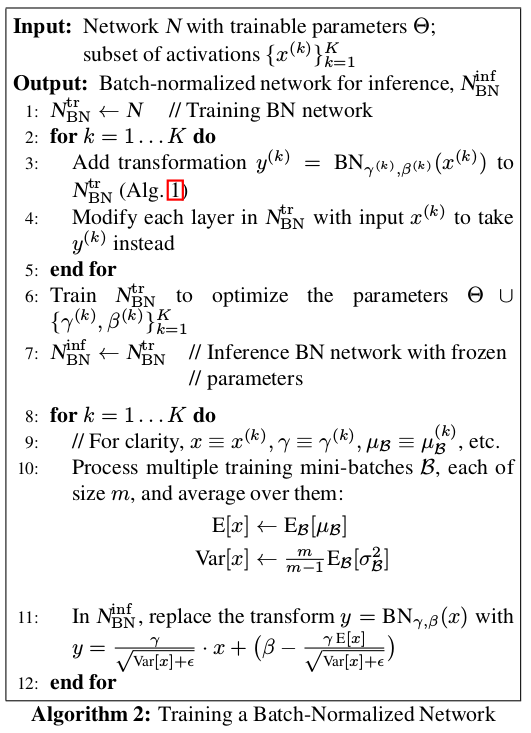
上面这个整体的训练过程中重点在于第10行和第11行,上图中的做法是每一个mini-batch计算单独的均值和方差,然后进行BN转换,下一个mini-batch再重新计算均值和方差,最后模型训练结束后把所有的mini-batch均值和方差再求个均值作为最终的E(x)和Var(x),参数\gamma和\beta在训练中按照梯度下降进行更新。模型推断的时候,BN转换按照上图第11行的公式计算,其实这个公式就是把E(x)和Var(x)带入本文第一张图中Algorithm1中的公式得到的。

需要注意的是,在tensorflow中,最终的均值和方差不是按照论文中这种方法计算的,而是采用了滑动平均(moving averages,实际论文中也提到了这种方法),tf.layers.batch_normalization中的计算方法是得到mini-batch之后,计算其均值和方差,然后和上一个mini-batch的均值方差进行加权求和。tf.layers.batch_normalization中有一个参数momentum用来控制加权。

比如当前mini-batch的均值和方差为1和0.1,上一个mini-batch平滑后的均值和方差为0.7和0.2,当momentum=0.9的时候,当前mini-batch平滑后的均值为0.9*0.7+(1-0.9)*1=0.73,平滑后的方差为0.9*0.2+(1-0.9)*0.1=0.19。

另外还需注意的是,BN层的均值和方差不会自动完成平滑操作,因此需要用下面这种写法。

update_ops = tf.get_collection(tf.GraphKeys.UPDATE_OPS)
optimizer = tf.train.GradientDescentOptimizer(learning_rate)
with tf.control_dependencies(update_ops):
    train_op = optimizer.apply_gradients(grads_and_vars=gradients)

通过tf.get_collection(tf.GraphKeys.UPDATE_OPS)可以获得更新均值和方差的操作,在进行训练之前首先进行更新操作,否则均值和方差一直保持初始化的值不变。

3、总结

  1. 加入BN层可以缓解Internal Covariate Shift,提升模型性能。
  2. 加入BN层之后允许较大的学习率,缓解了传统深度网络在较大学习率时出现的梯度消失和梯度爆炸问题。
  3. BN层具有正则化的效果。
  4. 在卷积网络中对于一个特征图学习一组参数\gamma和\beta,这样可以减少参数数量。
《Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift》论文导读 深度神经网络在训练过程中,由于前面层的参数变化,会导致后面层输入的分布发生变化,这种现象被称为“Internal Covariate Shift”(内部协变量偏移)。这种偏移会使得网络训练变得复杂,需要较低的学习率和谨慎的参数初始化,从而减慢了训练速度,并可能导致模型难以收敛。为了解决这个问题,作者提出了Batch Normalization方法。 阅读详情

相关推荐

Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift论文笔记

虽然GoogLeNet在ILSVRC2014上斩获了各种大奖,但是GooGle的各位大牛依然没有闲着,他们马上又抛出了一个新的问题:Internal Covariate Shift,也就是本文要研究的问题,他们提出了一个新的层:Batch Normalization(BN),不仅能够很好的解决这个问题,而且在增快训练速度的基础上能够有效的提高模型的性能。

小时候贼聪明 2914

【BN层的作用】论文阅读 | How Does Batch Normalization Help Optimization?

15年Google提出Batch Normalization,成为深度学习最成功的设计之一,18年MIT团队将原论文中提出的BN层的作用进行了一一反驳,重新揭示BN层的意义

bettii的博客 811

笔记:batch normalization:accelerating deep network training by reducing internal covariate shift

概述:机器学习系统中输入分布不均称为covariate shift。对于复杂网络系统,某层输入分布不稳定称为internal covariate shift.本文提出了batch normalization技术来解决deep neural network训练中这个的问题。

easylifer的专栏 3738

深度学习论文--Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift

本文翻译论文为深度学习经典模型之一:GoogLeNet-BN 论文链接:https://arxiv.org/abs/1502.03167v3 摘要:训练深度神经网络的难度在于:前一层网络参数的变化,导致每一层输入的分布也随之变化。通常需要设置小的学习率以及小心的初始化,因此降低了网络的学习速度,并且经常出现非线性饱和,最终导致深度网络难以训练。本文称这种现象为内部协方差偏移(internal ...

DAOCHI 4208

Batch Normalization: Accelerating Deep Network Training by Reducing Internal.pdf

Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift

[kriging](一)网上下载的kriging克里金的C++程序的初步调试

笔者在网上下载了一份克里金的C++程序,水平有限,正在逐步地调试中。 初步 克里金法现在在许多软件都已经有集成了,据笔者所知: arcgis : 看过有的arcgis培训视频里面简略介绍了里面的插值方法,有克里金。 surfer :笔者用过这个,效果很好。 gocad :听说有 landmark &jason :研究生时候用的专业的石油物探软件,里面有克里金法,万恶的开始。 pykrig...

FOREST优快云 5611

Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift全文翻译

Inception v2 Sergey Ioffe,Christian Szegedy Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift - 原文 论文解读 精读深度学习论文(3) Batch Normalization 0 摘要 由于训练过程中各层输入的分布...

种树最好的时间是10年前,其次是现在!!! 8702

叶绿体基因组提交NCBI全流程避坑指南

叶绿体基因组作为环状细胞器DNA,其数据提交并非简单上传,而是需严格遵循INSDC标准的学术出版行为。其核心原理在于元数据完整性、拓扑结构语义一致性与分类学路径精确匹配;技术价值体现在保障序列可追溯、可复现、可互操作;典型应用场景涵盖植物系统发育、条形码开发及合成生物学底盘构建。实践中,FASTA头行格式、feature table嵌套规则、taxid绑定及BankIt静默校验等环节极易引发失败。本文聚焦NCBI|叶绿体基因组数据上传中的高频报错与隐性约束,提供面向生物信息工程师的实操级规范解析。

weixin_31960565的博客 326

Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift

训练深度神经网络很复杂,因为在训练过程中,随着前一层参数的变化,每层输入的分布也会发生变化。。批量归一化应用于最先进的图像分类模型,以减少 14 倍的训练步骤实现相同的精度,并大幅优于原始模型。使用批量归一化网络集合,我们改进了 ImageNet 分类的最佳已发表结果:达到 4.82% 的 top-5 测试误差,超过了人类评分者的准确性。

u013049912的博客 1513

hpm6750evk2开发板(一)菜鸟入门

hpm6750与我们平时常用的stm单片机在开发环境和开发方法上有很大的区别,所以上手还是需要花一点时间的,拿到板子先不要急着上电调试,我们先找资料学习一下了,免得多走冤枉路,以下是我整理的一些学习资源,包括开发板使用手册、芯片SDK、开发工具、视频资料等,建议先把使用手册和学习视频先看了,再取搭建环境测试。最近刚入手一块hpm6750evk2开发板,花了几天时间学习,算是菜鸟入门了,今天分享一下学习过程。看完资料后,把开发工具安装上,下一篇文章我们分享一下调试工程的过程和遇到的问题。

Silas1750的博客 3085

某程token参数逆向分析

作者声明:文章仅供学习交流与参考!严禁用于任何商业与非法用途!否则由此产生的一切后果均与作者无关!如有侵权,请联系作者本人进行删除!

weixin_73499887的博客 2882

Batch Normalization:加速神经网络训练的通用手段

本文详尽介绍了近几年在深度学习领域十分重要的“小trick,大杀器”——Batch Normalization,实际编码实现对比加入BN前后模型的性能表现差异。

hyman.lu 2929

实现两端固支梁热力耦合的有限元分析

在本文中,我们将使用Matlab实现两端固支梁的热力耦合有限元分析。我们假设梁的材料是均匀的,梁的截面积为1,长度为1,两端固支,且受到均匀分布的热荷载。接下来,我们需要组装全局刚度矩阵和热传导矩阵。对于两个相邻的元素,它们共享一个节点,因此需要使用连接矩阵将局部矩阵组装成全局矩阵。接下来,我们需要定义元素刚度矩阵和热传导矩阵。然后,我们需要定义载荷向量。然后,我们需要定义边界条件。在这个例子中,梁的两端固支,因此我们需要将两端节点的位移限制为0。最后,我们需要解决线性方程组,得到节点的位移和温度分布。

CyberSparkZ的博客 396

Batch Normalization的Darknet代码解析

Batch_Norm公式推导与Darknet代码理解 论文:《Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift》 URL:https://arxiv.org/pdf/1502.03167.pdf 1. Batch_Norm的正向推导 2. Batch_Norm反向推导 其中对均值与xi的求导会用到复合函数的求导计算: 3. darknet代码 3.

YMilton的专栏 447

YOLOv11改进策略【Neck】| PRCV 2023,SBA(Selective Boundary Aggregation):特征融合模块,描绘物体轮廓重新校准物体位置,解决边界模糊问题

SBA 模块在医疗图像分割中具有重要作用,其设计出发点是解决图像中物体边界模糊以及融合特征时的冗余和不一致问题。

Limiiiing的博客 1943

MATLAB基础应用精讲-【数模应用】信用评分模型(附R语言和python代码实现)

信用评分模型是近年来兴起的一种为了保障银行和其他金融部门的金融安全而设立的一种关于人身金融权限的划定模型。该模型指根据客户的信用历史资料,利用一定的信用评分模型,得到不同等级的信用分数,根据客户的信用分数,来决定客户所可以持有的金额权限,从而保证还款等业务的安全性。而随着在现代社会和公司中,贷款,信用卡的作用日渐突出,信用评分模型的发展前景不可估量。信贷风险是指借款人因偿还贷款或履行合同承诺而破产而产生损失的可能性。传统上,它与贷款人无法偿还所欠利息和本金、影响现金流和增加装配成本所产生的风险有关。

qq_36130719的博客 364

手推Assignment2中BN反向传播

手推Assignment2中BN反向传播0.说在前面或许有些人对于上一节说的BN推导没有深入理解,那么本节则从一篇非常好的论文中来实践带大家手推一遍,与此同时,完成Wee...

Francis的博客 431

从零开始跑通3DGS教程:(四)修改(缩放、空间变换)colmap生成的sfm结果

通过colmap进行的sfm的普通方式会丢失场景的物理尺度信息,并且并不在符合一般认知的坐标系下,本文将读取colmap生成的点云和相机pose,将其进行空间变换和缩放之后,重新保存,新保存的结果仍然可以被colmap读取以及进行后续的稠密重建以及3dgs等工作

诺有缸的高飞鸟的博客 1424

【论文阅读】Batch Normalization:Accelerating Deep Network Training by Reducing Internal Covariate Shift

Batch Normalization,BN-Inception

qq_34222839的博客 1315

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

【论文泛读】 Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift

【论文泛读】 Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift 文章目录【论文泛读】 Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift摘要 Abstract介绍 Introduction减少 Internal Covariate Shift

风信子的猫Redamancy的快乐星球 5922

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

Batch Normalization:Accelerating Deep Network Training by Reducing Internal Concariate Shift《》

internal covariate shift: 由于训练过程中网络参数的变化,导致网络内部激活层分布的变化。 这种思想的由来: 1,统计机器学习中有一个经典的假设:训练数据和测试数据是满足相同分布的。covariate shift:训练集的样本数据分布变化时,训练得到的模型无法很好的Generalization。 2,在神经网络中的各输出层可以作为下一层的输入层,也就是输出层可以作为训练数据,...

weeeeeida的博客 2494

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

批归一化Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift论文详解

背景: BN层为深度学习领域最经典结构之一,被深度网络广泛采用。我们需要深入理解BN的作用及机制。 目的: 详解BN论文。 论文地址:https://arxiv.org/abs/1502.03167v2 目录 一、概览 Motivation Solution Benefits 实验验证 二、问题背景 2.1 SGD中mini batch 2.2 梯度 2.3 mini-ba...

祥瑞的技术博客 1897

批归一化《Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift》

批归一化《Batch Normalization: Accelerating Deep Network Training b y Reducing Internal Covariate Shift》读后总结前言文章主要内容与贡献提出了批归一化(Batch Normalization, BN)数值实验 前言 这是一些对于论文《Batch Normalization: Accelerating Dee...

yzqlyzql的博客 624
上一篇: 基于图的图像分割方法 Efficient Graph-Based Image Segmentation
下一篇: py3compile: not found 问题解决
__Destiny__
博客等级 码龄9年 27粉丝 41原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
