LLM 规划,编译器生成:以工作流为契约的确定性 SQL 生成器

AI已能产出可运行的 SQL,但可运行不等于可审计。

在复杂查询上,公开评测显示最先进模型在 BIRD-bench 等基准上的执行准确率常在六成左右徘徊,远未达到可直接评审通过的程度。典型偏差不在语法,而在窗口边界、分区键、聚合口径等较复杂逻辑,尤以会话化、时序 gap、动态透视等场景尤甚。SQL需多层嵌套 CTE 与窗口累加,关联条件隐蔽,改一处需从最内层逐层验证是否影响外层。

后果是三重成本叠加:难以 review、难以单步调试、难以跨库移植。代码确实能跑,但逻辑是否对,还需要把嵌套在脑子里完整重跑一遍才能确认。

LLM 直出 SQL 的确定性问题

问题的根因不在 AI 能力,而在范式。让概率模型直接承担终态 SQL 的生成,把“规划”与“生成”绑在同一次采样中,确定性无从保证。

看个例子:一张状态流水表,每行记录一个 ID 在某时刻的状态 NewStatus,需求是取出每个 ID 在 ConfirmationStarted 之前最近的那条 Closed。

直接让 AI 产出这条 SQL,常见结果为多层嵌套:

WITH t2 AS (
		SELECT CreatedAt, ID, NewStatus
			, 1 + SUM(CASE
				WHEN NewStatus = 'ConfirmationStarted' THEN 1
				ELSE 0
			END) OVER (PARTITION BY ID ORDER BY ID ASC, CreatedAt ASC ROWS UNBOUNDED PRECEDING) AS seg
		FROM mytable
	)
SELECT ID, MAX(CreatedAt) AS CreatedAt
FROM (
	SELECT CreatedAt, ID, NewStatus, seg
	FROM (
		SELECT CreatedAt, ID, NewStatus, seg
		FROM (
			SELECT CreatedAt, ID, NewStatus, seg
			FROM t2
			WHERE NewStatus = 'Closed'
		) t_1
		WHERE seg = 1
	) t_2
	WHERE ID IN (
		SELECT ID
		FROM (
			SELECT ID
			FROM t2
			WHERE NewStatus = 'Closed'
				AND seg = 1
		) t_3
		GROUP BY ID
	)
) t_4
GROUP BY ID
ORDER BY ID

这段 SQL 能跑对,但要逐层展开才能验证逻辑是否正确,这就是让 AI 直接产终态 SQL 的代价:每一步都藏在嵌套里,无法单步审计。

要恢复确定性,需将规划与生成分离。

架构总览:规划与生成分离

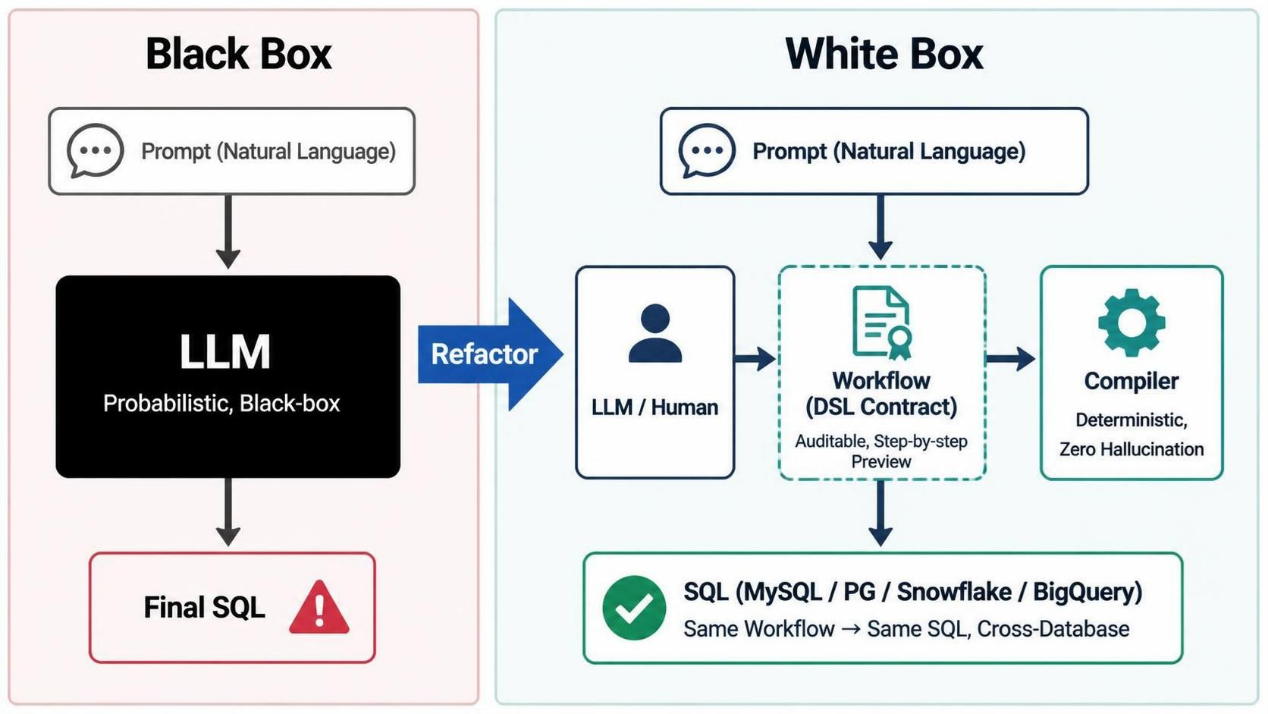
把一次性的 Prompt→SQL 黑盒拆为 Prompt→Workflow→SQL 白盒,Workflow 即契约。
Picture1png

三个环节:

Planner:人或 LLM 产出自然语言步骤集,负责把口语需求拆解为顺序步骤

Workflow:DSL 契约,结构清晰、问题分解、人类可读、每步可执行预览、本身就是可执行的文档。同一 Workflow 永远对应同一结果

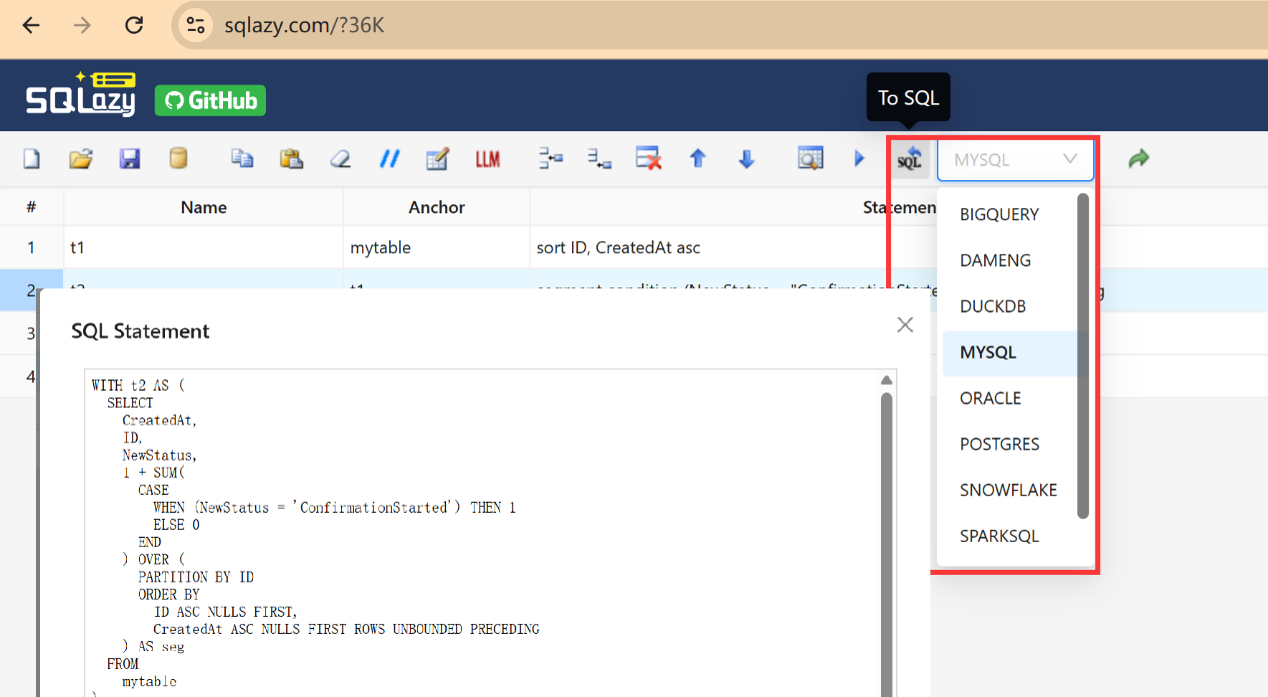
Compiler:确定性编译器,按固定规则将 Workflow 翻译为目标方言的原生 SQL。一份 Workflow 可编译为 MySQL、PostgreSQL、Snowflake、BigQuery 的原生 SQL

契约作用在于约束两端。LLM 的输出受 DSL 约束,不直接产出SQL;编译器的输入即 Workflow,不做猜测。同一 Workflow 今天与明天编译,结果完全一致。Workflow 本身成为可审计的逻辑文档,审查者无需猜测 AI 意图,只需审阅步骤。

SQLazy正是这种架构的具体实现:LLM只规划步骤,编译器确定性生成SQL。

关键设计

三个设计点共同支撑确定性与可审计性。

设计 1 :步骤 DSL 与单步调试

步骤按人类思考顺序组织,错在第 2 步就只改第 2 步。每步可独立执行并预览中间表,边界偏差在中间结果中直接显现,无需在最终结果中反推。以分段为例,执行后立即看到分段列的取值,分段是否按预期切分当场可判。

设计 2 :确定性编译

编译器按固定规则翻译,非概率生成。Workflow 中的排序、筛选、分段、聚合等操作,分别一一对应到 ORDER BY、WHERE、SUM(CASE WHEN) OVER(PARTITION BY) 分段、GROUP BY 等 SQL 语法,无幻觉,可复现。同一 Workflow 跨次执行、跨机器执行始终一致,满足受监管场景对可追溯的要求。

设计 3: 变更审计与版本化

Workflow是纯文本契约,天然可进 Git 做版本管理。逻辑变更只改对应步骤,SQL 由编译器自动重建,逻辑与 SQL 不会脱节。每次变更可 diff、可评审、可回滚,历史清晰可查,监管审计只需翻 Git 提交记录。

实例验证与适用范围

用前面的例子验证一下。

源数据 mytable:

CreatedAtIDNewStatus
2022-05-25 23:17:44147Active
2022-05-28 05:59:02147Closed
2022-06-18 05:59:01147Closed
2022-06-25 05:59:01147Closed
2022-07-13 00:02:47147ConfirmationStarted
2022-08-25 05:59:01147Closed
2023-04-29 05:59:021645Closed
2023-05-08 14:53:341645ConfirmationStarted

期望结果仅两行(147→2022-06-25,1645→2023-04-29),其余 Closed 要么过早,要么在 ConfirmationStarted 之后。

在 SQLazy 中,同一逻辑按顺序写作 Workflow:

NameAnchorStatement
t1mytablesort ID, CreatedAt asc
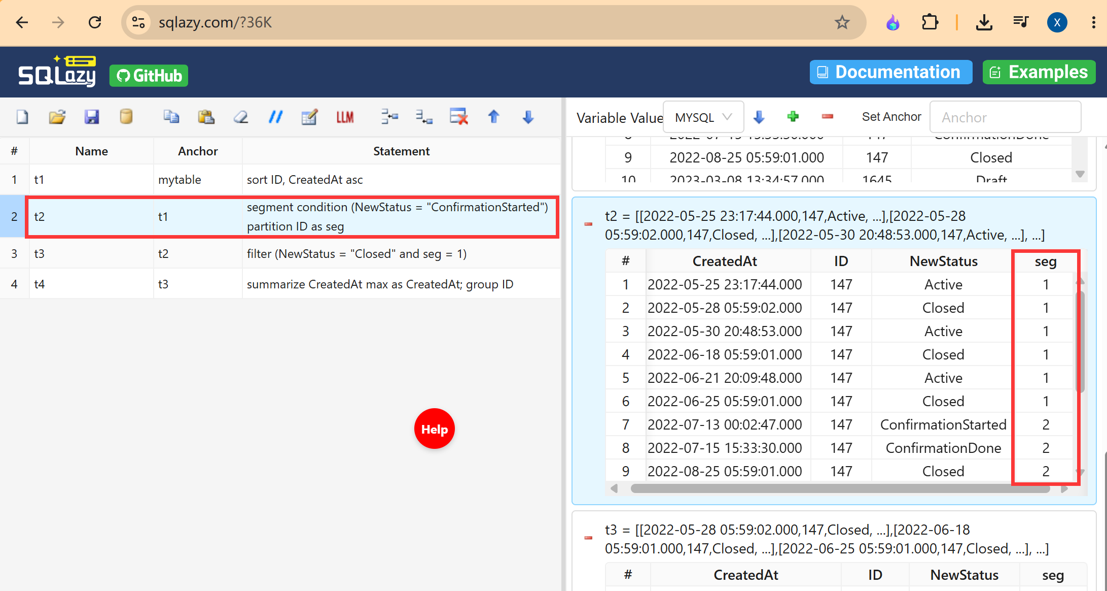
t2segment condition (NewStatus = "ConfirmationStarted") partition ID as seg
t3filter (NewStatus = "Closed" and seg = 1)
t4summarize max CreatedAt as CreatedAt; group ID

第 1 步 sort ID, CreatedAt asc 按 ID 与时间排序,确保时序正确。sort对应 ORDER BY。

第 2 步 segment condition (NewStatus = "ConfirmationStarted") partition ID as seg 按 ConfirmationStarted 切段,partition ID保证每 ID 独立分段。执行后多出一列 seg,seg=1 即目标区间,无需手写SUM(CASE WHEN ...) OVER。分段对不对,点开 t2 看 seg 列即可。
Picture2png

第 3 步 filter (NewStatus = "Closed" and seg = 1) 只保留目标区间内的 Closed。filter对应 WHERE。

第 4 步 summarize max CreatedAt as CreatedAt; group ID 按 ID 分组取最大时间,即最近一条。summarize对应 GROUP BY 与聚合。

Workflow写完点编译,按固定规则产出的 SQL(与前面的 SQL 相比步骤更清晰):

WITH t2 AS (
        SELECT CreatedAt, ID, NewStatus
            , 1 + SUM(CASE
                WHEN (NewStatus = 'ConfirmationStarted') THEN 1
                ELSE 0
            END) OVER (PARTITION BY ID ORDER BY ID ASC, CreatedAt ASC ROWS UNBOUNDED PRECEDING) AS seg
        FROM mytable
    )
SELECT ID, MAX(CreatedAt) AS CreatedAt
FROM (
    SELECT CreatedAt, ID, NewStatus, seg
    FROM t2
    WHERE (NewStatus = 'Closed'
        AND seg = 1)
) t_3
GROUP BY ID
ORDER BY ID

同一 Workflow 多次编译结果完全一致,切换方言无需改 Workflow。
Picture3png

适用范围同样需要诚实说明。简单 CRUD 直接写 SQL 更合适,为三五行逻辑引入 Workflow 并不划算;宏与循环等能力尚在路线图中。SQLazy 的定位是复杂分析逻辑的设计与验证,随后嵌入 dbt 等工作流,而非替代。

产品与开源的边界:SQLazy 的语法与示例开源,编译器与 IDE 为商业闭源并提供免费版;IDE 支持本地 / 私有化部署,契合企业对数据出境与离线使用的要求。

AI writes the logic. A compiler writes the SQL.

相关推荐

应用开发中占比不低的报表为啥很难享受 AI 编程的红利

LLM 需要依靠海量公开文本完成训练,但复杂报表开发是融合数据提取、业务逻辑计算、复杂可视化排版、交互打印的复合型工作,逻辑交织,不能用线性文本简单描述,大模型缺乏训练数据,自然无法支撑专业报表开发。在 AI 编程全面重塑软件开发的当下,企业应用中大量复杂的固定报表开发却难以享受这波技术红利,究其根本,主要受制于两大核心阻碍。这种“LLM+ 规则引擎”的混合架构,既增加了 AI 的自由与灵活,又守住了企业报表场景对 100% 准确率的要求。不过,也有能啃硬骨头的,润乾报表就迎难而上,趟出了一条新路子。

Raqsoft 66

能不能把智能问数(Text2SQL)功能集成进自己的应用?

加载几个 JAR 包,配好配置文件,应用里直接调 JDBC 接口就能跑。不需要单独部署 AI 服务,不需要复杂接口对接,像集成普通报表组件一样,无缝对接到业务系统里。现在智能问数倒是有大把方案,但一个比一个重,动不动就要单独部署一套 AI 服务,挂 GPU 集群,配 AI 工程师,比应用系统本身还复杂,单独用起来都不容易,集成更是痴人说梦。它不是一个独立部署的庞然大物,而是一个轻量的“智能问数引擎”,可以以组件形式直接嵌入到业务系统内部。把智能问数能力做到自己的应用里,不用建 AI 团队,不用买 GPU。

Raqsoft 187

智能问数(Text2SQL)的两大方案及实施成本

现在流行挂个 RAG 知识库,把表结构、字段名、业务术语全向量化存起来,每次查询时现去检索相关片段喂给大模型。只做一件事,把口语化的自然语言转成有规则的自然语言,也就是“规范文本”。然后规则引擎根据预先配置好的业务词典和映射规则,把规范文本编译成 100% 准确的 SQL。核心工作量在配置业务词典,把用户爱说的“华北区”“在途订单”这些词,跟数据库表和字段对上。关键是,规则是写死的、确定的。SQL 怎么生成、逻辑怎么组合,全都写在规则里。出了问题,查规则、改词典、补映射,改完就知道对不对,没有不确定性。

Raqsoft 146

AI 化的自助报表和 ChatBI 有什么区别?

这种白盒机制对 ChatBI 的准确性也有极大帮助,当其他 ChatBI 还在为 LLM 的“幻觉”和错误挣扎时,润乾通过让人类随时介入和纠正,将不确定性限制在可控范围内,既保留了对话的便捷,又守住了数据准确性的底线,让产品真正具备了在企业级复杂场景中可靠落地的底气,这才是让 AI 报表从“玩具”走向“生产工具”的关键所在。然而,当前市面上的 ChatBI 大多是全面基于 LLM 实现的,确实能生成分析图表,但都是一次性输出,AI 化的自助报表已经打包进润乾报表的工具版中,,比如先生成一张简单表。

Raqsoft 118

非高频但真趁手,报表工具这个AI功能太方便了

这种功能平时可能不常用,但一旦遇到复杂报表的批量整改,这种说句话就能全选中修改好的爽快感真的让人离不开。它把原本需要半小时的“体力活”压缩到了几秒钟,这才是报表工具该有的智能化体验。如果报表简单,手动改改也就罢了;但若是面对下面这种几百个格子的复杂大报表,想靠肉眼一个个去“找茬”,行高大于 10 的行标成橙色也是一句话搞定,不用挨个去找去看行高。Copilot 即会自动检索并锁定字体为黑体的所有单元格。报表交付后,再根据用户反馈来修改报表,是很正常的事情。比如上面的任务,只需要两个命令就能完成。

Raqsoft 196

智能问数Text2SQL的JOIN噩梦怎样被DQL终结?

Text2SQL 火了三年,有一道行业级的坎始终迈不过去:多表关联(JOIN)。演示环境里百发百中的工具,一进入企业真实数据环境就频频翻车。在 Spider 这类标准多表数据集上,主流大模型方案的执行准确率仅在 60%-82% 之间;而面对网状交织的企业级复杂模型时,复杂跨表场景的准确率甚至会跌破 30%。现实是,绝大多数企业的业务数据都分散在几十上百张表里,80% 以上的日常查询都涉及多表关联。JOIN 问题解决不了,智能问数就只是演示玩具。

Raqsoft 23

做一个项目就能回本的 AI 报表工具,更多都是赚到

这意味着,只要支付相当于一名工程师一个月的成本,就能在一年内无限量地使用这款专注报表领域二十多年的专业工具,无论你的项目有多成功、服务器如何扩容,都不需要再追加一分钱授权费。某能源行业软件公司,随着项目越来越多,服务器节点也从 5 个猛增到一百多个,但因为采用了润乾报表的工具模式,他们无需再为扩容追加一分钱,一年三万买断企业级全功能版本,还有 AI 提升开发效率,做一个项目轻松回本,多出来的每一个项目,省下的授权费都是企业实打实的纯利润!报表工具卖了这么多年,成本一直不低,项目越多、服务器节点越多,

Raqsoft 156

自助报表 /BI 多维分析从 GUI 到 LUI 的进化

这样就可以极低成本为中小企业提供 AI+BI 的整体解决方案赋能,帮助企业跨越技术鸿沟,轻松迈入省钱又省人力的智能时代。,能够作为轻量级模块无缝嵌入企业现有的 OA、CRM、ERP 等业务系统中,不需要单独部署和管理独立沉重的 BI 系统。,彻底免去了学习专业操作的烦恼,只要能描述清楚分析需求,几乎所有人都能轻松上手,极大的拓宽了数据分析的场景。太过口语化的命令可能工具会识别效果不好,这时候可以请 LLM 帮忙,规范成工具可以理解的语言命令。用户只需直接输入分析需求,系统即可自动理解并进行各种分析。

Raqsoft 231

加上AI Copilot,这成了史上门槛最低的报表工具

目前尚无法像其它 AI 编程领域那样做到 “一句话生成所有复杂报表”的程度,部分工作仍需传统方式操作,但利用 AI 持续优化各个环节,降低使用门槛并解放开发者的生产力,也是报表技术演进中极具意义的进步。开发人员往往需要熟练记忆报表工具的各类函数语法、属性配置与布局设计,不仅前期学习成本高昂,后期也常被束缚于繁琐的重复性工作中,开发效率难以实现质的飞跃。”的深刻转变,极大地降低了报表工具的学习成本与难度,称其为史上门槛最低的报表工具也不算夸张。长期以来,报表开发一直属于不难,但是门槛也不低的任务。

Raqsoft 119

智能问数Text2SQL项目为啥经常是一地鸡毛

它包含字段映射、表间关系、维度层次、度量定义,还有一套可扩展的词汇体系,字段词、比较词、聚合词、宏词、动词……词典够丰富,描述能力才够强,复杂查询才能被准确翻译成规范文本,覆盖范围更广更复杂的查询场景。大模型有幻觉,就不要让它直接生成 SQL,而只是负责翻译成用户可读的“规范文本”,用户确认“是这个意思”之后,不能再由大模型负责执行,而由确定的规则引擎编译成 100% 准确的 SQL,这解决了算不准的问题。语义层不仅要建,还得足够复杂、足够丰富,否则描述能力太弱,用户换种问法就懵了。仿佛怼上数据库就能跑。

Raqsoft 127

搞一套 AI 加持下的对话式 BI 多维分析要多少成本?

LLM 只负责将自然语言转化为规范指令,再由规则引擎 100% 准确执行指令进行分析,避免 LLM 直接生成 SQL 或者报表的幻觉风险,另外 LLM 只负责规范语言命令,Token 费用会很低,LLM 不接触数据,也不存在数据安全问题。近年来,BI 工具很是火热,但高昂的价格始终是绕不开的门槛,无论是国外还是国内厂商,动辄数十万的授权费、按用户数叠加的订阅费,都让许多中小企业望而却步。,已经有很多场景验证过了,有需要的同学也可以去试试,反正软件是用好了才买单的。

Raqsoft 210

智能问数Text2SQL想落地,要在承认 AI 有幻觉的前提下设计方案

Text2SQL落地难,根源在于忽视“幻觉不可根除”这一事实。过度追求模型准确率,导致方案脱离现实。真正可行的路径是承认幻觉存在,通过“AI做语义转写、规则引擎生成查询、人机协同校验”的分层架构,将幻觉限制在可感知、可修正的前端,实现错误可见、可控、可修复。润乾NLQ实践表明:与幻觉共存,而非消灭它,才是企业级落地的关键。

Raqsoft 103

智能问数Text2SQL终于能做到工业级落地

大模型不直接写 SQL,只把问题翻译成“规范文本”,规则引擎再编译成 100% 准确的 SQL。真正烧钱的是后面的调优、修 bug、喂数据、养团队。Text2SQL 火了三年,就卷一个东西——准确率。85%、90%、95%,数字越来越好看。期望太高——又要聊天自然,又要多轮深挖,又要 AI 自己出结论。普通服务器,普通团队,照跑。润乾 NLQ,让智能问数从概念变成每个企业都装得起的工具箱。金融敢用了,医疗敢用了。所以十个智能问数项目,九个半都是一地鸡毛。润乾 NLQ,不卷准确率,卷确定性。

Raqsoft 150

病人手术后 6 月内咨询标记

"手术后 6 个月内有没有咨询过" 要靠拼接功能把咨询记录挂到手术记录上,挂的条件就是 "咨询日期不早于手术日期,且不晚于手术日期加 6 个月",这是一个跨表的区间条件,正好用得上拼接功能的非等值条件参数。条件是跨表的区间判断,写在条件参数里:带 @ 的 dt@ 是基准表(手术)的日期,不带 @ 的 dt 是关联表(咨询)的日期,整个条件读作 "咨询日期不早于手术日期,且不晚于手术日期往后 6 个月"。两份记录后面要分别用于不同的计算:手术记录当拼接的基准表,咨询记录当被挂上去的关联表。

Raqsoft 180

TRAE + SQLazy MCP 自动化编写 SQL 实践

回到开头的问题:学 SQL 到底难在哪?难在它要求你先把业务想法翻译成机器的叙述方式——join 的顺序、子查询的嵌套、窗口帧的定义,都是翻译过程里的损耗和出错点。SQLazy 把这层翻译工作接了过来:你用业务语言描述计算过程,它负责编译成标准 SQL 在数据库执行。而 TRAE + SQLazy MCP 又把写这一步也接了过去:你说需求,AI 生成 SQLazy 脚本、自动造测试数据、自动验证结果,连存量 SQL 都能一键倒译回来。三层简化叠加之后,做一次数据查询的路径变成了:打开TRAE →。

Raqsoft 200

一个 POC 搞 20 题?我写你麻辣鸽……祭出豆包撸 SPL,单机 20 倍干翻 MPP

MPPSPL硬件3节点,288核,1.8T内存,SSD单台虚拟机,16核,64G内存20 个校验总耗时17,450 秒(4.8 小时)624 秒(10 分钟)倍数快 27.9 倍288C1.8T 对 16C64G,4.8 小时对 10 分钟,SPL又一次完胜!(为什么要说“又”?这事前前后后也搞了两周多点,不过一多半时间都花在和客户沟通如何造出合理的测试数据,写 SPL 再调性能的时间也就三五天,这在以前是没法想的,豆包算是立了大功!

Raqsoft 144

股票最长连续上涨区间的起始日期和结束日期

因为上一步已经把记录限定在最长的那一段(或并列的几段)里,所以这里算出来的就是最长连续上涨区间的起始日期和结束日期。生成的组号写入新列 NoRisingDays,同一段内的记录组号相同,组号相同的一批记录就是一段连续的上涨行情。整个计算被拆成取数、排序、分段、计数、取最长、汇总六步,每一步都是一张可以直接查看的中间结果表:第 3 步之后能看到区间号,第 4 步之后能看到每段几天,最长的那一段是哪一段一目了然,不需要把整条 SQL 跑完再去猜中间算错了没有。比较用的是符号“=”,不是 SQL 里的“==”。

Raqsoft 205

调试 SQL 该像调试代码一样

写代码的人这时候会打开调试器,打断点,单步走,每个变量走到哪一步、变成多少,全看得一清二楚。这和调试 Python、Java 时用的单步是一个东西——区别只在于 SQLazy 的代码结构更简单,没有分支和循环以及子程序,所以用不着断点、step in、step out 那一套,每句代码本身就是一步。要求:按生产线分组,组内按时间排序后,找出编号等于指定字符串(比如 spL1ml82N4o)的记录,以及它们前后各 2 条记录,最后按 id 去重。步骤是给人看、给人调的,SQL 是给机器跑的,各管一段。

Raqsoft 175

CodeBuddy+SQLazy MCP,AI 开发可信 SQL 的正确姿势

对每天和 SQL 打交道的开发者、分析师而言,复杂 SQL 开发始终是效率卡点:多层嵌套逻辑靠人脑硬堆,调试靠逐层拆解子查询,祖传 SQL 接手像 “拆弹”,跨库适配纯又是体力重复。用 AI 写?快倒是真快了,但敢不敢信是另一回事了。说不准几时就出点幻觉、想要审计还得费劲读懂,刚才的麻烦事一件也少不了。写得虽快却不敢直接上生产。,既保留 AI 的效率优势,又守住工程化的可靠底线,让复杂 SQL 编写和审计成本直降 90%。

Raqsoft 176

N 位开发者测完这个无幻觉 SQL 编译器,我们从中学到了什么

SQLazy刚完成后的一段时间,我们把它交给一批开发者,用他们自己的查询来试。反馈整体是正面的,多数人上手就能把工作流跑通,编译出来的 SQL 直接拿去用了。被点名最多的是这几样:生成的 SQL 不瞎编字段、每一步都能点开看、以前不敢动的旧查询也能拿来重做。但痛点也收上来不少,有些还挺扎人。这些痛点不是一回事,我们分了两类看。比如只看重复行、不看唯一行这种取数需求,用去重功能的三个选项可以直接解决;判断一个值属不属于某个集合,用 contain 就行。这一类不用改代码,说清楚就够了。

Raqsoft 111

CodeBuddy+SQLazy MCP 自动化编写和倒译复杂 SQL 实践

** 订单明细 **: 订单 ID(数值), 零件 ID(数值), 供应商 ID(数值), 序号 (数值), 订购数量 (数值), 订购金额 (数值), 折扣率 (数值), 税率 (数值), 退货标记 (字符串), 发货状态 (字符串), 发货日期 (日期时间), 承诺到货日期 (日期时间), 实际到货日期 (日期时间), 发货指示 (字符串), 运输方式 (字符串)尾差由排序第一的国家承担。- ** 零件供应 **: 零件 ID(数值), 供应商 ID(数值), 库存量 (数值), 成本价 (数值)

Raqsoft 149

写SQL,“懒“ 是你这个季度做的最严谨的事

第一次看到 SQLazy 这个名字,不少人心里一合计:SQL 还能 lazy?这工具靠谱吗?我们起这名字时就知道会被问。名字里全是懒,我们天天挂嘴边的却是可审计、零幻觉、合规,听起来自相矛盾。其实懒和严是一件事的两面。

Raqsoft 161

我们造了一个编译器,让你不必再赌 AI 的正确率了

我们造了一个编译器,让你不必再赌 AI 的正确率了。不是因为模型不够准,而是行业一直让它做不该做的事。你有没有遇到过 AI 给的 SQL 能跑、能过检查,上线后才发现边界错了一行,却不报错?

Raqsoft 146

我不再信 AI 生成的 SQL ,我现在信这套做法

为什么我不信任 AI 生成的 SQL 了,不是因为它不通,而是因为它太通——能过语法检查、能执行,却可能在不注意的地方漏洞百出。你有没有遇到过 AI 给的 SQL 通过了语法检查、执行不报错,数据却悄悄错了一行?

Raqsoft 212

SQLazy: 按配对顺序将刷卡进出记录转为单行记录

汇总时用条件聚合:action="IN" 时取 timestamp 的 max 作为 IN 列,action="OUT" 时取 timestamp 的 max 作为 OUT 列。正常情况下同一人同一建筑的记录成对出现, 先 IN 后 OUT;以 user-3/building-1 为例,原始序列为 OUT, IN, IN, IN, OUT, OUT, OUT,按配对规则切为 6 段:首条 OUT 落单,随后两条 IN 各落单,第四条 IN 与首条 OUT 配对成一行,最后两条 OUT 各落单。

Raqsoft 172

SQLazy 是不是你的 dbt 工作流里缺的那一环

dbt控制转换的管道,SQLazy进行分析逻辑的设计。两者不是替代关系,是互补。dbt 负责把分析结果物化、测试、文档化、追踪血缘;SQLazy 负责让你在写那些复杂分析 SQL 之前,先把逻辑想清楚、验证通过。如果你的 dbt model 里有一段超过 30 行的分析 SQL,试试先在 SQLazy 里拆成步骤。

Raqsoft 280

Trae+SQLazy 实践 SQL 国产化移植:Oracle => 达梦

许多国内企业面临将国外数据库迁移到国产数据库的任务,这不仅涉及数据搬迁,更核心的挑战在于大量复杂 SQL 语句的移植。目前业界主要有两种方案:1、目标数据库的兼容模式。许多国产数据库提供了对 Oracle 语法的兼容模拟,可直接运行 Oracle 的 SQL。优点是几乎无需改造、上线快,这对于 SQL 简单的 TP 业务非常适用。

Raqsoft 308

SQLazy: 取 ConfirmationStarted 之前最近的一条 Closed

现在要在每个 ID 内,找到 ConfirmationStarted 之前的所有的 Closed 中,离 ConfirmationStarted 最近的那条记录,取出记录的 ID 和时间字段。ConfirmationStarted 出现在 2022-07-13,此前的三条 Closed 分别发生在 05-28、06-18、06-25,离它最近的一条是 2022-06-25 05:59:01,正是期望结果中的时间。保证每个 ID 内部的记录按时间先后排列,后续分段和取 "最近" 才有依据。

Raqsoft 237

AI+SQLazy:从 SQL 小白到专家的神器

同一句话,每次问 AI,给你的 SQL 还不一样。改一次需求,它又生成一版全新的,之前看的、改的全都白费。AI 给的是成品,中间怎么算的你看不见,只能选择信,或者重来。从小白到专家,差的从来不是背语法,而是一套看得懂、改得动、传得下去的查询逻辑。SQLazy 给你这套逻辑,AI 帮你把话说明白,上手就能写,写着写着就成了专家。一句话能说清的需求,落到 SQL 里就是几十行嵌套,语法还挑剔,小白看一眼就想放弃。什么 CTE 嵌套,窗口函数,都不操心了,无论多复杂,编译器全搞定。同样的逻辑,输出永远一样。

Raqsoft 122

CodeBuddy+SQLazy 盘活历史复杂 SQL 详解

数据库里总有一些历史 SQL,上百行、多层嵌套,写的人早已不在,注释也几乎没有,接手的人要先花不少时间读懂,才谈得上修改。让 AI 直接改也不可靠,它生成的新 SQL 很可能与原 SQL 对不上,重新审一遍的功夫不比重写少。把这类 SQL 翻译成 SQLazy 分步脚本,逻辑就清楚多了:每一步做什么一目了然,能单独运行,中间结果随时可看,哪一步不对就改哪一步,调试和审计都有据可查;脚本本身就是文档,交接、传承直接交脚本。验证通过后还能编译成其他数据库的 SQL,换库只是重新编译一次。

Raqsoft 156
上一篇: 我不再信 AI 生成的 SQL ,我现在信这套做法
下一篇: 我们造了一个编译器,让你不必再赌 AI 的正确率了
润乾软件
润乾软件 企业官方账号 企业官方账号
博客等级 码龄15年 153粉丝 1142原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值