(3)go web开发之 基于雪花算法生成用户ID与自增id,uuid对比

雪花算法 Snowflake 生成分布式自增 ID 详解 文章目录1、雪花算法概述2、雪花算法结构3、雪花算法生成的 ID 性质4、雪花算法的优点5、雪花算法的缺点 1、雪花算法概述 Snowflake 是 twitter 开发的全局唯一 ID 生成服务。 Twitter 的分布式雪花算法 Snowflake,经测试 Snowflake 每秒能够产生 26 万个自增可排序的ID twitter 的 Snowflake 生 成ID能够按照时间有序生成 Snowflake 算法生成 id 的结果是一 个 64bit 大小的整数, 为一个 Long 型(转换成字符串后 阅读详情

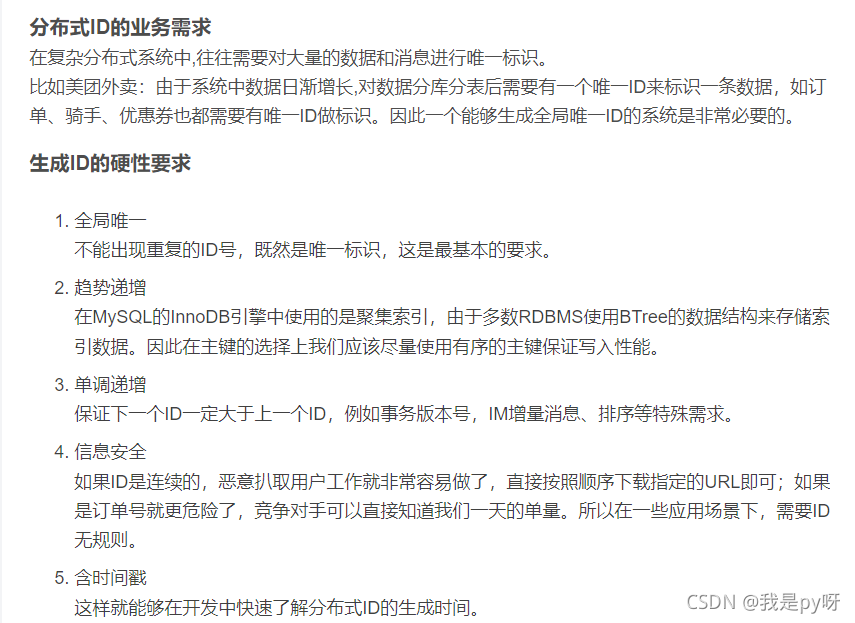
一: 为啥不用自增id作为用户的id?

  • 有两方面的考虑:
    • (1)首先: id长度不一,且太具有顺序性!数据安全性差! 轻易就可以知道自己是该站点第几个注册的用户。并且如果是注册的新用户,还可以知道当前站点已经有多少个注册用户! 这是不太好的,信息安全问题。
    • (2)其次: 数据量庞大,进行分库分表的时候, 不同库中的用户id可能发生重复。假设第一个库已经有 1亿个用户,那为了保证不重复,第二个机器,或者表,只能从大于 一亿的 位置开始。 且,必须要大于1亿很多,因为第一台机器还会继续增长,可能导致增长过程中重复!

二:为啥不使用uuid?

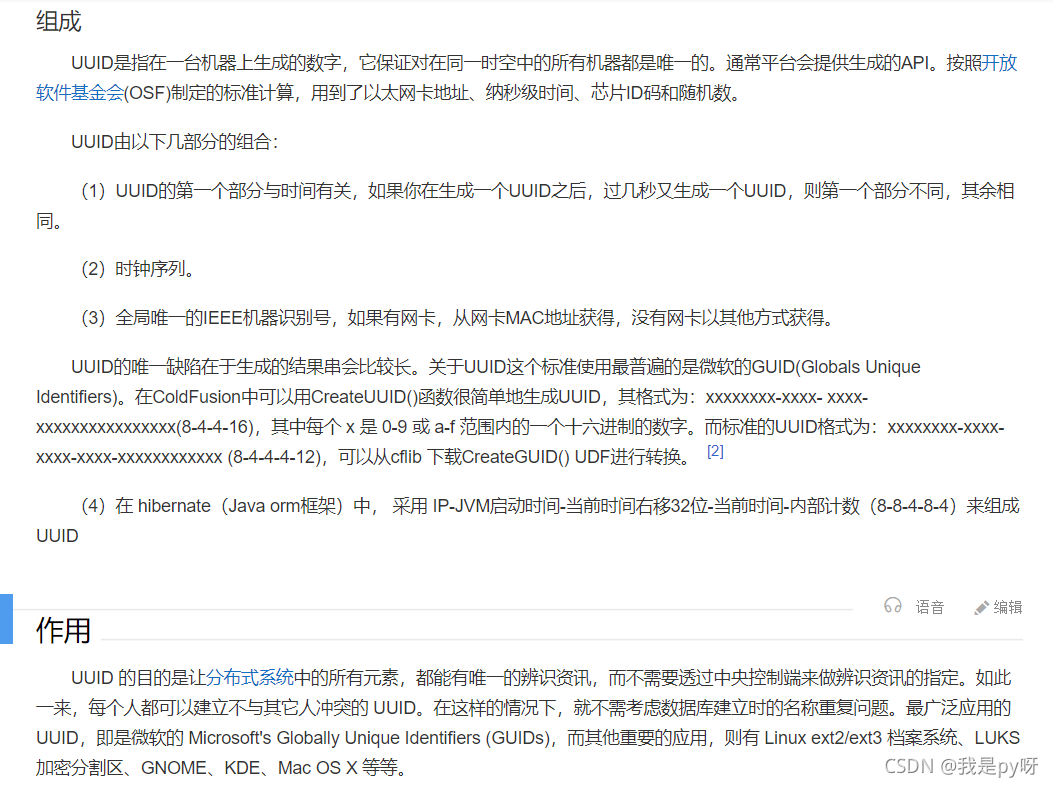
  • 啥是 uuid?来自百度百科的截图。 (我之前写登录时,图形验证码的保存,也用到过 uuid,当做key存储进redis)
    • 目前最广泛应用的UUID,是微软公司的全局唯一标识符(GUID),而其他重要的应用,则有Linux ext2/ext3文件系统、LUKS加密分区、GNOME、KDE、Mac OS X等等棘突
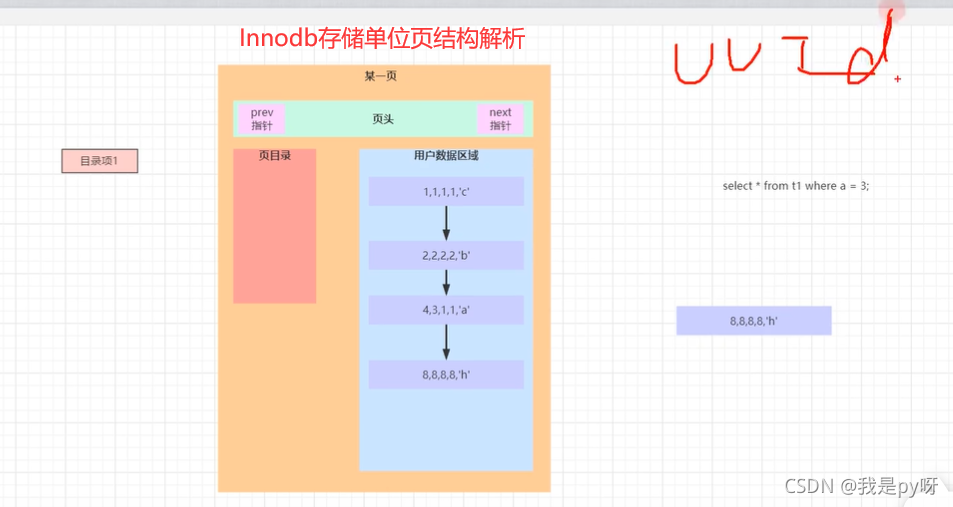
    • uuid 是一长串用 - 分隔的 字符, 图中介绍描述uuid 有 128长, 32字节表示。并且是无序的!这点很关键。 我在B站上看到讲解 B+树和mysql 索引的文章,其中讲到 页结构,和插入数据的过程
      在这里插入图片描述
    • 默认插入数据会以主键作为索引,建立聚簇索引。 在磁盘中将数据读取是按照页(逻辑单位)进行的。 每一页的大小默认是 16KB。因为作为主键的话,内部插入默认排序。 uuid是无序的,导致每次的插入结果不一定,增加时间开销。 如果是自增id,每次都是在后面进行插入了。
    • 每一次UUID数据的插入都会对主键的b+树进行很大的修改,这一点很不好,插入完全无序,不但会导致一些中间节点产生分裂,也会白白创造出很多不饱和的节点,这样大大降低了数据库插入的性能。
      • 顺序的插入,总数能不断达到饱和节点,每个节点存储足够多的关键字。 随意插入还需要判断往哪插入,插入的当前页,可能会造成分裂,改变B+树结构。
      • 插入效率低。

三:雪花算法(snowflake)

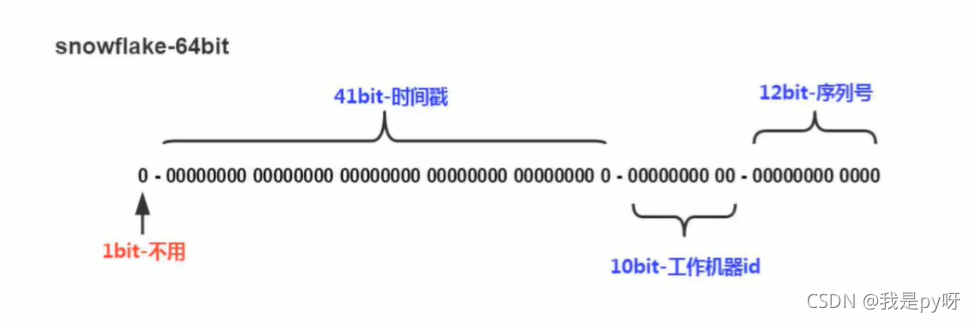
  • 雪花算法是Twitter开源的由64位整数组成的分布式ID,性能较高,并且在单机上递增。
    在这里插入图片描述

    • 全长64位。
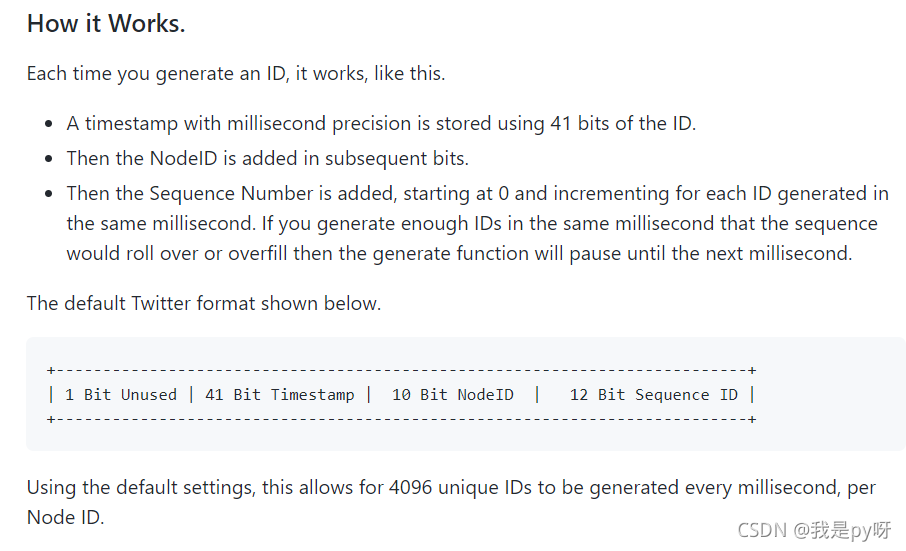
    • 第一部分,是1bit: 0。该段无意义。因为二进制里第一个bit如果是1,那么都是负数,我们生成的id要求都是正数。
    • 第二部分: 时间戳,单位为毫秒,总共可以容纳约69年。这个时间戳不是从1970年开始记起的,因为那样只能用到 2039年。 可以 以项目上线的时间为起点,开始计算。
    • 第三部分:5bit表示机房id,剩下5bit表示机器id。一共10位,就是最多容纳 1024个机器。
    • 第五部分表示序号:某个机房,某个机器这一毫秒内同时生成的id的序号。一共12位,那么就是一共可以生成 4096个一毫秒。
    • 总计 :同一毫秒的ID数量:1024 x 4096 = 3194304个。完完全全滴够用了。
  • go语言实现的 雪花算法,已经有开源的了,300多行代码:https://github.com/bwmarrin/snowflake/blob/master/snowflake.go这个实现的是和上述描述的基本一致。官方文档截图:
    在这里插入图片描述

  • 给出链接,讲解java版本的 雪花算法实现源码分析(代码都不长,200行左右):https://www.bilibili.com/video/BV1tr4y1C7gi?spm_id_from=333.999.0.0

  • 他们的原理都是类似的。通过很多 位运算操作,拼凑出来 ID。 需要注意的点:

    • 要注意ID值一毫秒内的数量, 当生成数量大于 一毫秒的最大值时,需要等待到下一毫秒。
    • 当前的时间 与上一次获取id相同时,说明是在统一毫秒, 序列(step)递增
    • 当小于时,返回错误, 当大于上次时间时,说明不在统一毫秒,更新 序列为 0,表示这一毫秒内重新开始计数。
  • go项目中使用:参照文档, 代码除了解析功能外。也就100多行。每一步都有注释。 初始化一个 node节点对象,然后调用生成相应的ID就可以了,可以是 int64,string等等类型的结果。

    package sonwflake
    // 这个模块封装了 雪花算法生成相应用户ID的方法。
    import (
    	"github.com/bwmarrin/snowflake"
    	"time"
    )
    
    
    // 定义一个节点: 通过这个全局的 node,就可以用于制造 ID了。
    var node *snowflake.Node
    
    // 源码里有很多默认的基本设定,比如开始时间等等, 我们可以改变这些,自己初始化一个 node节点
    func Init(startTime string, machineID int64) (err error) {
    	var st time.Time
    	st, err = time.Parse("2006-01-02", startTime)
    	if err != nil {
    		return
    	}
    	// 设置时间
    	snowflake.Epoch = st.UnixNano() / 1000000
    	node, err = snowflake.NewNode(machineID)
    	return
    }
    
    // 返回int64位的 id值
    func GenID() int64 {
    	return node.Generate().Int64()
    }
    
  • 文档中给出的使用:

    package main
    
    import (
    	"fmt"
    
    	"github.com/bwmarrin/snowflake"
    )
    
    func main() {
    
    	// Create a new Node with a Node number of 1
    	// 生成一个节点
    	node, err := snowflake.NewNode(1)
    	if err != nil 
    		fmt.Println(err)
    		return
    	}
    
    	// Generate a snowflake ID.
    	// type ID int64 这是id的类型,下面定义了很多方法, 获取Base64呀,或者是打印它的时间戳等
    	id := node.Generate()
    
    	// Print out the ID in a few different ways.
    	fmt.Printf("Int64  ID: %d\n", id)
    	fmt.Printf("String ID: %s\n", id)
    	fmt.Printf("Base2  ID: %s\n", id.Base2())
    	fmt.Printf("Base64 ID: %s\n", id.Base64())
    
    	// Print out the ID's timestamp
    	fmt.Printf("ID Time  : %d\n", id.Time())
    
    	// Print out the ID's node number
    	fmt.Printf("ID Node  : %d\n", id.Node())
    
    	// Print out the ID's sequence number
    	fmt.Printf("ID Step  : %d\n", id.Step())
    
      // Generate and print, all in one.
      fmt.Printf("ID       : %d\n", node.Generate().Int64())
    }

    
唯一ID:雪花算法介绍与 Go 语言实现 snowflake 雪花算法可以在不依赖数据库的情况下,生成全局唯一的ID。 阅读详情

相关推荐

深信服Go开发岗笔试考点解析:并发编程、内存管理与系统底层全覆盖

并发编程是Go语言的核心能力,GMP调度模型与channel通信机制决定了高并发系统的稳定上限。在实际工程中,goroutine泄漏与内存滥用常导致go语言中很可能会导致oom,而带过期时间的LRU缓存则是控制内存增长的有效手段。从网络IO的epoll模型到分布式存储的多副本机制,后端技术栈的深度决定系统的性能边界。面向安全与云计算厂商的Go开发岗位,不仅考察语法细节,更侧重对TCP状态机、超融合架构、Linux性能工具的工程理解。本文以深信服秋招笔试为案例,梳理从基础题到编程题的完整备考路径,帮助开发者建

weixin_30437847的博客 334

雪花ID(Go 实现)

雪花ID的实现 之前做项目的时候遇到,今天再深入理解一下。 文章目录雪花ID的实现前言一、雪花ID的作用?二、雪花ID的原理三、雪花ID的代码实现(Go 语言)四、雪花ID 的缺点 前言 雪花ID 最由推特开源的一种全局唯一ID 的生成算法,有递增、全局唯一等特性。 一、雪花ID的作用? 全局的唯一性 对于多台机器,毫秒级生成多条不重复ID 递增性 生成的雪花ID具有递增型,可以加速查询。 可用性高 支持多线程,分布式的系统架构 二、雪花ID的原理 最高位是符号位,生成的ID总是正数,

qq_52785898的博客 2094

随机小姐姐API源码解析:从高并发架构到短视频引流实战

在当今的互联网应用中,API(应用程序编程接口)作为系统间通信和数据交换的核心枢纽,其设计与实现直接关系到服务的性能、稳定性和扩展性。其基本原理是通过预定义的协议和格式,为客户端提供标准化的数据访问能力。从技术价值看,一个设计良好的API不仅能高效处理海量请求,还能通过智能分发、缓存策略和风控机制保障服务质量和安全。在短视频引流、社群运营和内容素材管理等应用场景中,这类API常作为“内容弹药库”,实现低成本、批量化的视觉内容供给。本文以热门的“随机小姐姐API”项目为例,深入剖析其在高并发处理、数据库优化和

weixin_34356555的博客 419

go实现雪花算法

雪花算法的go实现

qq_42170897的博客 1871

Go语言实现雪花算法(Snowflake Algorithm),该算法用于生成唯一的64位ID,这些ID在分布式系统中保持唯一性和时间顺序性。

雪花算法是由Twitter开发的,用于生成64位的唯一ID。时间戳:41位,表示自某个特定时间点(通常是1970年1月1日)以来的毫秒数。数据中心ID:5位,用于区分不同的数据中心。工作节点ID:5位,用于区分数据中心内的不同节点。序列号:12位,同一毫秒内的序列号,确保同一毫秒内的ID唯一。

靡不有初,鲜克有终 634

Java Spring Boot跨境电商平台架构设计与核心模块实现详解

企业级应用开发中,Java与Spring Boot生态因其强类型、严谨的工程化体系和丰富的中间件支持,成为构建高稳定、可扩展系统的常见选择。其核心原理在于通过分层架构(如表现层、业务逻辑层、数据访问层)解耦系统,并整合Redis、RabbitMQ等中间件来提升性能与可靠性。这种技术组合的价值在于能够高效处理复杂业务逻辑,保障事务一致性,尤其适用于电商等高并发场景。在跨境电商平台的具体实践中,技术选型需综合考虑团队技术栈、生态成熟度及长期维护需求。本文以ECO项目为例,深入剖析了基于Spring Boot的B

weixin_30530339的博客 420

【愚公系列】2023年10月 .NET CORE工具案例-DeveloperSharp(分布式唯一Id)

分布式唯一ID(Distributed Unique ID,简称DUID)是指在分布式系统中,为了避免ID冲突而使用的一种ID生成方式。在分布式系统中,多个节点同时生成ID,如果采用单机自增序列的方式,容易造成ID重复的问题。为了解决这个问题,产生了DUID的概念。常见的DUID生成方式有:UUID:通用唯一识别码,是一种由网络软件使用的标准,用于标识信息的唯一性。UUID是根据时间戳、硬件设备等多个因素生成的,因此非常难以重复。

愚公智库 5万+

Windows 10/11 安装 HYSPLIT 气象模型全攻略(附必备工具包下载清单)

本文提供了一份详尽的Windows 10/11系统下HYSPLIT气象模型安装与配置全攻略。指南涵盖了从核心认知、必备工具包(Tcl/Tk、ImageMagick)下载,到分步安装、环境变量设置及首次运行验证的完整流程,旨在帮助研究者和学生高效部署这一用于大气轨迹模拟与污染物扩散分析的专业工具。

weixin_28335283的博客 607

《黑马点评》项目学习5:自媒体文章审核(阿里云内容审核api、feign远程调用与服务降级、雪花算法)

文章上传之后要发布到app给用户看,需要经过文章审核,包括文本审核与图片审核。该部分内容实现会学到的技术有:第三方内容安全审核接口、分布式主键、异步调用、feign远程接口和熔断降级。审核方式:1.自动审核文章发布之后,系统自动审核,主要通过第三方接口对文章内容进行审核(成功、失败、不确定)2.人工审核自动审核返回不确定时,转人工审核,由管理员审核。

kukuyt的博客 1236

图像处理(12)--图像各种噪声及消除方法

文章目录结构1.什么是图像噪声2. 图像噪声来源3. 噪声分类及其消除方法3.1 高斯噪声及其消除方式3.1.1 如何确定一种噪声是高斯噪声3.1.2 高斯滤波消除高斯噪声3.1.3 高斯函数的重要性质3.2 瑞利噪声及其消除方式3.3 伽马(爱尔兰)噪声及其消除方式3.4 指数分布噪声及其消除方式3.5 均匀噪声及其消除方式3.6 脉冲(椒盐)噪声及其消除方式 1.什么是图像噪声 图像噪声是指...

ShaneHolmes 11万+

UE5入门第二周总结:基于蓝图的国际象棋的实现

在C++的学习中,这是一个入门级别的项目。我们的目标是灵活运用蓝图的特性和强大的可视化功能,做出这一入门级项目的同时,思考如何优化并改进算法,并尽可能的用面向对象的方法实现,用蓝图中的继承和多态简化编码过程。

YoungeYang的博客 1259

【朝夕教育】2023年10月 .NET CORE工具案例-DeveloperSharp(分布式唯一Id)

分布式唯一ID(Distributed Unique ID,简称DUID)是指在分布式系统中,为了避免ID冲突而使用的一种ID生成方式。在分布式系统中,多个节点同时生成ID,如果采用单机自增序列的方式,容易造成ID重复的问题。为了解决这个问题,产生了DUID的概念。常见的DUID生成方式有:UUID:通用唯一识别码,是一种由网络软件使用的标准,用于标识信息的唯一性。UUID是根据时间戳、硬件设备等多个因素生成的,因此非常难以重复。

微软MVP Eleven 548

CentOS7无网环境实战:MySQL8.0完整离线安装与避坑指南(附依赖包下载)

本文详细介绍了在CentOS7无网环境下MySQL8.0的完整离线安装流程,包括依赖包获取、系统预处理、MySQL二进制安装、服务配置与优化等关键步骤。特别针对离线安装的特殊需求,提供了从依赖包下载到服务调优的全链路解决方案,帮助用户在企业内网或隔离环境中高效部署MySQL数据库。

bush的博客 172

为什么你的Dify系统总被攻击?可能输在附件ID验证这一步

解决Dify系统安全漏洞,关键在于强化附件ID验证机制。本文详解Dify附件ID验证的常见风险与防护策略,涵盖API接口防护、权限校验逻辑及实际应用场景,提升系统抗攻击能力。方法实用,值得收藏。

LearnPlex的博客 734

网格聚类 Grid Clustering/Grid-based Clustering

本文主要简单介绍了网格聚类的基本概念,优缺点,应用场景,建模时的注意事项,评价指标,实现方法,python示例和模型参数等。

JasonH2021的博客 4827

40、5G NR射频要求解析

本文详细解析了5G NR射频相关要求,包括参考灵敏度与动态范围的定义、接收机对干扰信号的抗扰性要求(如阻塞、邻道选择性等)、辐射射频要求在FR1和FR2频段的差异,以及多标准无线电基站(MSR)的发展及其对射频要求的影响。内容涵盖测试模型、干扰场景、具体指标和实现挑战,为理解和应用5G NR射频规范提供了全面指导。

qsc901234的博客 245

分布式(三)

分布式(三)

folyh 800

[STC32G144K246入门第一步]点亮LED

STC32G144K246是一款高性能32位8051单片机,集成了丰富外设资源,适用于工业控制和复杂算法处理。该芯片支持双模式内核,内置硬件加速器,提供246KB Flash和144KB SRAM存储空间。文章详细介绍了开发环境搭建步骤、寄存器配置方法,并给出了LED驱动示例代码,通过推挽输出控制P42口实现闪烁效果。虽然开发环境相比ARM存在不足,但通过合理配置仍可满足项目需求。该教程为开发者快速上手STC32G144K246提供了实用参考。

sinat_58149788的博客 795

基于Web页面的常用工具集

《攻城师天梯:一站式开发者工具平台》介绍了一个基于Web的多功能工具集合,采用Golang+Vue3技术栈实现单文件部署。该平台提供11大类27个实用工具,包括API调试、AI对话、编解码、加密生成、数据处理等开发常用功能。项目使用高性能fasthttp框架和SQLite嵌入式数据库,支持一键编译部署,无需额外依赖。特色功能涵盖云平台API对接、文档格式转换、网络探测等,通过模块化设计实现高效开发。开源地址:https://github.com/llzc-art/tools

coder成长之路 418

Python爬取小红书种草商品评论数据:从入门到实战全攻略(附反爬+情感分析方案)

Python爬取小红书种草商品评论数据,核心是“抓包找到正确的接口+处理登录验证+合理的反爬策略”。新手不用一开始就追求多笔记批量爬取和情感分析,先把单笔记的评论抓取和存储跑通,再逐步扩展功能。我做的这个系统现在每天帮朋友爬取3-5款美妆产品的评论,自动做情感分析和关键词提取,她再也不用手动翻评论了,效率提升了80%。如果你们在开发中遇到具体问题,比如接口找不到、Cookie过期、IP被封,都可以在评论区留言,我会一一解答。后续也可以出一期小红书笔记种草数据爬取的教程,帮助大家更全面地分析竞品数据。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1346

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

【稀缺技术揭秘】:PHP连接中间件实现自动分库分表的3种高级模式

掌握PHP数据库分库分表适配难题?本文揭秘3种基于中间件的自动分库分表高级模式,适用于高并发、大数据量场景,提升系统扩展性与查询性能。支持动态路由与无缝迁移,方案稳定高效,值得收藏。

InitPulse的博客 1065

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Web相关工具和框架

如下所示,我们的服务首先向Dubbo的注册中心进行注册(发送服务的IP、端口、接口方法),消费者向注册中心订阅服务(发送所求的服务信息)以发现服务,注册中心根据消费者所求服务信息匹配对应的提供者列表给消费者,然后消费者从服务提供者地址列表中,基于软负载均衡算法选一台服务提供者进行调用。Dubbo:A服务能提供3种服务功能(接口),B服务能提供4种服务功能,C服务能提供5种服务功能,A服务也许需要使用B服务的功能,B服务需要使用C服务的功能,那让我们组合一波服务搞点事情吧。

milanleon的专栏 433

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

如何让Python程序自动续传大模型API请求?99%的人都忽略了这3个细节

掌握Python大模型API断点续传技巧,解决长请求中断重试难题。适用于大模型推理、批量数据处理场景,通过请求缓存、进度记录与异常重试机制实现高效续传。提升稳定性与效率,避免重复调用成本,值得收藏。

SimProceed的博客 312

snarkjs深度解析:零知识证明的JavaScript实现架构与实战指南

在区块链和隐私计算领域,**零知识证明**(Zero-Knowledge Proof)正成为构建可信系统的核心技术。而snarkjs作为JavaScript和WebAssembly实现的zkSNARK库,为开发者提供了在浏览器和Node.js环境中构建零知识证明应用的完整工具链。本文将深入探索snarkjs的架构设计、核心特性,并通过实战案例展示其在现代隐私计算应用中的价值。 ## 🔍 核心理

gitblog_00915的博客 1067

百川2-13B-Chat WebUI v1.0 应用场景:技术面试题生成、API接口设计、数据库建模实战

本文介绍了如何在星图GPU平台上自动化部署百川2-13B-对话模型-4bits量化版 WebUI v1.0镜像,并展示了其核心应用场景。该平台能帮助开发者快速搭建AI助手环境,用于高效生成技术面试题、设计API接口与数据库模型,从而显著提升开发与学习效率。

weixin_36304957的博客 983

软件开发中的长度问题:从数据库到网络的全链路处理实践

在软件工程中,数据长度是一个贯穿存储、传输与处理的核心基础概念。其原理涉及字符编码、内存管理、协议规范等多个层面,直接关系到系统的健壮性与数据一致性。从技术价值看,合理的长度约束能有效预防缓冲区溢出、数据截断等常见错误,提升系统安全性和稳定性。应用场景广泛覆盖数据库字段设计、API接口校验、文件路径处理以及网络传输优化。本文将结合数据库VARCHAR类型、HTTP请求体大小等热词,深入探讨如何在工程实践中系统化地管理数据长度,构建从设计、开发到运维的完整防御链条。

weixin_34234829的博客 347
上一篇: (2)go web开发之 使用viper读取配置文件
下一篇: 红黑树的应用与力扣456号算法题132模式详解,go语言解题
我是py呀
博客等级 码龄8年 205粉丝 130原创
评论 4
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值