《Py机器学习》-广义线性模型

全面概述:啥是广义线性模型 (GLM)? 广义线性模型 (GLM) 是一个强大的统计框架,它扩展了经典线性回归模型以处理各种数据类型和分布。1970 年代,统计学家 John Nelder 和 Robert Wedderburn 引入了 GLM,已成为从流行病学和金融学到生态学和社会科学等领域不可或缺的工具。本文全面概述了 GLM,探讨了它们的基本概念、关键组件和实际应用。 阅读详情

目录

        一. 本章使用的函数说明

        二. 四种线性模型

                1.最最基本线性模型

        2.线性回归模型

        3.岭回归

        4.套索回归

三. 模型的选择

一. 本章使用的函数说明

reshape( x )

 1.当原始数组A[4,6]为二维数组,代表4行6列。 A.reshape(-1,8):表示将数组转换成8列的数组,具体多少行我们不知道,所以参数设为-1。用我们的数学可以计算出是3行8列

2.当原始数组A[4,6]为二维数组,代表4行6列。 A.reshape(3,-1):表示将数组转换成3行的数组,具体多少列我们不知道,所以参数设为-1。用我们的数学可以计算出是3行8列

make_regression (n_samples=100, n_features=100, n_informative=10, n_targets=1, bias=0.0, effective_rank=None, tail_strength=0.5, noise=0.0, shuffle=True, coef=False, random_state=None)

用于生成随机样本

n_samples:样本数
n_features:特征数(自变量个数)
n_informative:参与建模特征数
n_targets:因变量个数
noise:噪音
bias:偏差(截距)
coef:是否输出coef标识
random_state:随机状态若为固定值则每次产生的数据都一样

train_test_split( train_data , train_target , test_size=0.4 ,  random_state=0 , stratify=y_train )

用于将数据分割成样本集和测试集

train_data:所要划分的样本特征集

train_target:所要划分的样本结果

test_size:样本占比,如果是整数的话就是样本的数量

random_state:是随机数的种子。

stratify是为了保持split前类的分布。比如有100个数据,80个属于A类,20个属于B类。如果train_test_split(... test_size=0.25, stratify = y_all), 那么split之后数据如下: 
training: 75个数据,其中60个属于A类,15个属于B类。 
testing: 25个数据,其中20个属于A类,5个属于B类。 

用了stratify参数,training集和testing集的类的比例是 A:B= 4:1,等同于split前的比例(80:20)。通常在这种类分布不平衡的情况下会用到stratify。

将stratify=X就是按照X中的比例分配 

将stratify=y就是按照y中的比例分配 

LinearRegression().fit( x,y )

用线性模型LinearRegression来拟合fit(输入,输出)。同理,将模型名称变成别的模型也是拟合

LinearRegression().fit().predict()

LinearRegression().fit().coef_

计算线性的直线系数w(模型的斜率k)。一个NumPy数组,数据中有几个特征值就对应几个数。.coef_[i] 表示数组中的第i个特征系数

LinearRegression().fit().intercept_

计算线性的截距b。一个浮点数

二. 四种线性模型

1.最最基本线性模型

        原理:直线会位于距离所有点距离最小的位置

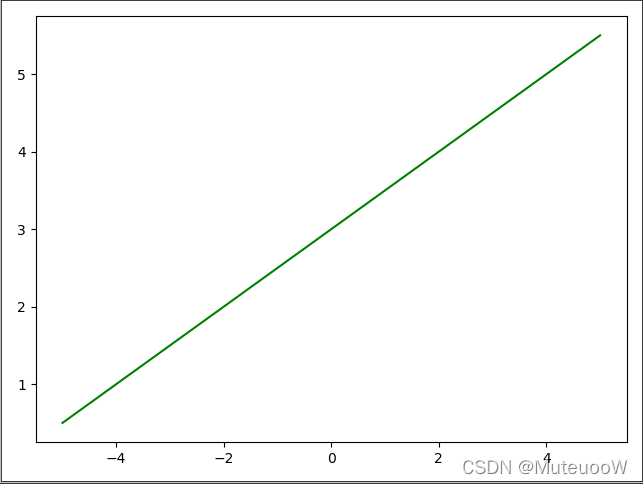
        利用生成的数字

#添加插件部分
import numpy as np
import matplotlib.pyplot as plt
#数据部分
x = np.linspace(-5,5,100) #在-5到5之间生成100个等差数字
y = 0.5*x+3
#画图部分
plt.plot(x,y,c='green')
plt.show()
          再用给定两点的predict拟合

import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression # 线性回归模型
#数据输入,x用[]括起来表示只有一个输入
x = [[1],[2]]
y = [5,3]
#创建一个线性模型LinearRegression,用这个线性模型拟合x,y  fit(x,y)
lr = LinearRegression().fit(x,y)
#定制图表的x上下界,和跨度(形成网格)
z = np.linspace(0,5,20)
#画图
plt.scatter(x,y,s=80)
plt.plot(z,lr.predict(z.reshape(-1,1)),c = 'k') #
plt.show()
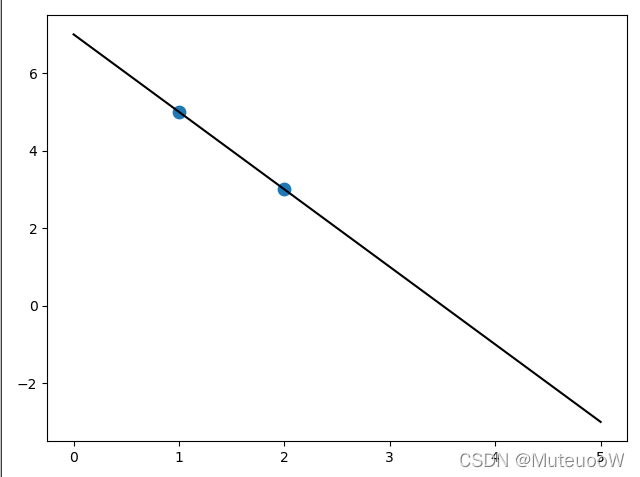
        【注】在新版skelearn函数里,所有数据都应该是二维矩阵,哪怕它只是单独一行或一列,需要使用.reshape(1,-1)进行转换

        求取该直线的一些信息

        确定通过上述两点的直线方程:

print('y = {:.3f}'.format(lr.coef_[0]),'x','+{:.3f}'.format(lr.intercept_)) 

        求K和截距

print('直线的系数(k)值:{:.2f}'.format(lr.coef_[0]))
print('直线的截距:{:.2f}'.format(lr.intercept_))

      【注】.nf代表显示小数点后n位

2.线性回归模型

          普通最小二乘法模型(OLS)

          原理:找到训练集中y的预测值和其真实值的平方差最小的时候,所对应的w和b

from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression

X,y = make_regression(n_samples = 100,n_features = 2,n_informative = 2,random_state = 39)

X_train,X_test,y_train,y_test = train_test_split(X,y,random_state=10)

lr = LinearRegression().fit(X_train,y_train)

print(lr.coef_)
print(lr.score(X_test,y_test))

          真实数据集再测试,导入糖尿病数据集:

from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.datasets import load_diabetes     #导入糖尿病数据集


X,y = load_diabetes().data,load_diabetes().target  #这里也不一样

X_train,X_test,y_train,y_test = train_test_split(X,y,random_state=10)

lr = LinearRegression().fit(X_train,y_train)

print(lr.coef_)
print(lr.score(X_test,y_test))

        当出现训练数据集和测试数据集得分相差很多,或测试数据得分超过训练数据时,考虑出现了过拟合现象,应采用岭回归

3.岭回归

        一种改良的最小二乘法,线性回归的进阶版,L2正则法在线性模型中的应用

        L2正则法:保留全部变量,通过降低特征变量的系数来避免过拟合的方法

        岭回归原理:保留所有的特征变量。但是会减小特征变量的系数值。使得特征变量对结果的影响变小。岭回归中是通过改变alpha参数来控制减小特征变量系数的程度。岭回归是一个在[模型的简单性]和[训练集上的性能]取得平衡的一个模型,通过alpha参数可以调节二者间的倾向。alpha参数默认为1。alpha参数越高,特征变量系数越低,在训练集上的性能越低,泛化程度越高,过拟合程度越低。alpha参数越接近于0(例如0.1),会导致模型越趋近于线性回归。

        特殊作用:可以避免过拟合。如果我们希望模型的泛化能力更好,那么应该考虑岭回归模型,而非线性回归

        泛化:

        函数调用:

from sklearn.linear_model import Ridge

        用岭回归重新测试同一个糖尿病数据集:

from sklearn.model_selection import train_test_split
from sklearn.linear_model import Ridge
from sklearn.datasets import load_diabetes     #导入糖尿病数据集


X,y = load_diabetes().data,load_diabetes().target

X_train,X_test,y_train,y_test = train_test_split(X,y,random_state=10)

lr = Ridge().fit(X_train,y_train)  #换成岭回归函数

print(lr.coef_)
print(lr.score(X_test,y_test))

这次相差的就很小了
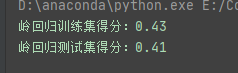
 调节alpha参数(影响训练集和测试集得分)

#alpha参数设为5
lr = Ridge(alpha=5).fit(X_train,y_train)

        当数据量小于50时,线性回归几乎没有用;如果数据量足够多(>300),岭回归与线性回归的学习效果相差无几

4.套索回归

        应用L1正则化进行回归的模型

        套索回归原理:在使用套索回归的时候,会将某些特征参数等于0,彻底被模型忽略,从而凸显出模型中的重要特征。可以视为模型自主选择的结果。

        用法:通过调节alpha参数和最大迭代次数max_iter参数,来提高纳入考虑的特征值数量,以及模型得分。其中,alpha参数默认为1,越接近0,模型越复杂,得分越高;但是如果alpha太小,太接近0,则会回到线性回归,出现过拟合现象。并非复杂程度越高,模型质量越好

        函数调用:

from sklearn.linear_model import Lasso

        再使用套索回归一下糖尿病模型

import numpy as np  #引入个np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import Lasso  #导入Lasso套索回归
from sklearn.datasets import load_diabetes     #导入糖尿病数据集


X,y = load_diabetes().data,load_diabetes().target
X_train,X_test,y_train,y_test = train_test_split(X,y,random_state=10)
lr = Lasso().fit(X_train,y_train)  #应用Lasso

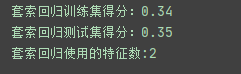
print("套索回归训练集得分:{:.2f}".format(lr.score(X_train,y_train)))
print("套索回归测试集得分:{:.2f}".format(lr.score(X_test,y_test)))
#用于检测套索回归使用了几个特征值
print("套索回归使用的特征数:{}".format(np.sum(lr.coef_ != 0)))

         拟合结果不理想,10个特征值只用了2个,说明发生欠拟合。

         降低alpha的值,并且增加最大迭代次数,来降低欠拟合程度:

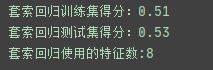
lr = Lasso(alpha=0.1 , max_iter=100000 ).fit(X_train,y_train)

        发现特征数变多了,并且得分明显提高,nice。

         但是注意此处出现了过拟合现象

三. 模型的选择

        岭回归(L2正则化)的应用场景:

                1. 数据的特征向量不多,而且每一个都比较重要

                2. 往往是优选

        套索回归(L1正则化)的应用场景:

                1.有很多种特征,并且有一些特征很不必要

                2. 需要对模型进行解释(更少的特征会方便解释,容易理解)

广义线性模型(GLM)在Python中的实现 广义线性模型(GLM)是一种统计模型,它通过将线性回归模型与适当的链接函数结合起来,用于建立因变量与自变量之间的关系。通过以上步骤,我们成功实现了广义线性模型(GLM)在Python中的应用。GLM提供了一种强大的工具来处理各种类型的响应变量,并建立与自变量之间的关系。在实际应用中,根据问题的特点选择合适的链接函数和模型家族非常重要,以获得最佳的预测性能。假设我们的数据集保存在一个名为"dataset.csv"的文件中,其中包含两列,分别是考试成绩(自变量)和是否录取(因变量)。 阅读详情

相关推荐

探究广义线性模型的Python实现

从结果摘要中可以看出,x1和x2的系数都是正的,并且P值非常小,这意味着它们对响应变量y有显著的影响。此外,模型的对数似然值为-1416.4,这意味着我们的GLM模型与数据的拟合效果非常好。广义线性模型(GLM)是一种常用的统计模型,用于建立连续响应变量与一个或多个解释变量之间的关系。在本文中,我们将探讨如何使用Python实现广义线性模型,并通过一个具体案例进行演示。接下来,我们将使用一个虚拟数据集来演示如何建立广义线性模型。在这个例子中,我们将选择一个正态分布的响应变量和一个恒定方差的误差项。

2301_78484069的博客 454

深入浅出Python机器学习4——广义线性模型

线性模型是一类广泛应用于机器学习领域的预测模型,是使用输入数据集的特征的线性函数进行建模,并对结果进行预测的方法。

繁华落尽心殇 3779

Transformer凭什么取代RNN?深入拆解自注意力机制与梯度消失问题的终极对决

本文深入探讨了Transformer如何通过自注意力机制解决RNN的梯度消失问题,成为自然语言处理领域的新标准。通过对比RNN和Transformer的架构差异,揭示了自注意力机制在并行计算、长期依赖处理等方面的技术优势,并提供了实际任务中的性能对比数据。

f6g7h8i9j的博客 190

广义线性模型

今天我来介绍一种在机器学习中应用的比较多的模型,叫做广义线性模型(GLM)。这种模型是把自变量的线性预测 函数当作因变量的估计值。在机器学习中,有很多模型都是基于广义线性模型的,比如传统的线性回归模型,最大熵 模型,Logistic回归,softmax回归,等等。今天主要来学习如何来针对某类型的分布建立相应的广义线性模型。   Contents      1. 广义线性模型的认识

ACdreamer 4万+

VS code平台调试AutoLISP程序教程

VS code平台调试AutoLISP程序教程

BearElder的博客 3183

QT使用高精度定时器

精度相对第二种方法高许多。

ljjjjjjjjjjj的博客 4097

推荐使用:Py-GLM - Python中的广义线性模型库

推荐使用:Py-GLM - Python中的广义线性模型库 在数据科学和机器学习领域中,广义线性模型(GLMs)是一种强大的工具,可以处理各种非线性和非正态分布的响应变量。今天,我们向您推荐一款名为py-glm的Python库,它为GLMs提供了全面而灵活的实现。 1、项目介绍 py-glm是专为Python设计的一个开源库,用于拟合、检查和评估广义线性模型。这个库支持从多种指数族中选择的模型,包...

gitblog_00046的博客 593

ESP8266红外控制美的空调:从协议解析到Home Assistant集成

红外遥控技术作为一种经典的非接触式控制方式,其原理是通过红外发光二极管发射经过特定频率调制的光信号来传递指令。在物联网和智能家居领域,利用微控制器如ESP8266模拟红外信号,成为将传统家电接入智能生态系统的关键技术。这项技术通过精准解析和生成符合设备厂商私有协议的红外编码,实现了对空调、电视等设备的远程与自动化控制,具有很高的实用价值。本文聚焦于美的空调的红外协议,深入探讨了其脉冲宽度调制(PWM)和全量式编码的特点,并提供了基于ESP8266的完整解决方案,包括硬件连接、库函数API详解以及如何将其无缝

weixin_30718391的博客 400

探索Python中的广义线性模型:py-glm

探索Python中的广义线性模型:py-glm 项目介绍 py-glm 是一个用于在Python中拟合、检查和评估广义线性模型的库。广义线性模型(GLM)是统计学中一个强大的工具,广泛应用于回归分析、分类问题以及计数数据分析等领域。py-glm 提供了丰富的功能,支持多种指数族模型,并且与 scikit-learn 的接口风格保持一致,使得用户可以轻松地将GLM集成到现有的机器学习工作流中。 项目...

gitblog_00087的博客 493

保姆级教程:在Windows上用Docker Desktop一键部署Dify 1.0.1(附国内镜像加速)

本文提供在Windows系统上使用Docker Desktop快速部署Dify 1.0.1的详细教程,包括环境准备、国内镜像加速配置、Dify容器部署实战及常见问题解决方案。特别针对国内用户优化,确保快速完成部署并提升开发效率。

weixin_33738555的博客 281

从零到一:在Ubuntu 20.04上搭建ROS1与PX4无人机开发环境

本文详细指导如何在Ubuntu 20.04系统上搭建完整的ROS1与PX4无人机开发环境。内容涵盖ROS Noetic安装、PX4固件源码编译、MAVROS通信桥接以及QGroundControl地面站的配置,并通过Gazebo仿真完成全链路联调测试,为无人机算法开发与验证提供稳定可靠的基础平台。

weixin_29292431的博客 166

`py-glm` 使用指南

py-glm 使用指南 项目介绍 py-glm 是一个 Python 库,旨在提供对广义线性模型(Generalized Linear Models, GLM)的支持。该库允许用户轻松地构建、拟合并分析基于 GLM 的统计模型,这在处理各种数据类型,尤其是非正态分布的数据时非常有用。它实现了广泛的分布家族和连接函数,使得在机器学习和统计分析中能够灵活应用GLM理论。 项目快速启动 安装 首先,你需...

gitblog_00386的博客 369

海洋浮游生物识海洋浮游生物识别系统:基于YOLOv10的显微图像自动检测与UI别系统:基于海洋浮游生物识别系统:基于YOLOv10的显微图像自动检测与UI展示YOLOv10的显微图像自动检测与UI展示

本文介绍了如何利用YOLOv10模型进行海洋浮游生物的自动识别,旨在提高传统显微镜观测的效率与准确性。研究背景强调了浮游生物在海洋生态系统中的重要性,并指出传统方法的局限性。数据集选用WHOI-Plankton,包含70多种浮游生物的20000多张带标签图像。文章详细描述了YOLOv10模型的安装、数据集配置、训练与测试步骤,并提供了基于PyQt5的图形化检测界面代码。结果显示,模型在精度、召回率和mAP@0.5等指标上表现优异,推理速度达到约30 FPS。最后,文章提出了部署建议和未来优化方向,如集成摄像

YOLO 375

广义线性模型(GLM)全面解析

广义线性模型通过三个核心组成部分来描述响应变量与预测变量之间的关系:随机成分、系统成分和链接函数。随机成分随机成分指响应变量的分布类型,通常属于指数族分布。常见的分布包括正态分布、二项分布、泊松分布等。这些分布的概率密度函数或概率质量函数可以表示为指数族的形式,这使得它们在理论和应用中非常便利。fy;fy;θhyexpηθ⋅Ty−Aθ其中,θ( \theta )θ是自然参数,Ty。

秋声工作室 1万+

问答式AI vs 智能体(Agent):它们有什么不同?

你肯定用过 ChatGPT 或文心一言——问它一个问题,它给你一个答案。AI Agent(AI智能体)。很多人搞不清楚:它们不都是"AI"吗?有什么区别?这篇文章用一个最简单的类比,彻底讲清楚这两者的本质差异。框架特点适合人群AutoGPT完全自主执行任务,链式思考开发者MetaGPT模拟团队协作,多角色分工开发者LangChain最流行的Agent开发框架开发者Dify可视化无代码搭建Agent非技术用户Coze(扣子)字节跳动出品,国内最易用普通用户WorkBuddy。

Johnny2004的专栏 445

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

Photon-ML 终极指南:LinkedIn开源的大规模机器学习库

Photon-ML 是由 LinkedIn 机器学习算法团队开发的基于 Apache Spark 的可扩展机器学习库,支持训练多种广义线性模型(GLMs)和广义线性混合模型(GLMMs/GLMix 模型),包括逻辑回归、线性回归和泊松回归,为大规模数据处理提供了强大的解决方案。 ## 🚀 核心功能亮点 ### 🌟 广义线性模型(GLMs) Photon-ML 支持三大基础模型,满足不同业务

gitblog_00503的博客 718

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

coremltools 的 GLMRegressor 格式详解:广义线性模型回归器的 Core ML 规范、校验与转换实践

GLMRegressor(Generalized Linear Model Regressor,广义线性模型回归器)是 Core ML 规范中定义回归模型的五种基础格式之一,用于描述"输入特征向量与连续型预测值之间呈线性关系"的模型。本文以仓库中的 [GLMRegressor.rst](https://link.gitcode.com/i/89dd56888b7efb66bb30c11ac7979

gitblog_01051的博客 175

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

如何快速入门 Photon-ML:5步搭建你的第一个Spark机器学习项目

Photon-ML 是一个基于 Apache Spark 的可扩展机器学习库,由 LinkedIn 机器学习算法团队开发,支持训练多种广义线性模型(GLMs)和广义线性混合模型(GLMMs/GLMix),包括逻辑回归、线性回归和泊松回归等。本指南将帮助你通过5个简单步骤快速上手,搭建并运行你的第一个 Photon-ML 项目。 ## 1️⃣ 环境准备:安装必要依赖 在开始之前,确保你的系统已安

gitblog_00125的博客 405

为什么Spirit-v1.5用p1-p99百分位做归一化?机器人动作数据MinMax归一化实战

Spirit-v1.5 是 Spirit AI 发布的机器人基础模型(VLA 模型),以 50.33% 的成功率登顶 RoboChallenge 榜单。它动作预测之所以稳定,一个容易被忽视的关键细节是:对机器人动作数据做 **MinMax 归一化**时,它没有使用数据集里的最小值和最大值,而是取了 **p1 和 p99 百分位**。本文拆解这个选择背后的原因、计算流程与实战要点,帮你把机器人动作数

gitblog_00247的博客 1091

coremltools 指南:将第三方机器学习模型转换为 Core ML 格式的完整实战手册

Core ML Tools(`coremltools`)是 Apple 官方开源的 Python 工具包,用于将 TensorFlow、PyTorch、scikit-learn、XGBoost、LibSVM 等第三方训练库产出的模型转换为 Apple Core ML 格式,并支持对转换后的模型进行读取、写入、优化与预测验证。本文以仓库根目录 [README.md](https://link.git

gitblog_00370的博客 818

logistic回归为什么采用sigmoid函数——从广义线性函数推导

目录Logistic回归基本形式为什么采用sigmoid函数?广义线性模型 Logistic回归基本形式 为什么采用sigmoid函数? 广义线性模型

zhy_is_pig的博客 2318

探索PyTorch-WideDeep:深度学习与广义线性模型的完美融合

在机器学习和数据科学的领域中,我们经常需要结合多种模型以获得更优的预测效果。而项目正是这样一个工具,它将经典的广义线性模型(Wide部分)与深度学习模型(Deep部分)相结合,提供了一种高效且易于使用的解决方案。 ## 项目简介 PyTorch-WideDeep是一个基于Python的库,利用PyTorch框架构建了广泛应用于推荐系统、广告点击率预估等场景的宽深集成模型。该项目的目标是简化复杂...

gitblog_00043的博客 667

numpy-ml 线性模型模块全解析:从 OLS、岭回归、贝叶斯回归到朴素贝叶斯与 GLM

本文以 numpy-ml 仓库的 [docs/numpy_ml.linear_models.rst](https://link.gitcode.com/i/6680cf4f2a444c31abf8888b65485013) 文档为主体,系统讲解 `numpy_ml.linear_models` 模块中六大模型的数学原理、闭式解推导与源码实现:加权/普通最小二乘(WLS/OLS)线性回归、岭回归(R

gitblog_00979的博客 873

numpy-ml 全解析:基于 NumPy 从零实现机器学习算法的教学级代码库

numpy-ml 是一个用纯 NumPy(仅辅以少量 SciPy)从零实现常见机器学习算法的开源教学代码库,涵盖概率图模型、深度神经网络、树模型、线性模型、强化学习、非参数方法、矩阵分解与预处理工具等十余大类算法。阅读本文后,你将掌握该仓库的安装方式、十二大算法模块的组织结构与源码映射关系,并能以它为起点快速开展实验、教学与二次开发。 ## 项目定位:为什么要用 NumPy 重写一遍机器学习

gitblog_00757的博客 1203

numpy-ml 线性模型模块全解析:从最小二乘到贝叶斯回归与 GLM

numpy-ml 是一个"Machine learning, in numpy"的纯 NumPy 机器学习实现仓库。其 [linear_models 子模块](https://link.gitcode.com/i/52e6b18a7a3c0a3b5a899b59319ae72c) 以不到 900 行代码,完整实现了从经典最小二乘到贝叶斯线性回归、逻辑回归、朴素贝叶斯与广义线性模型的六类线性模型。本

gitblog_00052的博客 713

PySpark ML API 完全指南:Apache Spark 的 DataFrame 机器学习库(pyspark.ml)模块地图与实战速查

本文以 Apache Spark 仓库中官方 API 参考索引 [python/docs/source/reference/pyspark.ml.rst](https://link.gitcode.com/i/50fdf83292d856a03759758011ebaa0e) 为骨架,系统梳理 PySpark 中基于 DataFrame 的机器学习库(MLlib DataFrame-based A

gitblog_00048的博客 360
上一篇: 西门子S7-1200 HslcommunicationDemo大纲拆解
下一篇: 《Py机器学习》—朴素贝叶斯
MuteuooW
博客等级 码龄7年 63粉丝 27原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值