爬取需验证码登录的电影票房数据库,别篡改人家的数据啊!

python实现的电影票房数据可视化 代码地址如下:http://www.demodashi.com/demo/14275.html ##详细说明: Tushare是一个免费、开源的python财经数据接口包.主要实现对股票等金融数据从数据采集、清洗加工 到 数据存储的过程,能够为金融分析人员提供快速、整洁、和多样的便于分析的数据。 完成本项目后,可以进一步通过类似的方法实现股票数据的可视化操作. (代码在python2.7或py... 阅读详情

简单需求分析

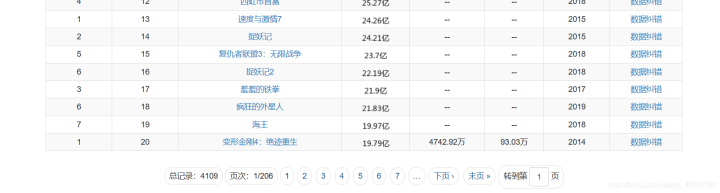
由于练手所需,我们需要电影票房数据。

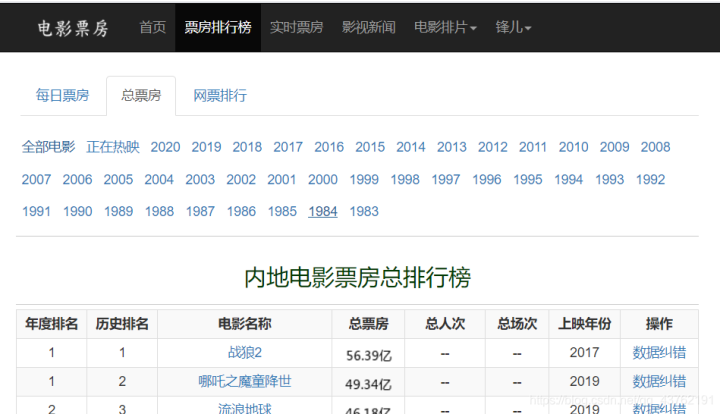
第一次做也没什么经验,就瞄准了电影票房数据库。
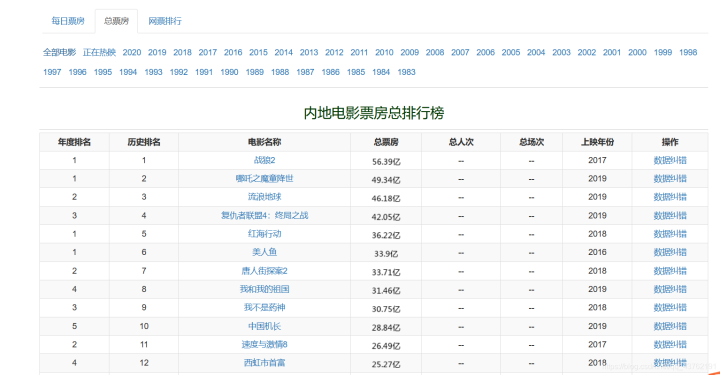


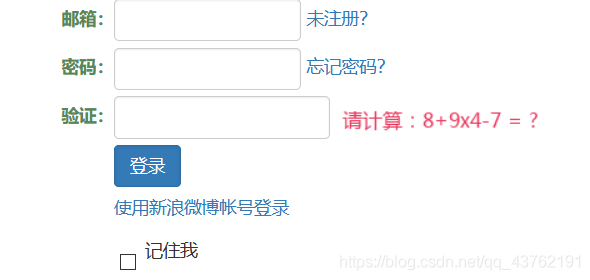
上去之后才知道,人家要登录,登录带了数学验证码。

于是我们开始了。


获取这个消息之后呢,团队里的成员就开始议论了。

最终,一边觉得可以把验证码取下来填上去获取cookies,另一边觉得可以先登录再取cookies,当然他们都成功了。 唯独我用selenium去登录取cookies的爬下来是乱码。

代码实现

哎,我知道,大家点进来也不是为了看我哔哔哔的,基本都想说:赶紧放码过来!!!

以下代码出自团队成员TopTab


import requests
import re
from lxml import etree
import random
from concurrent.futures import ThreadPoolExecutor
import time

user_agent=[
# 请自己放上十几个头
]
#下面的cookie自己加,建议加多个
cookie=[]

list_urls=[]
def geturl(page):
    headers={
        'Cookie':random.choice(cookie),
        'User-Agent':random.choice(user_agent)
    }
    time.sleep(1)
    page = requests.get("http://58921.com/alltime?page={}".format(int(page)),headers=headers)
    html = page.content.decode(encoding='utf-8')
    with open("test.html",'wb') as f:
        f.write(html.encode())
    xpath_data=etree.HTML(page.content)
    list_urls_raw=xpath_data.xpath('//*[@id="content"]/div[3]/table/tbody/tr/td[3]/a/@href')
    # print(list_urls_raw)
    for url in list_urls_raw:
        list_urls.append(url)
    return list_urls


def get_number(url_half):
    headers={
        'User-Agent':random.choice(user_agent)        
    }
    Html=requests.get("http://58921.com"+url_half+"/boxoffice",headers).content.decode("utf-8")
    # print(Html)
    pattern_number = re.compile(r'\(最新票房 (.+?)\)')
    pattern_name=re.compile(r'<h3 class="panel-title">(.*)票房统计\(.*\)</h3>')
    # print(pattern)
    number=pattern_number.findall(Html)[0]
    name=pattern_name.findall(Html)[0]
    print(number,name)
    return number,name

with ThreadPoolExecutor(max_workers=2) as executor_first:
    for i in range(1,30): # 要几页自己调
        executor_first.submit(geturl,i)
print(list_urls)
print(len(list_urls))
with ThreadPoolExecutor(max_workers=2) as executor_second:
    executor_second.map(get_number,list_urls)

然后这个cookies哪里取呢?由于我一直取不到正确的cookies,所以导致效果一直无法复现,这里帮你们把这个问题解决了。


晓得咯?


后记

近期有很多朋友通过私信咨询有关Python学习问题。为便于交流,点击蓝色自己加入讨论解答资源基地


TMDB电影数据分析                                                      这是关于TMDB5000条电影数据的分析报告       数据来源于Kaggle https://www.kaggle.com/tmdb/tmdb-movie-metadata报告分为:    (1)提出问题    (2)认识数据    (3)清洗数据    (4)分析数据    (5)总结(... 阅读详情

相关推荐

python爬虫实战——猫眼电影案例

python爬虫实战——猫眼电影案例 AJ-Gordon,数据分析师一枚,对爬虫,机器学习,数据可视化,数据建模均有所涉猎。 ·背景   笔者上一篇文章《基于猫眼票房数据的可视化分析》中爬取了猫眼实时票房数据,用于展示近三年电影票房概况。由于数据中缺少导演/演员/编剧阵容等信息,所以爬取猫眼电影数据进行补充。关于爬虫的教学内容,网络上一搜就有很多了,这里我以个人的爬虫习惯,介绍此次过程中所用到的库...

guoxulong1的博客 5117

Python爬虫入门案例(二)电影票房数据库爬取(request+XPath+csv)

大家学完第一个案例爬取豆瓣电影数据之后,对爬虫的基本概念以及流程有了大体的了解。其实我个人认为,爬虫的流程都是一样的,只不过方法不同而已。 今天我们就来学习第二个案例,爬取电影票房数据库中的电影数据信息。 网站地址:http://58921.com/ 下面就开始爬取。大概分为三步; 一:获取网页响应 二:获取网页所需内容 三:保存数据 1.获取相应。获取相应的方式与第一个案例一致,直接上代码。 ...

自律 6040

Python爬虫与数据分析实战:从零到项目部署的完整学习路径

Python作为当前最流行的编程语言之一,其核心价值在于能够高效处理数据获取与分析任务。通过requests、BeautifulSoup等库实现网络爬虫技术,可以自动化采集公开网络数据;结合Pandas、NumPy等数据分析工具,能够对海量数据进行清洗、转换与可视化呈现。这种技术组合在商业智能、市场研究、舆情监控等领域具有广泛应用,能够帮助企业从原始数据中提取有价值的信息。本教程围绕Python基础、爬虫实战和数据分析三大模块,构建了从环境搭建到项目部署的完整技能链条,特别适合希望系统掌握数据抓取与处理能力

weixin_30776545的博客 359

Linux C编程(8) 使用相对路径加载动态库-rpath和$ORIGIN

商业程序如何加载自己的so 使用LD_LIBRARY_PATH的缺点是要实现设置LD_LIBRARY_PATH。不够自动化。那么大型的商业程序是如何加载自己的so呢。 这里以QtCreator为例。 QtCreator安装在/home/xxx/Qt5.3.1目录下。使用ldd查看qtcreator依赖的so。 rpath ORIGN

dreamcs的专栏 1万+

从零开始,学会Python爬虫不再难!!! -- (3)揭秘:我是如何绕过登录验证的 丨蓄力计划

文章目录登录验证的背后客户端和服务端请求响应的关系认识session和cookiecookiesession开始操作 上图已魔法反爬,哈哈哈,想爬就爬呗,不拦着。 登录验证的背后 打开一个网页,发现它需要登录,有可能还有各种各样的验证码。 输入账号密码,或者扫码之后登录上网页,解锁更多新功能。 只要我们不关闭网页,这个登录状态就会被保持着。 这个场景都不陌生吧。 我们关闭浏览器,再次打开浏览器,会发现有的网页依旧保持着登录状态,比如说优快云,而有的网页已经被退出登录了,想再次进入就需要重新登录,这样的.

看,未来的博客 2304

MoveIt避坑指南:UR机械臂编程中常见的5个错误及解决方法

本文针对UR机械臂与MoveIt集成开发中的常见问题,总结了五个典型错误及其解决方案,包括关节限位设置、坐标系混淆、规划器选择、运动学求解器配置以及线程资源管理。重点分析了正逆运动学求解错误的原因,并提供了调整容忍度、显式指定坐标系、选择合适规划器及优化IK配置等实用代码示例,帮助开发者提升编程效率与系统稳定性。

root9的博客 433

电影票房的实时统计

# -*- coding: utf-8 -*- import urllib2 import re import os BOR_amount=0.0 url='http://58921.com/' req = urllib2.Request(url, headers={'User-Agent' : "Magic Browser"}) webpage= urllib2.u

浅汐 9826

离线安装vue脚手架,内网安装@vue/cli

公司开发环境使用内网,无法用外网,搭建环境的时候,发现内网系统没有安装vue脚手架,我搜了很多文章,发现他们的方法对我都不适用,然后就自己摸索,最终皇天不负有心人,终于被我安装上了,一下是我内网离线安装vue/cli的方法,希望能帮助到有需要的小伙伴! 因为npm被集成在nodejs中,而安装nodejs只需要把nodejs安装包copy到内网电脑安装就行,比较简单,这里就不多做演示。 在外网电脑上,使用npm install -g xxxx命令下载好我们所需要的各个安装包,比如: npm insta

Liberty_yes的博客 1万+

爬虫百战穿山甲(四)爬取需验证码登录的电影票房数据库

文章目录 简单需求分析 代码实现 简单需求分析 由于练手所需,我们需要电影票房数据。 第一次做也没什么经验,就瞄准了电影票房数据库。 在这里插入图片描述 在这里插入图片描述 上去之后才知道,人家要登录,登录带了数学验证码。 于是我们开始了。 在这里插入图片描述 获取这个消息之后呢,团队里的成员就开始议论了。 最终,一边觉得可以把验证码取下来填上去获取cookies,另一边觉得可以先登录再取cookies,当然他们都成功了。 唯独我用selenium去登录取cookies的爬下来是乱码。 代
ZZ100861122的博客 685

【QT+VS】如何在现有VS项目中添加Qt界面?【全网最详细】

VS项目有了,就缺个QT界面,怎么办呢?这篇文章帮你一键搞定!

深耕CV 4983

WSL2 Ubuntu 22.04安装NVIDIA驱动避坑指南:从驱动版本选择到CUDA环境验证

本文详细介绍了在WSL2 Ubuntu 22.04中安装NVIDIA驱动和配置CUDA环境的完整流程,包括驱动版本选择、环境变量设置以及常见问题解决方案。通过本指南,用户可以避免常见的安装陷阱,确保GPU加速环境正确配置,适用于深度学习开发和CUDA编程。

weixin_28419039的博客 463

基于大数据的电影票房爬取数据及可视化分析系统

2、同时增加文字触发提醒,设置提醒语,有相同字段的数据,会触发弹框提醒,例如设置状态提醒:特急/加急/一般 增加自定义提醒语(如:库存不足,请补货)对于本系统,我们提供全方位的支持,包括修改时间和标题,以及完整的安装、部署、运行和调试服务,确保系统能在你的电脑上顺利运行。AI续写、AI优化、AI校对、AI翻译:新增AI接口,编辑器接入AI,可以实现AI续写、AI优化、AI校对、AI翻译,可以帮你实现自动化,ai帮你完成文档。多种统计效果:可以多种统计图效果展示,1、合并效果 2、单独展示3、随模块一起。

豆包程序员 164

探索Vortex开源GPGPU:RISC-V SIMT架构(4-1),Execute SFU(1)

本文详细分析了Vortex RISC-V内核6级流水线中Execute阶段的SFU(特殊功能单元)模块。重点介绍了SFU的数据流结构,包含dispatch_unit、pe_switch、csr_unit、wctl_unit和gather_unit五个子模块。文章深入解析了warp控制指令wspawn和tmc的实现机制:wspawn用于激活指定数量的warp并设置新PC值,tmc则用于控制线程掩码和warp状态。通过C代码和汇编指令的对照分析,阐明了这些指令在并行计算中的关键作用,包括线程激活、状态切换和执行

weixin_55313207的博客 1363

大数据技术基于python的电影票房爬取与可视化系统

简单说,一个管安全规则,一个管身份凭证,组合起来为Web应用打造可靠防护。2、同时增加文字触发提醒,设置提醒语,有相同字段的数据,会触发弹框提醒,例如设置状态提醒:特急/加急/一般 增加自定义提醒语(如:库存不足,请补货)对于本系统,我们提供全方位的支持,包括修改时间和标题,以及完整的安装、部署、运行和调试服务,确保系统能在你的电脑上顺利运行。AI续写、AI优化、AI校对、AI翻译:新增AI接口,编辑器接入AI,可以实现AI续写、AI优化、AI校对、AI翻译,可以帮你实现自动化,ai帮你完成文档。

qq840612233的博客 66

14、脑肿瘤复发预测与转移瘤跟踪的自动化方法

本文介绍两种脑肿瘤相关自动化方法:一种用于预测胶质瘤切除术后的肿瘤复发位置,结合图像配准、静态模型和动态模拟模型,利用患者的DTI数据进行预测;另一种用于在纵向扫描中跟踪转移性脑肿瘤,通过联合求解配准参数估计和图像变化标记问题,提高肿瘤跟踪的准确性和效率。文章同时分析了两种方法的优势与挑战,并提出了未来研究方向,旨在为脑肿瘤的诊断和治疗提供更可靠的工具。

defi6farmer的博客 115

【AI大模型:前沿】46、AI+无人机:智能飞行革命全景指南——从技术突破到行业应用与未来趋势

AI+无人机的融合不仅是技术迭代,更是“空间生产力”的革命——它将人类活动范围从地面拓展至低空,重构物流、农业、应急等行业的生产方式。当前,技术突破(如多模态感知、群体智能)与法规松绑(超视距飞行许可)正加速产业化,预计2030年全球低空经济市场规模将突破万亿美元。技术层:轻量化AI模型、边缘-云端协同、安全冗余系统;应用层:垂直领域解决方案(如电网AI巡检、精准农业);生态层:无人机巢建设、空管系统、数据服务平台。

2025博客之星Top81。专注AI工程化与架构实战。从分布式思维到模型部署,用工程化视角为你厘清AI落地的真实路径。 5591

Python爬虫实战:猫眼电影票房数据采集与可视化分析完整指南

网络爬虫作为数据采集的核心技术,通过模拟浏览器行为自动获取网页信息。其工作原理基于HTTP协议请求响应机制,结合HTML解析技术提取结构化数据。在数据驱动决策的时代,爬虫技术价值体现在能够快速获取市场动态、竞品分析等商业情报。Python生态中的requests库简化了网络请求过程,BeautifulSoup提供了便捷的HTML解析方案,而pandas和pyecharts则实现了从数据清洗到可视化展示的完整链路。猫眼电影票房数据爬取项目正是这一技术栈的典型应用场景,涵盖了请求头模拟、频率控制等反爬应对策略,

weixin_30487201的博客 290

11、基于多阵列电极的表面肌电信号运动估计

本文介绍了一种基于多阵列电极的表面肌电信号运动估计技术,旨在实现对手腕和手指运动的高精度估计,解决传统人机接口在操控多自由度机器人时的局限性。通过多阵列电极系统采集前臂肌肉活动信号,结合独立成分分析(ICA)和非负矩阵分解(NMF)等信号处理方法,提取肌肉协同作用,进而生成运动指令以控制机器人或假肢手。文章对比了多阵列电极与传统电极的优势,展示了运动估计算法的整体流程,并以假肢手控制为例说明其实际应用。最后探讨了该技术在测量精度、应用拓展、智能化和便携化等方面的未来发展方向。该技术为假肢控制、康复训练和人机

ik678901234的博客 87

python - 爬虫简介

模拟浏览器对网站服务器发送请求解析服务器返回的响应数据,并保存数据。

violetta521的博客 3109

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

电影数据分析需求文档

电影数据分析需求文档1.项目概述1.1项目背景1.2项目目的1.3产品简介2.项目总体设计2.1可行性分析2.2项目要解决的问题2.3项目目标3.功能需求3.1功能划分3.2功能描述3.2.1.电影信息查询3.2.2.用户偏好推荐3.2.3.用户登录功能4.开发环境介绍4.1开发工具介绍4.2网站三层架构5.项目数据描述5.1电影数据表5.2用户数据表 1.项目概述 1.1项目背景 根据北京电影学...

qq_43015469的博客 6448

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

零基础Python学习路径:从环境搭建到爬虫数据分析实战

Python作为一门广泛应用于数据科学、自动化脚本和Web开发的高级编程语言,其核心价值在于简洁的语法和强大的生态系统。理解Python的工作原理,关键在于掌握其解释型语言的特性,以及通过包管理工具pip和虚拟环境venv来管理依赖。在技术实践中,Python通过requests库实现网络请求,结合BeautifulSoup进行HTML解析,构成了数据采集的基础能力。而pandas库则为数据清洗、转换和分析提供了高效的数据结构,如DataFrame,使得处理结构化数据变得直观。这些技术的结合,形成了从数据获

weixin_30876945的博客 496

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

商业数据分析全链路实战:Excel透视表、SQL、Python与爬虫核心技能整合

商业数据分析是当今企业决策的核心驱动力,其本质在于通过技术手段将原始数据转化为商业洞察。其核心原理涉及数据获取、清洗、存储、分析与可视化等多个环节。掌握这一技能组合能显著提升个人与组织的数据驱动决策能力,广泛应用于市场分析、运营优化、产品评估等场景。本文聚焦于整合Excel数据透视表、SQL数据库操作、Python数据分析及网络爬虫这四项关键技术,构建从数据源到洞察的完整闭环。其中,数据透视表作为快速汇总与可视化的利器,Python则凭借其强大的Pandas库成为自动化处理与复杂分析的引擎。通过串联这些工具

weixin_30386713的博客 348

基于django电影购票系统-计算机毕设 【课程设计】 03288

注册用户功能模块: 前台首页:注册用户注册登录系统后,可以在首页查看并使用轮播图、电影资讯、电影信息快捷导航按钮。 公告信息:用户可以查看管理员发布的所有公告信息,并可对其进行收藏和评论。 电影资讯:用户能够通过搜索、筛选和排序的方式查找相关的电影资讯然后点击查看详情,并可进行点赞、收藏和评论。 电影信息:用户在电影信息列表里能够通过电影搜索、类型搜索和排序的方式查找相关的电影信息然后点击查看详情,并可进行点赞、收藏和评论。 优惠活动:展示当前的优惠活动,吸引用户参与。 我的账户:修改个人信息和账户密码。

WeiXin_DZbishe的博客 1435

Python零基础5天速成:爬虫与数据分析实战路径全解析

Python作为当下最热门的编程语言之一,其核心价值在于强大的生态库和简洁的语法,能够高效解决数据处理与自动化问题。从技术原理上看,Python通过丰富的第三方库(如Requests、Pandas)实现了网络数据采集和结构化分析,为数据驱动决策提供了技术基础。在工程实践中,掌握Python爬虫与数据分析能力,可以快速实现从数据获取、清洗到可视化呈现的全流程自动化,显著提升工作效率。特别是在大数据和人工智能时代,这两项技能已成为数据分析师、开发工程师乃至业务人员的标配。本文以一套系统的Python零基础教程为

weixin_30598225的博客 466

Python零基础到实战:300集教程学习路径与就业技能拆解

Python作为一门广泛应用于数据科学、自动化脚本和Web开发的高级编程语言,其核心优势在于简洁的语法和强大的生态系统。理解Python的基础语法、数据结构与函数式编程原理,是掌握其技术价值的第一步。在工程实践中,Python通过丰富的第三方库(如Requests、Pandas)实现了高效的网络爬虫与数据分析能力,这些技能在数据采集、业务洞察等应用场景中至关重要。本文聚焦于一套涵盖Python基础、爬虫与数据分析三大模块的300集教程,深入剖析其学习路径与实战价值,并探讨如何通过项目驱动的方式,将教程知识转

weixin_34054931的博客 435
上一篇: 十行 Python 代码就提取了韦小宝的身份证信息!
下一篇: 自己30分钟能“走”多远嘛?Python来计算超过半步算我输
pythonlaodi
博客等级 码龄6年 286粉丝 244原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值