Python爬虫可以有选择性地爬取好看的图片!

python爬虫 可以有选择性地爬取好看的图片 爬虫部分的代码是xpath实现的,不妥的地方还请大佬们指点 运行结果如下: 这里做了一个判断,中文的话转成拼音,拼接进url中进行解析 输入有误的话会执行循环,判断输入的内容类型是不是在列表里面 源码如下: #!/usr/bin/env python # -*- coding: utf-8 -*- # @Time : 2020/11/9 18:32 # @Author : huni # @File : 爬彼岸图网.py # @Software: PyCharm import requ 阅读详情
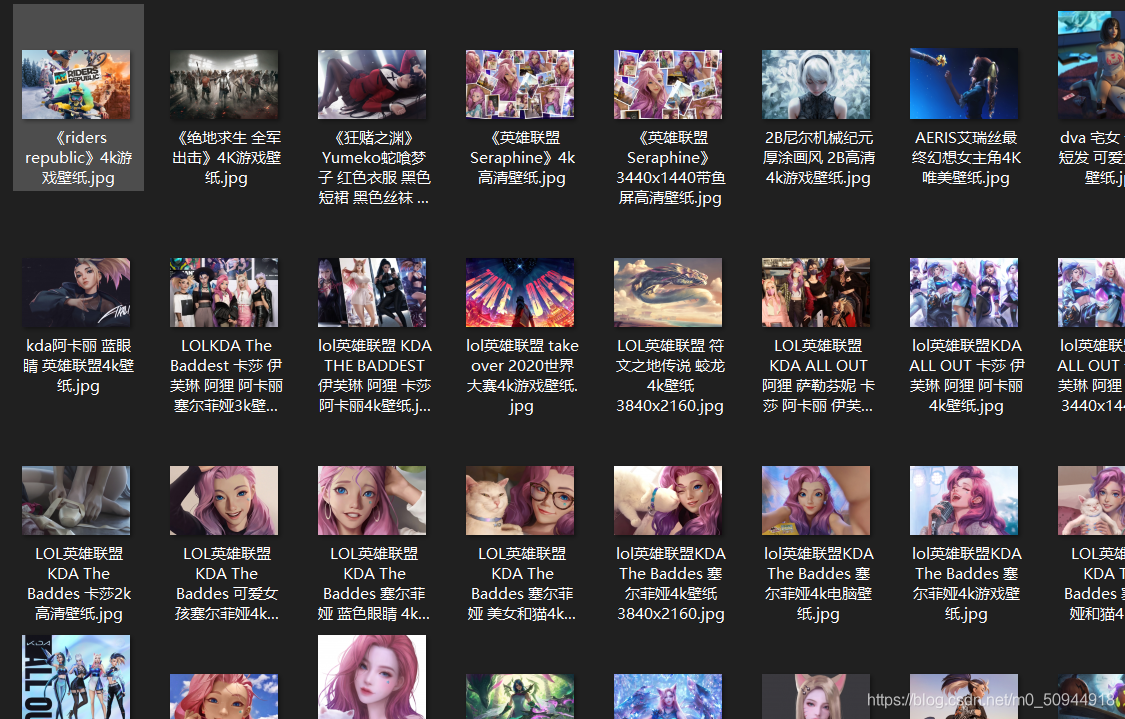
爬虫部分的代码是xpath实现的,不妥的地方还请大佬们指点
运行结果如下:
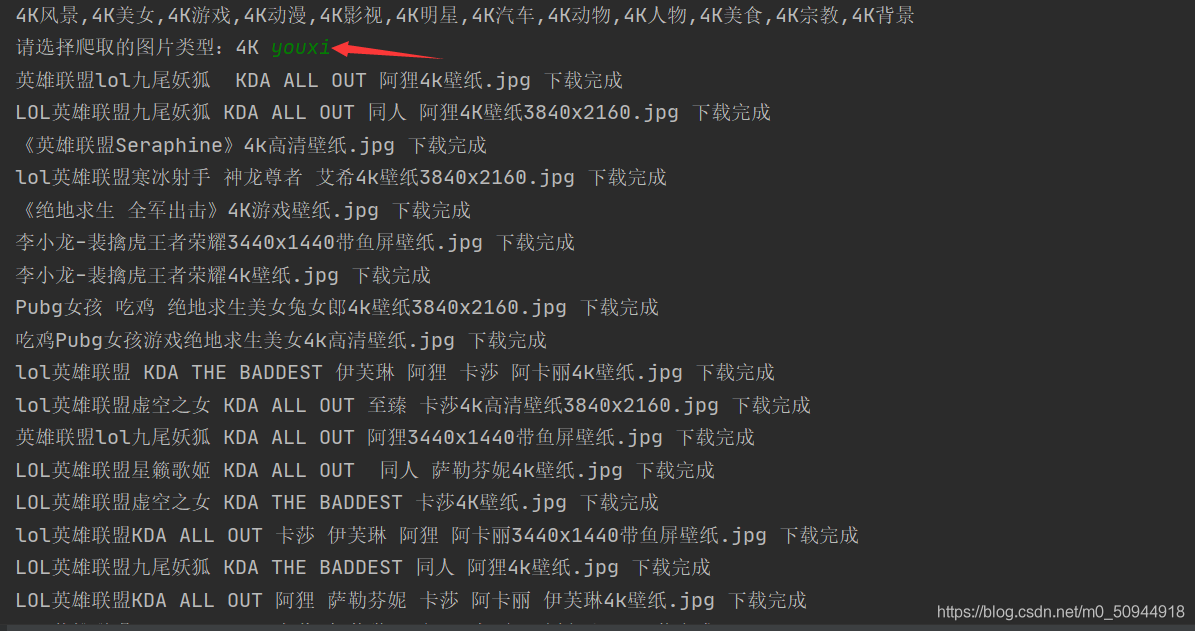


这里做了一个判断,中文的话转成拼音,拼接进url中进行解析
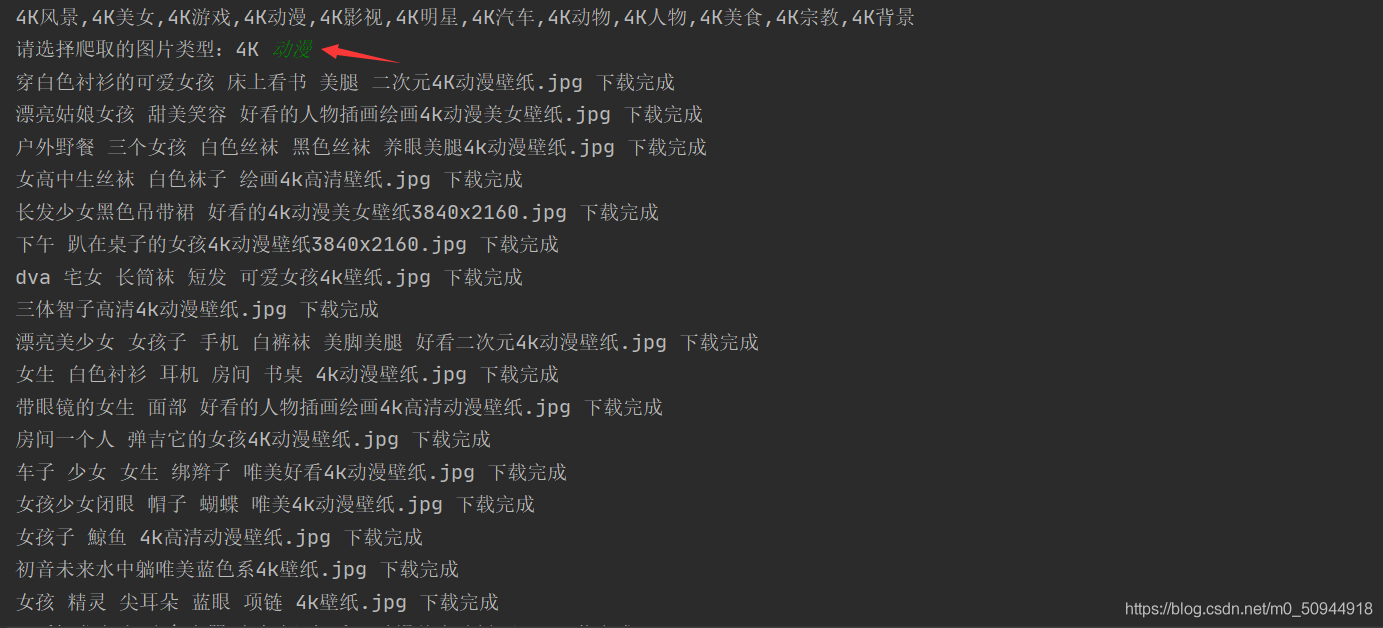

输入有误的话会执行循环,判断输入的内容类型是不是在列表里面
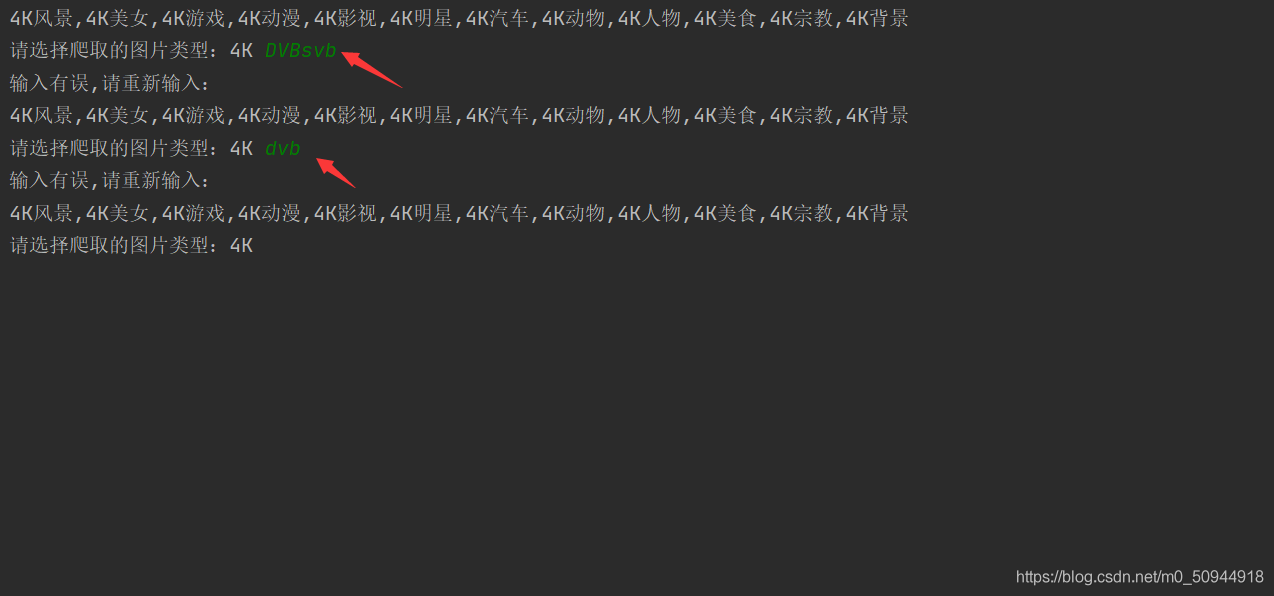
源码如下:

#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Time    : 2020/11/9 18:32
# @Author  : huni
# @File    : 爬彼岸图网.py
# @Software: PyCharm

import requests
from lxml import etree
import os
from pypinyin import lazy_pinyin

def main():
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.183 Safari/537.36'
    }
    while True:
        typelist = ['fengjing','meinv','youxi','dongman','yingshi','mingxing','qiche','dongwu','renwu','meishi','zongjiao','beijing']

        print('4K风景,4K美女,4K游戏,4K动漫,4K影视,4K明星,4K汽车,4K动物,4K人物,4K美食,4K宗教,4K背景')
        searchtype = input('请选择爬取的图片类型:4K ')
        res = True      #判断是否全为中文 是中文就返回True
        for w in searchtype:
            if not '\u4e00' <= w <= '\u9fff':
                res = False
        if not res:     #如果不是中文直接赋值给new_searchtype
            new_searchtype = searchtype
            if new_searchtype not in typelist:
                print('输入有误,请重新输入:')
            else:
                getData(new_searchtype,headers)
                break
        else:           #如果是中文就用拼音模块转成拼音再赋值给new_searchtype
            new_searchtype = lazy_pinyin(searchtype)[0] + lazy_pinyin(searchtype)[1]
            if new_searchtype not in typelist:
                print('输入有误,请重新输入:')
            else:
                getData(new_searchtype,headers)
                break


def getData(new_searchtype,headers):

    for i in range(1,4):
        if i == 1:
            url = 'http://pic.netbian.com/4k' + new_searchtype +'/'
        else:
            url = 'http://pic.netbian.com/4k' + new_searchtype +'/' + 'index_' + str(i) + '.html'
        response = requests.get(url=url,headers=headers)
        response.encoding = 'gbk'
        page_text = response.text

        #解析src属性值,解析alt的属性值
        tree = etree.HTML(page_text)
        # with open()
        li_list = tree.xpath('//*[@id="main"]/div[3]/ul/li')

        #创建一个文件夹
        if not os.path.exists('./picLibs'):
            os.mkdir('./picLibs')

        for li in li_list:
            name = li.xpath('./a/img/@alt')[0] + '.jpg'
            src = 'http://pic.netbian.com' + li.xpath('./a/img/@src')[0]
            # print(name,src)

            #请求图片进行储存
            img_data = requests.get(url=src,headers=headers).content
            img_path = 'picLibs/' + name
            with open(img_path,'wb') as fp:
                fp.write(img_data)
                print(name,'下载完成')


if __name__ == '__main__':
    main()


扩展阅读:
来自 优快云的 Refrain__WG 和 github的mozillazg

1判断全是英文

b = 'bilibili站'
b.isalpha()        # 中英混合不适用
# True
b.encode('utf-8').isalpha()
# False
b.encode('utf-8')
# b'bilibili\xe7\xab\x99'

2.判断全是中文

word_1 = '如何再飘摇'
res = True
 
for w in word_1:
    if not '\u4e00' <= w <= '\u9fff':
        res = False
        
print(res)
# True
123456789
word_2 = '风停了云知道2333'
res = True
for w in word_2:
    if not '\u4e00' <= w <= '\u9fff':
        res = False
        
print(res)
# False
 
 
word_3 = 'abc风中有朵雨做的云abc'
res = True
for w in word_3:
    if not '\u4e00' <= w <= '\u9fff':
        res = False
print(res)
# False

4.汉字转拼音
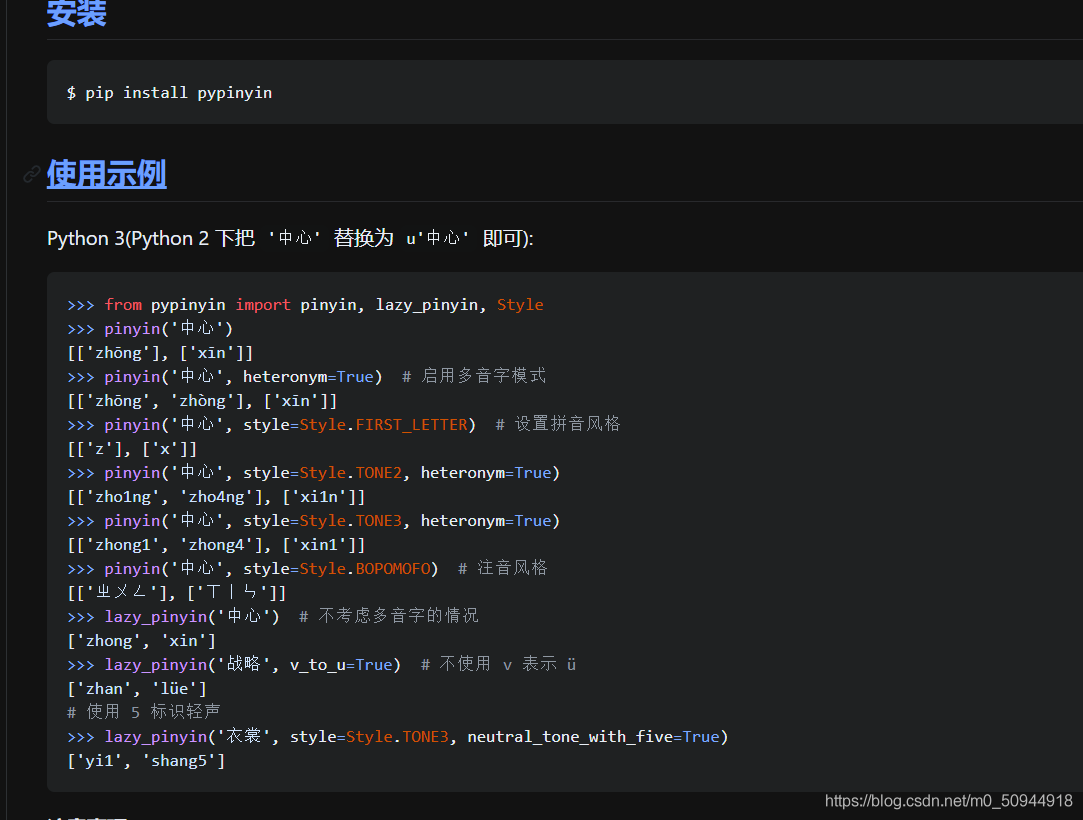
PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取

python免费学习资料以及群交流解答点击即可加入


【100天精通python】Day41:python网络爬虫开发_爬虫基础入门 网络爬虫(Web Crawler),是一种自动化程序,用于在互联网上浏览和抓取信息。爬虫可以遍历网页,收集数据,提取信息,以便于进一步处理和分析。网络爬虫在搜索引擎、数据采集、信息监测等领域发挥着重要作用。1.1 工作原理初始URL选择: 爬虫从一个或多个初始URL开始,这些URL通常是你希望开始爬取的网站的主页或其他页面。发送HTTP请求: 对于每个初始URL,爬虫会发送HTTP请求以获取网页内容。 阅读详情

相关推荐

解码运动想象:BCI Competition IV 2a数据集实战指南

本文提供了BCI Competition IV 2a数据集的实战指南,详细解析了该经典运动想象脑电数据集的结构、文件格式与实验范式。通过MNE-Python等工具,逐步演示了从原始信号读取、预处理(通道选择、滤波、分段)到特征提取(CSP、频带功率)和模型训练(LDA、SVM)的完整流程,并强调了受试者独立评估的重要性,为BCI研究者提供了可复现的入门与进阶路径。

weixin_29304985的博客 362

爬虫案例:手把手教你爬取图片

大家好,我是一行今天是小白菜同学的投稿,老规矩一个赞10积分一、确认目标和思路:写在最前面:程序很简单,重要的是思路以及对错误的分析1.确认目标和大体思路: 今天我们需要爬取的网站是:h...

一行玩python 1万+

SoC低功耗设计实战:28nm工艺下四核A7的Hierarchical Flow全流程解析

本文深入解析了在TSMC 28nm工艺上,采用Hierarchical Flow(层次化流程)实现四核Cortex-A7 SoC低功耗设计的全流程。文章从项目背景切入,详细探讨了基于UPF的电源规划、时钟树综合、接口时序收敛以及物理验证等关键环节,分享了使用Cadence Innovus等工具进行低功耗物理实现的实战经验与挑战。

weixin_29231263的博客 324

Python爬取图片

爬取网站https://image.baidu.com/

lidiaosi的博客 2万+

Pyradiomics 医学影像提取放射组学特征(下)

Pyradiomics 医学影像提取放射组学特征(下)

Edward的博客 1312

PyTorch深度学习实战(4)——常用激活函数和损失函数详解

激活函数和损失函数是深度学习模型中重要组成部分,激活函数和损失函数的选择很大程度上决定了深度神经网络的性能和精度,需要根据具体问题的特点和数据分布等因素进行选择。在本节中,将介绍深度学习中常见的激活函数和损失函数,并说明不同函数的常见应用场景。

盼小辉丶的博客 1万+

Python应用开发——爬取网页图片

当我们需要从网页上面下载很多图片的时候,一个一个手动保存实在是太累人了。那么有没有批量下载的办法呢? 答案是有的,Python爬虫就可以完美的做到这一点,而且作为一个Python的初学者,我可以很负责任的告诉你,这门语言入门挺简单的,特别是对于那些有其他编程语言经验的人。

ShenZhen_zixian的博客 4万+

【PointNet++】制作点云数据集使用CloudCompare进行标注

使用PointNet++复现成功后,需要训练自己的数据集。于是使用cloudcompare参照ShapeNet的数据集格式去制作,最终保存的txt文件格式为“xyz+rgb+label”,一共7列。 自己按此制作好的数据集已成功训练及推测,于是记录下来让好兄弟好姐妹们少踩坑多吃肉。

纵马踏花向自由 5715

Python爬虫实战(五):根据关键字爬取某度图片批量下载到本地(附上完整源码)

Python爬虫实战(五):根据关键字爬取某度图片批量下载到本地(附上完整源码)

努力让自己发光,对的人才能迎着光而来 14万+

HINT: High-quality INpainting Transformer with Mask-Aware Encoding and Enhanced Attention 训练自己的数据集

HINT(高质量图像修复变换器)通过创新的掩码感知像素洗牌下采样模块(MPD)和空间激活通道注意力层(SCAL),显著提高了图像修复的质量,尤其在大面积缺失区域的情况下。实验表明,HINT在CelebA、CelebA-HQ、Places2和敦煌数据集上超越了现有的最先进模型,提升了图像的细节和结构一致性。

LJ1147517021的博客 312

2021年03月 C/C++(五级)真题解析#中国电子学会#全国青少年软件编程等级考试

给定一个十进制正整数n(0 < n < 1000000000),每个数位上数字均不为0。n的位数为m。现在从m位中删除k位(0

人生就是一个不断学习的过程 1011

Python爬虫爬取图片

** Python爬虫爬取网站指定图片(多个网站综合经验结论分享) ** 我想以这篇文章来记录自己学习过程以及经验感受,因为我也是个初学者。接下来我将分享几个我爬取过的图片网站,给大家们分享下自己的方法经验。嘿嘿! 我选了以下两个具有代表性的网站进行分享 网站1: 摄图网 第一步:导入需要用到的库:requests、BeautifulSoup和time import requests from bs4 import BeautifulSoup import time 第二步:伪装自己的爬虫 因为很多网站都

weixin_52136304的博客 2万+

手把手教你从入门到精通C#串口通信

本文以我开发的串口助手SComTool为例,详细介绍《C#串口通信从入门到精通》专栏的目录内容,本专栏由一个高级工程师多年实战经验总结,绝对是c#串口通信的葵花宝典!带您从入门到精通C#串口通信!

qq_34059233的博客 3万+

Python 网络爬虫与数据采集(一)

Python 网络爬虫与数据采集第1章 序章 网络爬虫基础1 爬虫基本概述1.1 爬虫是什么1.2 爬虫可以做什么1.3 爬虫的分类1.4 爬虫的基本流程1.4.1 浏览网页的流程1.4.2 爬虫的基本流程1.5 爬虫与反爬虫1.5.1 爬虫的攻与防1.5.2 常见的反爬与反反爬1.6 爬虫的合法性与 robots 协议1.6.1 robots 协议1.6.2 查看网页的 robots 协议1.7 Python 爬虫相关库2. Chrome 浏览器开发者工具2.1 Chrome 浏览器开发者工具简述2.1

无 3万+

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

网络爬虫技术

本文介绍了网络爬虫的基础概念与应用。主要内容包括:1)爬虫定义与分类,分为通用、聚焦、增量式和深层网络爬虫四种类型;2)核心工作原理,涉及HTTP请求过程、响应结构和网页基础;3)常见爬取策略如宽度优先(BFS)和深度优先(DFS)遍历;4)Python中Requests库的使用方法,包括请求发送、响应处理和异常捕获。文章通过百度网页爬取实例,展示了网络爬虫从发送请求到获取响应的完整流程,为初学者提供了网络数据采集的基础知识框架。

2302_78993464的博客 2958

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

网络爬虫的基本认识

静态网页的内容预先写在 HTML 文件中,加载时无需与服务器动态交互(如调用 API),直接通过浏览器解析 HTML 即可显示。页面源码(右键 “查看网页源代码”)中能直接看到所有内容(如文字、图片链接、表格数据);网址通常以.html.htm结尾(也可能是动态路由,但内容固定);对比动态网页:动态网页(如 JavaScript 渲染的页面)源码中看不到最终内容,需额外处理(静态爬取不涉及)。以下是几个必备工具。

Louisejrkf的博客 1565

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Python 网络爬虫与数据采集

第1章 序章 网络爬虫基础1 爬虫基本概述1.1 爬虫是什么1.2 爬虫可以做什么1.3 爬虫的分类1.4 爬虫的基本流程1.4.1 浏览网页的流程1.4.2 爬虫的基本流程1.5 爬虫与反爬虫1.5.1 爬虫的攻与防1.5.2 常见的反爬与反反爬1.6 爬虫的合法性与 robots 协议1.6.1 robots 协议1.6.2 查看网页的 robots 协议1.7 Python 爬虫相关库2. Chrome 浏览器开发者工具。

2301_82162165的博客 2594

Python爬虫是什么?一文带你了解Python爬虫

作为程序员,相信大家对“爬虫”这个词并不陌生,身边常常会有人提这个词,在不了解它的人眼中,会觉得这个技术很高端很神秘。不用着急,我们的爬虫系列就是带你去揭开它的神秘面纱,探寻它真实的面目。爬虫是什么网络爬虫(又被称为网页蜘蛛,网络机器人),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。

xiaolinyui的博客 1548

关于python网络爬虫需要了解的几点基础常识!

关于【python网络爬虫】 目录: 一、什么是python爬虫 二、python爬虫产生的背景 三、Python网络爬虫常用的几种类型 四、Python网络爬虫的实现方式

zhaoylzy的博客 1449

网络爬虫技术从入门到精通(渗透高端操作)第一章

爬虫的简单定义: 网络爬虫是一个自动提取网页的程序,它为搜索引擎从万维网上下载网页,是搜索引擎的重要组成。传统爬虫从一个或若干初始网页的URL开始,获得初始网页上的URL,在抓取网页的过程中,不断从当前页面上抽取新的URL放入队列,直到满足系统的一定停止条件。 下面我们来看网络爬虫框架,我先带大家入门,做一些简单的东西,并在实例中为大家讲述。 爬虫的分类: 1:通用网络爬虫 它的爬取范围和爬取数据较大,对于爬取的速度和存储空间要求比较高,她在爬取页面的顺序上效率比较低,需要好长时间才能刷新一回页面,..

jgdabc的博客 8056

网络爬虫的基本原理及抓取静态网页详解

网络爬虫(又称为网页蜘蛛,网络机器人)是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。网络爬虫可以从一个或若干初始网页的URL开始,通过抓取网页上的链接地址,自动地访问网页、提取数据,实现对整个网站内容的爬取。网络爬虫主要用于搜索引擎、数据挖掘、信息提取、网页抓取等应用,是网络数据采集的重要工具。网络爬虫的技术实现涉及到多个领域的知识,包括计算机网络、数据挖掘、自然语言处理等。网络爬虫的分类有多种,根据其爬取范围可以分为通用爬虫和聚焦爬虫。

2303_76177437的博客 3378

Python爬虫的核心库——requsts库,并附加百度图片爬取脚本

requsts.get() get(url, params=None, **kwargs) Sends a GET request. param url: URL for the new :class:Request object. param params: (optional) Dictionary, list of tuples or bytes to send in the query s...

qq_41734243的博客 1744

《精通python网络爬虫》——笔记

花一个月不到的时间匆匆学的python现在终于得到了一丢丢的用处,一开始学python的初心就是想弄网络爬虫,感觉爬虫这个东西才是最有意思的部分,后来发现爬取那么多的数据,最后需要的还是要对数据进行分析和探究数据背后的奥秘,这样的进阶路线只是学习python爬虫的其中一个目标,这也是题主学python的一个主要原因,之后就是往人工智能和机器学习方面去进行入门了,题主现在还只是一个小白,正在这条路上...

偏执的眸 3857

Python 爬虫介绍,什么是爬虫,如何学习爬虫?

作为程序员,相信大家对“爬虫”这个词并不陌生,身边常常会有人提这个词,在不了解它的人眼中,会觉得这个技术很高端很神秘。不用着急,我们的爬虫系列就是带你去揭开它的神秘面纱,探寻它真实的面目。 爬虫是什么 网络爬虫(又被称为网页蜘蛛,网络机器人),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。 通俗地讲,我们把互联网比作...

444

Python爬虫是什么?一文带你了解Python爬虫,新手小白必看 !!

网络爬虫(又被称为网页蜘蛛,网络机器人),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。 通俗地讲,我们把互联网比作一张大蜘蛛网,每个站点资源比作蜘蛛网上的一个结点,爬虫就像一只蜘蛛,按照设计好的路线和规则在这张蜘蛛网上找到目标结点,获取资源。

python03012的博客 2097
上一篇: Djange构建招聘信息爬虫系统!太强了吧!
下一篇: Python爬虫:手把手教你采集登陆后才能看到数据!
pythonlaodi
博客等级 码龄6年 286粉丝 244原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值