Python网络爬虫——爬取小视频网站源视频!自己偷偷看哦!

Python 爬虫实战——爬取视频(一) 这篇内容就简单给大家写个如何从网页上爬取某B主 主页 页面上所有的视频链接和视频标题。这篇是基础,下篇会根据这篇的结果做一个批量爬取视频的教程(先提前给大家展示个效果图)。此程序是在Python 3.11.6 版本的环境,注意哦要不然程序可能运行不起来。很简单,代码不多,但是大家要合理合fa运用爬虫技术哦。 阅读详情

学习前提

1、了解python基础语法
2、了解re、selenium、BeautifulSoup、os、requests等python第三方库

1.引入库

PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取

python免费学习资料以及群交流解答点击即可加入

爬取网站视频需要引入的第三方库:

import os 
from selenium import webdriver 
import requests 
from bs4 import BeautifulSoup 
import re 

模块用处:

1、os模块:文件目录操作模块,用于创建或者删除目录或文件。
2、selenium模块:python请求模块之一,用于某些特殊请求。
3、requests模块:用于请求网页地址。
4、BeautifulSoup模块:用于解析网页,获取页面元素或内容。
5、re模块:正则表达式,本程序中用于匹配视频链接。


2.请求网页地址

请求页面:

"""请求页面"""
header = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.111 Safari/537.36"
} #请求
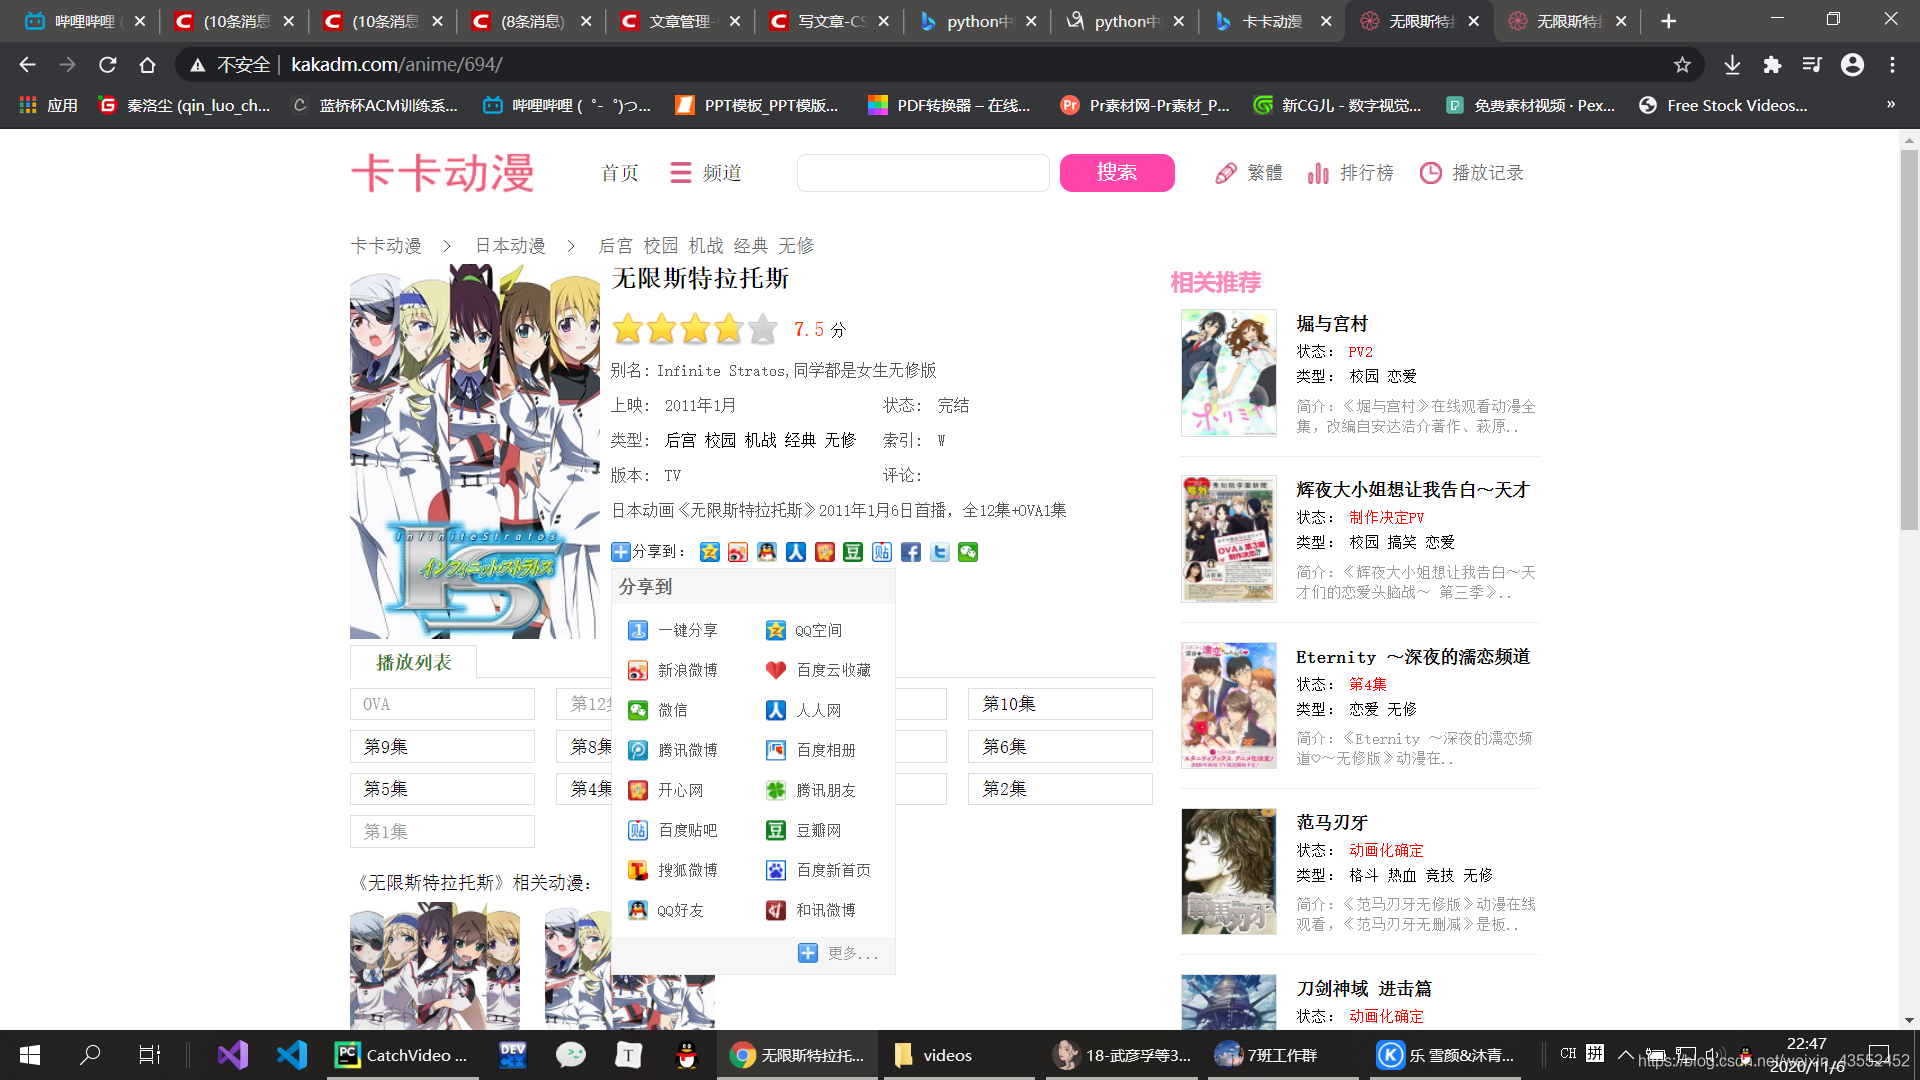
url = "http://www.kakadm.com/anime/2417/" #网页地址,这里以卡卡动漫中的无限斯特拉托斯为例
r = requests.get(url, headers=header)
html = r.text #以二进制打印页面

由上述代码获取如下页面:
请求头(反爬机制中的一种):

headers中包含网页请求中的请求头,每一个浏览器都有属于自己的请求头,因此需要更改,以免请求失败


3.解析网页,获取播放链接

解析上述页面:

"""解析页面"""
soup = BeautifulSoup(html, "html.parser")
urls = soup.find("div", class_="movurl").find_all("a") #查找视频播放链接

videourls = []
for u in urls:
    videourls.append(u.get("href")) #由分析网页元素可知,仅获取链接部分内容

# 获取视频播放地址
str = "http://www.kakadm.com/"
for index, item in enumerate(videourls):
    videourls[index] = str + item #加上前缀,获取13个视频播放链接

由上述代码获取如下页面:
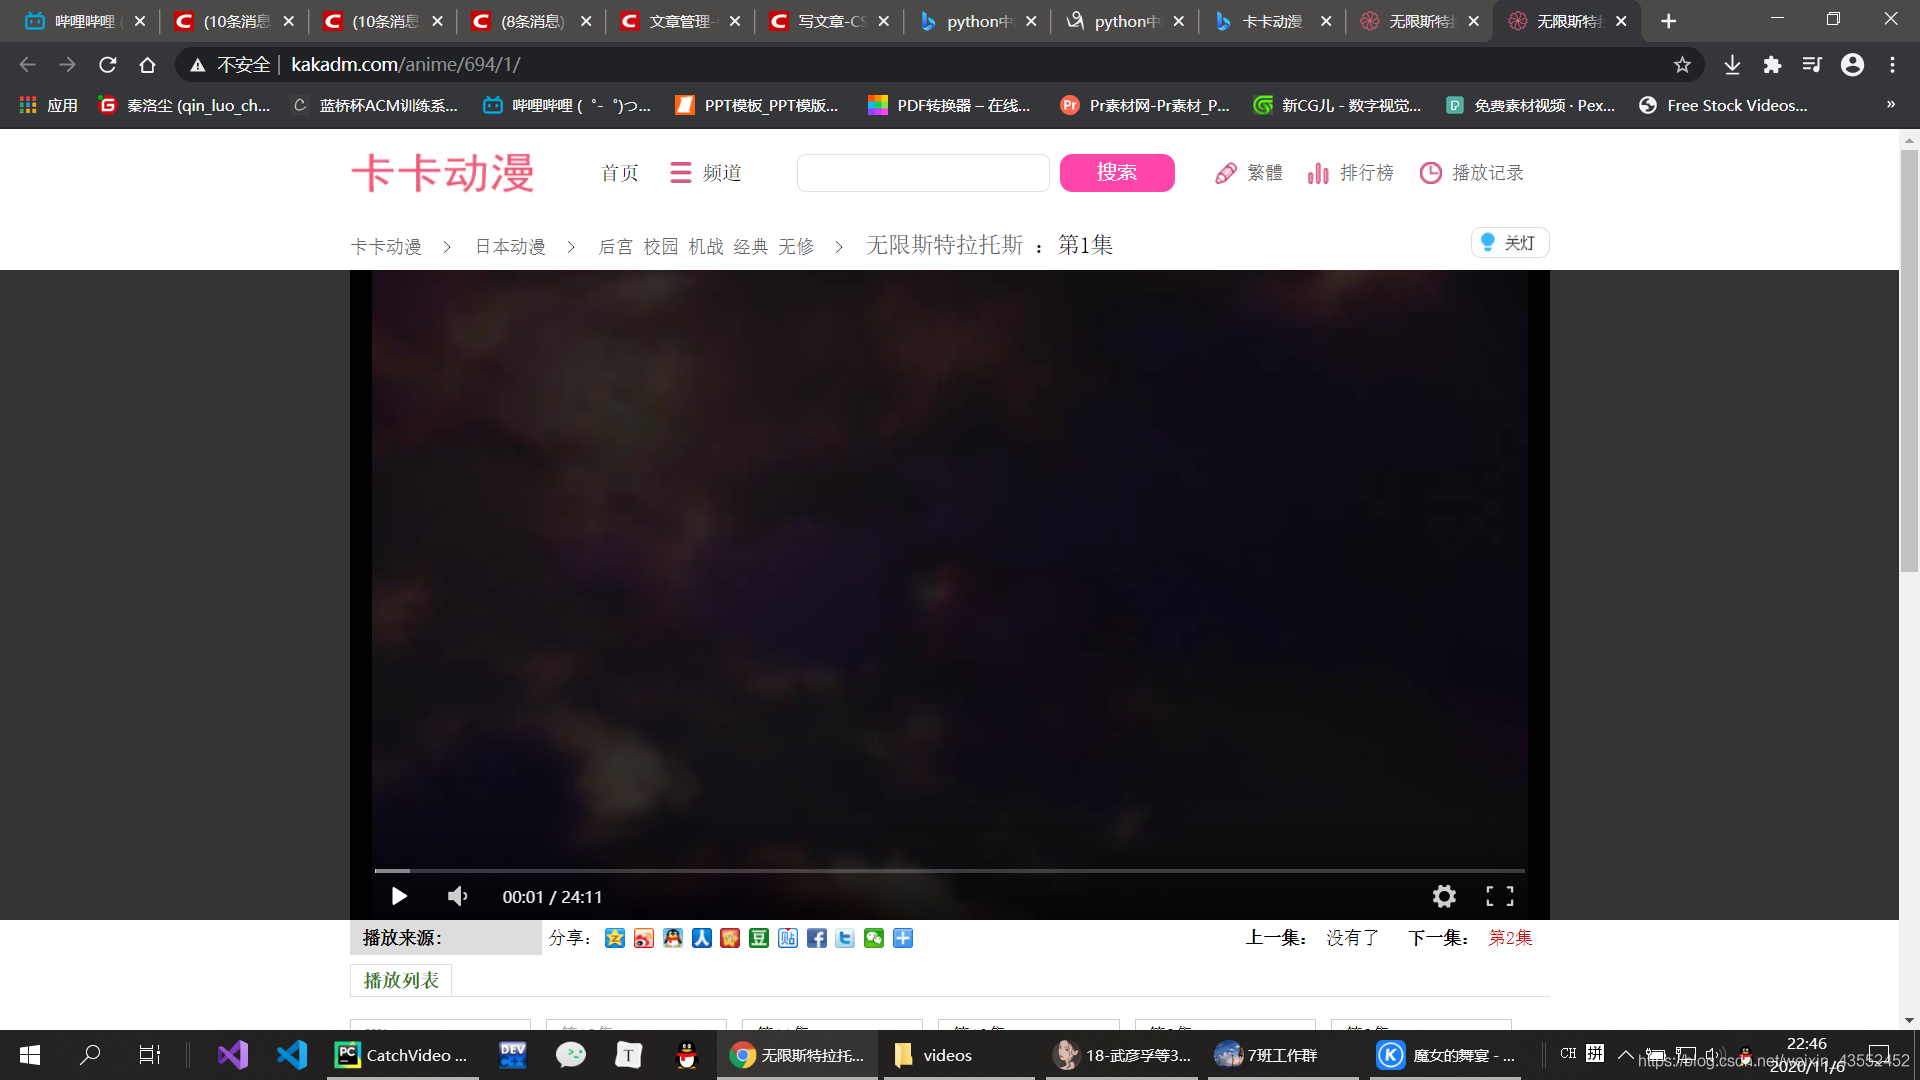

4.解析网页,获取视频源链接,即获取后缀名含.mp4的链接

由上述代码获取视频播放页面后,获取源视频链接:

# 请求获取视频源mp4
videos = []
title = []
chrome_options = webdriver.ChromeOptions()
# 使用headless无界面浏览器模式,即不需要打开浏览器
chrome_options.add_argument('--headless')  # 增加无界面选项
chrome_options.add_argument('--disable-gpu')  # 如果不加这个选项,有时定位会出现问题
flag = 0
name = ''
for u in videourls:
    # 启动浏览器,获取网页源代码
    b = webdriver.Chrome(options=chrome_options)  # 建立Chrome的驱动
    b.implicitly_wait(10)  # 隐式等待,动态查找元素
    b.get(u)  # 在Chrome上打开网址

    # 获取视频名字,如:无限斯特拉托斯
    if flag == 0:
        soup = BeautifulSoup(html, "html.parser")
        name = soup.find("title").string.split('-')[0]  # 获取标签内的内容
        flag = 1

    # 进入iframe内嵌网页
    b.switch_to.frame("playbox")  # 针对iframe标签,(id)
    html = b.page_source  # 打印页面

    soup = BeautifulSoup(html, "html.parser")
    t = soup.find("title").string.split(' ')[0]  # 视频命名
    v = re.findall(r'(http[s]?://(?:[a-zA-Z]|[0-9]|[$-_@.&+]|[!*\(\),]|(?:%[0-9a-fA-F][0-9a-fA-F]))+\.mp4)',
                   html)  # 获取mp4网址
    t = name + " " + t
    title.append(t)
    videos.append(v)
    print(v)
    b.quit()  # 退出

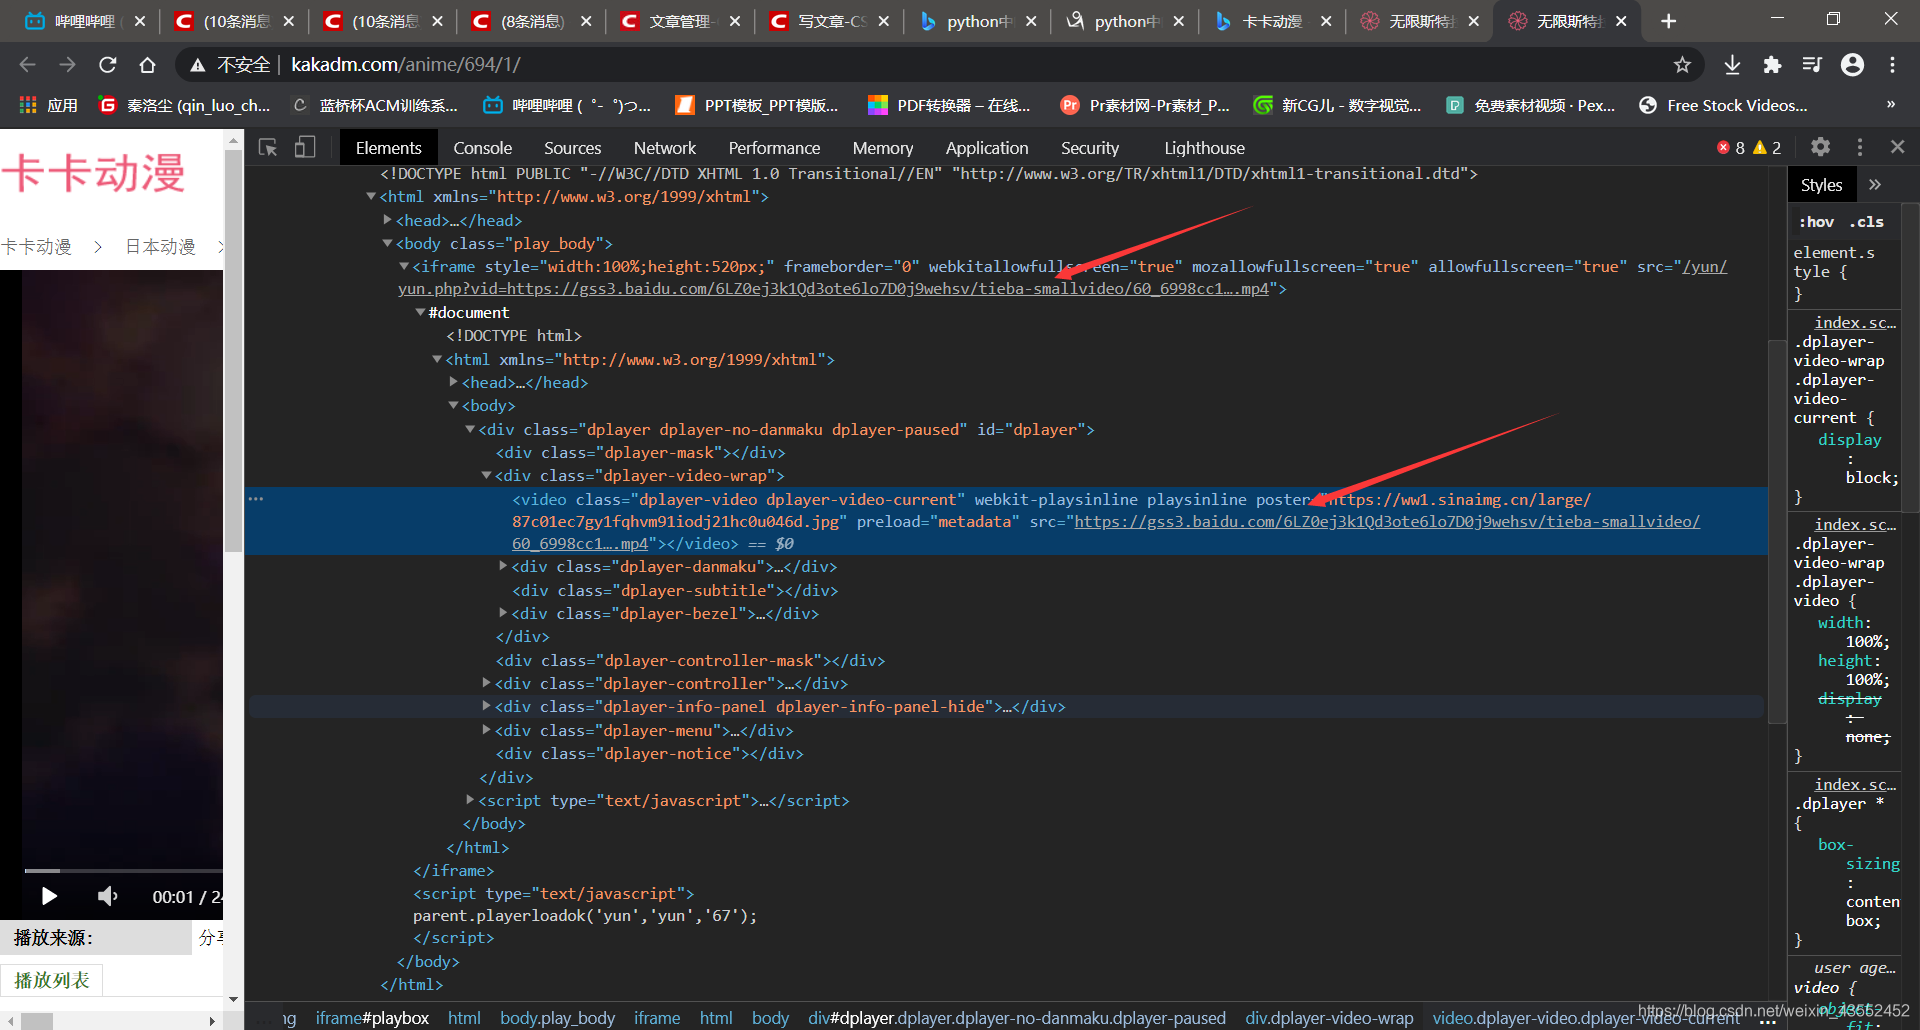
由上述代码获取如下视频源链接:
注意:
在本例子中,卡卡动漫里的视频源链接放在ifame标签中,这是基本反爬机制之一。ifame标签会隐藏其内的内容,用requests模块不能直接访问,需要在浏览器中访问,即需要selenium模块,通过针对iframe标签的方法b.switch_to.frame(id)
打开浏览器来访问iframe标签,并获取隐藏其中的视频源链接。

5.下载视频,并储存到指定文件夹

由上述代码获取视频源链接后,下载到指定文件目录:

"""下载mp4视频"""
i = 0  # 显示当前下载第几个视频
j = 0  # 遍历视频标题列表
# 创建视频文件目录
path = 'D:\Softdownload\Python\\videos\{}\\'.format(name)
if os.path.exists(path) == False:  # 如果文件不存在
    os.mkdir(path)
for index, item in enumerate(videos):
    i += 1
    print("正在下载第{}个视频".format(i))
    file_name = title[j] + '.mp4'  # 命名成mp4格式
    j += 1
    r = requests.get(videos[index][0], headers=header)  # 请求里面的网址
    with open(path + file_name, 'wb') as f:  # 在指定文件夹下载视频,没有就创建
        f.write(r.content)

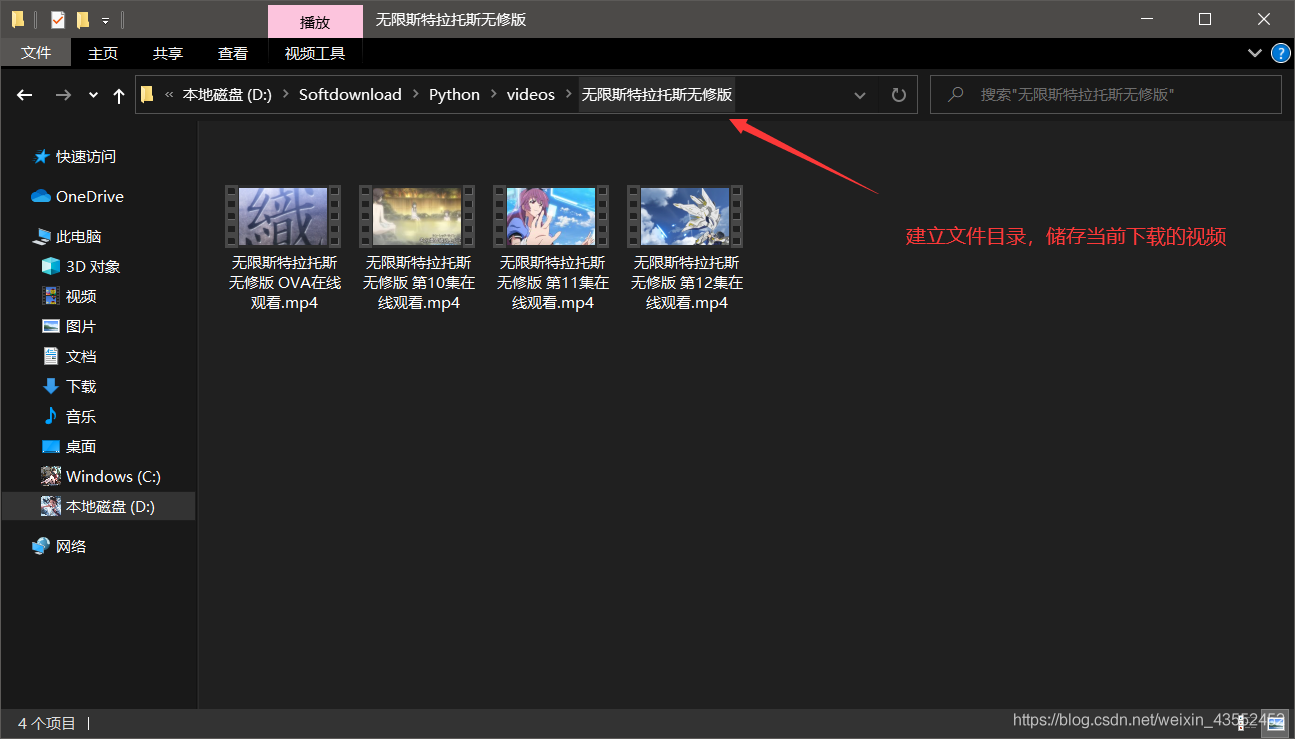
由上述代码会建立如下文件目录:
还是不难的哈!希望能从文中学到你想要得到的!

 

Python爬虫——爬取某网站的视频 爬取视频 阅读详情

相关推荐

Python爬虫—爬取网页视频

作为一个萌新博主,以下是我学爬虫一个多学期来的经验,有bug的地方请多见谅,谢谢各位

weixin_52687990的博客 5713

40行代码教你利用Python网络爬虫批量抓取小视频

还在为在线看小视频缓存慢发愁吗?还在为想重新回味优秀作品但找不到资源而忧虑吗?莫要慌,让python来帮你解决,40行代码教你爬遍小视频网站,先批量下载后仔细观看,岂不美哉!本文主要基于Python网络爬虫,利用40行代码,针对小视频网页,进行批量获取网页视频到本地。方法简单易行,而且行之有效,欢迎大家踊跃尝试。如果想获取本文代码,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

WANGJUNAIJIAO的博客 6829

python爬取视频评论数据

用python爬取小视频数据和评论数据

weixin_46913162的博客 5437

python高阶爬虫---视频类内容爬取,内含详细教程和代码实例

最近放暑假,闲来无事,爬点东西来玩。这学期由于课程需要,多次用爬虫的技术来获取数据,但都是获取一些文字类的数据。突发奇想,自己想利用爬虫获取一些音视频类的数据。下面以某站和某影院为例,说明爬虫获取音视频的技术和方法。BiliBili的视频爬取教程参考自BiliBili视频(自己爬自己,哈哈哈),城市影院的视频爬取以BiliBili为启发,自己编写。代码仅供参考,不用做其他用途。..............................

DALEONE的博客 4万+

Python爬取全民小视频网站视频,可爬取全网视频!

前言 本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,如有问题请及时联系我们以作处理。 PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取 python免费学习资料以及群交流解答点击即可加入 开发工具 python 3.6.5 pycharm import requests 1 确定目标网页 选择影视类目 右键选择检查,开发开发者工具 选择 Network,网页往下滑,可以看到数据加载 视频地址 视频名字 视频ID 接.

爬遍所有网站 682

Python爬虫-爬取腾讯小视频

这两天在爬TX的视频的原始下载地址,遇到的问题挺多,感觉这个网站的规律变化多端的,中间也忘了修改过多少次代码了,而且有时候抓包也抓不到一些想要的内容,最后也只能抓到一些像《拜托啦学妹》、《国产整蛊大师》类似的小视频,长时间的视频最后我看了一下只能拿到前五分钟的视频,现在先记录一下,供后续再研究。 我是利用Chrome直接进行抓包的,可以拿到视频的真实地址(ps.但是后续多次尝试其他小视频竟然抓不

suwenkun1126的博客 2万+

python网络爬虫爬取视频_Python网络爬虫——爬取小视频网站源视频!自己偷偷看哦!...

学习前提1、了解python基础语法2、了解re、selenium、BeautifulSoup、os、requests等python第三方库1.引入库爬取网站视频需要引入的第三方库:import osfrom selenium import webdriverimport requestsfrom bs4 import BeautifulSoupimport re模块用处:1、os模块:文件目录操...

weixin_39796533的博客 427

Python爬哔哩哔哩的小视频

呃呃,这个好像用处不怎么大,就当玩一玩,直接看代码,代码中有很多注释 # -*- coding: utf-8 -*- # 它可以模拟浏览器向网站发送一个请求[命令] import requests ''' 编写爬虫的过程中 基于html去分析网页数据并删选 ** 使用浏览器去分析这个网站的接口 [api] 找到它之后利用 requests去请求这个api 拿到a...

weixin_44560813的博客 1879

python3下载网页视频_Python网络爬虫——爬取小视频网站源视频!自己偷偷看哦!...

学习前提1、了解python基础语法2、了解re、selenium、BeautifulSoup、os、requests等python第三方库1.引入库PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取爬取网站视频需要引入的第三方库:import osfrom selenium import webdriverimport requestsfrom bs4 import Beaut...

weixin_39664456的博客 630

【愚公系列】《Python网络爬虫从入门到精通》020-爬取动态渲染信息(Ajax数据的爬取)

在当今的互联网时代,动态网页已经成为了常态,许多网站使用Ajax技术来异步加载数据,这使得我们在进行数据爬取时面临着新的挑战。与传统的静态网页不同,Ajax请求通常不会直接在HTML源代码中显示出所需的数据,这就要求我们采取更灵活的方法来获取这些信息。本期文章将带你深入了解Ajax数据的爬取技巧。我们将探讨Ajax原理和工作方式,以及如何使用Python等工具有效地抓取由Ajax动态加载的数据。

愚公智库 12万+

Python实战:批量爬取B站小视频完整流程

Python爬虫是一种通过程序自动化抓取网页数据的技术,广泛应用于数据采集、内容监控、市场分析等领域。随着短视频平台的兴起,爬取B站小视频数据成为许多数据爱好者和研究者的实践目标。本项目旨在通过实战方式,使用Python构建一个能够稳定抓取B站小视频信息的爬虫系统。我们将从基础的HTTP请求发送开始,逐步深入HTML解析、API分析与反爬策略应对,最终完成一个结构清晰、功能完整的爬虫项目。整个流程将结合requests、BeautifulSoup、lxml等主流库,帮助开发者掌握真实场景下的数据抓取技巧。

weixin_42578963的博客 2184

python爬取小视频-40行代码教你利用Python网络爬虫批量抓取小视频

/1 前言/还在为在线看小视频缓存慢发愁吗?还在为想重新回味优秀作品但找不到资源而忧虑吗?莫要慌,让python来帮你解决,40行代码教你爬遍小视频网站,先批量下载后仔细观看,岂不美哉!/2 整理思路/这类网站一般大同小异,本文就以凤凰网新闻视频网站为例,采用倒推的方式,给大家介绍如何通过流量分析获得视频下载的url,进而批量下载。/3 操作步骤//3.1 分析网站,找出网页变化规律/1、首先找到...

q6q6q的专栏 3618

OV5640摄像头DVP与MIPI接口配置实战:从30Hz到60Hz的性能优化指南

本文详细解析了OV5640摄像头在DVP与MIPI接口下的60Hz性能优化方法,重点解决720p分辨率下帧率仅30Hz的常见问题。通过精确配置时钟树、传感器寄存器和接口参数,提供DVP与MIPI接口的实战配置代码,并分享调试工具与性能验证技巧,帮助开发者实现稳定的60fps输出。

weixin_29223603的博客 1301

Python爬虫学习教程 bilibili网站视频爬取!【附源码】

Python爬虫学习教程,万物皆可爬!每个技术大牛都是从基础慢慢的提升上去的,基础知识越深以后的发展越牛!学好python,才能玩转python,那到底怎么才能学好python? 通过爬取b站案例带领你快速掌握爬虫,掌握学习技巧~带你揭开编程最神秘的面纱,解决学习路上的迷惑·~ 对于初学者在学习Python过程中有不懂的或是缺少这方面学习教程的可以加一下我建的Python技术的学习裙;九三七六...

IT编程联盟 5182

固件测试工具选型需要考察的功能点汇总

通过专业的固件测试工具可以帮助我们提高测试效率、提升测试的覆盖度、确保测试的准确性,保障产品的安全和质量。本文我们讲固件测试工具的功能点进行梳理和汇总,方便大家在采购固件测试工具时进行选型比对。

daopuyun的博客 2111

k8s 查看cpu使用率最高的pod

在 Kubernetes 中,可以使用命令查看 Pod 的资源使用情况,从而找到 CPU 使用率最高的 Pod。

u010674101的专栏 3345

Python爬取全民小视频网站视频,可爬取全站视频

前言 本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,如有问题请及时联系我们以作处理。 PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取 python免费学习资料以及群交流解答点击即可加入 开发工具 python 3.6.5 pycharm import requests 确定目标网页 选择影视类目 右键选择检查,开发开发者工具 选择 Network,网页往下滑,可以看到数据加载 视频地址 视频名字 视频ID 接口数据链接

人生苦短, 还不用Python? 1414

立创开源Link Hub多功能USB扩展坞:CH339F主控+4层板设计,实测网口/存储性能

本文深度评测了立创开源Link Hub多功能USB扩展坞,其采用CH339F主控芯片与4层PCB板设计,并严格进行阻抗匹配。实测表明,该扩展坞的USB接口与microSD读卡器性能均接近USB 2.0理论极限,百兆以太网口转换效率高,性能损失极小。设计上注重电源保护与信号完整性,是一个兼顾稳定性与成本的高完成度开源硬件项目。

weixin_36173034的博客 158

python爬取小视频,看完身体一天不如一天!

Python现在非常火,语法简单而且功能强大,很多同学都想学Python!所以在这里给各位看官们准备了高价值Python学习视频教程及相关电子版书籍,都放在了文章结尾,欢迎前来领取!python爬取小视频记录学习python简单爬虫小程序,记录代码和学习过程环境信息python 2.7.12分析与步骤 要分析网站信息 http://www.budejie.com/video/ 查看网页不同页面的...

weixin_34128839的博客 2343

Tesseract in Java - Intellij IDEA对Tess4J的配置和使用

最近要弄OCR,搜到这个,官网全英文,很烦,看看有没有中文的博客介绍,擦,一个比一个奇葩,还是自己按照官方的来吧,外网慢的很,传到csdn给大家下载。中文训练库下载地址: http://download.youkuaiyun.com/detail/d_dmelon/9916532Tess4J3.4下载地址: http://download.youkuaiyun.com/detail/d_dmelon/9916519安装

Lewis的博客 1万+

三相交错并联的boost变换器simulink仿真,电流双闭环控制策略

文章介绍了一种基于Simulink的三通道交错并联双向Buck-Boost变换器的设计与仿真。该变换器采用电压外环和三电流内环的控制策略,并通过120°载波移相技术实现Buck模式与Boost模式之间的平滑切换,有效避免了过压和过流问题。交错并联的拓扑结构不仅减少了电感电流的纹波,还缩小了每相电感的体积,提升了电路的响应速度,适用于储能系统。仿真过程完全离散化,采用离散解析器,主电路与控制部分以不同步长运行,更贴近实际应用。控制与采样环节均为手工搭建,未使用Matlab自带模块,展示了三相交错并联Boost

2510_91195931的博客 1706

爬虫项目实战九:爬取6间房小视频

爬取6间房小视频目标项目准备网站分析页码分析反爬分析代码实现效果显示 目标 爬取6间房小视频,批量保存到本地文件夹。 项目准备 软件:Pycharm 第三方库:requests,fake_useragent 网站地址:https://v.6.cn/minivideo/ 网站分析 打开网站 分析网页是什么加载类型。 F12打开开发者模式。 这是抓取的数据包。 判断为动态加载类型。 页码分析 第一个数据包: 第二个数据包: 第三个数据包: https://v.6.cn/minivideo/getM

Linkage interrupt 2869

​网格划分理论:CFD理论67 网格划分-三大理论问题_哔哩哔哩_bilibili传统解释非结构化网格是不对的——计算传热学大叔专题讨论2--CFD网格类型_哔哩哔哩_bilibili

传统解释非结构化网格是不对的——计算传热学大叔。fluent计算理论和离散方法原理视频推荐。

qq_15963745的博客 183
上一篇: 用Python实现《沉默的真相》3万+弹幕情感分析!简单!
下一篇: Scrapy框架爬取股票信息!没点技术还真操作不来!
pythonlaodi
博客等级 码龄6年 286粉丝 244原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值